🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,217 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,751 阅读
3
【高数】形心计算公式讲解大全
9,117 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,153 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,891 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
刘航宇(共319篇)
找到
319
篇与
刘航宇
相关的结果
- 第 2 页
EBI开发手册|FPGA与STM32 EBI高速并行通信技术详解
摘要本文详细介绍了FPGA与STM32 EBI高速并行通信技术,包括EBI的优势、系统框图、读写时序、硬件连接、信号定义、FPGA端Verilog接口设计、STM32端HAL配置与驱动等,适用于复杂电子系统和高可靠FPGA-MCU协同设计。关键词:FPGA, STM32, EBI, 高速并行通信, 内存映射目录 1. 为什么选EBI而非SPI? 2. EBI系统框图 3. EBI开发手册下载 4. EBI读写时序EBI读时序 EBI写时序 5. EBI硬件连接与信号定义5.1 信号连接表 5.2 硬件设计注意事项 6. FPGA端Verilog接口设计6.1 模块接口定义 6.2 核心设计要点6.2.1 信号直通与数据三态控制 3.2.2 写信号同步 6.2.3 读信号同步 7. 内部模块连接示例 8. STM32端HAL配置与驱动8.1 GPIO初始化 8.2 FMC异步SRAM模式初始化 8.3 读写驱动函数 9. 读写时序分析9.1 读时序 (FPGA → STM32) 9.2 写时序 (STM32 → FPGA) 10. 关键设计决策说明10.1 为什么写信号只用1级同步,读信号用3级? 10.2 三态门控制逻辑 10.3 地址直通 vs 同步 EBI开发手册下载 适用场景:复杂电子系统 / 高可靠FPGA-MCU协同设计 关键词:FPGA · STM32 · EBI · LocalBus · 异步SRAM · EE学术1. 为什么选EBI而非SPI? 在高可靠嵌入式系统中,STM32与FPGA通信的常见方式有SPI、I2C、UART等串行接口,以及EBI(External Bus Interface)等并行总线。虽然SPI实现简单,但在需要高带宽、低延迟、内存映射访问的场景下,EBI并行总线具有显著优势: 对比维度SPIEBI数据宽度1~4 bit (QSPI)8/16 bit理论带宽~50 MB/s (QSPI)~100+ MB/s访问方式寄存器操作内存映射 (直接读写)DMA支持有限原生支持适用场景控制命令、低速数据图像缓冲、FFT数据流、航电总线对于需要FPGA处理高速数据流(如传感器采集、信号处理)并将结果回传MCU的场景,EBI允许STM32像访问内部SRAM一样直接读写FPGA内部寄存器或FIFO,无需复杂的协议栈开销。这种"内存映射"方式使得CPU可以通过简单的指针操作完成数据交换,几乎零额外软件开销。 2. EBI系统框图 pasted_1784792114679_uqlyxj.png图片 pasted_1784792133238_8k92xm.png图片 3. EBI开发手册下载 见文章末尾 4. EBI读写时序 EBI读时序 pasted_1784792256693_rqlsy7.png图片 EBI写时序 pasted_1784792336779_i0i8ah.png图片 5. EBI硬件连接与信号定义 以STM32F407 + FPGA(Xilinx/Altera)为例,采用16位数据宽度、非复用地址模式,典型连接如下: 5.1 信号连接表 STM32 引脚FPGA 引脚信号说明PD14~PD15, PE7~PE15IO_EBI_data[15:0]EBI数据总线 (16位双向)PF0~PF5, PG0~PG13I_EBI_addr[23:0]EBI地址总线 (24位,可寻址16MB)PG9I_EBI_CS_nEBI片选 (低有效)PD4I_EBI_OE_nEBI读使能 (低有效)PD5I_EBI_WE_nEBI写使能 (低有效)—I_sys_clkFPGA系统时钟 (≥100MHz)—I_rst_n系统复位 (低有效)地址映射:Bank1_NE2 → 0x6400_0000 ~ 0x64FF_FFFF (16MB空间) 5.2 硬件设计注意事项 ⚠️ 关键提示 FPGA的IO电平必须与STM32匹配(通常 3.3V LVTTL/LVCMOS33) 数据线建议串联 22~47Ω 电阻抑制信号反射,尤其是高速运行时 地址线若不需要全部使用,可接地或接固定电平,减少FPGA引脚占用 若使用等待信号(NWAIT),需在EBI配置中使能,并在FPGA中正确驱动 航空电子场景需特别关注 EMC/EMI 设计,建议增加滤波和屏蔽 6. FPGA端Verilog接口设计 FPGA侧的核心任务是模拟一个"SRAM设备",响应STM32的读写时序。以下是基于异步SRAM模式的完整Verilog接口模块,直接对应你的实际工程代码: 6.1 模块接口定义 module EBI_LOCALBUS ( /* --------------------- Input Signals --------------------- */ input I_sys_clk, // 系统时钟 input I_rst_n, // 系统复位 input I_EBI_CS_n, // EBI片选 input I_EBI_WE_n, // EBI写信号 input I_EBI_OE_n, // EBI读信号 input [23 : 00] I_EBI_addr, // EBI地址 (24位) inout [15 : 00] IO_EBI_data, // EBI数据总线 (16位双向) input [15 : 00] I_EBI_RD_data, // CPU读数据 (来自内部模块) /* --------------------- Output Signals -------------------- */ output [15 : 00] O_EBI_WR_data, // CPU写数据 (输出到内部模块) output O_EBI_CS_n, // 片选转接 output reg O_EBI_WE_n, // 写信号同步输出 output O_EBI_RD_n, // 读信号同步输出 output [23 : 00] O_EBI_addr // 地址转接 );6.2 核心设计要点 6.2.1 信号直通与数据三态控制 // EBI片选直通 assign O_EBI_CS_n = I_EBI_CS_n; // EBI地址直通 assign O_EBI_addr = I_EBI_addr; // 写数据:EBI总线 → FPGA内部 (写操作时数据由STM32驱动) assign O_EBI_WR_data = IO_EBI_data; // 读数据:FPGA内部 → EBI总线 (仅在片选有效且读使能有效时驱动) assign IO_EBI_data = ( (I_EBI_CS_n == 1'b0) && (S_EBI_RD_N_d2 == 1'b0) ) ? I_EBI_RD_data : 16'bz;关键设计: O_EBI_CS_n 和 O_EBI_addr 为直通信号,不做时钟域转换,确保地址和片选的最小延迟 IO_EBI_data 采用三态控制:仅在 CS_n == 0 且 RD_N_d2 == 0 时驱动读数据,否则置高阻态,避免总线冲突 O_EBI_WR_data 直接采样 IO_EBI_data,因为写操作时数据总线由STM32驱动,无需三态判断 3.2.2 写信号同步 // EBI写信号打拍同步 always @(posedge I_sys_clk or negedge I_rst_n) begin if (I_rst_n == 1'b0) begin O_EBI_WE_n <= 1'b1; // 复位后写无效 end else begin O_EBI_WE_n <= I_EBI_WE_n; end end设计意图: 写信号经过1级同步,从异步EBI域转入FPGA系统时钟域 同步后的 O_EBI_WE_n 可直接用于内部模块的写使能,配合 O_EBI_addr 和 O_EBI_WR_data 完成一次完整的写操作 6.2.3 读信号同步 reg S_EBI_RD_N_d0; reg S_EBI_RD_N_d1; reg S_EBI_RD_N_d2; // EBI读信号三级打拍 always @(posedge I_sys_clk or negedge I_rst_n) begin if (I_rst_n == 1'b0) begin S_EBI_RD_N_d0 <= 1'b1; S_EBI_RD_N_d1 <= 1'b1; S_EBI_RD_N_d2 <= 1'b1; end else begin S_EBI_RD_N_d0 <= I_EBI_OE_n; S_EBI_RD_N_d1 <= S_EBI_RD_N_d0; S_EBI_RD_N_d2 <= S_EBI_RD_N_d1; end end assign O_EBI_RD_n = S_EBI_RD_N_d2;为什么读信号需要3级同步? 读信号采用三级延迟(而非写信号的1级),原因如下: 同步级数作用S_EBI_RD_N_d0第一级同步,消除亚稳态S_EBI_RD_N_d1第二级同步,稳定信号S_EBI_RD_N_d2第三级延迟,为FPGA内部模块预留数据准备时间读操作需要FPGA内部模块在检测到读使能后,将数据放到 I_EBI_RD_data 上,再通过三态门驱动到 IO_EBI_data。三级延迟确保了: 内部模块有足够的时间响应读请求 数据在 S_EBI_RD_N_d2 == 0 时已经稳定 满足STM32 EBI的数据建立时间要求 7. 内部模块连接示例 EBI_LOCALBUS 模块本身是一个总线桥接器,需要配合内部功能模块使用。以下是一个典型的寄存器文件连接示例: module internal_regfile ( input I_sys_clk, input I_rst_n, input I_cs_n, // 来自 EBI_TO_LOCALBUS.O_EBI_CS_n input I_we_n, // 来自 EBI_TO_LOCALBUS.O_EBI_WE_n input I_rd_n, // 来自 EBI_TO_LOCALBUS.O_EBI_RD_n input [23:0] I_addr, // 来自 EBI_TO_LOCALBUS.O_EBI_addr input [15:0] I_wr_data, // 来自 EBI_TO_LOCALBUS.O_EBI_WR_data output reg [15:0] O_rd_data // 送到 EBI_TO_LOCALBUS.I_EBI_RD_data ); reg [15:0] reg_file [0:255]; // 256个16位寄存器 integer i; initial begin for (i = 0; i < 256; i = i + 1) reg_file[i] = 16'd0; end // 写操作:WE_n下降沿 (同步后的信号) always @(posedge I_sys_clk or negedge I_rst_n) begin if (!I_rst_n) begin // 复位逻辑 end else if (!I_cs_n && !I_we_n) begin reg_file[I_addr[7:0]] <= I_wr_data; end end // 读操作:组合逻辑输出 (确保在RD_n有效时数据已稳定) always @(*) begin if (!I_cs_n && !I_rd_n) O_rd_data = reg_file[I_addr[7:0]]; else O_rd_data = 16'h0000; end endmodule顶层连接: module top_fpga_stm32 ( input sys_clk, input sys_rst_n, // EBI物理接口 inout [15:0] fmc_data, input [23:0] fmc_addr, input fmc_cs_n, input fmc_oe_n, input fmc_we_n ); wire [15:0] ebi_rd_data; wire [15:0] ebi_wr_data; wire ebi_cs_n; wire ebi_we_n; wire ebi_rd_n; wire [23:0] ebi_addr; EBI_LOCALBUS u_ebi_bridge ( .I_sys_clk (sys_clk), .I_rst_n (sys_rst_n), .I_EBI_CS_n (fmc_cs_n), .I_EBI_WE_n (fmc_we_n), .I_EBI_OE_n (fmc_oe_n), .I_EBI_addr (fmc_addr), .IO_EBI_data (fmc_data), .I_EBI_RD_data (ebi_rd_data), .O_EBI_WR_data (ebi_wr_data), .O_EBI_CS_n (ebi_cs_n), .O_EBI_WE_n (ebi_we_n), .O_EBI_RD_n (ebi_rd_n), .O_EBI_addr (ebi_addr) ); internal_regfile u_regfile ( .I_sys_clk (sys_clk), .I_rst_n (sys_rst_n), .I_cs_n (ebi_cs_n), .I_we_n (ebi_we_n), .I_rd_n (ebi_rd_n), .I_addr (ebi_addr), .I_wr_data (ebi_wr_data), .O_rd_data (ebi_rd_data) ); endmodule8. STM32端HAL配置与驱动 STM32侧使用HAL库配置FMC/EBI为异步SRAM模式。以下代码基于STM32F407,使用Bank1_NE2(对应地址 0x64000000): 8.1 GPIO初始化 #include "stm32f4xx_hal.h" #define FPGA_BASE_ADDR 0x64000000 // 内存映射指针 (16位访问) volatile uint16_t *fpga_regs = (volatile uint16_t *)FPGA_BASE_ADDR; static void FMC_GPIO_Init(void) { GPIO_InitTypeDef GPIO_InitStruct = {0}; __HAL_RCC_GPIOD_CLK_ENABLE(); __HAL_RCC_GPIOE_CLK_ENABLE(); __HAL_RCC_GPIOF_CLK_ENABLE(); __HAL_RCC_GPIOG_CLK_ENABLE(); // 数据总线 D0~D15: PD14/15, PE7~15 GPIO_InitStruct.Pin = GPIO_PIN_14 | GPIO_PIN_15; GPIO_InitStruct.Mode = GPIO_MODE_AF_PP; GPIO_InitStruct.Pull = GPIO_NOPULL; GPIO_InitStruct.Speed = GPIO_SPEED_FREQ_VERY_HIGH; GPIO_InitStruct.Alternate = GPIO_AF12_FMC; HAL_GPIO_Init(GPIOD, &GPIO_InitStruct); GPIO_InitStruct.Pin = GPIO_PIN_7 | GPIO_PIN_8 | GPIO_PIN_9 | GPIO_PIN_10 | GPIO_PIN_11 | GPIO_PIN_12 | GPIO_PIN_13 | GPIO_PIN_14 | GPIO_PIN_15; HAL_GPIO_Init(GPIOE, &GPIO_InitStruct); // 地址总线 A0~A5: PF0~PF5 (可扩展至A23) GPIO_InitStruct.Pin = GPIO_PIN_0 | GPIO_PIN_1 | GPIO_PIN_2 | GPIO_PIN_3 | GPIO_PIN_4 | GPIO_PIN_5; HAL_GPIO_Init(GPIOF, &GPIO_InitStruct); // 控制信号: NOE(PD4), NWE(PD5), NE2(PG9) GPIO_InitStruct.Pin = GPIO_PIN_4 | GPIO_PIN_5; HAL_GPIO_Init(GPIOD, &GPIO_InitStruct); GPIO_InitStruct.Pin = GPIO_PIN_9; HAL_GPIO_Init(GPIOG, &GPIO_InitStruct); }8.2 FMC异步SRAM模式初始化 void FMC_FPGA_Init(void) { SRAM_HandleTypeDef hsram = {0}; FMC_NORSRAM_TimingTypeDef Timing = {0}; FMC_GPIO_Init(); __HAL_RCC_FMC_CLK_ENABLE(); hsram.Instance = FMC_NORSRAM_DEVICE; hsram.Extended = FMC_NORSRAM_EXTENDED_DEVICE; // Bank1_NE2, 16位数据宽度, SRAM类型 hsram.Init.NSBank = FMC_NORSRAM_BANK2; hsram.Init.DataAddressMux = FMC_DATA_ADDRESS_MUX_DISABLE; // 非复用 hsram.Init.MemoryType = FMC_MEMORY_TYPE_SRAM; hsram.Init.MemoryDataWidth = FMC_NORSRAM_MEM_BUS_WIDTH_16; hsram.Init.BurstAccessMode = FMC_BURST_ACCESS_MODE_DISABLE; hsram.Init.WaitSignalPolarity = FMC_WAIT_SIGNAL_POLARITY_LOW; hsram.Init.WrapMode = FMC_WRAP_MODE_DISABLE; hsram.Init.WaitSignalActive = FMC_WAIT_TIMING_BEFORE_WS; hsram.Init.WriteOperation = FMC_WRITE_OPERATION_ENABLE; hsram.Init.WaitSignal = FMC_WAIT_SIGNAL_DISABLE; hsram.Init.ExtendedMode = FMC_EXTENDED_MODE_DISABLE; hsram.Init.AsynchronousWait = FMC_ASYNCHRONOUS_WAIT_DISABLE; hsram.Init.WriteBurst = FMC_WRITE_BURST_DISABLE; hsram.Init.ContinuousClock = FMC_CONTINUOUS_CLOCK_SYNC_ONLY; // 时序配置 (HCLK = 168MHz, 1周期 ≈ 5.95ns) // 需根据FPGA时序报告调整,满足建立/保持时间 Timing.AddressSetupTime = 2; // 地址建立: ~12ns Timing.AddressHoldTime = 1; // 地址保持 Timing.DataSetupTime = 5; // 数据建立: ~30ns Timing.BusTurnAroundDuration = 1; // 总线周转 Timing.CLKDivision = 2; Timing.DataLatency = 2; Timing.AccessMode = FMC_ACCESS_MODE_A; HAL_SRAM_Init(&hsram, &Timing, &Timing); }8.3 读写驱动函数 /** * @brief 向FPGA寄存器写入16位数据 */ static inline void FPGA_WriteReg(uint16_t reg, uint16_t value) { fpga_regs[reg] = value; __DSB(); // 数据同步屏障,确保写入完成 } /** * @brief 从FPGA寄存器读取16位数据 */ static inline uint16_t FPGA_ReadReg(uint16_t reg) { uint16_t val = fpga_regs[reg]; __DSB(); return val; } /** * @brief 批量数据写入 */ void FPGA_WriteBuffer(uint16_t reg_base, uint16_t *data, uint32_t len) { for (uint32_t i = 0; i < len; i++) { fpga_regs[reg_base + i] = data[i]; } __DSB(); } /** * @brief 批量数据读取 */ void FPGA_ReadBuffer(uint16_t reg_base, uint16_t *data, uint32_t len) { for (uint32_t i = 0; i < len; i++) { data[i] = fpga_regs[reg_base + i]; } __DSB(); }9. 读写时序分析 9.1 读时序 (FPGA → STM32) 读时序要点: I_EBI_OE_n 下降沿后,FPGA内部模块开始准备数据 经过3个时钟周期(d0 → d1 → d2),S_EBI_RD_N_d2 变为低电平 三态门在 S_EBI_RD_N_d2 == 0 时使能,将 I_EBI_RD_data 驱动到 IO_EBI_data STM32在 NOE 上升沿采样数据,需确保数据在采样前已稳定(满足DataSetupTime) 9.2 写时序 (STM32 → FPGA) 写时序要点: I_EBI_WE_n 下降沿表示写周期开始,STM32地址和数据已稳定 O_EBI_WE_n 在1个时钟周期后同步到低电平,内部模块在时钟上升沿检测 !O_EBI_WE_n && !O_EBI_CS_n 执行写操作 O_EBI_WR_data 直接采样 IO_EBI_data,无需额外延迟,因为写操作时数据总线由STM32持续驱动 10. 关键设计决策说明 10.1 为什么写信号只用1级同步,读信号用3级? 信号同步级数原因I_EBI_WE_n → O_EBI_WE_n1级写操作对FPGA是"被动接收",数据总线由STM32驱动,FPGA只需在时钟沿采样稳定的数据即可I_EBI_OE_n → S_EBI_RD_N_d23级读操作对FPGA是"主动输出",需要给内部模块预留时间准备数据,再通过三态门驱动到总线10.2 三态门控制逻辑 assign IO_EBI_data = ( (I_EBI_CS_n == 1'b0) && (S_EBI_RD_N_d2 == 1'b0) ) ? I_EBI_RD_data : 16'bz;使用 S_EBI_RD_N_d2 而非 I_EBI_OE_n 的原因: 直接使用 I_EBI_OE_n 会导致FPGA在STM32还未准备好接收数据时就驱动总线,可能产生总线冲突 使用延迟后的 S_EBI_RD_N_d2 确保:① 内部数据已准备好;② STM32的读使能确实有效;③ 满足数据建立时间 10.3 地址直通 vs 同步 assign O_EBI_addr = I_EBI_addr; // 直通,无时钟延迟地址采用组合逻辑直通而非同步,原因: 地址在EBI访问期间保持稳定,无需跨时钟域处理 减少地址到内部模块的延迟,提高访问速度 地址稳定性由STM32硬件保证 EBI开发手册下载
嵌入式&系统
FPGA&ASIC
# ASIC/FPGA
# 嵌入式
# Verilog
# C/C++
刘航宇
7月23日
0
105
6
2026-07-17
电子信息类专业考研-简历-就业宝藏公众号:843电子信息站
摘要本公众号为电子信息类专业学生提供技术、考研、就业信息,涵盖技术栈、考研课程、简历、项目辅导与就业指导,助力学生提升竞争力。关键词:电子信息专业, 考研指导, 就业信息, FPGA技术, 嵌入式开发电子信息类专业(通信、电子、集成电路、人工智能等)的同学们,大学四年或硕士三年转瞬即逝,考研、实习、求职三座大山接踵而至。信息差,往往比努力更致命。 从技术、考研到就业,本博客和公众号843电子信息站将会给大家带来很多信息差上的帮助。 技术栈 考研栈 简历与就业栈 升学与就业规划 技术栈 可以关注EE学术-刘航宇的博客https://ee.ac.cn/,本博客包含嵌入式、FPGA、数字IC领域多项基础知识以及实战项目,非常适合找工作的宝子们,以此来提高笔试和面试机会。 有任何FPGA或嵌入式项目开发问题欢迎留言或者加博主,可以辅导解答。 pasted_1784268982839_xjdg8h.png图片 FPGA、STM32视频教程可以关注我的哔站 https://space.bilibili.com/470370345 pasted_1784272934372_eu8hjd.png图片 考研栈 欢迎大家报考考研西北大学843电子信息类专业:新一代电子信息技术、电子科学与技术、信息与通信工程专业,西大在行业认可度属于比较高的,毕业生可去央国企、华为、腾讯等大厂。 推荐的843专业考研课程网站(学习通上课): https://edu.ee.ac.cn/ 简历与就业栈 可关注微信公众号:843电子信息站,致力于电子工程-FPGA与嵌入式技术的分享、电子信息就业信息分享;FPGA与嵌入式项目开发与辅导;西北大学843考研模电、数电、电路指导等。 pmycSqU.png图片 升学与就业规划 可参考本站文章:《电子信息类专业升学与就业规划,FPGA与嵌入式领域本科硕士均适用》 https://ee.ac.cn/index.php/archives/688.html
我的随笔
# ASIC/FPGA
# 嵌入式
# 随笔
# 西北大学843
刘航宇
7月17日
0
155
6
2026-06-29
格雷码(Gray Code)原理与应用详解-结合工程领域说明
摘要格雷码是一种二进制编码方式,相邻数之间只有一位二进制位变化,避免亚稳态和毛刺问题。主要应用在FPGA、嵌入式设计等领域,如异步FIFO,确保状态切换干净、无歧义。关键词:Gray Code, 格雷码, 应用场景, FPGA, 异步FIFO一、什么是格雷码 格雷码(Gray Code)是一种特殊的二进制编码方式,它的核心特点是相邻两个数之间只有一位二进制位发生变化。这与普通二进制码不同——比如二进制中 3011011011 到 4100100100 有三位同时翻转,而格雷码中相邻数永远只变一位。 二、为什么需要格雷码 普通二进制在数值递增时,多位可能同时翻转,这在硬件世界中会引入一个严重问题:亚稳态和毛刺(Glitch)。 举个例子: • 二进制从 0111 777 变到 1000 888 • 4位同时翻转,由于电路延迟差异,实际可能短暂出现 0101、0010 等错误中间态 • 如果此时被采样,就会读到完全错误的数据 格雷码从根本上避免了这个问题——任何时候只有1位变化,不存在中间错误态。 三、格雷码的主要应用场景 应用场景 为什么用格雷码 图片 四、格雷码 vs 二进制 对照表(3位) 图片 五、FPGA中最经典的用法:异步FIFO // 二进制计数器 → 格雷码转换 → 跨时钟域传输 module gray_code_converter #( parameter WIDTH = 8 )( input WIDTH−1:0WIDTH-1:0WIDTH−1:0 bin, // 二进制计数器值 output WIDTH−1:0WIDTH-1:0WIDTH−1:0 gray // 格雷码输出 ); // 转换公式:gray = bin ^ bin>>1bin >> 1bin>>1 assign gray = bin ^ bin>>1bin >> 1bin>>1; endmodule为什么FIFO指针必须用格雷码? • 写时钟域的写指针要传到读时钟域进行比较 • 如果用二进制,多位同时变化 → 跨时钟域采样可能抓到错误值 → 空满判断出错 → 数据丢失或覆盖 • 格雷码每次只变1位 → 即使采样时机不对,最多差1个地址 → 不会误判空满状态 六、格雷码 ↔ 二进制 转换公式 【二进制 → 格雷码】 G(n) = B(n) ^ B(n+1) // 最高位不变,其余位与高位异或 // 或简写: gray = bin ^ (bin >> 1) 【格雷码 → 二进制】 B(n) = G(n) ^ B(n+1) // 从最高位开始,逐位异或恢复 // 或递推: bin[MSB] = gray[MSB] bin[i] = gray[i] ^ bin[i+1] 七、一句话总结 格雷码不是为了"计算"方便,而是为了"变化安全"——在硬件世界中,让每一次状态切换都干净、无歧义、无毛刺。这是数字电路从"理论正确"走向"工程可靠"的关键一步,也是FPGA/嵌入式设计中跨时钟域、机械编码器等场景的标准做法。
嵌入式&系统
通信&信息处理
# 嵌入式
# 通信&射频
刘航宇
6月29日
0
156
5
国家线已出,26复试与27届考研西北大学843电子信息该如何准备?
摘要西北大学843电子信息考研,26届复试需联系导师,关注时间节点,准备专业课笔试、面试和实验操作;27届初试需刷真题,关注招生简章变动。西大认可度高,不歧视双非,建议早规划,执行力比计划更重要。关键词:西北大学, 843电子信息, 考研复试, 初试准备, 专业课学习🔥 26届复试党(迫在眉睫版) 🌱 27届考研党(早鸟规划版) 27考研概况 843专业招生人数 考试科目 初试题型与分值 下面针对新生常见提问的一些问答: 国家线终于出了是264分!考西北大学843电子信息的宝子们看过来,这篇一次性说清26届复试和27届初试该怎么准备! 图片 peSlNL9.png图片 🔥 26届复试党(迫在眉睫版) 先联系导师,选导师!!提前占据自己喜欢的研究方向 ⏰ 时间节点要记牢 国家线公布后1-2周内,西大自划线+复试名单就会出 复试一般安排在3月底-4月初 📋 西北大学复试考什么?843电子信息复试通常包含: 专业课笔试 综合面试 实验操作 💡 现阶段必做3件事: 速查官网 → 按研究生网站或提供的资料看以往复试细则 联系导师 → 邮件模板准备好,附上简历+初试成绩 狂补专业课 → 重点看初试没考但复试常考的内容 💬 西大复试很公平,不歧视双非!本科没项目也别慌,把毕业设计吃透也能聊! 推荐的复试指导班和资料 ✅26 届 843 复试指导课仅需31(资料整理服务费68) 不到一顿饭钱轻松助你考研一臂之力,报名链接👉 https://mooc1.chaoxing.com/course/portal/f4Jg9QrC9ticE_Jwt1BcCA peSuvvj.png图片 peSlNL9.png图片 🌱 27届考研党(早鸟规划版) 📌 843电子信息考情速览 初试科目:政治、英语一、数学一、843电子基础综合 参考书:模电、数电和电路 🗓️ 全年时间轴(建议版) 图片 全科真题模拟;专业课刷西大历年真题(重点!) ⚠️ 西大843避坑提醒: 真题重复率不低!务必搞到近10年真题(报名27课程或者考研Q群519462257获取) 电路计算题要动手算,别只看不做 关注电子学院和计算机学院官网,9月看招生简章有无变动 推荐的初试系统全程班和资料(报名特惠488,该班级会送复试) ✅27 届 843 电子通信考研系统班:从基础划重点到真题逐题讲,还有复试全程指导,赠送 07-26 年 843/849 真题 + 笔记课件 + 复试资料包,报名链接👉https://mooc1.chaoxing.com/course/260044360.html peSlIW8.png图片 peSlNL9.png图片 请记住: 初试分数是硬道理,复试表现是加分项 别被"本科出身"焦虑绑架,西大真的很公平 现在准备完全来得及,执行力比完美计划更重要 27考研概况 西北大学在大厂如华为、中兴、腾讯和阿里的认可度一向不错,西北大学电子信息类专业在211中报名人数一直较少,21~25年,这几年来看,复试分数线一直都是国家线或者比国家线高几分,因此从报考性价比和上岸概率来说无疑是个不错的选择! 843专业招生人数 新一代电子信息专硕专硕专硕120人左右,电子科学与技术(学硕)20人左右,信息与通信工程(学硕)20人左右 考试科目 模电、数电、电路----(三门课不少章节不考,考的不算多) 初试题型与分值 初试:三门,每门2~3题,每科目占50分 考察基础理解程度 下面针对新生常见提问的一些问答: 问:西北大学843就业情况如何? 答:就业不错,高的有年薪50~60W的,也低的也有18W、15W的,每年有不少去大厂、银行的。 问:西北大学843三个专业初试是一样的吗? 答:完全一样,卷子也一样,复试略有不同 问:我本科不是电子信息类专业可以报名吗? 答:可以,不歧视,根据以往843考研班统计结果来看,是有不少跨专业上岸的,跨幅最大是本科土木 问:我本科是二本,专升本可以吗? 答:可以报名,考试流程都是正常的,对于这类学生可能存在自身学习能力低下,但是只要努力就会有结果,根据以往843考研班统计结果:每年都有二本上岸的,2024年有两位是专升本过来的 问:有没有843考研交流群? 答:有,推荐下面这个843群有500多人QQ群号:519462257QQ群号:519462257QQ群号:519462257 点击快速加入,西大843QQ交流大群 问:843初试都有考哪些东西? 答:模电,数电,电路分析三本书,不过不少地方不考,不用太担心!如果不知道重点可以进一步问学长 问:是否有推荐的靠谱843课程班或资料? 答:下面两个链接是推荐的843班 https://edu.ee.ac.cn/ https://mooc1.chaoxing.com/course/260044360.html peS1nSO.png图片 peSlNL9.png图片 如果只是需要考研初试复试真题资料话可以联系学长哦~ 问:843复试难吗,歧视双非吗? 答:不难中规中矩,不歧视双非,每年有二本上岸的,双非压线上岸的 问:843报考专业如何选择? 答:这个开放的,大家可能根据自己本科专业或者喜好进行选择,学硕毕业要求会难一些,其次招生人数也会少一些
我的随笔
# 西北大学843
刘航宇
1年前
0
2,670
5
2025-01-09
【FPGA】AXI DMA详解
摘要本文详细介绍了AXI DMA的工作原理、ZYNQ中的DMA类型、AXI DMA IP核的配置和使用方法,包括Direct Register模式、Scatter/Gather模式和Cyclic DMA模式,以及AXI DMA的参数和接口分析。关键词:FPGA, AXI DMA, DMA传输, ZYNQ, 数据搬运<DMA简介 ZYNQ DMA简介 三、AXI DMA IP简介 四、AXI DMA参数与接口分析 Xilinx FPGA里面的AXI DMA IP核的简单用法 DMA简介 DMA是一种内存访问技术,允许某些计算机内部的硬件子系统可以独立的直接读写内存,而不需要CPU介入处理,从而不需要CPU的大量中断负载,否则,CPU需要从来源把每一片段的数据复制到寄存器,然后在把他们再次写回到新的地方,在这个时间里,CPU就无法执行其他的任务。 DMA是一种快速数据传送方式,通常用来传送数据量较多的数据块。使用DMA时,CPU向DMA控制器发送一个存储器传输请求,这样当DMA控制器在传输的时候,CPU执行其他的操作,传输完成时DMA以中断的方式通知CPU。 DMA传输过程的示意图为: 图片 DMA的传输过程为: 1、为了配置用DMA传输数据到存储器,处理器(Cortex-A9)发出一条指令。 2、DMA控制器把数据从外设传输到存储器或者从存储器传输到存储器,从而较少CPU处理的事务量。 3、输出传输完成后,向CPU发出一个中断通知DMA传输可以关闭。 为了发起传输事务,DMA控制器必须得到以下信息: (1)、源地址——数据被读出的地址 (2)、目的地址——数据被写入的地址 (3)、传输长度——应传输的字节数 ZYNQ DMA简介 ZYNQ提供了两种DMA,一种是集成在PS中的硬核DMA,另一种是PL中使用的软核AXI DMA IP。 在ARM APU(Application Processor Unit,应用处理单元)设计过程中,已经考虑到大量数据搬移的情况,因此在APU中自带了一个DMA控制器DAMC,这个DMAC驻留在PS内,而且必须通过驻留在内存中的DMA指令编程,这些程序往往需要CPU准备,因此需要部分的CPU参与。DMAC支持多达8个通道,所以多个DMA结构的核可以挂载在单个DMAC上。 DMAC与PL的连接是通过AXI-GP接口,这个接口最高支持到32位宽,这也限制了这种模式下的传输速率,理论上最大为600MB/s,这种模式不占用PL资源,但需要对DMA指令编程,会增加软件的复杂性。 为了获取更高的速率,可以空间换时间,在PL中添加AXI DMA IP core,并利用AXI_HP接口完成高速的数据传输,各种接口的传输比较为: 图片 ZYNQ中ACI_HP接口的分布为: 图片 通过PL的DMA和AXI_HP接口传输方式的拓扑图为: 图片 DMA的数据传输经过S_AXI_HP接口,每一个HP接口都含有控制和数据fifo,这些fifo为大数据量突发传输提供缓冲,使得HP成为理想的高速数据接口。 对DMA的控制或配置通过M_AXI_GP接口(M代表master为PS),传输状态通过中断传达到PS的中断控制器。 对M_AXI_GP0理解是: 在ZYNQ7处理器系统IP core中,在PS-PL Configuration下的AXI Non Secure Enablement下有一个GP Master AXI Interface选项,可选一个M_AXI_GP0接口。 该接口的作用是对PL侧的IP core通过AXI-Lite总线进行配置,如果不仅需要的话直接不使能即可。 图片 图片 三、AXI DMA IP简介 ZYNQ提供了两种DMA,一种是集成在PS中的硬核DMA,另一种是PL中使用的软核AXI DMA IP。 AXI DMA IP核在AXI4-Stream IP接口之间提供高带宽直接存储访问。其可选的scatter gather(SG,链式相关)功能还可以从基于处理器的系统中的中央处理单元(CPU)卸载数据搬运任务。初始化、状态和管理寄存器通过AXI-Lite从接口访问(即数据发出方为PL,PS为Slave),核心功能组成为(这张图很有助于理解DMA中断以及SDK代码,下面会解释): 图片 原图位于AXI_DMA数据手册的第五页。 AXI DMA使用了三种总线,分别是: (1)、AXI Memory Map,用于内存交互,AXI4 Memory Map Read用于从DMA读取,AXI4 Memory Map用于向DMA写入。 (2)、AXI4-Lite同于对寄存器的配置。 (3)、AXI4-Stream接口用于对外设的读写,S2MM(Stream to Memory Mapped,数据流向内存映射)用于对外设读取。AXI_MM2S和AXI_S2MM是AXI_Stream总线,可以发送和接收连续的数据流,无需地址。 AXI DMA提供3种模式: (1)、Direct Register模式:用于在MM2S和S2MM通道上执行简单的DMA传输,小的FPGA资源少。有两个通道:一个从Device到DMA,另一个从DMA到Device。应用程序必须设置缓冲区地址和长度字段以启动相应通道中的传输。 (2)、Scatter/Gather模式:允许在单个DMA事务中将数据传输到多个存储区域传输数据。 (3)、Cyclic DMA模式: 四、AXI DMA参数与接口分析 图片 1、接口分析: (1)、M_AXI_MM2S:DMA的读通道,从DDR中读取数据。受Enable Read Channel控制,表现为M_AXI_MM2S。 (2)、M_AXI_S2MM:DMA的写通道,将数据写入DDR中。受Enable Write Channel控制,表现为M_AXI_S2MM。 (3)、M_AXIS_MM2S:DMA将数据发送到具有stream接口IP。 (4)、S_AXIS_S2MM:DMA将数据从具有Stream接口的IP中将数据读入。 (5)、mm2s_introut:DMA将数据从DDR的映射单元中读出,然后将数据发送到具有Stream接口的IP完成信号。 (6)、s2mm_introut:DMA将数据从具有stream接口的IP中读入,并写入到内存映射单元的完成中断信号。 2、参数分析 图片 (1)、Enable Scatter Gatter Engine 链式DMA操作,取消选中该选项可启用directregister模式操作。 (2)、Enable Micro DMA 改选项会生成高度优化的DMA,资源数量较少,用于传输极少量数据的应用程序。 (3)、Width of Buffer Length Register 根据IP手册pg021,在direct register模式下,此整数值用于指定控制字段缓冲区长度的有效位数,字节数等于2^(width),即字节读取和字节写入的有效长度都是2^(width)。比如宽度设置为26,可传输的字节数为2^(26)字节。(pg021,78页)。 (4)、Address Width 指定地址空间的宽度,默认32。 (5)、Enable Read Channel Memory Map Data Width:AXI MM2S存储映射读取总线的数据位宽,可为32、64、128、256、512、1024。 Stream Data Width:AXI MM2S AXI-Stream数据总线的位宽,该值必须小于等于Memory Map Data Width,可以为8、16、32、64、128、512、1024。 Max Burst Size:最大突发长度设置,指定的是MM2S的AXI4-Memory Map侧的突发周期的最大值,可为2、4、8、16、32、64、128、256。 (6)、Enable Write channel:同Read channel。 3、关于中断的理解 (1)、M_AXI_MM2S:DMA的读通道,从DDR中读取数据。受Enable Read Channel控制,表现为M_AXI_MM2S。 在AXI_DMA ip core的输出信号中,有两个中断信号,分别是s2mm_introut和mm2s_introut,mm指的是Memory Mapped,S指的是Stream。 Memory Map指的是什么?根据AXI DMA的介绍,AXI DMA提供一个介于AXI4 Memory Mapped 与AXI4 Stream IP之间的高带宽DMA: 原话位于IP参考的page5: The AXI DirectMemory Access (AXI DMA) IP core provides high-bandwidth direct memory accessbetween the AXI4 memory mapped and AXI4-Stream IP interfaces. 所以,对于DMA来说,S2MM,就是Stream形式的数据到达DDR映射空间,具体的实现方式是Stream数据流先进入DMA,之后再从DMA到Memeory Mapped。 MM2S是Memory Mapped将数据送入具有AXI Stream接口的IP。 从这里分析mm2s_introut与s2mm_introut信号的区别是分析不出来的,因为数据都是先到DMA,再从DMA发送出去。 在第5页还有一张图,讲述AXI DMA的架构: 图片 分析这张图,DDR内存映射空间的读写都是通过AXI4Memory Map完成的,也就是说s2mm与mm2s的重点不在PS DDR侧,重点在PL侧,当Stream接口的数据将输出传到DMA时候,这个过程叫做DMA的接收,DMA将映射单元的数据写到stream接口的IP,这个过程叫做DMA的发送。 所以!也就可以理解在SDK中将s2mm_introut定义为DMA接收中断,将mm2s_introut定义为发送中断了! 所以以下语句就很容易理解了: // DMA接收通道的中断ID #define RX_INTR_ID XPAR_FABRIC_AXIDMA_0_S2MM_INTROUT_VEC_ID #define TX_INTR_ID XPAR_FABRIC_AXIDMA_0_MM2S_INTROUT_VEC_IDXilinx FPGA里面的AXI DMA IP核的简单用法 在FPGA里面,AXI DMA这个IP核的主要作用,就是在Verilog语言和C语言之间传输大批量的数据,使用的通信协议为AXI4-Stream。 Xilinx很多IP核都是基于AXI4-Stream协议的,例如浮点数Floating-point IP核,以及以太网Tri Mode Ethernet MAC IP核。要想将Verilog层面的数据搬运到C语言里面处理,就要使用DMA IP核。 本文以浮点数Floating-point IP核将定点数转换为浮点数为例,详细讲解AXI DMA IP核的使用方法。 浮点数IP核的输入输出数据都是32位,协议均为AXI4-Stream。C语言程序首先将要转换的定点数数据通过DMA发送给浮点数IP核,浮点数IP核转换完成后再通过DMA将单精度浮点数结果发回C语言程序,再通过printf打印出来。 定点数的数据类型为int,小数点定在第四位上,即:XXXXXXX.X。整数部分占28位,小数部分占4位。 转换后浮点数的数据类型为float,可以用printf的%f直接打印出来。 工程下载地址:https://pan.baidu.com/s/1SXppHMdhroFT8vGCIysYTQ(提取码:u7wf) MicroBlaze C语言工程的建法不再赘述,请参阅:https://blog.csdn.net/ZLK1214/article/details/111824576 以读写Floating-point IP核数据为例 图片 首先添加Floating-point IP核,作为DMA的外设端:(主存端为BRAM) 图片 图片 图片 图片 这里要注意一下,一定要勾选上TLAST,否则DMA接收端会出现DMA Internal Error的错误: 图片 下面是Xilinx DMA手册里面对DMA Internal Error错误的描述: 图片 添加AXI DMA IP核: 图片 IP核添加好了,但还没有连线: 图片 点击Run Connection Automation,自动连接DMA的S_AXI_LITE接口: 图片 图片 图片 图片 图片 自动连接浮点数IP核的时钟引脚: 图片 图片 图片 图片 图片 添加BRAM控制器: 图片 图片 最终的连线结果: 图片 修改新建的BRAM的容量为64KB: 图片 图片 最终的地址分配方式: 图片 保存Block Design,然后生成Bitstream: 图片 Bitstream生成后,导出xsa文件: 图片 Vitis Platform工程重新导入xsa文件: 图片 图片 修改C程序(helloworld.c)的代码: (这里面XPAR_BRAM_2_BASEADDR最好改成0xc0000000,因为生成的xparameters.h配置文件里面BRAM号可能有变化) /* * helloworld.c: simple test application * * This application configures UART 16550 to baud rate 9600. * PS7 UART (Zynq) is not initialized by this application, since * bootrom/bsp configures it to baud rate 115200 * * ------------------------------------------------ * | UART TYPE BAUD RATE | * ------------------------------------------------ * uartns550 9600 * uartlite Configurable only in HW design * ps7_uart 115200 (configured by bootrom/bsp) */ #include <stdio.h> #include <xaxidma.h> #include "platform.h" // DMA无法通过AXI Interconnect访问Microblaze本身的BRAM内存 // 只能访问挂接在AXI Interconnect上的内存 #define _countof(arr) (sizeof(arr) / sizeof(*(arr))) typedef struct { int numbers_in[40]; float numbers_out[40]; } BRAM2_Data; static BRAM2_Data *bram2_data = (BRAM2_Data *)XPAR_BRAM_2_BASEADDR; static XAxiDma xaxidma; int main(void) { int i, ret = 0; XAxiDma_Config *xaxidma_cfg; init_platform(); printf("Hello World\n"); printf("Successfully ran Hello World application\n"); // 初始化DMA xaxidma_cfg = XAxiDma_LookupConfig(XPAR_AXIDMA_0_DEVICE_ID); XAxiDma_CfgInitialize(&xaxidma, xaxidma_cfg); ret = XAxiDma_Selftest(&xaxidma); if (ret != XST_SUCCESS) { printf("XAxiDma_Selftest() failed! ret=%d\n", ret); goto err; } // 初始化DMA的输入数据 printf("numbers_in=%p, numbers_out=%p\n", bram2_data->numbers_in, bram2_data->numbers_out); for (i = 0; i < _countof(bram2_data->numbers_in); i++) { bram2_data->numbers_in[i] = 314 * (i + 1); if (i & 1) bram2_data->numbers_in[i] = -bram2_data->numbers_in[i]; } // DMA开始发送数据 (Length参数的单位为字节) ret = XAxiDma_SimpleTransfer(&xaxidma, (uintptr_t)bram2_data->numbers_in, sizeof(bram2_data->numbers_in), XAXIDMA_DMA_TO_DEVICE); if (ret != XST_SUCCESS) { printf("XAxiDma_SimpleTransfer(XAXIDMA_DMA_TO_DEVICE) failed! ret=%d\n", ret); goto err; } // DMA开始接收数据 ret = XAxiDma_SimpleTransfer(&xaxidma, (uintptr_t)bram2_data->numbers_out, sizeof(bram2_data->numbers_out), XAXIDMA_DEVICE_TO_DMA); if (ret != XST_SUCCESS) { printf("XAxiDma_SimpleTransfer(XAXIDMA_DEVICE_TO_DMA) failed! ret=%d\n", ret); goto err; } // 等待DMA发送完毕 i = 0; while (XAxiDma_Busy(&xaxidma, XAXIDMA_DMA_TO_DEVICE)) { i++; if (i == 200000) { // 必须确保DMA访问的内存是直接挂接在AXI Interconnect上的 // 否则这里会报DMA Decode Error的错误 (the address request points to an invalid address) printf("DMA Tx timeout! DMASR=0x%08lx\n", XAxiDma_ReadReg(xaxidma.RegBase + XAXIDMA_TX_OFFSET, XAXIDMA_SR_OFFSET)); goto err; } } printf("DMA Tx complete!\n"); // 等待DMA接收完毕 i = 0; while (XAxiDma_Busy(&xaxidma, XAXIDMA_DEVICE_TO_DMA)) { i++; if (i == 200000) { // floating-point IP核的配置里面一定要把A通道的tlast复选框勾选上, 使输入端和输出端都有tlast信号 // 否则s_axis_s2mm_tlast一直为0, DMA以为数据还没接收完, 就会报DMA Internal Error的错误 // (the incoming packet is bigger than what is specified in the DMA length register) printf("DMA Rx timeout! DMASR=0x%08lx\n", XAxiDma_ReadReg(xaxidma.RegBase + XAXIDMA_RX_OFFSET, XAXIDMA_SR_OFFSET)); goto err; } } printf("DMA Rx complete!\n"); err: for (i = 0; i < _countof(bram2_data->numbers_out); i++) printf("numbers_out[%d]=%f\n", i, bram2_data->numbers_out[i]); cleanup_platform(); return 0; }C程序的运行结果: 图片 图片 接下来讲一下我们刚才禁用掉的Scatter Gather接口的用法。取消禁用后,之前的C代码就不能运行了。 之前没有启用Scatter Gather的时候,我们一次只能提交一个DMA请求,等这个DMA请求的数据传输完毕后,我们才能提交下一个DMA传输请求。 有了Scatter Gather接口,我们就可以一次性提交很多很多DMA请求,然后CPU去干其他的事情。这可以大大提高传输效率。 除此以外,Scatter Gather还可以将多个位于不同内存地址的缓冲区合并成一个AXI4-Stream数据包传输。 下面的示例演示了如何利用Scatter Gather功能批量收发3组数据包。 启用了Scatter Gather后,DMA里面多出了一个M_AXI_SG接口,点击Run Connection Automation,连接到AXI Interconnect上: 图片 图片 Vivado工程Generate Bitstream,然后导出xsa文件。回到Vitis后,必须把Platform工程删了重建,不然XPAR_AXI_DMA_0_INCLUDE_SG的值得不到更新。 图片 图片 图片 原有的C程序不再可用,修改一下程序代码: /* * helloworld.c: simple test application * * This application configures UART 16550 to baud rate 9600. * PS7 UART (Zynq) is not initialized by this application, since * bootrom/bsp configures it to baud rate 115200 * * ------------------------------------------------ * | UART TYPE BAUD RATE | * ------------------------------------------------ * uartns550 9600 * uartlite Configurable only in HW design * ps7_uart 115200 (configured by bootrom/bsp) */ #include <stdio.h> #include <xaxidma.h> #include "platform.h" /* Xilinx的官方例程:C:\Xilinx\Vitis\2020.1\data\embeddedsw\XilinxProcessorIPLib\drivers\axidma_v9_11\examples\xaxidma_example_sg_poll.c */ // DMA无法通过AXI Interconnect访问Microblaze本身的BRAM内存 // 只能访问挂接在AXI Interconnect上的内存 #define _countof(arr) (sizeof(arr) / sizeof(*(arr))) typedef struct { int numbers_in[40]; float numbers_out[40]; } BRAM2_Data; typedef struct { uint8_t txbuf[640]; uint8_t rxbuf[640]; } BRAM2_BdRingBuffer; static BRAM2_Data *bram2_data = (BRAM2_Data *)0xc0000000; static BRAM2_BdRingBuffer *bram2_bdringbuf = (BRAM2_BdRingBuffer *)0xc0008000; static XAxiDma xaxidma; int main(void) { int i, n, ret = 0; XAxiDma_Bd *bd, *p; XAxiDma_BdRing *txring, *rxring; XAxiDma_Config *cfg; init_platform(); printf("Hello World\n"); printf("Successfully ran Hello World application\n"); // 初始化DMA cfg = XAxiDma_LookupConfig(XPAR_AXIDMA_0_DEVICE_ID); XAxiDma_CfgInitialize(&xaxidma, cfg); ret = XAxiDma_Selftest(&xaxidma); if (ret != XST_SUCCESS) { printf("XAxiDma_Selftest() failed! ret=%d\n", ret); goto err; } if (!XAxiDma_HasSg(&xaxidma)) { printf("XPAR_AXI_DMA_0_INCLUDE_SG=%d\n", XPAR_AXI_DMA_0_INCLUDE_SG); printf("Please recreate and build Vitis platform project!\n"); goto err; } // 初始化DMA的输入数据 printf("[0] numbers_in=%p, numbers_out=%p\n", bram2_data[0].numbers_in, bram2_data[0].numbers_out); printf("[1] numbers_in=%p, numbers_out=%p\n", bram2_data[1].numbers_in, bram2_data[1].numbers_out); printf("[2] numbers_in=%p, numbers_out=%p\n", bram2_data[2].numbers_in, bram2_data[2].numbers_out); for (i = 0; i < _countof(bram2_data[0].numbers_in); i++) { bram2_data[0].numbers_in[i] = 314 * (i + 1); bram2_data[1].numbers_in[i] = -141 * (i + 1); bram2_data[2].numbers_in[i] = -2718 * (i + 1); if (i & 1) { bram2_data[0].numbers_in[i] = -bram2_data[0].numbers_in[i]; bram2_data[1].numbers_in[i] = -bram2_data[1].numbers_in[i]; bram2_data[2].numbers_in[i] = -bram2_data[2].numbers_in[i]; } } // 配置DMA发送描述符 txring = XAxiDma_GetTxRing(&xaxidma); n = XAxiDma_BdRingCntCalc(XAXIDMA_BD_MINIMUM_ALIGNMENT, sizeof(bram2_bdringbuf->txbuf)); ret = XAxiDma_BdRingCreate(txring, (uintptr_t)bram2_bdringbuf->txbuf, (uintptr_t)bram2_bdringbuf->txbuf, XAXIDMA_BD_MINIMUM_ALIGNMENT, n); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingCreate(txring) failed! ret=%d\n", ret); goto err; } printf("BdRing Tx count: %d\n", n); ret = XAxiDma_BdRingAlloc(txring, 3, &bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingAlloc(txring) failed! ret=%d\n", ret); goto err; } p = bd; for (i = 0; i < 3; i++) { XAxiDma_BdSetBufAddr(p, (uintptr_t)bram2_data[i].numbers_in); XAxiDma_BdSetLength(p, sizeof(bram2_data[i].numbers_in), txring->MaxTransferLen); XAxiDma_BdSetCtrl(p, XAXIDMA_BD_CTRL_TXSOF_MASK | XAXIDMA_BD_CTRL_TXEOF_MASK); XAxiDma_BdSetId(p, i); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(txring, p); } ret = XAxiDma_BdRingToHw(txring, 3, bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingToHw(txring) failed! ret=%d\n", ret); goto err; } // 配置DMA接收描述符 rxring = XAxiDma_GetRxRing(&xaxidma); n = XAxiDma_BdRingCntCalc(XAXIDMA_BD_MINIMUM_ALIGNMENT, sizeof(bram2_bdringbuf->rxbuf)); ret = XAxiDma_BdRingCreate(rxring, (uintptr_t)bram2_bdringbuf->rxbuf, (uintptr_t)bram2_bdringbuf->rxbuf, XAXIDMA_BD_MINIMUM_ALIGNMENT, n); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingCreate(rxring) failed! ret=%d\n", ret); goto err; } printf("BdRing Rx count: %d\n", n); ret = XAxiDma_BdRingAlloc(rxring, 3, &bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingAlloc(rxring) failed! ret=%d\n", ret); goto err; } p = bd; for (i = 0; i < 3; i++) { XAxiDma_BdSetBufAddr(p, (uintptr_t)bram2_data[i].numbers_out); XAxiDma_BdSetLength(p, sizeof(bram2_data[i].numbers_out), rxring->MaxTransferLen); XAxiDma_BdSetCtrl(p, 0); XAxiDma_BdSetId(p, i); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(rxring, p); } ret = XAxiDma_BdRingToHw(rxring, 3, bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingToHw(rxring) failed! ret=%d\n", ret); goto err; } // 开始发送数据 ret = XAxiDma_BdRingStart(txring); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingStart(txring) failed! ret=%d\n", ret); goto err; } // 开始接收数据 ret = XAxiDma_BdRingStart(rxring); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingStart(rxring) failed! ret=%d\n", ret); goto err; } // 等待收发结束 n = 0; while (n < 6) { // 检查发送是否结束 ret = XAxiDma_BdRingFromHw(txring, XAXIDMA_ALL_BDS, &bd); if (ret != 0) { n += ret; p = bd; for (i = 0; i < ret; i++) { printf("DMA Tx%lu Complete!\n", XAxiDma_BdGetId(p)); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(txring, p); } ret = XAxiDma_BdRingFree(txring, ret, bd); if (ret != XST_SUCCESS) printf("XAxiDma_BdRingFree(txring) failed! ret=%d\n", ret); } // 检查接收是否结束 ret = XAxiDma_BdRingFromHw(rxring, XAXIDMA_ALL_BDS, &bd); if (ret != 0) { n += ret; p = bd; for (i = 0; i < ret; i++) { printf("DMA Rx%lu Complete!\n", XAxiDma_BdGetId(p)); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(rxring, p); } ret = XAxiDma_BdRingFree(rxring, ret, bd); if (ret != XST_SUCCESS) printf("XAxiDma_BdRingFree(rxring) failed! ret=%d\n", ret); } } err: for (i = 0; i < _countof(bram2_data[0].numbers_out); i++) printf("numbers_out[%d]=%f,%f,%f\n", i, bram2_data[0].numbers_out[i], bram2_data[1].numbers_out[i], bram2_data[2].numbers_out[i]); cleanup_platform(); return 0; }图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
1年前
1
5,622
11
SoC架构、通信举例、AHB、APB接口
摘要本文介绍了SoC架构,包括处理器内核、存储器、外设等组成部分,并详细阐述了ARM公司推出的AMBA片上总线,如AHB、APB、AXI等,以及它们在CPU与外设通信中的应用。关键词:SoC架构, AHB接口, APB接口, ARM AMBA, AXI总线典型的SoC包括以下部分 CPU与SRAM通信 CPU与I2C接口通信 AHB从接口 AHB主接口 APB桥 APB Slave框图 AXI总线 AXI传输对比 AMBA中AXI AHP APB比较 典型的SoC包括以下部分 • 一个或多个处理器内核,可以是MCU、MPU、数字信号处理器或专用指 令集处理器内核; • 存储器:可以是RAM、ROM、EEPROM或闪存; • 用于提供时间脉冲信号的振荡器和锁相环电路; • 由计数器和计时器、电源电路组成的外设; • 不同标准的连线接口,如USB、火线、以太网、通用异步收发; • 用于在数字信号和模拟信号之间转换的ADC/DAC; • 电压调理电路及稳压器。 在外设内部,各组件通过芯片上的互联总线相互连接。ARM公司推出的 AMBA片上总线主要包括高性能系统总线AHB、通用系统总线ASB、外围互联总线APB、可拓展接口AXI。AHB主要针对高效率、高频宽及快速系统模块;ASB可用于某些高速且不必要使用AHB 总线的场合作为系统总线;APB 主要用于低速、低功率的外围,AXI在AMBA3.0协议中增加,可以用于ARM 和FPGA的高速数据交互。 基于ARM的SoC 图片 CPU与SRAM通信 CPU通过AHB对SRAM进行读写 地址生成:CPU生成要访问的SRAM地址。 信号发送:CPU通过AHB总线发送地址信息和读写请求信号。 数据传输: 读操作:CPU发送读请求后,SRAM将数据放在数据线上,CPU接收数据。 写操作:CPU将数据放在数据线上,发送写请求,SRAM接收并存储数据。 等待确认:操作完成后,SRAM可能通过AHB的握手信号通知CPU操作已完成。 CPU与I2C接口通信 CPU通过APB读取I2C的数据 I2C是一种串行通信协议,通常用于低速外围设备与主控制器之间的通信。APB是一种用于连接低速外设的总线。以下是CPU通过APB读取I2C数据的一般步骤: 初始化I2C外设:CPU通过APB发送指令初始化I2C外设,设置通信参数如时钟速率、地址等。 发送启动条件:CPU通过I2C外设发送启动条件,开始通信。 地址和读写位:CPU发送目标设备的I2C地址以及读写位(读操作为1,写操作为0)。 数据传输: 写操作:如果读写位为0,CPU通过APB发送数据到I2C外设,然后发送停止条件结束通信。 读操作:如果读写位为1,CPU接收来自I2C外设的数据。 数据接收:在读取操作中,CPU通过APB从I2C外设接收数据。 发送停止条件:操作完成后,CPU发送停止条件,结束I2C通信。 AHB从接口 图片 图片 AHB主接口 图片 图片 APB桥 APB桥为AHB的一个从设备,但它在APB中是唯一的主设备,而APB中其它低速和低功率消耗的外围皆为APB桥的从设备。下图是 APB 桥的信号接口: 图片 APB桥将系统总线传送转换成APB方式的传送,它具备一些这些功能: 锁存地址,在传送过程中保持地址有效。锁存读写控制信号 对锁存的地址进行译码并产生选择信号PSELx,在传送过程中只有一个选择信号可以被激活。也就是选择出唯一一个APB从设备以进行读写动作. 写操作时: 负责将AHB送来的数据送上APB总线。 读操作时: 负责将APB的数据送上AHB系统总线。 产生一时序选通信号PENABLE作为数据传递时的启动信号 APB Slave框图 图片 如前面所提及,APB 总线中除了 APB bridge 为 M 外,其它的外围皆为 S。因此,APB 从设备比 AHB从设备接口较为简单且非常具弹性: 例如 a. APB 少了仲裁器及复杂的译码电路,APB 进行写操作时,从设备可以决定: : 在 PCLK 上升沿触发, 且 PSEL 为高时锁存数据 :或在 PENABLE 上升沿, 且 PSEL 为高时锁存数据 b. PSELx,PADDR和PWRITE信号的组合可以决定哪个寄存器会被写操作更新。 c. 在读操作的时候,数据可以 PWRITE 在=0,PSELx 和 PENABLE=1 的时候被送到总线上,而PADDR 用于决定哪个寄存器会被读。 AXI总线 AXI的三种类型 AXI(AXI4-Full):用于高性能的存储器映射需求;(占用资源较多,传输大量数据) AXI4-Lite:简化版的AXI4接口;(占用资源较少,可用于低吞吐率的存储器的通信) AXI4-Stream:用于高速的流数据通信(不使用地址,适用于视频流) AXI的工作方式 AXI4和AXI4-Lite包含5个独立的通道 读地址通道 读数据通道 写地址通道 写数据通道 写响应通道 图片 AXI4:由于读写地址通道是分离的,所以支持双向同时传输;突发长度最大为256; AXI4-Lite:和AXI4比较类似,但是不支持突发传输; AXI4-Stream:和AXI4的写数据通道比较类似,只有一个单一的数据通道,突发长度不受限制; AXI传输对比 Burst可以减少地址通道的交互,提升单笔传输的效率。 Outstanding可以较少多笔传输之间的等待,提升多笔传输的效率。 AMBA中AXI AHP APB比较 图片
IP&SOC设计
# SOC设计
刘航宇
2年前
0
1,466
2
2024-08-23
FPGA/数字IC之FIFO深度计算
摘要本文探讨了FIFO深度计算问题,分析了不同情况下FIFO深度的确定方法,包括读写频率、突发长度、空闲周期等因素,并给出了计算公式和实例。关键词:FPGA, 数字IC, FIFO深度计算, 异步时钟域, 数据传输FIFO的深度计算问题1情况1:fa>fb,且在读和写中都没有空闲周期; 2情况2:fa>fb,两个连续的读写之间有一个时钟周期延迟; 3️情况3:fa>fb,在读和写中都有空闲周期; 4️情况4:fa>fb,读写使能的占空比给定; 5️情况5:fa<fb,在读和写中都没有空闲周期; 6情况6:fa<fb,在读和写中都有空闲周期 7情况7:fa=fb,在读和写中都没有空闲周期。 8️情况8:fa=fb,在写和读中都有空闲周期 情况9:数据速率如下所示; 1️0情况10:以不同的形式给出写入和读取的规则。 对于读写同时进行的FIFO,有一个简便计算公式 FIFO的深度计算问题 FIFO的最小深度问题,可以理解为两个模块之间的数据传输问题;只有在读取速度慢于写入速度的情况下,我们才需要一个FIFO,来暂时的寄存这些没有被读出去的数据; 一个最主要的逻辑思想是: 确定FIFO的大小,就是要找到在写入过程中没有被读取的数据的个数;即FIFO的深度等于未被读取的数据的数量。 现在考虑一种实例,A时钟域数据发往B时钟域,将会出现以下几种情况: 1情况1:fa>fb,且在读和写中都没有空闲周期; 例如: 写入频率fa = 80MHz,读取频率fb = 50MHz。 突发长度即要写入的数据数目为120个。 计算如下: 写入一个数据需要的时间 = 1 / 80MHz = 12.5ns; 写入突发事件中所有数据需要时间 = 120 * 12.5 = 1500ns; 读取一个数所需时间 = 1 / 50MHz = 20ns; 所有数据写入完成后使用1500ns,1500ns可以读出数据为 = 1500 / 20 = 75个。 所以,要在FIFO中存储的剩余数据量为 120 - 75 = 45; 故:设计的FIFO的最小深度为45! 2情况2:fa>fb,两个连续的读写之间有一个时钟周期延迟; 这种情况和情况1一样,仅仅是人为的制造了某种混乱; 3️情况3:fa>fb,在读和写中都有空闲周期; 例如: 写入频率fa = 80MHz,读取频率fb = 50MHz。 突发长度即要写入的数据数目为120个。 两个连续的写之间空闲周期为1,两个连续的读之间空闲周期为3; 计算如下: 可以理解为每两个时钟周期写入一次数据,每四个时钟周期读出一个数据。 写入一个数据需要的时间 = 2 (1 / 80MHz) = 2 12.5 = 25ns; 写入突发事件中所有数据需要时间 = 120 * 25 = 3000ns; 读取一个数所需时间 = 4 (1 / 50MHz) = 4 20 = 80ns; 所有数据写入完成后使用3000ns,可以读出数据为 = 3000 / 80 = 37.5 ≈ 37个。 所以,要在FIFO中存储的剩余数据量为120 - 37 = 83; 故:设计的FIFO的最小深度为83! 4️情况4:fa>fb,读写使能的占空比给定; 例如: 写入频率fa = 80MHz,读取频率fb = 50MHz。 突发长度即要写入的数据数目为120个。 写使能占空比为50%,读使能占空比为25%。 这种情况和情况3一样,没有什么区别; 【注】这里的情况2️和情况4仅仅是为了说明同一个问题可以通过不同的方式来提问。 5️情况5:fa<fb,在读和写中都没有空闲周期; 例如: 写入频率fa = 30MHz,读取频率fb = 50MHz。 突发长度即要写入的数据数目为120个。 计算如下: 在这种情况下,深度为1的FIFO就足够了,因为不会有任何数据的丢失,因为读比写快。 6情况6:fa<fb,在读和写中都有空闲周期 例如: 写入频率fa = 30MHz,读取频率fb = 50MHz。 突发长度即要写入的数据数目为120个。 两个连续的写之间空闲周期为1,两个连续的读之间空闲周期为3; 计算如下: 可以理解为每两个时钟周期写入一次数据,每四个时钟周期读出一个数据。 写入一个数据需要的时间 = 2 (1 / 30MHz) = 2 33.33 = 66.667ns; 写入突发事件中所有数据需要时间 = 120 * 66.667 = 8000ns; 读取一个数所需时间 = 4 (1 / 50MHz) = 4 20 = 80ns; 所有数据写入完成后使用8000ns,可以读出数据为 8000 / 80 = 100个。 所以,要在FIFO中存储的剩余数据量为120 - 100 = 20; 故:设计的FIFO的最小深度为20 7情况7:fa=fb,在读和写中都没有空闲周期。 例如: 写入/读取频率fa = fb = 30MHz。 突发长度即要写入的数据数目为120个。 计算如下: 如果clka和clkb之间没有相位差,则不需要FIFO; 如果clka和clkb之间有一定的相位差,一个深度为“1”的FIFO就够了。 8️情况8:fa=fb,在写和读中都有空闲周期 例如: 写入频率fa = 50MHz,读取频率fb = 50MHz。 突发长度即要写入的数据数目为120个。 两个连续的写之间空闲周期为1,两个连续的读之间空闲周期为3; 计算如下: 可以理解为每两个时钟周期写入一次数据,每四个时钟周期读出一个数据。 写入一个数据需要的时间 = 2 (1 / 50MHz) = 2 20 = 40ns; 写入突发事件中所有数据需要时间 = 120 * 40 = 4800ns; 读取一个数所需时间 = 4 (1 / 50MHz) = 4 20 = 80ns; 所有数据写入完成后使用4800ns,可以读出的数据为4800 / 80 = 60个。 所以,要在FIFO中存储的剩余数据量为120 - 60 = 60; 故:设计的FIFO的最小深度为60! 情况9:数据速率如下所示; 例如: 写入80个数据,需要100个时钟周期,(写入的时钟随机); 读出8个数据,需要10个时钟周期,(读取的时钟随机)。 计算如下: ①上述表明,书写频率等于读出频率 ②读和写都可以在任何随机的时刻发生,以下是一些可能性。 图片 在上述情况中,完成写入所需的周期如下: 图片 在FIFO设计中,为了更稳妥的考虑,我们选择最坏的情况下进行数据传输,以此来设计FIFO的深度,以避免数据丢失; 最坏的情况即:写和读之间的数据率差异应该最大,因此对于写操作,考虑最大的数据速率,对于读操作,考虑最小的数据速率。 故:考虑上述可能性中的第四种情况(即所谓的“背靠背”情况): 计算如下: 160个时钟周期内,写入160个数据; 数据的读取率为8个数据/10个时钟周期; 在160个时钟周期内可以读取的数据量为:160 * 8 / 10 = 128。 因此,需要存储在FIFO中的剩余字节数为160 - 128 = 32。 故:设计的FIFO的最小深度为32! 1️0情况10:以不同的形式给出写入和读取的规则。 例如: fa = fb / 4; Tenb = Ta * 100; enb的占空比为25%。计算如下: 在这种情况下,就需要假设一些数值: 设:fb = 100MHz。则,fa = 1 / 4 * 100 = 25MHz。 则:Ta = 40ns,Tenb = 4000ns; 又因为写使能占空比25%。 则:写使能时间为4000ns / 4 = 1000ns。【注】此处认为fb为写时钟,因为只有这样,才能是写入的比读出的快,当然了,把fa当做写时钟,下面就没法算了,哈哈。 突发长度 = 1000ns / 10ns = 100个; 在写入的1000ns内,可以读出 1000ns / 40ns = 25个; 所以,要在FIFO中存储的剩余数据量为100 - 25 = 75; 故:设计的FIFO的最小深度为75!例如 假设两个异步时钟clk_a和clk_b,clk_a = 148.5M,clk_b = 140M。如图所示,clk_a时钟域中连续1920个16bit的数据通过data_valid标记,有效数据之后,紧接着720个无效数据时钟周期。请问,该数据通过异步fifo同步到clk_b时钟域,异步fifo的最小深度是多少?请写出计算过程。 图片 【解析】 考虑情况9️中case-4案例,即所谓的“背靠背”情况: 在a时钟域通过1920 * 2 = 3840个Ta传输3840个数据; Ta = 1 / 148.5MHz ≈ 6.734ns; Tb = 1 / 140MHz ≈ 7.143ns。 3840 * 6.734 = 25858.56ns; 在25858.56ns内,通过clk_b读取的个数为:25858.56 / 7.143 ≈ 3620个。 那么,剩余未读完的个数为3840 - 3620 = 220; 即FIFO的深度最小为220。【注】在此情况下,理解清楚规则非常之重要! 对于读写同时进行的FIFO,有一个简便计算公式 FIFO_Depth >= Burst_length -Burst_length (rd_clk/ wr_clk)(rd_rate) 最后,需要注意的是,我们在本文通篇计算的都是最小FIFO深度,但是在实际应用中,尤其是异步FIFO的应用中,需要使用格雷码计数,这就要求FIFO的深度为2的整数次幂,否则格雷码计数到最大值跳变为0时,将出现多位变化的情况,不符合设计。异步FIFO深度不是2的整数次幂情况下,则可能需要特殊处理,需要使用别的编码方式了。
FPGA&ASIC
# ASIC/FPGA
刘航宇
2年前
1
1,226
3
通讯等不确定性条件下设计无人机之间的安全距离
摘要本文针对无人机通信不确定性,提出基于分离原理的安全半径设计方法。通过仿真和实验验证,该方法有效提高了无人机飞行安全性和效率。关键词:无人机安全距离, 通信不确定性, 安全半径设计, 分离原理, 无人机控制器引用文章: 简介 1. 研究问题 2. 分离原理介绍 3. 安全半径设计 4. 仿真及实验验证 引用文章: Q. Quan, R. Fu and K. -Y. Cai, "How Far Two UAVs Should Be subject to Communication Uncertainties," in IEEE Transactions on Intelligent Transportation Systems, doi: 10.1109/TITS.2022.3213555. 简介 近年来,无人机技术的快速发展使得低空空域中无人机的数量爆炸增长。碰撞避免作为无人机应用的关键技术,近年来人们已经进行了大量研究,设计出各种方法使得无人机在飞行过程中与障碍物保持一定安全距离(本文将该距离称为无人机的 安全半径)。然而, 在碰撞避免相关研究中,不确定性往往是难以处理的问题。针对不确定性,主流的方法包括对不确定性进行预测,以及在闭环控制中给予补偿。然而,以上方法很依赖于预测及补偿的精准设计,设计不当将有可能导致控制器失效。本研究受地面交通中车辆间安全距离启发,基于对通信不确定性和无人机控制器性能的假设,提出了 安全半径设计和控制器设计的原则 (本文称为 分离原理 )。进一步,安全半径具体通常通过经验预先设计,如果设计得过大或过小将分别影响无人机飞行的高效性及安全性。 如何根据无人机模型及通信不确定性确定其安全半径下界仍然是悬而未决的问题 。利用分离原理,本文研究了 设计阶段(无不确定性)和飞行阶段(受不确定性影响)的无人机安全半径设计 。最后,通过仿真和实验表明了所提方法的有效性。 图片 1. 研究问题 本研究中,无人机与障碍物的运动模型均建模为多旋翼模型,换句话说,我们考虑的障碍物可以等效为另一架多旋翼飞行器。对于多旋翼飞行器而言,其可以获得自身以及障碍物的实时位置和速度。为简单描述起见,本文建模均为二维,类似的建模及分析方法可以扩展到三维情况。 我们首先建立多旋翼的具体控制模型如下。 其中多旋翼的位置和速度分别表示为 ,速度控制模型建立为一阶惯性环节,其时间常数 与无人机的机动性能相关,控制输入 为期望速度。在此基础上,本文定义一种新的滤波位置模型如下。 多旋翼滤波位置的物理意义是根据多旋翼的当前位置、速度及机动能力,对其运动趋势预测。在此基础上,定义多旋翼的安全区域为以滤波位置为圆心的圆形区域,其半径称为安全半径 。对于障碍物,我们类似定义其滤波位置,以及以障碍物滤波位置为圆心的圆形障碍物区域,半径称为障碍物半径 。 图片 进一步,我们针对不确定性做了以下2点假设:(1)无人机和障碍物对自身的三维位置及三维速度估计均存在噪声;(2)无人机在获取障碍物状态信息时,存在通信延迟及丢包。该通信网络模型如下图所示。 图片 本研究中,丢包模型进一步建模为均值模型,且假设估计噪声、通信延迟、丢包均值模型误差均存在上界且上界已知。其数学定义如下: 图片 进一步,本文对无人机的控制器性能做出如下假设:(1)在无不确定性的理想状态下,无人机的控制器可以使无人机和障碍物之间的 真实距离 始终大于给定安全距离;(2)在存在以上不确定性的实际情况中,无人机的控制器可以使无人机和障碍物之间的 估计距离 始终保持给定安全距离。本研究的具体目标是在不确定性上界已知的条件下计算出无人机安全半径的下界。 图片 2. 分离原理介绍 无人机在理想状态下设计的控制器中给定的安全半径值 ,在实际含有不确定性的环境中将转化为估计安全半径 ;直观上理解,将含有不确定性的无人机与障碍物之间的估计位置误差代替真实位置误差作为反馈时,控制器将难以维持给定的安全半径。本研究中, 分离原理具体研究的是不确定性在满足什么条件时无人机的控制器设计和安全半径设计过程可分离 ,也就是估计安全半径和安全半径相等, 成立。分离原理具体数学描述如下: 图片 分离原理中提出的三个条件包括一个充分必要条件(i)以及两个充分条件(ii)和(iii)。其中,条件(i)为理论推导,在实际中难以得到验证,通常可通过条件(ii)和(iii)进行验证。条件(ii)对无人机速度的限制较宽,该式在障碍物主动躲避无人机的条件下容易达成。反之,条件(iii)对无人机速度的限制较苛刻,要求无人机速度严格大于障碍物速度,适用于在障碍物不主动躲避无人机的情况下。以上两种情况的区别如下图所示。 图片 3. 安全半径设计 根据上述分离原理的提出,在分离原理满足的前提下,基于无人机的安全半径模型和通信网络模型,可以进一步设计 合适大小的无人机安全半径 。如前文所述,安全半径设计过大会增加环境的冗余度,设计过小则无法保证飞行过程的安全。在本研究中,给出了在理想情况下以及实际情况下安全半径的下界,分别如下: 图片 4. 仿真及实验验证 仿真及实验验证在仿真中,我们针对单障碍物、多非合作障碍物、多合作障碍物设计了三种场景来验证我们方法的有效性。在实验中,我们使用DJI tello无人机对以上情况进行测试,结果与我们的理论一致。实验视频: https://youtu.be/LkSDPFGa_1E 论文地址 https://rfly.buaa.edu.cn/pdfs/2022/How_far_two_UAVs_should_be_subject_to_communication_uncertainties.pdf
软硬件算法
# 软件算法
刘航宇
2年前
0
1,065
2
2024-07-05
Linux之不使用命令删除文件中的第N行
摘要本文介绍了三种方法在不使用命令的情况下,通过编程删除Linux文件中的指定行。方法包括使用临时文件、系统调用和直接操作文件指针,并提供了相应的C语言代码示例。关键词:Linux, 文件删除, 行号删除, 文件操作, 临时文件1.问题描述 2. 解题思路: 3. 代码实现: 1.问题描述 设计一个程序,通过命令行参数接收一个文件名 filename.txt (纯文本文件)和一个整型数字 n,实现从 filename.txt 中删除第 n 行数据。 2. 解题思路: (1) 借助临时文件: 将文件逐行读取,跳过要删除的行,并将其写入临时文件,然后删除源文件,重命名临时文件为源文件,完成删除指定行数据。 (2) 不借助临时文件: 将文件以读写方式打开,读取到要删除行后,通过移动文件指针将文件后面所有行前移一行,但是最后一行会重复,可以通过截断文件操作完成在源文件上删除指定行数据。 (3) 通过sed 或 awk 删除文件指定行 3. 代码实现: (1) 通过 fopen 打开文件借助临时文件删除指定行数据 #filename:ques_15a.c #include <stdio.h> // 包含标准输入输出库 #include <stdlib.h> // 包含标准库函数,比如exit int main(int argc, char *argv[]) { // 检查命令行参数的数量是否正确 if (argc != 3) { printf("Usage: ./a.out filename num\n"); exit(EXIT_FAILURE); // 如果不正确,打印用法信息并退出 } char buf[4096]; // 定义一个足够大的字符数组用于读取文件行 int linenum = atoi(argv[2]); // 将命令行参数中的行号转换为整数 FILE *fp = fopen(argv[1], "r"); // 尝试以只读模式打开源文件 FILE *fpt = fopen("temp.txt", "w"); // 创建一个临时文件用于写入 // 如果源文件无法打开,打印错误信息并退出 if (!fp) { printf("File %s not exist!\n", argv[1]); exit(EXIT_FAILURE); } // 检查是否有权限修改源文件 char str[100]; sprintf(str, "%s%s", "test -w ", argv[1]); if (system(str)) { // 如果没有写权限 printf("Can't modify file %s, permission denied!\n", argv[1]); exit(EXIT_FAILURE); // 打印错误信息并退出 } int total_line = 0; // 初始化文件总行数计数器 while (fgets(buf, sizeof(buf), fp)) { // 读取文件的每一行 total_line++; } fseek(fp, 0, SEEK_SET); // 将文件指针重置到文件的开头 // 如果要删除的行数大于文件的总行数,打印错误信息并退出 if (linenum > total_line) { printf("%d is greater than total_line!\n", linenum); exit(EXIT_FAILURE); } int i = 0; // 初始化当前行计数器 while (fgets(buf, sizeof(buf), fp)) { // 再次读取文件的每一行 i++; // 当前行数加1 if (i != linenum) { // 如果当前行不是要删除的行 fputs(buf, fpt); // 将当前行写入临时文件 } } remove(argv[1]); // 删除原始文件 rename("temp.txt", argv[1]); // 将临时文件重命名为原始文件名 // 关闭文件指针 fclose(fp); fclose(fpt); return 0; // 程序正常退出 }(2) 通过 Linux 系统调用 open 打开文件,需要自定义读取一行的函数,不借助临时文件删除指定行数据 # filename:ques_15b.c #include <stdio.h> // 包含标准输入输出库 #include <stdlib.h> // 包含标准库函数,比如atoi和exit #include <string.h> // 包含字符串操作函数,比如strlen #include <fcntl.h> // 包含文件控制的定义 #include <sys/stat.h> // 包含文件状态的定义 #include <sys/types.h>// 包含各种数据类型 #include <unistd.h> // 包含UNIX标准函数定义 // 函数声明:读取一行文件内容到缓冲区 int readline(int fd, char *buf) { int t = 0; // 用于记录读取的字符数 // 循环读取直到遇到换行符 for (; ;) { read(fd, &buf[t], 1); // 从文件描述符fd读取一个字符到buf t++; // 增加读取的字符数 if (buf[t-1] == '\n') { // 如果读取到换行符 break; // 退出循环 } } return t; // 返回读取的字符数 } // 函数声明:获取文件的大小和行数 int get_file_info(int fd, int *size) { int num = 0; // 记录行数 char ch; // 临时变量用于存储读取的字符 // 循环读取直到文件结束 while (read(fd, &ch, 1) > 0) { (*size)++; // 文件大小加1 if (ch == '\n') { // 如果读取到换行符 num++; // 行数加1 } } return num; // 返回行数 } int main(int argc, char *argv[]) { // 检查命令行参数数量 if (argc != 3) { printf("Usage: ./a.out filename num\n"); exit(EXIT_FAILURE); // 参数不正确时退出 } int fd; // 文件描述符 char buf[4096]; // 缓冲区 int linenum = atoi(argv[2]); // 将命令行参数转换为整数 // 尝试以读写模式打开文件 fd = open(argv[1], O_RDWR); if (fd < 0) { printf("Can't open file %s, file not exist or permission denied!\n", argv[1]); exit(EXIT_FAILURE); // 打开失败时退出 } int size = 0; // 文件大小 // 获取文件的行数和大小 int total_line = get_file_info(fd, &size); // 如果要删除的行数大于文件总行数,退出 if (linenum > total_line) { printf("%d is greater than total_line!\n", linenum); exit(EXIT_FAILURE); } int s = 0; // 要删除行的大小 int t = 0; // 当前行的大小 int i = 0; // 当前行数 lseek(fd, 0, SEEK_SET); // 将文件指针移到文件头 // 循环读取文件,直到文件结束 while (read(fd, &buf[0], 1) > 0) { lseek(fd, -1, SEEK_CUR); // 回退一个字符 memset(buf, 0, sizeof(buf)); // 清空缓冲区 readline(fd, buf); // 读取一行到缓冲区 i++; // 行数加1 t = strlen(buf); // 当前行的大小 // 如果当前行是目标行,记录其大小 if (i == linenum) { s = t; } // 如果当前行在目标行之后,将该行前移 if (i > linenum) { lseek(fd, -(s+t), SEEK_CUR); // 移动文件指针 write(fd, buf, strlen(buf)); // 写入当前行 lseek(fd, s, SEEK_CUR); // 移动文件指针 } } ftruncate(fd, size-s); // 截断文件,删除指定行 close(fd); // 关闭文件描述符 return 0; // 正常退出 }(3) 通过 fopen 打开文件,不借助临时文件删除指定行数据 # filename:ques_15b.c #include <stdio.h> // 包含标准输入输出库 #include <stdlib.h> // 包含标准库函数,如atoi和exit #include <string.h> // 包含字符串处理函数,如strlen #include <math.h> // 包含数学函数,虽然在这个程序中没有使用 #include <unistd.h> // 包含UNIX标准函数,如truncate int main(int argc, char *argv[]) { // 检查命令行参数个数是否正确 if (argc != 3) { printf("Usage: ./a.out filename num\n"); exit(EXIT_FAILURE); // 参数不正确时退出程序 } int linenum = atoi(argv[2]); // 将命令行中指定的行号转换为整数 char buf[4096]; // 定义缓冲区,用于读取文件内容 // 尝试以读写模式打开文件 FILE *fp = fopen(argv[1], "r+"); // 如果文件无法打开,打印错误信息并退出程序 if (!fp) { printf("Can't open file %s, file not exist or permission denied!\n", argv[1]); exit(EXIT_FAILURE); } int total_line = 0; // 记录文件的总行数 int size = 0; // 记录文件的总大小 // 循环读取文件直到文件末尾,计算总行数和总大小 while (fgets(buf, sizeof(buf), fp)) { size += strlen(buf); // 累加每行的长度 total_line++; // 行数加1 } // 如果要删除的行数大于文件的总行数,打印错误信息并退出程序 if (linenum > total_line) { printf("%d is greater than total_line!\n", linenum); exit(EXIT_FAILURE); } int s = 0; // 记录要删除的行的大小 int t = 0; // 记录当前读取行的大小 int i = 0; // 记录当前行数 fseek(fp, 0L, SEEK_SET); // 将文件指针重置到文件开头 // 再次循环读取文件,准备删除指定行 while (fgets(buf, sizeof(buf), fp)) { i++; // 当前行数加1 t = strlen(buf); // 当前行的长度 // 如果当前行是要删除的行,记录其大小 if (i == linenum) { s = t; } // 如果当前行在要删除的行之后,将其前移 if (i > linenum) { fseek(fp, -(s+t), SEEK_CUR); // 将文件指针移动到正确的位置 fputs(buf, fp); // 写入当前行 fseek(fp, s, SEEK_CUR); // 将文件指针向前移动s个字节 } } // 截断文件,删除指定行 truncate(argv[1], size-s); // 关闭文件指针 fclose(fp); return 0; // 正常退出程序 }(4) 这三个删除文件指定行的函数都需借助临时文件完成
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
511
1
2024-06-27
FPGA/数字IC-常考八股
摘要本文介绍了FPGA/数字IC设计中的关键概念,包括时间概念、亚稳态产生与防止、多时域设计、竞争与冒险现象、锁存器与寄存器区别、阻塞与非阻塞赋值、流水线设计、函数与任务、不可综合Verilog语句等,旨在帮助读者深入理解FPGA/数字IC设计原理。关键词:FPGA, 数字IC, 时钟域同步, 亚稳态, 竞争冒险各种时间概念 亚稳态的产生 如何防止亚稳态? 多时域设计中,如何处理信号跨时域? 什么是竞争与冒险现象?怎样判断?如何消除? 锁存器(Latch)和寄存器(Flip-Flop)概念和区别 `timescale 阻塞赋值&非阻塞赋值 流水线 函数&任务 不可综合verilog语句 一些小计算总结 各种时间概念 建立时间(setup time)是指在触发器的时钟信号上升沿到来以前,数据稳定不变的时间,如果建立时间不够,数据将不能在这个时钟上升沿被打入触发器。 保持时间(hold time)是指在触发器的时钟信号上升沿到来以后,数据稳定不变的时间,如果保持时间不够,数据同样不能被打出触发器。 图片 传输延时(transmission delay)数据相对于时钟上升沿tc-q后从触发器输出至Q端,则tc-q称为寄存器的传输延时 恢复时间(recovery time)原本有效的复位信号释放后,与紧跟其后的第一个时钟上升沿之间的最小时间。 清除时间(removal time)时钟信号的上升沿,与紧跟其后异步复位信号从有效到无效的最小时间。 亚稳态的产生 在FPGA系统中,如果数据传输中不满足触发器的 Tsu 和 Th 不满足,或者复位过程中复位信号的释放相对于有效时钟沿的恢复时间(recovery time)不满足,就可能产生亚稳态,此时触发器输出端Q在有效时钟沿之后比较长的一段时间处于不确定的状态,在这段时间里Q端在0和1之间处于振荡状态,而不是等于数据输入端D的值。这段时间称为决断时间(resolution time)。经过resolution time之后Q端将稳定到0或1上,但是稳定到0或者1,是随机的,与输入没有必然的关系。 如何防止亚稳态? 亚稳态是指触发器无法在某个规定时间段内达到一个可确认的状态。当一个触发器进入亚稳态时,既无法预测该单元的输出电平,也无法预测何时输出才能稳定在某个正确的电平上。在这个稳定期间,触发器输出一些中间级电平,或者可能处于振荡状态,并且这种无用的输出电平可以沿信号通道上的各个触发器级联式传播下去。 解决方法: 1 降低系统时钟频率 2 用反应更快的FF 3 引入同步机制,防止亚稳态传播(加两级D触发器)。 4 改善时钟质量,用边沿变化快速的时钟信号 多时域设计中,如何处理信号跨时域? 不同的时钟域之间信号通信时需要进行同步处理,这样可以防止新时钟域中第一级触发器的亚稳态信号对下级逻辑造成影响。 解决方法: 1 信号跨时钟域同步:当单个信号跨时钟域时,可以采用两级触发器来同步; 2 数据或地址总线跨时钟域: 可以采用异步 FIFO 来实现时钟同步; 3 第三种方法就是采用握手信号。 什么是竞争与冒险现象?怎样判断?如何消除? 在组合电路中, 门电路两个输入信号同时向相反的逻辑电平跳变称为竞争;由于竞争而在电路的输出端可能产生尖峰脉冲的现象称为竞争冒险。 (也就是由于竞争产生的毛 刺叫做冒险)。 判断方法: •代数法: 如果布尔式中有相反的信号则可能产生竞争和冒险现象,即逻辑函数在一定条件 下可以化简成 Y=A+A’或 Y=AA’则可以判断存在竞争冒险现象(只是一个变量变化的情况) ; •卡诺图:有两个相切的卡诺圈并且相切处没有被其他卡诺圈包围,就有可能出现竞争冒险; •实验法+观察法:示波器观测; 解决方法: 1:加滤波电容,消除毛刺的影响; 2:加选通信号,避开毛刺; 3:增加冗余项消除逻辑冒险。 锁存器(Latch)和寄存器(Flip-Flop)概念和区别 电平敏感的存储器件称为锁存器。可分为高电平锁存器和低电平锁存器,用于不同时钟之间的信号同步。 有交叉耦合的门构成的双稳态的存储原件称为触发器(寄存器)。分为上升沿触发和下降沿触发。可以认为是两个不同电平敏感的锁存器串连而成。前一个锁存器决定了触发器的建立时间,后一个锁存器则决定了保持时间。 latch 是电平触发, register 是边沿触发。 register 在同一时钟边沿触发下动作,符合同步电路的设计思想,而 latch 则属于异步电路设计,往往会导致时序分析困难,不适当的应用 latch 则会大量浪费芯片资源。 `timescale `timescale 1ns / 1ps,含义为:时延单位为1ns,时延精度为1ps 在仿真文件里面需要写,例如 `timescale 10 ns / 1 ns //单位10ns,精度1ns module test; reg set; initial begin #1 set = 0; //1*10 ns = 10ns #10 set = 1; //10*10ns = 100ns end endmodule阻塞赋值&非阻塞赋值 阻塞赋值“=”属于顺序执行,即下一条语句执行前,当前语句一定会执行完毕 非阻塞赋值“<=”属于并行执行语句,即下一条语句的执行和当前语句的执行是同时进行的 在设计电路时,always 时序逻辑块中多用非阻塞赋值,always 组合逻辑块中多用阻塞赋值;在仿真电路时,initial 块中一般多用阻塞赋值 不要在一个过程结构中混合使用阻塞赋值与非阻塞赋值 流水线 流水线设计是verilog设计中基本功之一,是对组合逻辑系统的分割,并在各个部分之间插入寄存器,并暂存中间数据的方法。 流水线操作的目的是把一个大操作分解为若干小操作,因为每一步操作变小了,所以时间更短,频率更快(面积换时间)。流水线在理各个阶段都需要增加寄存器保存中间计算状态,而且多条指令并行执行会导致功耗增加,硬件复杂度增加 函数&任务 函数返回一个值,而任务则不返回值 函数至少要有一个输入变量,而任务可以没有或有多个任何类型的变量。 函数只能与主模块共用同一个仿真时间单位,而任务可以定义自己的仿真时间单位。 函数不能启动任务,而任务能够启动其他任务和函数。 不可综合verilog语句 (1)initial:只能在test bench中使用,不能综合。 (2)events:event在同步test bench时更有用,不能综合。 (3)real:不支持real数据类型的综合。 (4)time:不支持time数据类型的综合。 (5)force 和release:不支持force和release的综合。 (6)assign 和deassign:不支持对reg 数据类型的assign或deassign进行综合,支持对wire数据类型的assign或deassign进行综合。 (7) fork join:不可综合,可以使用非块语句达到同样的效果。 (8) primitives:支持门级原语的综合,不支持非门级原语的综合。 (9) table:不支持UDP 和table的综合。 (10) 敏感列表里同时带有posedge和negedge 如:always @(posedge clk or negedge clk) begin...end 这个always块不可综合。 (11) 同一个reg变量被多个always块驱动 (12) 延时 以#开头的延时不可综合成硬件电路延时,综合工具会忽略所有延时代码,但不会报错。 如:a=#10 b; 这里的#10是用于仿真时的延时,在综合的时候综合工具会忽略它。也就是说,在综合的时候上式等同于a=b; (13) 与X、Z的比较 可能会有人喜欢在条件表达式中把数据和X(或Z)进行比较,殊不知这是不可综合的,综合工具同样会忽略。所以要确保信号只有两个状态:0或1。 功耗(Power)等于处理器上的电流值与电压值的乘积,可以反应处理器最大负荷运行、满载工作时电流热效应造成热量释放的大小指标,单位为瓦(W)。总功耗由静态和动态两部分组成 PGA芯片内有两种存储器资源:一种叫block ram,另一种是由LUT配置成的内部存储器(也就是分布式ram)。block ram由一定数量固定大小的存储块构成的,使用block ram,不占用额外的逻辑资源,并且速度快。但是使用的时钟消耗block ram的资源是其大小的整数倍。 FPGA时钟结构:全局时钟、局部时钟和I/O时钟 MMCM、PLL即时钟管理模块,用来消除时钟的延迟、抖动以及产生各种不同频率的时钟。 MMCM相对PLL的优势就是相位可动态调整,但PLL占用的面积更小。 一个属于单片机STM32(顺序处理) ,一个属于可编程阵列FPGA(并行处理) RAM随机读取存储器,掉电丢失 ROM只读存储器 Flash memory 是“闪存” EEPROM可以一次只擦除一个字节 单端口RAM:只有一组地址线数据线 伪双口RAM,一个端口只读,一个端口只写 同步复位&异步复位 同步复位:只有在时钟沿到来时复位信号才起作用,复位信号持续的时间应该超过一个时钟周期才能保证系统复位 异步复位:复位信号容易受到毛刺的影响。复位结束时刻恰在亚稳态窗口内时 异步复位同步释放最好 当异步复位有效时,复位信号立刻复位 信号释放时,会在时钟上升沿来临时,才可以恢复 一些小计算总结 %0表示用最少位数表示 进行取模运算%时,结果值的符号位采用模运算式里第一个操作数的符号位 对于有符号数来说: 若符号位为1,使用>>>,高位补1; 若符号位为0,使用>>>,高位补0; 对于无符号数来说,无论最高位是什么,使用>>>,高位都补0。 标识符可以是任意一组数字、字母、$符合和下划线的组合,但第一个字符必须是字母或者下划线
FPGA&ASIC
# ASIC/FPGA
刘航宇
2年前
0
2,476
6
2024-06-27
基础概念:中断、任务、进程、线程、RTOS、Linux
摘要本文介绍了中断、任务、进程、线程等基本概念,并阐述了它们在多任务操作和资源管理中的角色。同时,对比了RTOS和Linux在设计目标、实时性、调度策略等方面的差异。关键词:中断, 任务, 进程, 线程, RTOS中断 任务 进程 线程 它们之间的区别 RTOS和Linux的区别 中断、任务、进程和线程是计算机科学和操作系统中的基本概念,它们在多任务操作和资源管理中扮演着重要的角色。下面是这些概念的简要解释以及它们之间的区别: 中断 中断是硬件或软件发出的信号,用来通知CPU暂停当前的工作,转而去执行一个特殊的程序(中断处理程序)。中断可以是外部的,比如来自硬件设备的信号,或者是内部的,比如软件生成的信号。中断机制允许操作系统响应外部事件,如用户输入或硬件状态变化。 任务 在某些操作系统中,任务是一个抽象概念,用来表示一个执行单元,它可以是一个进程或者线程。任务通常指的是需要操作系统调度和资源管理的执行流。 进程 进程是操作系统分配资源和调度的基本单位。每个进程都有自己的地址空间、数据栈以及其他用于跟踪进程状态和执行的资源。进程可以包含一个或多个线程。 线程 线程是进程中的一个实体,是CPU调度和执行的单位。线程共享所属进程的资源,但拥有自己的堆栈和程序计数器。线程比进程更轻量级,创建和切换的开销更小。 它们之间的区别 资源分配:进程是资源分配的最小单位,线程则不是。 执行:进程是执行程序的实例,线程是进程中的实际执行流。 地址空间:进程有独立的地址空间,线程共享进程的地址空间。 创建开销:进程的创建开销通常大于线程。 通信:线程间可以通过共享内存进行通信,进程间通信需要使用IPC(进程间通信)机制。 RTOS和Linux的区别 RTOS(实时操作系统)和Linux是两种不同类型的操作系统,它们在设计目标和特性上有所区别: 设计目标: RTOS:设计用于需要快速、可预测响应的系统,如嵌入式系统、工业控制等。 Linux:是一个通用操作系统,主要用于桌面、服务器、移动设备等。 实时性: RTOS:提供确定的响应时间,可以保证任务在指定的时间内得到处理。 Linux:虽然可以配置为实时系统,但通常不具备RTOS的严格实时性。 调度策略: RTOS:通常使用基于优先级的抢占式调度。 Linux:使用完全公平调度器(CFS)进行调度,可以配置为实时调度。 内存管理: RTOS:通常有简单的内存管理机制,适合资源受限的环境。 Linux:具有复杂的内存管理机制,支持虚拟内存和内存共享。 应用场景: RTOS:适用于对实时性要求高、资源受限的场合。 Linux:适用于需要高度灵活性和扩展性的场合。 开源和社区支持: RTOS:有些RTOS是开源的,但社区规模通常小于Linux。 Linux:是一个开源项目,拥有庞大的社区和开发者支持。 总的来说,RTOS和Linux各有优势,选择哪个系统取决于应用的具体需求。RTOS适合对实时性要求极高的场景,而Linux适合需要高度灵活性和功能丰富的环境。
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
955
2
Verilog语言实现读写txt文件方法
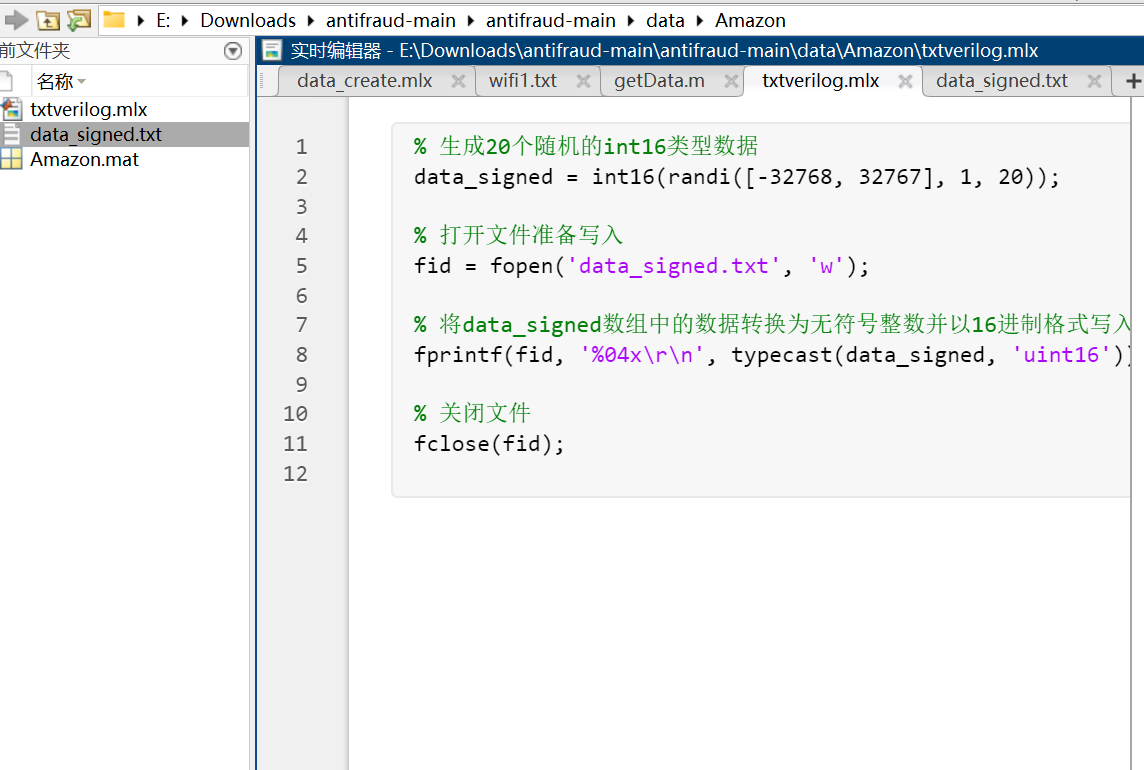
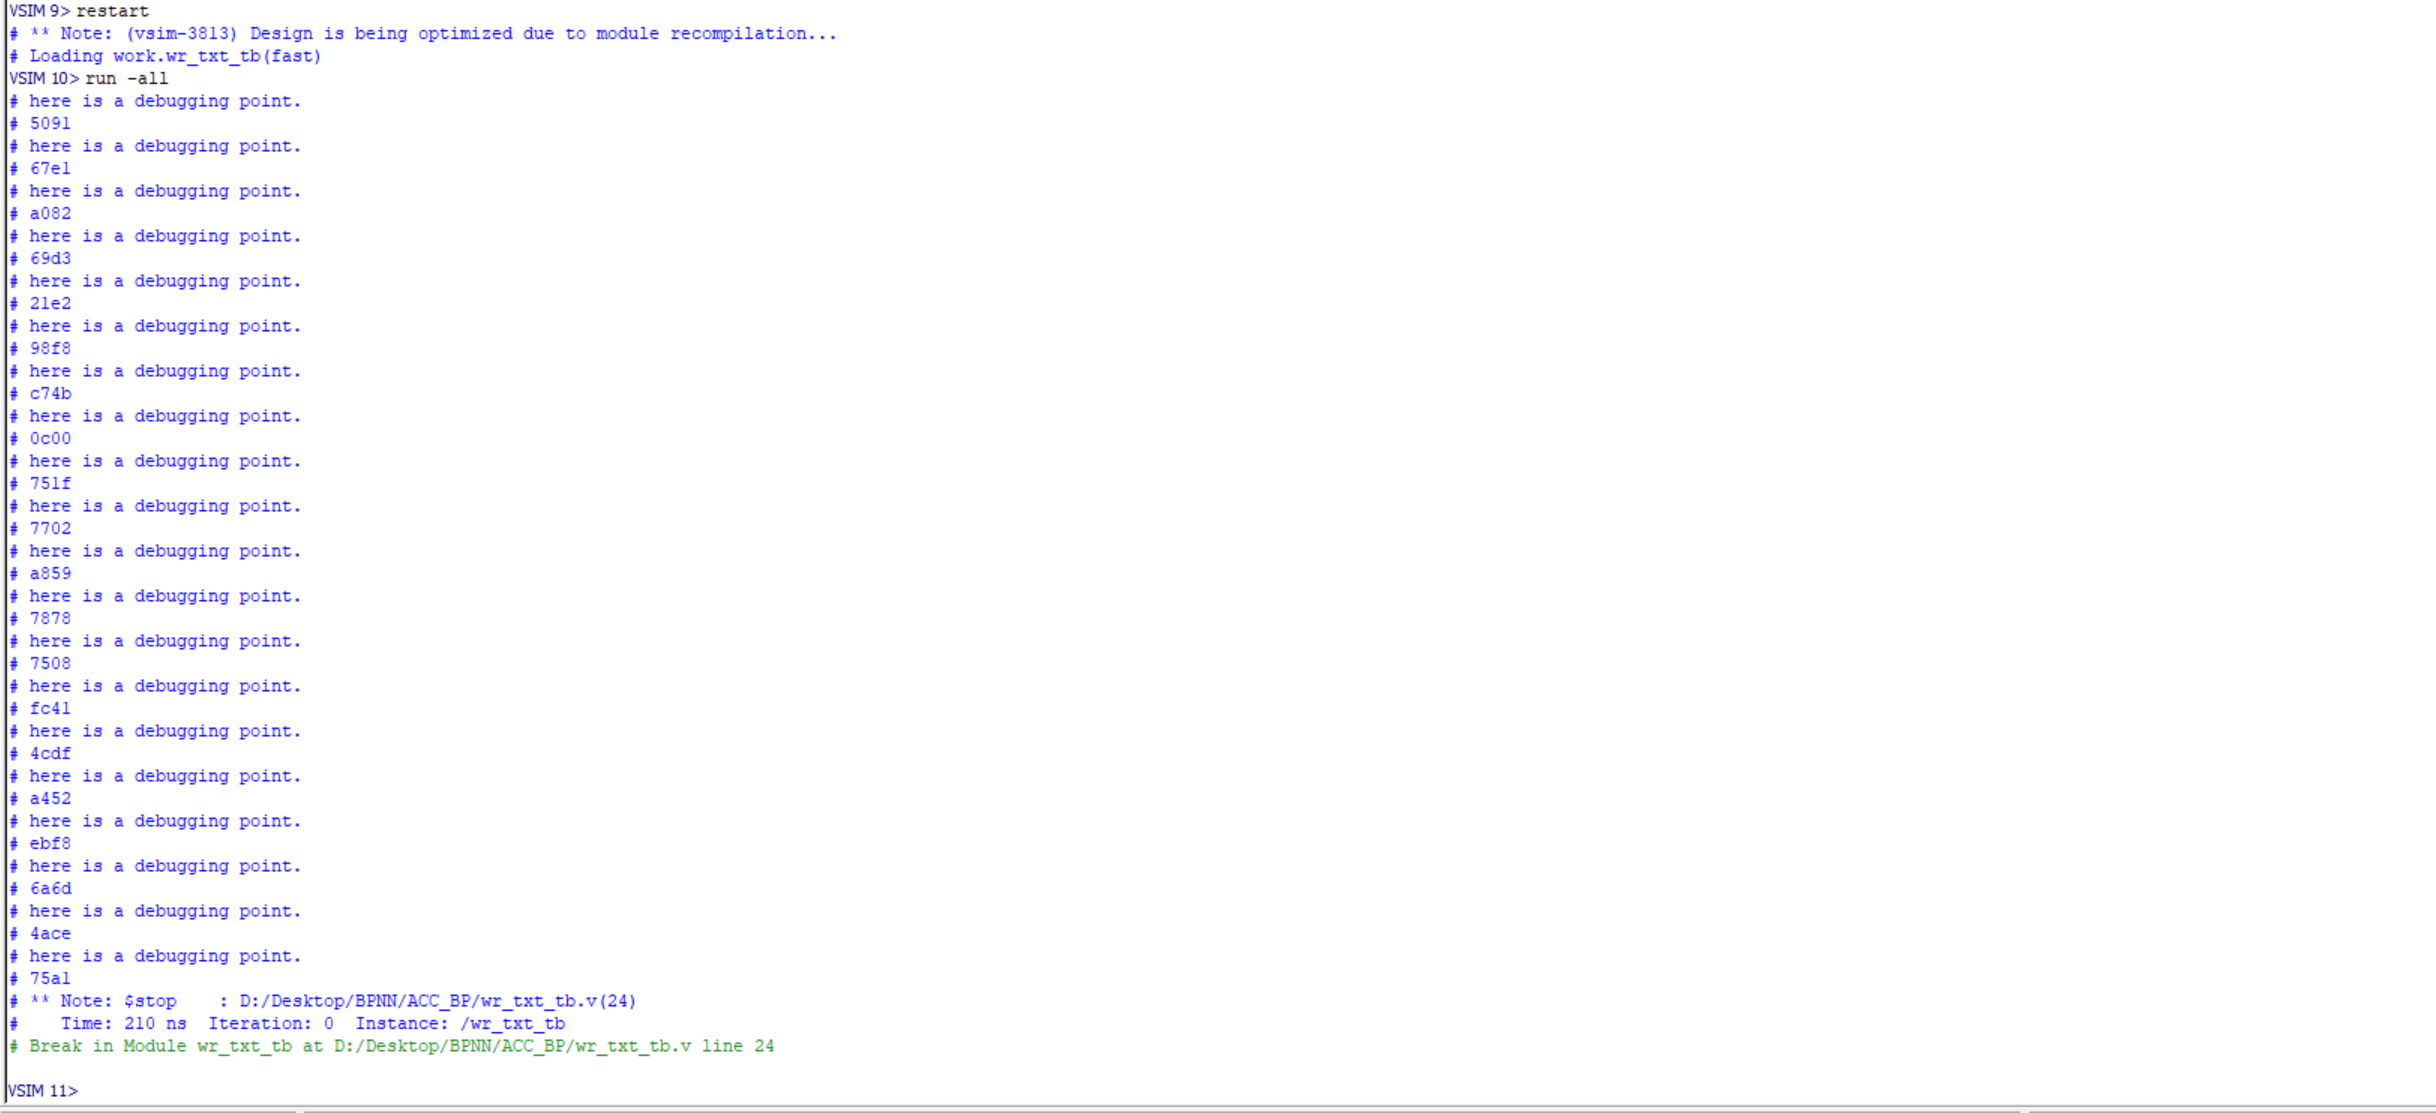
摘要本文介绍了Verilog语言中读写txt文件的方法。首先,通过MATLAB生成txt文件,并转换为十六进制格式。然后,在testbench中读取txt文件数据到寄存器,并按地址读取。接着,展示了如何写入txt文件,并提供了示例代码。最后,介绍了使用$display语句进行调试的方法。关键词:Verilog, 文件读写, txt文件, 测试集, 预测结果随着项目难度递增,例如AI芯片设计,不免需要验证Verilog的功能性,那么输入可以是测试集.txt,输出为预测结果/精确率.txt。下面讲解一下Verilog如何实现读写txt文件 一、读txt文件 二、写txt文件 $display语句的使用 demo案例 一、读txt文件 1、准备一个txt文件 MATLAB上生成的txt文件的格式为每行一个数据,与coe文件不同的是,数据之间没有逗号。由于verilog的读txt的系统函数仅仅能识别十六进制和二进制数据,一般情况下,将数据转换为十六进制数比较方便。当数据为有符号数时,可以采用下面的方式生成txt文件: % 生成20个随机的int16类型数据 data_signed = int16(randi([-32768, 32767], 1, 20)); % 打开文件准备写入 fid = fopen('data_signed.txt', 'w'); % 将data_signed数组中的数据转换为无符号整数并以16进制格式写入文件 fprintf(fid, '%04x\r\n', typecast(data_signed, 'uint16')); % 关闭文件 fclose(fid);图片 图片 其中,typecast(int16(data_signed),‘uint16’) 可以将数据转变为补码形式。同时,需要注意的是,在换行中,需要采用’\r\n‘,不能仅仅使用’\r’ 2、在testbench上读写 读txt文件时,一般选择先将txt中的数据置入寄存器memory中,然后按照地址读出memory中的数据。 reg [15:0] mem [0:1023]; reg [9:0] addr ; reg [11:0]data_out ; initial begin $readmemh("E:/self-study/VIVADO_workspace/prj/data_signed.txt",mem); addr = 10'd0; end always #10 begin data_out = mem[addr][11:0]; addr = addr + 10'd1; end需要注意的是,txt文件的地址不能出错,另外,注意地址分隔符需要用’/‘,windos系统中的’\‘需要对应改过来才能使用。 二、写txt文件 integer handle; initial begin handle = $fopen("E:/self-study/VIVADO_workspace/prj/data_out.txt"); end always@(posedge sys_clk) begin if(data_in_valid) begin $fdisplay(handle,"%d",data_out); end end利用initial函数初始化handle的值,另外,地址分隔符同样要改回来。 如果仿真之后,txt文件中并没有内容,可以尝试刷新一下txt文件。如果还没有内容出现,则就是txt文件没有关闭造成的,解决方法有两种: ①直接关闭xsim仿真程序,此时txt文件自动关闭,内容出现。 ②使用$fclose函数关闭文件,如果使能变量aagc_in_valid是一段高电平信号,则可以检测该信号的下降沿,在此时关闭文件即可: reg [2:0] valid_reg; always@(posedge sys_clk) begin valid_reg <= {valid_reg[1:0],data_in_valid}; if(valid_reg == 3'b110) begin $fclose(handle); end end甚至于,直接写一个计数器,也是可以的。 $display语句的使用 在功能仿真阶段调试程序时,$display是很有用的一段程序,它和java,c语言中的打印语句使用方法是相似的,可以把变量和语句运行状况打在TCL log的窗口上,供调试者知晓代码运行情况。 $display("here is a debugging point."); $display("%d", data_in);demo案例 module wr_txt_tb; reg [15:0] mem [0:1023]; reg [9:0] addr; reg [15:0] data_out; initial begin $readmemh("E:/Downloads/data_signed.txt", mem); addr = 10'd0; end always #10 begin if (addr < 10'd20) begin // 假设您只想读取前20个数据 data_out = mem[addr][15:0]; addr = addr + 10'd1; $display("here is a debugging point."); $display("%h", data_out); // 以十六进制形式打印 end else begin $stop; // 结束仿真 end end endmodule图片 图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
2年前
0
1,460
4
上一页
1
2
3
...
27
下一页