🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,263 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,790 阅读
3
【高数】形心计算公式讲解大全
9,138 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,203 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,923 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
ed(共165篇)
找到
165
篇与
ed
相关的结果
- 第 2 页
2026-07-17
电子信息类专业考研-简历-就业宝藏公众号:843电子信息站
摘要本公众号为电子信息类专业学生提供技术、考研、就业信息,涵盖技术栈、考研课程、简历、项目辅导与就业指导,助力学生提升竞争力。关键词:电子信息专业, 考研指导, 就业信息, FPGA技术, 嵌入式开发电子信息类专业(通信、电子、集成电路、人工智能等)的同学们,大学四年或硕士三年转瞬即逝,考研、实习、求职三座大山接踵而至。信息差,往往比努力更致命。 从技术、考研到就业,本博客和公众号843电子信息站将会给大家带来很多信息差上的帮助。 技术栈 考研栈 简历与就业栈 升学与就业规划 技术栈 可以关注EE学术-刘航宇的博客https://ee.ac.cn/,本博客包含嵌入式、FPGA、数字IC领域多项基础知识以及实战项目,非常适合找工作的宝子们,以此来提高笔试和面试机会。 有任何FPGA或嵌入式项目开发问题欢迎留言或者加博主,可以辅导解答。 pasted_1784268982839_xjdg8h.png图片 FPGA、STM32视频教程可以关注我的哔站 https://space.bilibili.com/470370345 pasted_1784272934372_eu8hjd.png图片 考研栈 欢迎大家报考考研西北大学843电子信息类专业:新一代电子信息技术、电子科学与技术、信息与通信工程专业,西大在行业认可度属于比较高的,毕业生可去央国企、华为、腾讯等大厂。 推荐的843专业考研课程网站(学习通上课): https://edu.ee.ac.cn/ 简历与就业栈 可关注微信公众号:843电子信息站,致力于电子工程-FPGA与嵌入式技术的分享、电子信息就业信息分享;FPGA与嵌入式项目开发与辅导;西北大学843考研模电、数电、电路指导等。 pmycSqU.png图片 升学与就业规划 可参考本站文章:《电子信息类专业升学与就业规划,FPGA与嵌入式领域本科硕士均适用》 https://ee.ac.cn/index.php/archives/688.html
我的随笔
# ASIC/FPGA
# 嵌入式
# 随笔
# 西北大学843
刘航宇
7月17日
0
190
6
国家线已出,26复试与27届考研西北大学843电子信息该如何准备?
摘要西北大学843电子信息考研,26届复试需联系导师,关注时间节点,准备专业课笔试、面试和实验操作;27届初试需刷真题,关注招生简章变动。西大认可度高,不歧视双非,建议早规划,执行力比计划更重要。关键词:西北大学, 843电子信息, 考研复试, 初试准备, 专业课学习🔥 26届复试党(迫在眉睫版) 🌱 27届考研党(早鸟规划版) 27考研概况 843专业招生人数 考试科目 初试题型与分值 下面针对新生常见提问的一些问答: 国家线终于出了是264分!考西北大学843电子信息的宝子们看过来,这篇一次性说清26届复试和27届初试该怎么准备! 图片 peSlNL9.png图片 🔥 26届复试党(迫在眉睫版) 先联系导师,选导师!!提前占据自己喜欢的研究方向 ⏰ 时间节点要记牢 国家线公布后1-2周内,西大自划线+复试名单就会出 复试一般安排在3月底-4月初 📋 西北大学复试考什么?843电子信息复试通常包含: 专业课笔试 综合面试 实验操作 💡 现阶段必做3件事: 速查官网 → 按研究生网站或提供的资料看以往复试细则 联系导师 → 邮件模板准备好,附上简历+初试成绩 狂补专业课 → 重点看初试没考但复试常考的内容 💬 西大复试很公平,不歧视双非!本科没项目也别慌,把毕业设计吃透也能聊! 推荐的复试指导班和资料 ✅26 届 843 复试指导课仅需31(资料整理服务费68) 不到一顿饭钱轻松助你考研一臂之力,报名链接👉 https://mooc1.chaoxing.com/course/portal/f4Jg9QrC9ticE_Jwt1BcCA peSuvvj.png图片 peSlNL9.png图片 🌱 27届考研党(早鸟规划版) 📌 843电子信息考情速览 初试科目:政治、英语一、数学一、843电子基础综合 参考书:模电、数电和电路 🗓️ 全年时间轴(建议版) 图片 全科真题模拟;专业课刷西大历年真题(重点!) ⚠️ 西大843避坑提醒: 真题重复率不低!务必搞到近10年真题(报名27课程或者考研Q群519462257获取) 电路计算题要动手算,别只看不做 关注电子学院和计算机学院官网,9月看招生简章有无变动 推荐的初试系统全程班和资料(报名特惠488,该班级会送复试) ✅27 届 843 电子通信考研系统班:从基础划重点到真题逐题讲,还有复试全程指导,赠送 07-26 年 843/849 真题 + 笔记课件 + 复试资料包,报名链接👉https://mooc1.chaoxing.com/course/260044360.html peSlIW8.png图片 peSlNL9.png图片 请记住: 初试分数是硬道理,复试表现是加分项 别被"本科出身"焦虑绑架,西大真的很公平 现在准备完全来得及,执行力比完美计划更重要 27考研概况 西北大学在大厂如华为、中兴、腾讯和阿里的认可度一向不错,西北大学电子信息类专业在211中报名人数一直较少,21~25年,这几年来看,复试分数线一直都是国家线或者比国家线高几分,因此从报考性价比和上岸概率来说无疑是个不错的选择! 843专业招生人数 新一代电子信息专硕专硕专硕120人左右,电子科学与技术(学硕)20人左右,信息与通信工程(学硕)20人左右 考试科目 模电、数电、电路----(三门课不少章节不考,考的不算多) 初试题型与分值 初试:三门,每门2~3题,每科目占50分 考察基础理解程度 下面针对新生常见提问的一些问答: 问:西北大学843就业情况如何? 答:就业不错,高的有年薪50~60W的,也低的也有18W、15W的,每年有不少去大厂、银行的。 问:西北大学843三个专业初试是一样的吗? 答:完全一样,卷子也一样,复试略有不同 问:我本科不是电子信息类专业可以报名吗? 答:可以,不歧视,根据以往843考研班统计结果来看,是有不少跨专业上岸的,跨幅最大是本科土木 问:我本科是二本,专升本可以吗? 答:可以报名,考试流程都是正常的,对于这类学生可能存在自身学习能力低下,但是只要努力就会有结果,根据以往843考研班统计结果:每年都有二本上岸的,2024年有两位是专升本过来的 问:有没有843考研交流群? 答:有,推荐下面这个843群有500多人QQ群号:519462257QQ群号:519462257QQ群号:519462257 点击快速加入,西大843QQ交流大群 问:843初试都有考哪些东西? 答:模电,数电,电路分析三本书,不过不少地方不考,不用太担心!如果不知道重点可以进一步问学长 问:是否有推荐的靠谱843课程班或资料? 答:下面两个链接是推荐的843班 https://edu.ee.ac.cn/ https://mooc1.chaoxing.com/course/260044360.html peS1nSO.png图片 peSlNL9.png图片 如果只是需要考研初试复试真题资料话可以联系学长哦~ 问:843复试难吗,歧视双非吗? 答:不难中规中矩,不歧视双非,每年有二本上岸的,双非压线上岸的 问:843报考专业如何选择? 答:这个开放的,大家可能根据自己本科专业或者喜好进行选择,学硕毕业要求会难一些,其次招生人数也会少一些
我的随笔
# 西北大学843
刘航宇
1年前
0
2,701
5
2025-01-09
【FPGA】AXI DMA详解
摘要本文详细介绍了AXI DMA的工作原理、ZYNQ中的DMA类型、AXI DMA IP核的配置和使用方法,包括Direct Register模式、Scatter/Gather模式和Cyclic DMA模式,以及AXI DMA的参数和接口分析。关键词:FPGA, AXI DMA, DMA传输, ZYNQ, 数据搬运<DMA简介 ZYNQ DMA简介 三、AXI DMA IP简介 四、AXI DMA参数与接口分析 Xilinx FPGA里面的AXI DMA IP核的简单用法 DMA简介 DMA是一种内存访问技术,允许某些计算机内部的硬件子系统可以独立的直接读写内存,而不需要CPU介入处理,从而不需要CPU的大量中断负载,否则,CPU需要从来源把每一片段的数据复制到寄存器,然后在把他们再次写回到新的地方,在这个时间里,CPU就无法执行其他的任务。 DMA是一种快速数据传送方式,通常用来传送数据量较多的数据块。使用DMA时,CPU向DMA控制器发送一个存储器传输请求,这样当DMA控制器在传输的时候,CPU执行其他的操作,传输完成时DMA以中断的方式通知CPU。 DMA传输过程的示意图为: 图片 DMA的传输过程为: 1、为了配置用DMA传输数据到存储器,处理器(Cortex-A9)发出一条指令。 2、DMA控制器把数据从外设传输到存储器或者从存储器传输到存储器,从而较少CPU处理的事务量。 3、输出传输完成后,向CPU发出一个中断通知DMA传输可以关闭。 为了发起传输事务,DMA控制器必须得到以下信息: (1)、源地址——数据被读出的地址 (2)、目的地址——数据被写入的地址 (3)、传输长度——应传输的字节数 ZYNQ DMA简介 ZYNQ提供了两种DMA,一种是集成在PS中的硬核DMA,另一种是PL中使用的软核AXI DMA IP。 在ARM APU(Application Processor Unit,应用处理单元)设计过程中,已经考虑到大量数据搬移的情况,因此在APU中自带了一个DMA控制器DAMC,这个DMAC驻留在PS内,而且必须通过驻留在内存中的DMA指令编程,这些程序往往需要CPU准备,因此需要部分的CPU参与。DMAC支持多达8个通道,所以多个DMA结构的核可以挂载在单个DMAC上。 DMAC与PL的连接是通过AXI-GP接口,这个接口最高支持到32位宽,这也限制了这种模式下的传输速率,理论上最大为600MB/s,这种模式不占用PL资源,但需要对DMA指令编程,会增加软件的复杂性。 为了获取更高的速率,可以空间换时间,在PL中添加AXI DMA IP core,并利用AXI_HP接口完成高速的数据传输,各种接口的传输比较为: 图片 ZYNQ中ACI_HP接口的分布为: 图片 通过PL的DMA和AXI_HP接口传输方式的拓扑图为: 图片 DMA的数据传输经过S_AXI_HP接口,每一个HP接口都含有控制和数据fifo,这些fifo为大数据量突发传输提供缓冲,使得HP成为理想的高速数据接口。 对DMA的控制或配置通过M_AXI_GP接口(M代表master为PS),传输状态通过中断传达到PS的中断控制器。 对M_AXI_GP0理解是: 在ZYNQ7处理器系统IP core中,在PS-PL Configuration下的AXI Non Secure Enablement下有一个GP Master AXI Interface选项,可选一个M_AXI_GP0接口。 该接口的作用是对PL侧的IP core通过AXI-Lite总线进行配置,如果不仅需要的话直接不使能即可。 图片 图片 三、AXI DMA IP简介 ZYNQ提供了两种DMA,一种是集成在PS中的硬核DMA,另一种是PL中使用的软核AXI DMA IP。 AXI DMA IP核在AXI4-Stream IP接口之间提供高带宽直接存储访问。其可选的scatter gather(SG,链式相关)功能还可以从基于处理器的系统中的中央处理单元(CPU)卸载数据搬运任务。初始化、状态和管理寄存器通过AXI-Lite从接口访问(即数据发出方为PL,PS为Slave),核心功能组成为(这张图很有助于理解DMA中断以及SDK代码,下面会解释): 图片 原图位于AXI_DMA数据手册的第五页。 AXI DMA使用了三种总线,分别是: (1)、AXI Memory Map,用于内存交互,AXI4 Memory Map Read用于从DMA读取,AXI4 Memory Map用于向DMA写入。 (2)、AXI4-Lite同于对寄存器的配置。 (3)、AXI4-Stream接口用于对外设的读写,S2MM(Stream to Memory Mapped,数据流向内存映射)用于对外设读取。AXI_MM2S和AXI_S2MM是AXI_Stream总线,可以发送和接收连续的数据流,无需地址。 AXI DMA提供3种模式: (1)、Direct Register模式:用于在MM2S和S2MM通道上执行简单的DMA传输,小的FPGA资源少。有两个通道:一个从Device到DMA,另一个从DMA到Device。应用程序必须设置缓冲区地址和长度字段以启动相应通道中的传输。 (2)、Scatter/Gather模式:允许在单个DMA事务中将数据传输到多个存储区域传输数据。 (3)、Cyclic DMA模式: 四、AXI DMA参数与接口分析 图片 1、接口分析: (1)、M_AXI_MM2S:DMA的读通道,从DDR中读取数据。受Enable Read Channel控制,表现为M_AXI_MM2S。 (2)、M_AXI_S2MM:DMA的写通道,将数据写入DDR中。受Enable Write Channel控制,表现为M_AXI_S2MM。 (3)、M_AXIS_MM2S:DMA将数据发送到具有stream接口IP。 (4)、S_AXIS_S2MM:DMA将数据从具有Stream接口的IP中将数据读入。 (5)、mm2s_introut:DMA将数据从DDR的映射单元中读出,然后将数据发送到具有Stream接口的IP完成信号。 (6)、s2mm_introut:DMA将数据从具有stream接口的IP中读入,并写入到内存映射单元的完成中断信号。 2、参数分析 图片 (1)、Enable Scatter Gatter Engine 链式DMA操作,取消选中该选项可启用directregister模式操作。 (2)、Enable Micro DMA 改选项会生成高度优化的DMA,资源数量较少,用于传输极少量数据的应用程序。 (3)、Width of Buffer Length Register 根据IP手册pg021,在direct register模式下,此整数值用于指定控制字段缓冲区长度的有效位数,字节数等于2^(width),即字节读取和字节写入的有效长度都是2^(width)。比如宽度设置为26,可传输的字节数为2^(26)字节。(pg021,78页)。 (4)、Address Width 指定地址空间的宽度,默认32。 (5)、Enable Read Channel Memory Map Data Width:AXI MM2S存储映射读取总线的数据位宽,可为32、64、128、256、512、1024。 Stream Data Width:AXI MM2S AXI-Stream数据总线的位宽,该值必须小于等于Memory Map Data Width,可以为8、16、32、64、128、512、1024。 Max Burst Size:最大突发长度设置,指定的是MM2S的AXI4-Memory Map侧的突发周期的最大值,可为2、4、8、16、32、64、128、256。 (6)、Enable Write channel:同Read channel。 3、关于中断的理解 (1)、M_AXI_MM2S:DMA的读通道,从DDR中读取数据。受Enable Read Channel控制,表现为M_AXI_MM2S。 在AXI_DMA ip core的输出信号中,有两个中断信号,分别是s2mm_introut和mm2s_introut,mm指的是Memory Mapped,S指的是Stream。 Memory Map指的是什么?根据AXI DMA的介绍,AXI DMA提供一个介于AXI4 Memory Mapped 与AXI4 Stream IP之间的高带宽DMA: 原话位于IP参考的page5: The AXI DirectMemory Access (AXI DMA) IP core provides high-bandwidth direct memory accessbetween the AXI4 memory mapped and AXI4-Stream IP interfaces. 所以,对于DMA来说,S2MM,就是Stream形式的数据到达DDR映射空间,具体的实现方式是Stream数据流先进入DMA,之后再从DMA到Memeory Mapped。 MM2S是Memory Mapped将数据送入具有AXI Stream接口的IP。 从这里分析mm2s_introut与s2mm_introut信号的区别是分析不出来的,因为数据都是先到DMA,再从DMA发送出去。 在第5页还有一张图,讲述AXI DMA的架构: 图片 分析这张图,DDR内存映射空间的读写都是通过AXI4Memory Map完成的,也就是说s2mm与mm2s的重点不在PS DDR侧,重点在PL侧,当Stream接口的数据将输出传到DMA时候,这个过程叫做DMA的接收,DMA将映射单元的数据写到stream接口的IP,这个过程叫做DMA的发送。 所以!也就可以理解在SDK中将s2mm_introut定义为DMA接收中断,将mm2s_introut定义为发送中断了! 所以以下语句就很容易理解了: // DMA接收通道的中断ID #define RX_INTR_ID XPAR_FABRIC_AXIDMA_0_S2MM_INTROUT_VEC_ID #define TX_INTR_ID XPAR_FABRIC_AXIDMA_0_MM2S_INTROUT_VEC_IDXilinx FPGA里面的AXI DMA IP核的简单用法 在FPGA里面,AXI DMA这个IP核的主要作用,就是在Verilog语言和C语言之间传输大批量的数据,使用的通信协议为AXI4-Stream。 Xilinx很多IP核都是基于AXI4-Stream协议的,例如浮点数Floating-point IP核,以及以太网Tri Mode Ethernet MAC IP核。要想将Verilog层面的数据搬运到C语言里面处理,就要使用DMA IP核。 本文以浮点数Floating-point IP核将定点数转换为浮点数为例,详细讲解AXI DMA IP核的使用方法。 浮点数IP核的输入输出数据都是32位,协议均为AXI4-Stream。C语言程序首先将要转换的定点数数据通过DMA发送给浮点数IP核,浮点数IP核转换完成后再通过DMA将单精度浮点数结果发回C语言程序,再通过printf打印出来。 定点数的数据类型为int,小数点定在第四位上,即:XXXXXXX.X。整数部分占28位,小数部分占4位。 转换后浮点数的数据类型为float,可以用printf的%f直接打印出来。 工程下载地址:https://pan.baidu.com/s/1SXppHMdhroFT8vGCIysYTQ(提取码:u7wf) MicroBlaze C语言工程的建法不再赘述,请参阅:https://blog.csdn.net/ZLK1214/article/details/111824576 以读写Floating-point IP核数据为例 图片 首先添加Floating-point IP核,作为DMA的外设端:(主存端为BRAM) 图片 图片 图片 图片 这里要注意一下,一定要勾选上TLAST,否则DMA接收端会出现DMA Internal Error的错误: 图片 下面是Xilinx DMA手册里面对DMA Internal Error错误的描述: 图片 添加AXI DMA IP核: 图片 IP核添加好了,但还没有连线: 图片 点击Run Connection Automation,自动连接DMA的S_AXI_LITE接口: 图片 图片 图片 图片 图片 自动连接浮点数IP核的时钟引脚: 图片 图片 图片 图片 图片 添加BRAM控制器: 图片 图片 最终的连线结果: 图片 修改新建的BRAM的容量为64KB: 图片 图片 最终的地址分配方式: 图片 保存Block Design,然后生成Bitstream: 图片 Bitstream生成后,导出xsa文件: 图片 Vitis Platform工程重新导入xsa文件: 图片 图片 修改C程序(helloworld.c)的代码: (这里面XPAR_BRAM_2_BASEADDR最好改成0xc0000000,因为生成的xparameters.h配置文件里面BRAM号可能有变化) /* * helloworld.c: simple test application * * This application configures UART 16550 to baud rate 9600. * PS7 UART (Zynq) is not initialized by this application, since * bootrom/bsp configures it to baud rate 115200 * * ------------------------------------------------ * | UART TYPE BAUD RATE | * ------------------------------------------------ * uartns550 9600 * uartlite Configurable only in HW design * ps7_uart 115200 (configured by bootrom/bsp) */ #include <stdio.h> #include <xaxidma.h> #include "platform.h" // DMA无法通过AXI Interconnect访问Microblaze本身的BRAM内存 // 只能访问挂接在AXI Interconnect上的内存 #define _countof(arr) (sizeof(arr) / sizeof(*(arr))) typedef struct { int numbers_in[40]; float numbers_out[40]; } BRAM2_Data; static BRAM2_Data *bram2_data = (BRAM2_Data *)XPAR_BRAM_2_BASEADDR; static XAxiDma xaxidma; int main(void) { int i, ret = 0; XAxiDma_Config *xaxidma_cfg; init_platform(); printf("Hello World\n"); printf("Successfully ran Hello World application\n"); // 初始化DMA xaxidma_cfg = XAxiDma_LookupConfig(XPAR_AXIDMA_0_DEVICE_ID); XAxiDma_CfgInitialize(&xaxidma, xaxidma_cfg); ret = XAxiDma_Selftest(&xaxidma); if (ret != XST_SUCCESS) { printf("XAxiDma_Selftest() failed! ret=%d\n", ret); goto err; } // 初始化DMA的输入数据 printf("numbers_in=%p, numbers_out=%p\n", bram2_data->numbers_in, bram2_data->numbers_out); for (i = 0; i < _countof(bram2_data->numbers_in); i++) { bram2_data->numbers_in[i] = 314 * (i + 1); if (i & 1) bram2_data->numbers_in[i] = -bram2_data->numbers_in[i]; } // DMA开始发送数据 (Length参数的单位为字节) ret = XAxiDma_SimpleTransfer(&xaxidma, (uintptr_t)bram2_data->numbers_in, sizeof(bram2_data->numbers_in), XAXIDMA_DMA_TO_DEVICE); if (ret != XST_SUCCESS) { printf("XAxiDma_SimpleTransfer(XAXIDMA_DMA_TO_DEVICE) failed! ret=%d\n", ret); goto err; } // DMA开始接收数据 ret = XAxiDma_SimpleTransfer(&xaxidma, (uintptr_t)bram2_data->numbers_out, sizeof(bram2_data->numbers_out), XAXIDMA_DEVICE_TO_DMA); if (ret != XST_SUCCESS) { printf("XAxiDma_SimpleTransfer(XAXIDMA_DEVICE_TO_DMA) failed! ret=%d\n", ret); goto err; } // 等待DMA发送完毕 i = 0; while (XAxiDma_Busy(&xaxidma, XAXIDMA_DMA_TO_DEVICE)) { i++; if (i == 200000) { // 必须确保DMA访问的内存是直接挂接在AXI Interconnect上的 // 否则这里会报DMA Decode Error的错误 (the address request points to an invalid address) printf("DMA Tx timeout! DMASR=0x%08lx\n", XAxiDma_ReadReg(xaxidma.RegBase + XAXIDMA_TX_OFFSET, XAXIDMA_SR_OFFSET)); goto err; } } printf("DMA Tx complete!\n"); // 等待DMA接收完毕 i = 0; while (XAxiDma_Busy(&xaxidma, XAXIDMA_DEVICE_TO_DMA)) { i++; if (i == 200000) { // floating-point IP核的配置里面一定要把A通道的tlast复选框勾选上, 使输入端和输出端都有tlast信号 // 否则s_axis_s2mm_tlast一直为0, DMA以为数据还没接收完, 就会报DMA Internal Error的错误 // (the incoming packet is bigger than what is specified in the DMA length register) printf("DMA Rx timeout! DMASR=0x%08lx\n", XAxiDma_ReadReg(xaxidma.RegBase + XAXIDMA_RX_OFFSET, XAXIDMA_SR_OFFSET)); goto err; } } printf("DMA Rx complete!\n"); err: for (i = 0; i < _countof(bram2_data->numbers_out); i++) printf("numbers_out[%d]=%f\n", i, bram2_data->numbers_out[i]); cleanup_platform(); return 0; }C程序的运行结果: 图片 图片 接下来讲一下我们刚才禁用掉的Scatter Gather接口的用法。取消禁用后,之前的C代码就不能运行了。 之前没有启用Scatter Gather的时候,我们一次只能提交一个DMA请求,等这个DMA请求的数据传输完毕后,我们才能提交下一个DMA传输请求。 有了Scatter Gather接口,我们就可以一次性提交很多很多DMA请求,然后CPU去干其他的事情。这可以大大提高传输效率。 除此以外,Scatter Gather还可以将多个位于不同内存地址的缓冲区合并成一个AXI4-Stream数据包传输。 下面的示例演示了如何利用Scatter Gather功能批量收发3组数据包。 启用了Scatter Gather后,DMA里面多出了一个M_AXI_SG接口,点击Run Connection Automation,连接到AXI Interconnect上: 图片 图片 Vivado工程Generate Bitstream,然后导出xsa文件。回到Vitis后,必须把Platform工程删了重建,不然XPAR_AXI_DMA_0_INCLUDE_SG的值得不到更新。 图片 图片 图片 原有的C程序不再可用,修改一下程序代码: /* * helloworld.c: simple test application * * This application configures UART 16550 to baud rate 9600. * PS7 UART (Zynq) is not initialized by this application, since * bootrom/bsp configures it to baud rate 115200 * * ------------------------------------------------ * | UART TYPE BAUD RATE | * ------------------------------------------------ * uartns550 9600 * uartlite Configurable only in HW design * ps7_uart 115200 (configured by bootrom/bsp) */ #include <stdio.h> #include <xaxidma.h> #include "platform.h" /* Xilinx的官方例程:C:\Xilinx\Vitis\2020.1\data\embeddedsw\XilinxProcessorIPLib\drivers\axidma_v9_11\examples\xaxidma_example_sg_poll.c */ // DMA无法通过AXI Interconnect访问Microblaze本身的BRAM内存 // 只能访问挂接在AXI Interconnect上的内存 #define _countof(arr) (sizeof(arr) / sizeof(*(arr))) typedef struct { int numbers_in[40]; float numbers_out[40]; } BRAM2_Data; typedef struct { uint8_t txbuf[640]; uint8_t rxbuf[640]; } BRAM2_BdRingBuffer; static BRAM2_Data *bram2_data = (BRAM2_Data *)0xc0000000; static BRAM2_BdRingBuffer *bram2_bdringbuf = (BRAM2_BdRingBuffer *)0xc0008000; static XAxiDma xaxidma; int main(void) { int i, n, ret = 0; XAxiDma_Bd *bd, *p; XAxiDma_BdRing *txring, *rxring; XAxiDma_Config *cfg; init_platform(); printf("Hello World\n"); printf("Successfully ran Hello World application\n"); // 初始化DMA cfg = XAxiDma_LookupConfig(XPAR_AXIDMA_0_DEVICE_ID); XAxiDma_CfgInitialize(&xaxidma, cfg); ret = XAxiDma_Selftest(&xaxidma); if (ret != XST_SUCCESS) { printf("XAxiDma_Selftest() failed! ret=%d\n", ret); goto err; } if (!XAxiDma_HasSg(&xaxidma)) { printf("XPAR_AXI_DMA_0_INCLUDE_SG=%d\n", XPAR_AXI_DMA_0_INCLUDE_SG); printf("Please recreate and build Vitis platform project!\n"); goto err; } // 初始化DMA的输入数据 printf("[0] numbers_in=%p, numbers_out=%p\n", bram2_data[0].numbers_in, bram2_data[0].numbers_out); printf("[1] numbers_in=%p, numbers_out=%p\n", bram2_data[1].numbers_in, bram2_data[1].numbers_out); printf("[2] numbers_in=%p, numbers_out=%p\n", bram2_data[2].numbers_in, bram2_data[2].numbers_out); for (i = 0; i < _countof(bram2_data[0].numbers_in); i++) { bram2_data[0].numbers_in[i] = 314 * (i + 1); bram2_data[1].numbers_in[i] = -141 * (i + 1); bram2_data[2].numbers_in[i] = -2718 * (i + 1); if (i & 1) { bram2_data[0].numbers_in[i] = -bram2_data[0].numbers_in[i]; bram2_data[1].numbers_in[i] = -bram2_data[1].numbers_in[i]; bram2_data[2].numbers_in[i] = -bram2_data[2].numbers_in[i]; } } // 配置DMA发送描述符 txring = XAxiDma_GetTxRing(&xaxidma); n = XAxiDma_BdRingCntCalc(XAXIDMA_BD_MINIMUM_ALIGNMENT, sizeof(bram2_bdringbuf->txbuf)); ret = XAxiDma_BdRingCreate(txring, (uintptr_t)bram2_bdringbuf->txbuf, (uintptr_t)bram2_bdringbuf->txbuf, XAXIDMA_BD_MINIMUM_ALIGNMENT, n); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingCreate(txring) failed! ret=%d\n", ret); goto err; } printf("BdRing Tx count: %d\n", n); ret = XAxiDma_BdRingAlloc(txring, 3, &bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingAlloc(txring) failed! ret=%d\n", ret); goto err; } p = bd; for (i = 0; i < 3; i++) { XAxiDma_BdSetBufAddr(p, (uintptr_t)bram2_data[i].numbers_in); XAxiDma_BdSetLength(p, sizeof(bram2_data[i].numbers_in), txring->MaxTransferLen); XAxiDma_BdSetCtrl(p, XAXIDMA_BD_CTRL_TXSOF_MASK | XAXIDMA_BD_CTRL_TXEOF_MASK); XAxiDma_BdSetId(p, i); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(txring, p); } ret = XAxiDma_BdRingToHw(txring, 3, bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingToHw(txring) failed! ret=%d\n", ret); goto err; } // 配置DMA接收描述符 rxring = XAxiDma_GetRxRing(&xaxidma); n = XAxiDma_BdRingCntCalc(XAXIDMA_BD_MINIMUM_ALIGNMENT, sizeof(bram2_bdringbuf->rxbuf)); ret = XAxiDma_BdRingCreate(rxring, (uintptr_t)bram2_bdringbuf->rxbuf, (uintptr_t)bram2_bdringbuf->rxbuf, XAXIDMA_BD_MINIMUM_ALIGNMENT, n); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingCreate(rxring) failed! ret=%d\n", ret); goto err; } printf("BdRing Rx count: %d\n", n); ret = XAxiDma_BdRingAlloc(rxring, 3, &bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingAlloc(rxring) failed! ret=%d\n", ret); goto err; } p = bd; for (i = 0; i < 3; i++) { XAxiDma_BdSetBufAddr(p, (uintptr_t)bram2_data[i].numbers_out); XAxiDma_BdSetLength(p, sizeof(bram2_data[i].numbers_out), rxring->MaxTransferLen); XAxiDma_BdSetCtrl(p, 0); XAxiDma_BdSetId(p, i); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(rxring, p); } ret = XAxiDma_BdRingToHw(rxring, 3, bd); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingToHw(rxring) failed! ret=%d\n", ret); goto err; } // 开始发送数据 ret = XAxiDma_BdRingStart(txring); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingStart(txring) failed! ret=%d\n", ret); goto err; } // 开始接收数据 ret = XAxiDma_BdRingStart(rxring); if (ret != XST_SUCCESS) { printf("XAxiDma_BdRingStart(rxring) failed! ret=%d\n", ret); goto err; } // 等待收发结束 n = 0; while (n < 6) { // 检查发送是否结束 ret = XAxiDma_BdRingFromHw(txring, XAXIDMA_ALL_BDS, &bd); if (ret != 0) { n += ret; p = bd; for (i = 0; i < ret; i++) { printf("DMA Tx%lu Complete!\n", XAxiDma_BdGetId(p)); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(txring, p); } ret = XAxiDma_BdRingFree(txring, ret, bd); if (ret != XST_SUCCESS) printf("XAxiDma_BdRingFree(txring) failed! ret=%d\n", ret); } // 检查接收是否结束 ret = XAxiDma_BdRingFromHw(rxring, XAXIDMA_ALL_BDS, &bd); if (ret != 0) { n += ret; p = bd; for (i = 0; i < ret; i++) { printf("DMA Rx%lu Complete!\n", XAxiDma_BdGetId(p)); p = (XAxiDma_Bd *)XAxiDma_BdRingNext(rxring, p); } ret = XAxiDma_BdRingFree(rxring, ret, bd); if (ret != XST_SUCCESS) printf("XAxiDma_BdRingFree(rxring) failed! ret=%d\n", ret); } } err: for (i = 0; i < _countof(bram2_data[0].numbers_out); i++) printf("numbers_out[%d]=%f,%f,%f\n", i, bram2_data[0].numbers_out[i], bram2_data[1].numbers_out[i], bram2_data[2].numbers_out[i]); cleanup_platform(); return 0; }图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
1年前
1
5,670
11
SoC架构、通信举例、AHB、APB接口
摘要本文介绍了SoC架构,包括处理器内核、存储器、外设等组成部分,并详细阐述了ARM公司推出的AMBA片上总线,如AHB、APB、AXI等,以及它们在CPU与外设通信中的应用。关键词:SoC架构, AHB接口, APB接口, ARM AMBA, AXI总线典型的SoC包括以下部分 CPU与SRAM通信 CPU与I2C接口通信 AHB从接口 AHB主接口 APB桥 APB Slave框图 AXI总线 AXI传输对比 AMBA中AXI AHP APB比较 典型的SoC包括以下部分 • 一个或多个处理器内核,可以是MCU、MPU、数字信号处理器或专用指 令集处理器内核; • 存储器:可以是RAM、ROM、EEPROM或闪存; • 用于提供时间脉冲信号的振荡器和锁相环电路; • 由计数器和计时器、电源电路组成的外设; • 不同标准的连线接口,如USB、火线、以太网、通用异步收发; • 用于在数字信号和模拟信号之间转换的ADC/DAC; • 电压调理电路及稳压器。 在外设内部,各组件通过芯片上的互联总线相互连接。ARM公司推出的 AMBA片上总线主要包括高性能系统总线AHB、通用系统总线ASB、外围互联总线APB、可拓展接口AXI。AHB主要针对高效率、高频宽及快速系统模块;ASB可用于某些高速且不必要使用AHB 总线的场合作为系统总线;APB 主要用于低速、低功率的外围,AXI在AMBA3.0协议中增加,可以用于ARM 和FPGA的高速数据交互。 基于ARM的SoC 图片 CPU与SRAM通信 CPU通过AHB对SRAM进行读写 地址生成:CPU生成要访问的SRAM地址。 信号发送:CPU通过AHB总线发送地址信息和读写请求信号。 数据传输: 读操作:CPU发送读请求后,SRAM将数据放在数据线上,CPU接收数据。 写操作:CPU将数据放在数据线上,发送写请求,SRAM接收并存储数据。 等待确认:操作完成后,SRAM可能通过AHB的握手信号通知CPU操作已完成。 CPU与I2C接口通信 CPU通过APB读取I2C的数据 I2C是一种串行通信协议,通常用于低速外围设备与主控制器之间的通信。APB是一种用于连接低速外设的总线。以下是CPU通过APB读取I2C数据的一般步骤: 初始化I2C外设:CPU通过APB发送指令初始化I2C外设,设置通信参数如时钟速率、地址等。 发送启动条件:CPU通过I2C外设发送启动条件,开始通信。 地址和读写位:CPU发送目标设备的I2C地址以及读写位(读操作为1,写操作为0)。 数据传输: 写操作:如果读写位为0,CPU通过APB发送数据到I2C外设,然后发送停止条件结束通信。 读操作:如果读写位为1,CPU接收来自I2C外设的数据。 数据接收:在读取操作中,CPU通过APB从I2C外设接收数据。 发送停止条件:操作完成后,CPU发送停止条件,结束I2C通信。 AHB从接口 图片 图片 AHB主接口 图片 图片 APB桥 APB桥为AHB的一个从设备,但它在APB中是唯一的主设备,而APB中其它低速和低功率消耗的外围皆为APB桥的从设备。下图是 APB 桥的信号接口: 图片 APB桥将系统总线传送转换成APB方式的传送,它具备一些这些功能: 锁存地址,在传送过程中保持地址有效。锁存读写控制信号 对锁存的地址进行译码并产生选择信号PSELx,在传送过程中只有一个选择信号可以被激活。也就是选择出唯一一个APB从设备以进行读写动作. 写操作时: 负责将AHB送来的数据送上APB总线。 读操作时: 负责将APB的数据送上AHB系统总线。 产生一时序选通信号PENABLE作为数据传递时的启动信号 APB Slave框图 图片 如前面所提及,APB 总线中除了 APB bridge 为 M 外,其它的外围皆为 S。因此,APB 从设备比 AHB从设备接口较为简单且非常具弹性: 例如 a. APB 少了仲裁器及复杂的译码电路,APB 进行写操作时,从设备可以决定: : 在 PCLK 上升沿触发, 且 PSEL 为高时锁存数据 :或在 PENABLE 上升沿, 且 PSEL 为高时锁存数据 b. PSELx,PADDR和PWRITE信号的组合可以决定哪个寄存器会被写操作更新。 c. 在读操作的时候,数据可以 PWRITE 在=0,PSELx 和 PENABLE=1 的时候被送到总线上,而PADDR 用于决定哪个寄存器会被读。 AXI总线 AXI的三种类型 AXI(AXI4-Full):用于高性能的存储器映射需求;(占用资源较多,传输大量数据) AXI4-Lite:简化版的AXI4接口;(占用资源较少,可用于低吞吐率的存储器的通信) AXI4-Stream:用于高速的流数据通信(不使用地址,适用于视频流) AXI的工作方式 AXI4和AXI4-Lite包含5个独立的通道 读地址通道 读数据通道 写地址通道 写数据通道 写响应通道 图片 AXI4:由于读写地址通道是分离的,所以支持双向同时传输;突发长度最大为256; AXI4-Lite:和AXI4比较类似,但是不支持突发传输; AXI4-Stream:和AXI4的写数据通道比较类似,只有一个单一的数据通道,突发长度不受限制; AXI传输对比 Burst可以减少地址通道的交互,提升单笔传输的效率。 Outstanding可以较少多笔传输之间的等待,提升多笔传输的效率。 AMBA中AXI AHP APB比较 图片
IP&SOC设计
# SOC设计
刘航宇
2年前
0
1,471
2
通讯等不确定性条件下设计无人机之间的安全距离
摘要本文针对无人机通信不确定性,提出基于分离原理的安全半径设计方法。通过仿真和实验验证,该方法有效提高了无人机飞行安全性和效率。关键词:无人机安全距离, 通信不确定性, 安全半径设计, 分离原理, 无人机控制器引用文章: 简介 1. 研究问题 2. 分离原理介绍 3. 安全半径设计 4. 仿真及实验验证 引用文章: Q. Quan, R. Fu and K. -Y. Cai, "How Far Two UAVs Should Be subject to Communication Uncertainties," in IEEE Transactions on Intelligent Transportation Systems, doi: 10.1109/TITS.2022.3213555. 简介 近年来,无人机技术的快速发展使得低空空域中无人机的数量爆炸增长。碰撞避免作为无人机应用的关键技术,近年来人们已经进行了大量研究,设计出各种方法使得无人机在飞行过程中与障碍物保持一定安全距离(本文将该距离称为无人机的 安全半径)。然而, 在碰撞避免相关研究中,不确定性往往是难以处理的问题。针对不确定性,主流的方法包括对不确定性进行预测,以及在闭环控制中给予补偿。然而,以上方法很依赖于预测及补偿的精准设计,设计不当将有可能导致控制器失效。本研究受地面交通中车辆间安全距离启发,基于对通信不确定性和无人机控制器性能的假设,提出了 安全半径设计和控制器设计的原则 (本文称为 分离原理 )。进一步,安全半径具体通常通过经验预先设计,如果设计得过大或过小将分别影响无人机飞行的高效性及安全性。 如何根据无人机模型及通信不确定性确定其安全半径下界仍然是悬而未决的问题 。利用分离原理,本文研究了 设计阶段(无不确定性)和飞行阶段(受不确定性影响)的无人机安全半径设计 。最后,通过仿真和实验表明了所提方法的有效性。 图片 1. 研究问题 本研究中,无人机与障碍物的运动模型均建模为多旋翼模型,换句话说,我们考虑的障碍物可以等效为另一架多旋翼飞行器。对于多旋翼飞行器而言,其可以获得自身以及障碍物的实时位置和速度。为简单描述起见,本文建模均为二维,类似的建模及分析方法可以扩展到三维情况。 我们首先建立多旋翼的具体控制模型如下。 其中多旋翼的位置和速度分别表示为 ,速度控制模型建立为一阶惯性环节,其时间常数 与无人机的机动性能相关,控制输入 为期望速度。在此基础上,本文定义一种新的滤波位置模型如下。 多旋翼滤波位置的物理意义是根据多旋翼的当前位置、速度及机动能力,对其运动趋势预测。在此基础上,定义多旋翼的安全区域为以滤波位置为圆心的圆形区域,其半径称为安全半径 。对于障碍物,我们类似定义其滤波位置,以及以障碍物滤波位置为圆心的圆形障碍物区域,半径称为障碍物半径 。 图片 进一步,我们针对不确定性做了以下2点假设:(1)无人机和障碍物对自身的三维位置及三维速度估计均存在噪声;(2)无人机在获取障碍物状态信息时,存在通信延迟及丢包。该通信网络模型如下图所示。 图片 本研究中,丢包模型进一步建模为均值模型,且假设估计噪声、通信延迟、丢包均值模型误差均存在上界且上界已知。其数学定义如下: 图片 进一步,本文对无人机的控制器性能做出如下假设:(1)在无不确定性的理想状态下,无人机的控制器可以使无人机和障碍物之间的 真实距离 始终大于给定安全距离;(2)在存在以上不确定性的实际情况中,无人机的控制器可以使无人机和障碍物之间的 估计距离 始终保持给定安全距离。本研究的具体目标是在不确定性上界已知的条件下计算出无人机安全半径的下界。 图片 2. 分离原理介绍 无人机在理想状态下设计的控制器中给定的安全半径值 ,在实际含有不确定性的环境中将转化为估计安全半径 ;直观上理解,将含有不确定性的无人机与障碍物之间的估计位置误差代替真实位置误差作为反馈时,控制器将难以维持给定的安全半径。本研究中, 分离原理具体研究的是不确定性在满足什么条件时无人机的控制器设计和安全半径设计过程可分离 ,也就是估计安全半径和安全半径相等, 成立。分离原理具体数学描述如下: 图片 分离原理中提出的三个条件包括一个充分必要条件(i)以及两个充分条件(ii)和(iii)。其中,条件(i)为理论推导,在实际中难以得到验证,通常可通过条件(ii)和(iii)进行验证。条件(ii)对无人机速度的限制较宽,该式在障碍物主动躲避无人机的条件下容易达成。反之,条件(iii)对无人机速度的限制较苛刻,要求无人机速度严格大于障碍物速度,适用于在障碍物不主动躲避无人机的情况下。以上两种情况的区别如下图所示。 图片 3. 安全半径设计 根据上述分离原理的提出,在分离原理满足的前提下,基于无人机的安全半径模型和通信网络模型,可以进一步设计 合适大小的无人机安全半径 。如前文所述,安全半径设计过大会增加环境的冗余度,设计过小则无法保证飞行过程的安全。在本研究中,给出了在理想情况下以及实际情况下安全半径的下界,分别如下: 图片 4. 仿真及实验验证 仿真及实验验证在仿真中,我们针对单障碍物、多非合作障碍物、多合作障碍物设计了三种场景来验证我们方法的有效性。在实验中,我们使用DJI tello无人机对以上情况进行测试,结果与我们的理论一致。实验视频: https://youtu.be/LkSDPFGa_1E 论文地址 https://rfly.buaa.edu.cn/pdfs/2022/How_far_two_UAVs_should_be_subject_to_communication_uncertainties.pdf
软硬件算法
# 软件算法
刘航宇
2年前
0
1,074
2
2024-07-05
Linux之不使用命令删除文件中的第N行
摘要本文介绍了三种方法在不使用命令的情况下,通过编程删除Linux文件中的指定行。方法包括使用临时文件、系统调用和直接操作文件指针,并提供了相应的C语言代码示例。关键词:Linux, 文件删除, 行号删除, 文件操作, 临时文件1.问题描述 2. 解题思路: 3. 代码实现: 1.问题描述 设计一个程序,通过命令行参数接收一个文件名 filename.txt (纯文本文件)和一个整型数字 n,实现从 filename.txt 中删除第 n 行数据。 2. 解题思路: (1) 借助临时文件: 将文件逐行读取,跳过要删除的行,并将其写入临时文件,然后删除源文件,重命名临时文件为源文件,完成删除指定行数据。 (2) 不借助临时文件: 将文件以读写方式打开,读取到要删除行后,通过移动文件指针将文件后面所有行前移一行,但是最后一行会重复,可以通过截断文件操作完成在源文件上删除指定行数据。 (3) 通过sed 或 awk 删除文件指定行 3. 代码实现: (1) 通过 fopen 打开文件借助临时文件删除指定行数据 #filename:ques_15a.c #include <stdio.h> // 包含标准输入输出库 #include <stdlib.h> // 包含标准库函数,比如exit int main(int argc, char *argv[]) { // 检查命令行参数的数量是否正确 if (argc != 3) { printf("Usage: ./a.out filename num\n"); exit(EXIT_FAILURE); // 如果不正确,打印用法信息并退出 } char buf[4096]; // 定义一个足够大的字符数组用于读取文件行 int linenum = atoi(argv[2]); // 将命令行参数中的行号转换为整数 FILE *fp = fopen(argv[1], "r"); // 尝试以只读模式打开源文件 FILE *fpt = fopen("temp.txt", "w"); // 创建一个临时文件用于写入 // 如果源文件无法打开,打印错误信息并退出 if (!fp) { printf("File %s not exist!\n", argv[1]); exit(EXIT_FAILURE); } // 检查是否有权限修改源文件 char str[100]; sprintf(str, "%s%s", "test -w ", argv[1]); if (system(str)) { // 如果没有写权限 printf("Can't modify file %s, permission denied!\n", argv[1]); exit(EXIT_FAILURE); // 打印错误信息并退出 } int total_line = 0; // 初始化文件总行数计数器 while (fgets(buf, sizeof(buf), fp)) { // 读取文件的每一行 total_line++; } fseek(fp, 0, SEEK_SET); // 将文件指针重置到文件的开头 // 如果要删除的行数大于文件的总行数,打印错误信息并退出 if (linenum > total_line) { printf("%d is greater than total_line!\n", linenum); exit(EXIT_FAILURE); } int i = 0; // 初始化当前行计数器 while (fgets(buf, sizeof(buf), fp)) { // 再次读取文件的每一行 i++; // 当前行数加1 if (i != linenum) { // 如果当前行不是要删除的行 fputs(buf, fpt); // 将当前行写入临时文件 } } remove(argv[1]); // 删除原始文件 rename("temp.txt", argv[1]); // 将临时文件重命名为原始文件名 // 关闭文件指针 fclose(fp); fclose(fpt); return 0; // 程序正常退出 }(2) 通过 Linux 系统调用 open 打开文件,需要自定义读取一行的函数,不借助临时文件删除指定行数据 # filename:ques_15b.c #include <stdio.h> // 包含标准输入输出库 #include <stdlib.h> // 包含标准库函数,比如atoi和exit #include <string.h> // 包含字符串操作函数,比如strlen #include <fcntl.h> // 包含文件控制的定义 #include <sys/stat.h> // 包含文件状态的定义 #include <sys/types.h>// 包含各种数据类型 #include <unistd.h> // 包含UNIX标准函数定义 // 函数声明:读取一行文件内容到缓冲区 int readline(int fd, char *buf) { int t = 0; // 用于记录读取的字符数 // 循环读取直到遇到换行符 for (; ;) { read(fd, &buf[t], 1); // 从文件描述符fd读取一个字符到buf t++; // 增加读取的字符数 if (buf[t-1] == '\n') { // 如果读取到换行符 break; // 退出循环 } } return t; // 返回读取的字符数 } // 函数声明:获取文件的大小和行数 int get_file_info(int fd, int *size) { int num = 0; // 记录行数 char ch; // 临时变量用于存储读取的字符 // 循环读取直到文件结束 while (read(fd, &ch, 1) > 0) { (*size)++; // 文件大小加1 if (ch == '\n') { // 如果读取到换行符 num++; // 行数加1 } } return num; // 返回行数 } int main(int argc, char *argv[]) { // 检查命令行参数数量 if (argc != 3) { printf("Usage: ./a.out filename num\n"); exit(EXIT_FAILURE); // 参数不正确时退出 } int fd; // 文件描述符 char buf[4096]; // 缓冲区 int linenum = atoi(argv[2]); // 将命令行参数转换为整数 // 尝试以读写模式打开文件 fd = open(argv[1], O_RDWR); if (fd < 0) { printf("Can't open file %s, file not exist or permission denied!\n", argv[1]); exit(EXIT_FAILURE); // 打开失败时退出 } int size = 0; // 文件大小 // 获取文件的行数和大小 int total_line = get_file_info(fd, &size); // 如果要删除的行数大于文件总行数,退出 if (linenum > total_line) { printf("%d is greater than total_line!\n", linenum); exit(EXIT_FAILURE); } int s = 0; // 要删除行的大小 int t = 0; // 当前行的大小 int i = 0; // 当前行数 lseek(fd, 0, SEEK_SET); // 将文件指针移到文件头 // 循环读取文件,直到文件结束 while (read(fd, &buf[0], 1) > 0) { lseek(fd, -1, SEEK_CUR); // 回退一个字符 memset(buf, 0, sizeof(buf)); // 清空缓冲区 readline(fd, buf); // 读取一行到缓冲区 i++; // 行数加1 t = strlen(buf); // 当前行的大小 // 如果当前行是目标行,记录其大小 if (i == linenum) { s = t; } // 如果当前行在目标行之后,将该行前移 if (i > linenum) { lseek(fd, -(s+t), SEEK_CUR); // 移动文件指针 write(fd, buf, strlen(buf)); // 写入当前行 lseek(fd, s, SEEK_CUR); // 移动文件指针 } } ftruncate(fd, size-s); // 截断文件,删除指定行 close(fd); // 关闭文件描述符 return 0; // 正常退出 }(3) 通过 fopen 打开文件,不借助临时文件删除指定行数据 # filename:ques_15b.c #include <stdio.h> // 包含标准输入输出库 #include <stdlib.h> // 包含标准库函数,如atoi和exit #include <string.h> // 包含字符串处理函数,如strlen #include <math.h> // 包含数学函数,虽然在这个程序中没有使用 #include <unistd.h> // 包含UNIX标准函数,如truncate int main(int argc, char *argv[]) { // 检查命令行参数个数是否正确 if (argc != 3) { printf("Usage: ./a.out filename num\n"); exit(EXIT_FAILURE); // 参数不正确时退出程序 } int linenum = atoi(argv[2]); // 将命令行中指定的行号转换为整数 char buf[4096]; // 定义缓冲区,用于读取文件内容 // 尝试以读写模式打开文件 FILE *fp = fopen(argv[1], "r+"); // 如果文件无法打开,打印错误信息并退出程序 if (!fp) { printf("Can't open file %s, file not exist or permission denied!\n", argv[1]); exit(EXIT_FAILURE); } int total_line = 0; // 记录文件的总行数 int size = 0; // 记录文件的总大小 // 循环读取文件直到文件末尾,计算总行数和总大小 while (fgets(buf, sizeof(buf), fp)) { size += strlen(buf); // 累加每行的长度 total_line++; // 行数加1 } // 如果要删除的行数大于文件的总行数,打印错误信息并退出程序 if (linenum > total_line) { printf("%d is greater than total_line!\n", linenum); exit(EXIT_FAILURE); } int s = 0; // 记录要删除的行的大小 int t = 0; // 记录当前读取行的大小 int i = 0; // 记录当前行数 fseek(fp, 0L, SEEK_SET); // 将文件指针重置到文件开头 // 再次循环读取文件,准备删除指定行 while (fgets(buf, sizeof(buf), fp)) { i++; // 当前行数加1 t = strlen(buf); // 当前行的长度 // 如果当前行是要删除的行,记录其大小 if (i == linenum) { s = t; } // 如果当前行在要删除的行之后,将其前移 if (i > linenum) { fseek(fp, -(s+t), SEEK_CUR); // 将文件指针移动到正确的位置 fputs(buf, fp); // 写入当前行 fseek(fp, s, SEEK_CUR); // 将文件指针向前移动s个字节 } } // 截断文件,删除指定行 truncate(argv[1], size-s); // 关闭文件指针 fclose(fp); return 0; // 正常退出程序 }(4) 这三个删除文件指定行的函数都需借助临时文件完成
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
534
1
2024-06-27
FPGA/数字IC-常考八股
摘要本文介绍了FPGA/数字IC设计中的关键概念,包括时间概念、亚稳态产生与防止、多时域设计、竞争与冒险现象、锁存器与寄存器区别、阻塞与非阻塞赋值、流水线设计、函数与任务、不可综合Verilog语句等,旨在帮助读者深入理解FPGA/数字IC设计原理。关键词:FPGA, 数字IC, 时钟域同步, 亚稳态, 竞争冒险各种时间概念 亚稳态的产生 如何防止亚稳态? 多时域设计中,如何处理信号跨时域? 什么是竞争与冒险现象?怎样判断?如何消除? 锁存器(Latch)和寄存器(Flip-Flop)概念和区别 `timescale 阻塞赋值&非阻塞赋值 流水线 函数&任务 不可综合verilog语句 一些小计算总结 各种时间概念 建立时间(setup time)是指在触发器的时钟信号上升沿到来以前,数据稳定不变的时间,如果建立时间不够,数据将不能在这个时钟上升沿被打入触发器。 保持时间(hold time)是指在触发器的时钟信号上升沿到来以后,数据稳定不变的时间,如果保持时间不够,数据同样不能被打出触发器。 图片 传输延时(transmission delay)数据相对于时钟上升沿tc-q后从触发器输出至Q端,则tc-q称为寄存器的传输延时 恢复时间(recovery time)原本有效的复位信号释放后,与紧跟其后的第一个时钟上升沿之间的最小时间。 清除时间(removal time)时钟信号的上升沿,与紧跟其后异步复位信号从有效到无效的最小时间。 亚稳态的产生 在FPGA系统中,如果数据传输中不满足触发器的 Tsu 和 Th 不满足,或者复位过程中复位信号的释放相对于有效时钟沿的恢复时间(recovery time)不满足,就可能产生亚稳态,此时触发器输出端Q在有效时钟沿之后比较长的一段时间处于不确定的状态,在这段时间里Q端在0和1之间处于振荡状态,而不是等于数据输入端D的值。这段时间称为决断时间(resolution time)。经过resolution time之后Q端将稳定到0或1上,但是稳定到0或者1,是随机的,与输入没有必然的关系。 如何防止亚稳态? 亚稳态是指触发器无法在某个规定时间段内达到一个可确认的状态。当一个触发器进入亚稳态时,既无法预测该单元的输出电平,也无法预测何时输出才能稳定在某个正确的电平上。在这个稳定期间,触发器输出一些中间级电平,或者可能处于振荡状态,并且这种无用的输出电平可以沿信号通道上的各个触发器级联式传播下去。 解决方法: 1 降低系统时钟频率 2 用反应更快的FF 3 引入同步机制,防止亚稳态传播(加两级D触发器)。 4 改善时钟质量,用边沿变化快速的时钟信号 多时域设计中,如何处理信号跨时域? 不同的时钟域之间信号通信时需要进行同步处理,这样可以防止新时钟域中第一级触发器的亚稳态信号对下级逻辑造成影响。 解决方法: 1 信号跨时钟域同步:当单个信号跨时钟域时,可以采用两级触发器来同步; 2 数据或地址总线跨时钟域: 可以采用异步 FIFO 来实现时钟同步; 3 第三种方法就是采用握手信号。 什么是竞争与冒险现象?怎样判断?如何消除? 在组合电路中, 门电路两个输入信号同时向相反的逻辑电平跳变称为竞争;由于竞争而在电路的输出端可能产生尖峰脉冲的现象称为竞争冒险。 (也就是由于竞争产生的毛 刺叫做冒险)。 判断方法: •代数法: 如果布尔式中有相反的信号则可能产生竞争和冒险现象,即逻辑函数在一定条件 下可以化简成 Y=A+A’或 Y=AA’则可以判断存在竞争冒险现象(只是一个变量变化的情况) ; •卡诺图:有两个相切的卡诺圈并且相切处没有被其他卡诺圈包围,就有可能出现竞争冒险; •实验法+观察法:示波器观测; 解决方法: 1:加滤波电容,消除毛刺的影响; 2:加选通信号,避开毛刺; 3:增加冗余项消除逻辑冒险。 锁存器(Latch)和寄存器(Flip-Flop)概念和区别 电平敏感的存储器件称为锁存器。可分为高电平锁存器和低电平锁存器,用于不同时钟之间的信号同步。 有交叉耦合的门构成的双稳态的存储原件称为触发器(寄存器)。分为上升沿触发和下降沿触发。可以认为是两个不同电平敏感的锁存器串连而成。前一个锁存器决定了触发器的建立时间,后一个锁存器则决定了保持时间。 latch 是电平触发, register 是边沿触发。 register 在同一时钟边沿触发下动作,符合同步电路的设计思想,而 latch 则属于异步电路设计,往往会导致时序分析困难,不适当的应用 latch 则会大量浪费芯片资源。 `timescale `timescale 1ns / 1ps,含义为:时延单位为1ns,时延精度为1ps 在仿真文件里面需要写,例如 `timescale 10 ns / 1 ns //单位10ns,精度1ns module test; reg set; initial begin #1 set = 0; //1*10 ns = 10ns #10 set = 1; //10*10ns = 100ns end endmodule阻塞赋值&非阻塞赋值 阻塞赋值“=”属于顺序执行,即下一条语句执行前,当前语句一定会执行完毕 非阻塞赋值“<=”属于并行执行语句,即下一条语句的执行和当前语句的执行是同时进行的 在设计电路时,always 时序逻辑块中多用非阻塞赋值,always 组合逻辑块中多用阻塞赋值;在仿真电路时,initial 块中一般多用阻塞赋值 不要在一个过程结构中混合使用阻塞赋值与非阻塞赋值 流水线 流水线设计是verilog设计中基本功之一,是对组合逻辑系统的分割,并在各个部分之间插入寄存器,并暂存中间数据的方法。 流水线操作的目的是把一个大操作分解为若干小操作,因为每一步操作变小了,所以时间更短,频率更快(面积换时间)。流水线在理各个阶段都需要增加寄存器保存中间计算状态,而且多条指令并行执行会导致功耗增加,硬件复杂度增加 函数&任务 函数返回一个值,而任务则不返回值 函数至少要有一个输入变量,而任务可以没有或有多个任何类型的变量。 函数只能与主模块共用同一个仿真时间单位,而任务可以定义自己的仿真时间单位。 函数不能启动任务,而任务能够启动其他任务和函数。 不可综合verilog语句 (1)initial:只能在test bench中使用,不能综合。 (2)events:event在同步test bench时更有用,不能综合。 (3)real:不支持real数据类型的综合。 (4)time:不支持time数据类型的综合。 (5)force 和release:不支持force和release的综合。 (6)assign 和deassign:不支持对reg 数据类型的assign或deassign进行综合,支持对wire数据类型的assign或deassign进行综合。 (7) fork join:不可综合,可以使用非块语句达到同样的效果。 (8) primitives:支持门级原语的综合,不支持非门级原语的综合。 (9) table:不支持UDP 和table的综合。 (10) 敏感列表里同时带有posedge和negedge 如:always @(posedge clk or negedge clk) begin...end 这个always块不可综合。 (11) 同一个reg变量被多个always块驱动 (12) 延时 以#开头的延时不可综合成硬件电路延时,综合工具会忽略所有延时代码,但不会报错。 如:a=#10 b; 这里的#10是用于仿真时的延时,在综合的时候综合工具会忽略它。也就是说,在综合的时候上式等同于a=b; (13) 与X、Z的比较 可能会有人喜欢在条件表达式中把数据和X(或Z)进行比较,殊不知这是不可综合的,综合工具同样会忽略。所以要确保信号只有两个状态:0或1。 功耗(Power)等于处理器上的电流值与电压值的乘积,可以反应处理器最大负荷运行、满载工作时电流热效应造成热量释放的大小指标,单位为瓦(W)。总功耗由静态和动态两部分组成 PGA芯片内有两种存储器资源:一种叫block ram,另一种是由LUT配置成的内部存储器(也就是分布式ram)。block ram由一定数量固定大小的存储块构成的,使用block ram,不占用额外的逻辑资源,并且速度快。但是使用的时钟消耗block ram的资源是其大小的整数倍。 FPGA时钟结构:全局时钟、局部时钟和I/O时钟 MMCM、PLL即时钟管理模块,用来消除时钟的延迟、抖动以及产生各种不同频率的时钟。 MMCM相对PLL的优势就是相位可动态调整,但PLL占用的面积更小。 一个属于单片机STM32(顺序处理) ,一个属于可编程阵列FPGA(并行处理) RAM随机读取存储器,掉电丢失 ROM只读存储器 Flash memory 是“闪存” EEPROM可以一次只擦除一个字节 单端口RAM:只有一组地址线数据线 伪双口RAM,一个端口只读,一个端口只写 同步复位&异步复位 同步复位:只有在时钟沿到来时复位信号才起作用,复位信号持续的时间应该超过一个时钟周期才能保证系统复位 异步复位:复位信号容易受到毛刺的影响。复位结束时刻恰在亚稳态窗口内时 异步复位同步释放最好 当异步复位有效时,复位信号立刻复位 信号释放时,会在时钟上升沿来临时,才可以恢复 一些小计算总结 %0表示用最少位数表示 进行取模运算%时,结果值的符号位采用模运算式里第一个操作数的符号位 对于有符号数来说: 若符号位为1,使用>>>,高位补1; 若符号位为0,使用>>>,高位补0; 对于无符号数来说,无论最高位是什么,使用>>>,高位都补0。 标识符可以是任意一组数字、字母、$符合和下划线的组合,但第一个字符必须是字母或者下划线
FPGA&ASIC
# ASIC/FPGA
刘航宇
2年前
0
2,504
6
Verilog语言实现读写txt文件方法
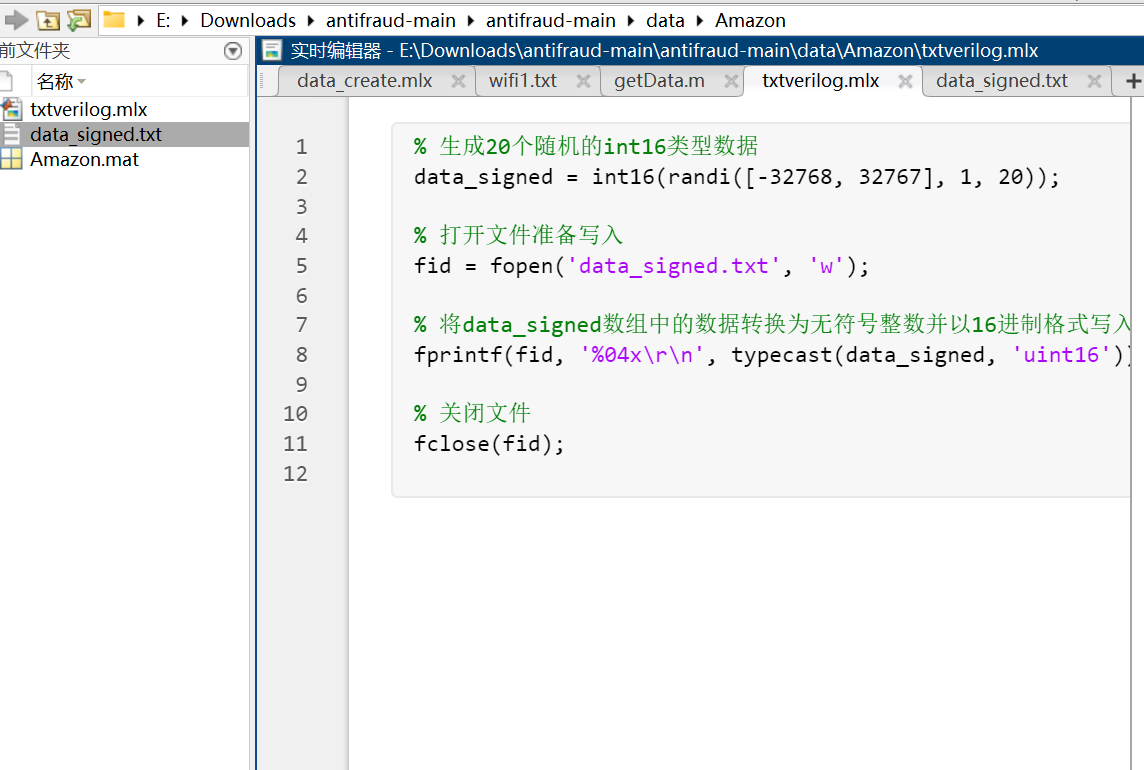
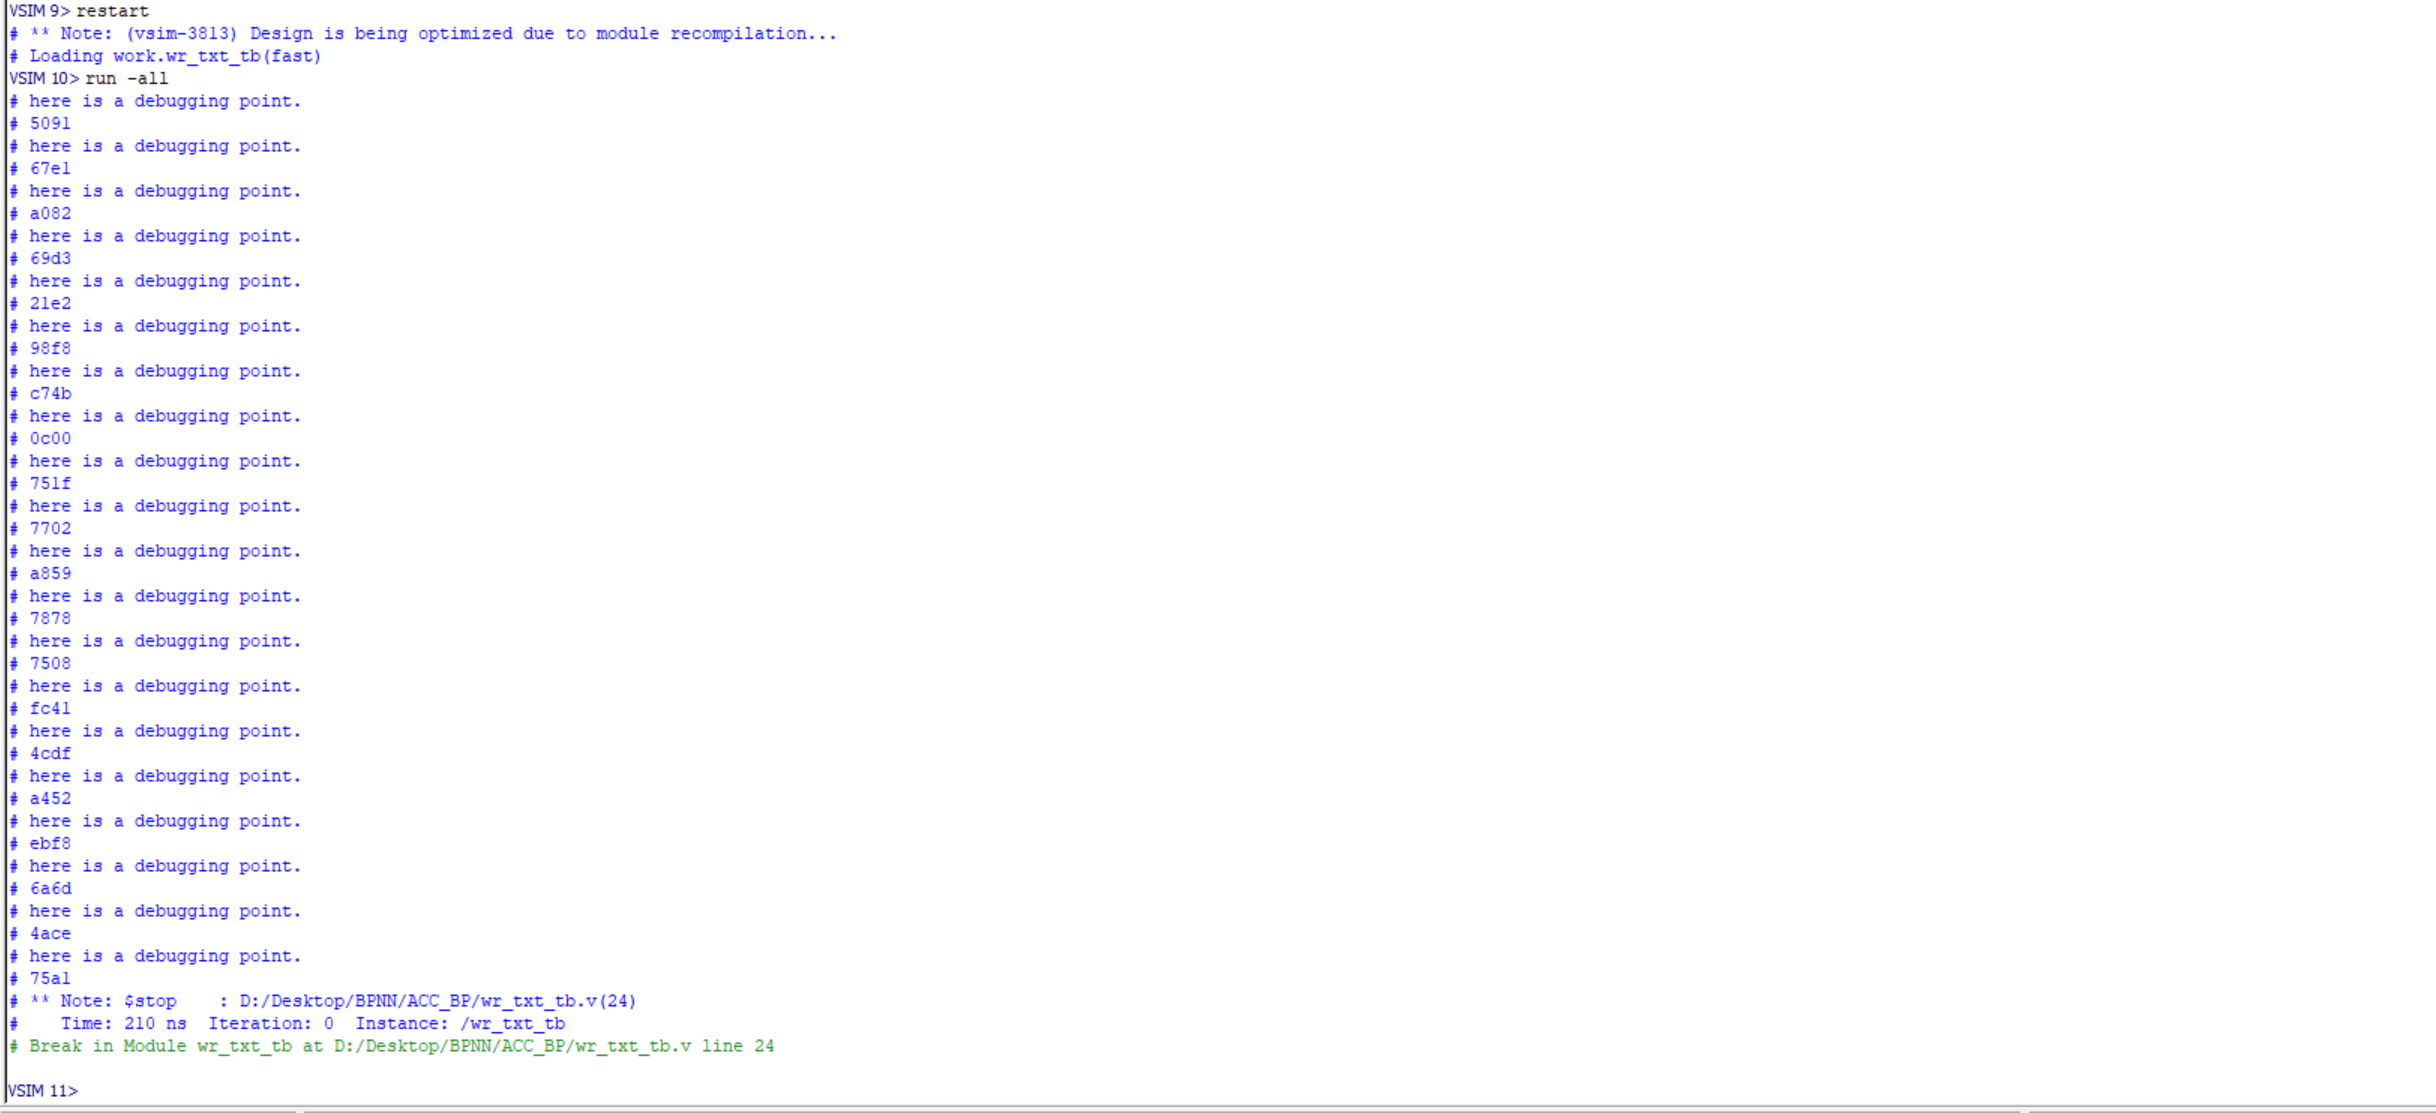
摘要本文介绍了Verilog语言中读写txt文件的方法。首先,通过MATLAB生成txt文件,并转换为十六进制格式。然后,在testbench中读取txt文件数据到寄存器,并按地址读取。接着,展示了如何写入txt文件,并提供了示例代码。最后,介绍了使用$display语句进行调试的方法。关键词:Verilog, 文件读写, txt文件, 测试集, 预测结果随着项目难度递增,例如AI芯片设计,不免需要验证Verilog的功能性,那么输入可以是测试集.txt,输出为预测结果/精确率.txt。下面讲解一下Verilog如何实现读写txt文件 一、读txt文件 二、写txt文件 $display语句的使用 demo案例 一、读txt文件 1、准备一个txt文件 MATLAB上生成的txt文件的格式为每行一个数据,与coe文件不同的是,数据之间没有逗号。由于verilog的读txt的系统函数仅仅能识别十六进制和二进制数据,一般情况下,将数据转换为十六进制数比较方便。当数据为有符号数时,可以采用下面的方式生成txt文件: % 生成20个随机的int16类型数据 data_signed = int16(randi([-32768, 32767], 1, 20)); % 打开文件准备写入 fid = fopen('data_signed.txt', 'w'); % 将data_signed数组中的数据转换为无符号整数并以16进制格式写入文件 fprintf(fid, '%04x\r\n', typecast(data_signed, 'uint16')); % 关闭文件 fclose(fid);图片 图片 其中,typecast(int16(data_signed),‘uint16’) 可以将数据转变为补码形式。同时,需要注意的是,在换行中,需要采用’\r\n‘,不能仅仅使用’\r’ 2、在testbench上读写 读txt文件时,一般选择先将txt中的数据置入寄存器memory中,然后按照地址读出memory中的数据。 reg [15:0] mem [0:1023]; reg [9:0] addr ; reg [11:0]data_out ; initial begin $readmemh("E:/self-study/VIVADO_workspace/prj/data_signed.txt",mem); addr = 10'd0; end always #10 begin data_out = mem[addr][11:0]; addr = addr + 10'd1; end需要注意的是,txt文件的地址不能出错,另外,注意地址分隔符需要用’/‘,windos系统中的’\‘需要对应改过来才能使用。 二、写txt文件 integer handle; initial begin handle = $fopen("E:/self-study/VIVADO_workspace/prj/data_out.txt"); end always@(posedge sys_clk) begin if(data_in_valid) begin $fdisplay(handle,"%d",data_out); end end利用initial函数初始化handle的值,另外,地址分隔符同样要改回来。 如果仿真之后,txt文件中并没有内容,可以尝试刷新一下txt文件。如果还没有内容出现,则就是txt文件没有关闭造成的,解决方法有两种: ①直接关闭xsim仿真程序,此时txt文件自动关闭,内容出现。 ②使用$fclose函数关闭文件,如果使能变量aagc_in_valid是一段高电平信号,则可以检测该信号的下降沿,在此时关闭文件即可: reg [2:0] valid_reg; always@(posedge sys_clk) begin valid_reg <= {valid_reg[1:0],data_in_valid}; if(valid_reg == 3'b110) begin $fclose(handle); end end甚至于,直接写一个计数器,也是可以的。 $display语句的使用 在功能仿真阶段调试程序时,$display是很有用的一段程序,它和java,c语言中的打印语句使用方法是相似的,可以把变量和语句运行状况打在TCL log的窗口上,供调试者知晓代码运行情况。 $display("here is a debugging point."); $display("%d", data_in);demo案例 module wr_txt_tb; reg [15:0] mem [0:1023]; reg [9:0] addr; reg [15:0] data_out; initial begin $readmemh("E:/Downloads/data_signed.txt", mem); addr = 10'd0; end always #10 begin if (addr < 10'd20) begin // 假设您只想读取前20个数据 data_out = mem[addr][15:0]; addr = addr + 10'd1; $display("here is a debugging point."); $display("%h", data_out); // 以十六进制形式打印 end else begin $stop; // 结束仿真 end end endmodule图片 图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
2年前
0
1,474
4
Socket通信-Linux系统中C语言实现TCP/UDP图片和文件传输
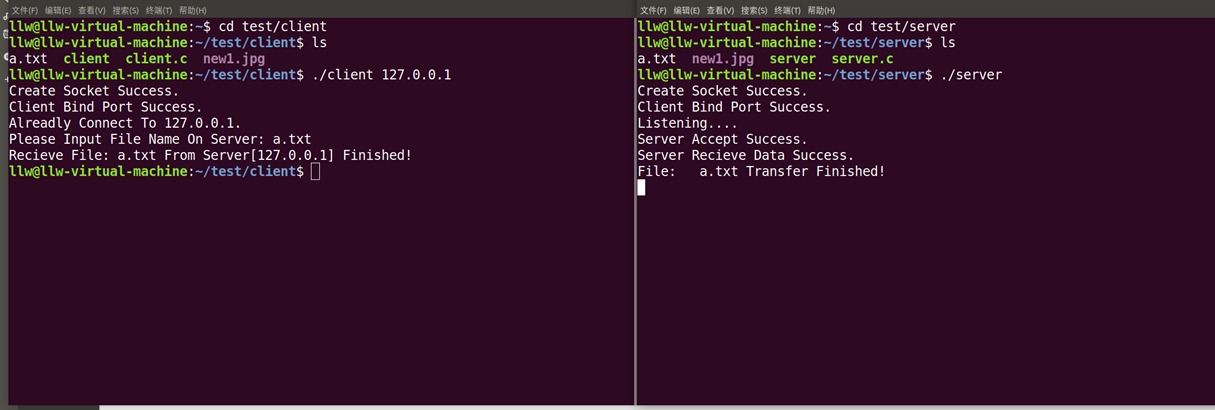
摘要本文介绍了在Linux系统中使用C语言实现TCP/UDP图片和文件传输的方法。首先讲解了TCP协议的建立连接过程,包括服务端和客户端的编程步骤,然后介绍了UDP协议的无连接特性及其编程步骤,并提供了服务端和客户端的代码示例。关键词:Socket通信, Linux系统, C语言, TCP/UDP, 图片文件传输TCP实现1.服务端 2.客户端 二、UDP实现1.服务端 2.客户端 TCP实现 传输控制协议(TCP,Transmission Control Protocol) 是为了在不可靠的互联网络上提供可靠的端到端字节流而专门设计的一个传输协议。TCP是因特网中的传输层协议,使用三次握手协议建立连接。当主动方发出SYN连接请求后,等待对方回答SYN+ACK,并最终对对方的 SYN 执行 ACK 确认。这种建立连接的方法可以防止产生错误的连接,TCP使用的流量控制协议是可变大小的滑动窗口协议。 1.服务端 基于TCP协议的socket的server端程序编程步骤: 1、建立socket ,使用socket() 2、绑定socket ,使用bind() 3、打开listening socket,使用listen() 4、等待client连接请求,使用accept() 5、收到连接请求,确定连接成功后,使用输入,输出函数recv(),send()与client端互传信息 6、关闭socket,使用close() 服务端代码server.c /*server.c*/ #include<netinet/in.h> #include<sys/types.h> #include<sys/socket.h> #include<stdio.h> #include<stdlib.h> #include<string.h> #define SERVER_PORT 5678 //端口号 #define LENGTH_OF_LISTEN_QUEUE 20 #define BUFFER_SIZE 1024 #define FILE_NAME_MAX_SIZE 512 int main(int argc, char **argv) { // 设置一个socket地址结构server_addr,代表服务器ip地址和端口 struct sockaddr_in server_addr; bzero(&server_addr, sizeof(server_addr)); server_addr.sin_family = AF_INET; server_addr.sin_addr.s_addr = htons(INADDR_ANY); server_addr.sin_port = htons(SERVER_PORT); // 创建用于流协议(TCP)socket,用server_socket代表服务器向客户端提供服务的接口 int server_socket = socket(PF_INET, SOCK_STREAM, 0); if (server_socket < 0) { printf("Create Socket Failed!\n"); exit(1); } else printf("Create Socket Success.\n"); // 把socket和socket地址结构绑定 if (bind(server_socket, (struct sockaddr*)&server_addr, sizeof(server_addr))) { printf("Server Bind Port: %d Failed!\n", SERVER_PORT); exit(1); } else printf("Client Bind Port Success.\n"); // server_socket用于监听 if (listen(server_socket, LENGTH_OF_LISTEN_QUEUE)) { printf("Server Listen Failed!\n"); exit(1); } else printf("Listening....\n"); // 服务器始终监听 while(1) { // 定义客户端的socket地址结构client_addr,当收到来自客户端的请求后,调用accept // 接受此请求,同时将client端的地址和端口等信息写入client_addr中 struct sockaddr_in client_addr; socklen_t length = sizeof(client_addr); // 接受一个从client端到达server端的连接请求,将客户端的信息保存在client_addr中 // 如果没有连接请求,则一直等待直到有连接请求为止,这是accept函数的特性 // accpet返回一个新的socket,这个socket用来与此次连接到server的client进行通信 // 这里的new_server_socket代表了这个通信通道 int new_server_socket = accept(server_socket, (struct sockaddr*)&client_addr, &length); if (new_server_socket < 0) { printf("Server Accept Failed!\n"); break; } else printf("Server Accept Success.\n"); char buffer[BUFFER_SIZE]; bzero(buffer, sizeof(buffer)); length = recv(new_server_socket, buffer, BUFFER_SIZE, 0); if (length < 0) { printf("Server Recieve Data Failed!\n"); break; } else printf("Server Recieve Data Success.\n"); char file_name[FILE_NAME_MAX_SIZE + 1]; bzero(file_name, sizeof(file_name)); strncpy(file_name, buffer, strlen(buffer) > FILE_NAME_MAX_SIZE ? FILE_NAME_MAX_SIZE : strlen(buffer)); FILE *fp = fopen(file_name, "r"); //获取文件操作符 if (fp == NULL) { printf("File:\t%s Not Found!\n", file_name); } else { bzero(buffer, BUFFER_SIZE); int file_block_length = 0; while( (file_block_length = fread(buffer, sizeof(char), BUFFER_SIZE, fp)) > 0) { // 发送buffer中的字符串到new_server_socket,实际上就是发送给客户端 if (send(new_server_socket, buffer, file_block_length, 0) < 0) { printf("Send File:\t%s Failed!\n", file_name); break; } bzero(buffer, sizeof(buffer)); } fclose(fp); printf("File:\t%s Transfer Finished!\n", file_name); } close(new_server_socket); } close(server_socket); return 0; } 2.客户端 基于TCP协议的socket的Client程序编程步骤: 1、建立socket,使用socket() 2、通知server请求连接,使用connect() 3、若连接成功,就使用输入输出函数recv(),send()与server互传信息 4、关闭socket,使用close() 客户端代码client.c /*client.c*/ #include<netinet/in.h> // for sockaddr_in #include<sys/types.h> // for socket #include<sys/socket.h> // for socket #include<stdio.h> // for printf #include<stdlib.h> // for exit #include<string.h> // for bzero #define SERVER_PORT 5678 #define BUFFER_SIZE 1024 #define FILE_NAME_MAX_SIZE 512 int main(int argc, char **argv) { if (argc != 2) //判断有没有输入服务器ip { printf("Usage: ./%s ServerIPAddress\n", argv[0]); exit(1); } // 设置一个socket地址结构client_addr, 代表客户机的ip地址和端口 struct sockaddr_in client_addr; bzero(&client_addr, sizeof(client_addr)); client_addr.sin_family = AF_INET; // internet协议族IPv4 client_addr.sin_addr.s_addr = htons(INADDR_ANY); // INADDR_ANY表示自动获取本机地址 client_addr.sin_port = htons(0); // auto allocated, 让系统自动分配一个空闲端口 // 创建用于internet的流协议(TCP)类型socket,用client_socket代表客户端socket int client_socket = socket(AF_INET, SOCK_STREAM, 0); if (client_socket < 0) { printf("Create Socket Failed!\n"); exit(1); } else printf("Create Socket Success.\n"); // 把客户端的socket和客户端的socket地址结构绑定 if (bind(client_socket, (struct sockaddr*)&client_addr, sizeof(client_addr))) { printf("Client Bind Port Failed!\n"); exit(1); } else printf("Client Bind Port Success.\n"); // 设置一个socket地址结构server_addr,代表服务器的internet地址和端口 struct sockaddr_in server_addr; bzero(&server_addr, sizeof(server_addr)); server_addr.sin_family = AF_INET; // 服务器的IP地址来自程序的参数 if (inet_aton(argv[1], &server_addr.sin_addr) == 0) { printf("Server IP Address Error!\n"); exit(1); } server_addr.sin_port = htons(SERVER_PORT); int server_addr_length = sizeof(server_addr); // 向服务器发起连接请求,连接成功后client_socket代表客户端和服务器端的一个socket连接 if (connect(client_socket, (struct sockaddr*)&server_addr, server_addr_length) < 0) { printf("Can Not Connect To %s!\n", argv[1]); exit(1); } else printf("Alreadly Connect To %s.\n", argv[1]); char file_name[FILE_NAME_MAX_SIZE + 1]; bzero(file_name, sizeof(file_name)); printf("Please Input File Name On Server: "); scanf("%s", file_name); char buffer[BUFFER_SIZE];//缓存区 bzero(buffer, sizeof(buffer)); strncpy(buffer, file_name, strlen(file_name) > BUFFER_SIZE ? BUFFER_SIZE : strlen(file_name)); // 向服务器发送buffer中的数据,此时buffer中存放的是客户端需要接收的文件的名字 send(client_socket, buffer, BUFFER_SIZE, 0); // send , sendto(), recv(),recvfrom() FILE *fp = fopen(file_name, "w"); if (fp == NULL) { printf("File: %s Can Not Open To Write!\n", file_name); exit(1); } // 从服务器端接收数据到buffer中 bzero(buffer, sizeof(buffer)); int length = 0; while(length = recv(client_socket, buffer, BUFFER_SIZE, 0)) { if (length < 0) { printf("Recieve Data From Server %s Failed!\n", argv[1]); break; } int write_length = fwrite(buffer, sizeof(char), length, fp); if (write_length < length) { printf("File:\t%s Write Failed!\n", file_name); break; } bzero(buffer, BUFFER_SIZE); } printf("Recieve File: %s From Server[%s] Finished!\n", file_name, argv[1]); // 传输完毕,关闭socket fclose(fp); close(client_socket); return 0; } 如图,客户端(左)从服务端(右)下载文件/图片: 图片 二、UDP实现 UDP(User Datagram Protocol) 全称是用户数据报协议,是一种非面向连接的协议,这种协议并不能保证我们的网络程序的连接是可靠的。 1.服务端 基于UDP协议的socket的server编程步骤: 1、建立socket,使用socket() 2、绑定socket,使用bind() 3、以recvfrom()函数接收发送端传来的数据(使用recvfrom函数 时需设置非阻塞,以免程序卡在此处) 4、关闭socket,使用close() /*server.c*/ #include<netinet/in.h> #include<sys/types.h> #include<sys/socket.h> #include<stdio.h> #include<stdlib.h> #include<string.h> #define SERVER_PORT 5678 //端口号 #define LENGTH_OF_LISTEN_QUEUE 20 #define BUFFER_SIZE 1024 #define FILE_NAME_MAX_SIZE 512 int main(int argc, char **argv) { // 设置一个socket地址结构server_addr,代表服务器internet的地址和端口 struct sockaddr_in server_addr; bzero(&server_addr, sizeof(server_addr)); server_addr.sin_family = AF_INET; server_addr.sin_addr.s_addr = htons(INADDR_ANY); server_addr.sin_port = htons(SERVER_PORT); // create a stream socket // 创建用于internet的流协议(UDP)socket,用server_socket代表服务器向客户端提供服务的接口 int server_socket = socket(PF_INET, SOCK_DGRAM, 0); if (server_socket < 0) { printf("Create Socket Failed!\n"); exit(1); } else printf("Create Socket Success.\n"); // 把socket和socket地址结构绑定 if (bind(server_socket, (struct sockaddr*)&server_addr, sizeof(server_addr))) { printf("Server Bind Port: %d Failed!\n", SERVER_PORT); exit(1); } else printf("Server Bind Port Success.\n"); printf("Waiting......\n"); // 服务器端一直运行用以持续为客户端提供服务 while(1) { // 接受此请求,同时将client端的地址和端口等信息写入client_addr中 struct sockaddr_in client_addr; int length = 0; int addrlen = sizeof(client_addr); char buffer[BUFFER_SIZE]; bzero(buffer, sizeof(buffer)); length = recvfrom(server_socket, buffer, BUFFER_SIZE, 0,(struct sockaddr *)&client_addr,&addrlen); if (length < 0) { printf("Server Recieve Data Failed!\n"); break; } char file_name[FILE_NAME_MAX_SIZE + 1]; bzero(file_name, sizeof(file_name)); strncpy(file_name, buffer, strlen(buffer) > FILE_NAME_MAX_SIZE ? FILE_NAME_MAX_SIZE : strlen(buffer)); FILE *fp = fopen(file_name, "r"); if (fp == NULL) { printf("File:\t%s Not Found!\n", file_name); } else { bzero(buffer, BUFFER_SIZE); int file_block_length = 0; while( (file_block_length = fread(buffer, sizeof(char), BUFFER_SIZE, fp)) > 0) { // 发送buffer中的字符串到server_socket,实际上就是发送给客户端 if (sendto(server_socket, buffer, BUFFER_SIZE, 0,(struct sockaddr *)&client_addr,addrlen) < 0) { printf("Send File:\t%s Failed!\n", file_name); break; } bzero(buffer, sizeof(buffer)); } fclose(fp); printf("File:\t%s Transfer Finished!\n", file_name); } } close(server_socket); return 0; }2.客户端 基于UDP协议的socket的client端编程步骤: 1、建立Socket,使socket() 2、用sendto()函数向接收端发送数据。 3、关闭socket,使用close()函数 /*client.c*/ #include<netinet/in.h> // for sockaddr_in #include<sys/types.h> // for socket #include<sys/socket.h> // for socket #include<stdio.h> // for printf #include<stdlib.h> // for exit #include<string.h> // for bzero #include <fcntl.h> #include <unistd.h> #include <sys/time.h> #define SERVER_PORT 5678 #define BUFFER_SIZE 1024 #define FILE_NAME_MAX_SIZE 512 int main(int argc, char **argv) { if (argc != 2) { printf("Usage: ./%s ServerIPAddress\n", argv[0]); exit(1); } // 设置一个socket地址结构client_addr, 代表客户机的internet地址和端口 struct sockaddr_in client_addr; bzero(&client_addr, sizeof(client_addr)); client_addr.sin_family = AF_INET; // internet协议族 client_addr.sin_addr.s_addr = htons(INADDR_ANY); // INADDR_ANY表示自动获取本机地址 client_addr.sin_port = htons(0); // auto allocated, 让系统自动分配一个空闲端口 // 创建用于internet的流协议(TCP)类型socket,用client_socket代表客户端socket int client_socket = socket(AF_INET, SOCK_DGRAM, 0); if (client_socket < 0) { printf("Create Socket Failed!\n"); exit(1); } // 设置超时,防止recvfrom()函数阻塞 struct timeval timeout; timeout.tv_sec = 1;//秒 timeout.tv_usec = 0;//微秒 if (setsockopt(client_socket, SOL_SOCKET, SO_RCVTIMEO, &timeout, sizeof(timeout)) == -1) { perror("setsockopt failed:"); } // 把客户端的socket和客户端的socket地址结构绑定 if (bind(client_socket, (struct sockaddr*)&client_addr, sizeof(client_addr))) { printf("Client Bind Port Failed!\n"); exit(1); } // 设置一个socket地址结构server_addr,代表服务器的internet地址和端口 struct sockaddr_in server_addr; bzero(&server_addr, sizeof(server_addr)); server_addr.sin_family = AF_INET; // 服务器的IP地址来自程序的参数 if (inet_aton(argv[1], &server_addr.sin_addr) == 0) { printf("Server IP Address Error!\n"); exit(1); } server_addr.sin_port = htons(SERVER_PORT); int server_addr_length = sizeof(server_addr); char file_name[FILE_NAME_MAX_SIZE + 1]; bzero(file_name, sizeof(file_name)); printf("Please Input File Name On Server: "); scanf("%s", file_name); char buffer[BUFFER_SIZE]; bzero(buffer, sizeof(buffer)); strncpy(buffer, file_name, strlen(file_name) > BUFFER_SIZE ? BUFFER_SIZE : strlen(file_name)); // 向服务器发送buffer中的数据,此时buffer中存放的是客户端需要接收的文件的名字 if( sendto(client_socket, buffer, BUFFER_SIZE, 0,(struct sockaddr *)&server_addr,server_addr_length) ) printf("Waiting receive %s from server....\n",file_name); FILE *fp = fopen(file_name, "w"); if (fp == NULL) { printf("File:\t%s Can Not Open To Write!\n", file_name); exit(1); } // 从服务器端接收数据到buffer中 bzero(buffer, sizeof(buffer)); int length = 0; //length = recvfrom(client_socket, buffer, BUFFER_SIZE, 0, (struct sockaddr*)&server_addr, &server_addr_length)//非阻塞 while( length = recvfrom(client_socket, buffer, BUFFER_SIZE, 0, (struct sockaddr*)&server_addr, &server_addr_length)) { if (length < 0) { //printf("Recieve Data From Server %s Failed!\n", argv[1]); break; } int write_length = fwrite(buffer, sizeof(char), length, fp); if (write_length < length) { printf("File: %s Write Failed!\n", file_name); break; } bzero(buffer, BUFFER_SIZE); } printf("Receive File: %s From Server[%s] Finished!\n", file_name, argv[1]); // 传输完毕,关闭socket fclose(fp); close(client_socket); return 0; } 如图,客户端(左)从服务端(右)下载文件/图片: 图片 注:使用recvfrom函数 时需设置非阻塞,以免程序卡住。
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
791
0
2024-01-20
机器学习/深度学习-训练过程讲解acc/loss/val_acc/val_loss分析
摘要本文探讨了机器学习/深度学习训练过程中的loss、acc、val_acc、val_loss等指标分析,强调了模型选择、参数调优和过拟合问题,并提供了解决训练过程中震荡和收敛问题的方法。关键词:机器学习, 深度学习, 训练过程, loss分析, accuracy计算loss是会把所有loss层的loss相加。 那么如何选取一个较为理想的medel? 单独观察训练集loss曲线 loss出现NAN 联合观察loss曲线和acc TensorFlow中loss与val_loss、accuracy和val_accuracy含义 震荡修复 计算loss是会把所有loss层的loss相加。 从验证集误差是和测试集误差的角度分析 其实你这个问题就是个伪命题,如果我们刻意的去在训练集上拟合模型,使其准确率达到很高的高度,或者说尽量在验证集合上表现的好,都是相悖的。 因为我们不能为了某一特定数据集来刻意拟合,因为模型预测数据是不一定就在这个训练或者验证集合的空间中。 还有,如果这个model预测集合acc20% 训练集合acc19% (即训练集精度低于测试集精度),那么这个模型肯定是不好的。 还有一点需要注意,就是千万不能为了拟合测试集合而去更改模型,测试集合应该每次都有不同。 那么如何选取一个较为理想的medel? 首先,要有一个期望的准确率,通过不同模型的实验,找到最能接近的; 然后,选定模型后进行参数调优; 那么我们要尽可能的提高model的准确率,同时提高其泛化的能力,不能单一看某一指标,此时可参考 准确率、召回率、虚警率、F1Score等指标综合评判。或者采用多重验证随机划分训练、预测、验证集合,多次随机后找到最优参数。 有时候训练集合误差很低,但是泛化能力极差,产生过拟合, 有时候验证集合误差很低,但是可能验证集合无法代表所有的样本,有特殊性或者其他异常点较多。 所以模型问题不能单一从你这两点来评判。 一般而言,训练集loss < 验证集loss <测试集loss 因为网络 [已见过] 所有训练集samples,故最低。而网络用验证集作为反馈来调节参数,相当于参考了验证集samples中的信息(间接 [已见过])。又因为网络没有任何测试集的信息,所以测试结果一般而言最差。 不过这都不是绝对的,有不符合这个一般现象的task,而我们不可以说哪种情况更“好”。 多数情况验证集上错误率更低一点。因为是选择在验证集上准确率最高的模型来进行测试。考虑到数据的随机性,在验证集上准确率最高的模型在测试集上不一定是最高的,所以算出来的指标通常验证集会比测试集上好一点。 但是实际情况下都有可能,特别是数据量不太大的时候。样本集合的数据也只是近似整体的分布,肯定会有波动。 一个好的网络,二者的差距应该是很低的。但一般情况下因为网络不可避免地存在一定程度上的过拟合,所以肯定是train_loss低于test_lost,但如果低太多,就得考虑是过拟合的问题还是因为样本的特征空间不统一的问题。 一般训练集不大时,最终训练的网络及容易过拟合,也就是说train-loss一定会收敛,但是test-loss不会收敛; 训练时的loss会低于test的loss大概1~2个数量级,通常是10倍左右。 单独观察训练集loss曲线 1)如果你的 learning_rate_policy 是 step 或者其他变化类型的话, loss 曲线可以帮助你选择一个比较合适的 stepsize; 2)如果loss曲线表现出线性(下降缓慢)表明学习率太低; 3)如果loss不再下降,表明学习率太高陷入局部最小值; 4)曲线的宽度和batch size有关,如果宽度太宽,说明相邻batch间的变化太大,应该减小batch size。 可能导致不收敛的问题(如loss为87.3365,loss居高不下等)的解决方案 1)在caffe中可以在solver里面设置:debug_info: true,看看各个层的data和diff是什么值,一般这个时候那些值不是NAN(无效数字)就是INF(无穷大); 2)检查数据标签是否从0开始并且连续; 3)把学习率base_lr调低; 4)数据问题,lmdb生成有误; 5)中间层没有归一化,导致经过几层后,输出的值已经很小了,这个时候再计算梯度就比较尴尬了,可以尝试在各个卷积层后加入BN层和SCALE层; 5)把base_lr调低,然后batchsize也调高; 6)把data层的输入图片进行归一化,就是从0-255归一化到0-1,使用的参数是: transform_param { scale: 0.00390625//像素归一化,1/255 } 7)网络参数太多,网络太深,删掉几层看看,可能因为数据少,需要减少中间层的num_output; 8)记得要shuffle数据,否则数据不够随机,几个batch之间的数据差异很小。 loss出现NAN 1)观察loss值的趋势,如果迭代几次以后一直在增大,最后变成nan,那就是发散了,需要考虑减小训练速率,或者是调整其他参数。 2)数据不能太少,如果太少的话很容易发散" 3)Gradient Clipp 处理gradient之后往后传,一定程度上解决梯度爆炸问题。(但由于有了batch normalization,此方法用的不多) 4)原因可能是训练的时间不够长。 5)可以看一下训练时,网络参数的L2或L1 联合观察loss曲线和acc 1)单独的 loss 曲线能提供的信息很少的,一般会结合测试机上的 accuracy 曲线来判断是否过拟合; 2)关键是要看你在测试集上的acc如何; 3)可以把accuracy和loss的曲线画出来,方便设定stepsize,一般在accuracy和loss都趋于平缓的时候就可以减小lr了; 4)看第一次test时(即iteration 0),loss和精度,如果太差,说明初始点的设置有问题 5)使用caffe时,train时,看见的loss是训练集的;accuracy才是测试集的 6)所谓的过拟合是:loss下降,accuracy也下降 TensorFlow中loss与val_loss、accuracy和val_accuracy含义 图片 loss:训练集损失值 accuracy:训练集准确率 val_loss:测试集损失值 val_accruacy:测试集准确率 以下5种情况可供参考: train loss 不断下降,test loss不断下降,说明网络仍在学习;(最好的) train loss 不断下降,test loss趋于不变,说明网络过拟合;(max pool或者正则化) train loss 趋于不变,test loss不断下降,说明数据集100%有问题;(检查dataset) train loss 趋于不变,test loss趋于不变,说明学习遇到瓶颈,需要减小学习率或批量数目;(减少学习率) train loss 不断上升,test loss不断上升,说明网络结构设计不当,训练超参数设置不当,数据集经过清洗等问题。(最不好的情况) 震荡修复 验证集曲线震荡 图片 分析原因:训练的batch_size太小 目前batch_size = 64,改成128: 图片 改成200: 图片 可见,增大batch_size 变大,震荡逐渐消失,同时在测试集的acc也提高了。batch_size为200时,训练集acc小于测试集,模型欠拟合,需要继续增大epoch。 总结 增大batchsize的好处有三点: 1)内存的利用率提高了,大矩阵乘法的并行化效率提高。 2)跑完一次epoch(全数据集)所需迭代次数减少,对于相同的数据量的处理速度进一步加快,但是达到相同精度所需要的epoch数量也越来越多。由于这两种因素的矛盾, batch_Size 增大到某个时候,达到时间上的最优。 3)一定范围内,batchsize越大,其确定的下降方向就越准,引起训练震荡越小。 盲目增大的坏处: 1)当数据集太大时,内存撑不住。 2)过大的batchsize的结果是网络很容易收敛到一些不好的局部最优点。 3)batchsize增大到一定的程度,其确定的下降方向已经基本不再变化。 4)太小的batch也存在一些问题,比如训练速度很慢,训练不容易收敛等。 5)具体的batch size的选取和训练集的样本数目相关。
机器学习
# 机器学习
刘航宇
2年前
0
3,488
3
2024-01-11
嵌入式常见知识点
摘要本文介绍了嵌入式系统开发中常见的知识点,包括线程与进程的区别、整数是否为2的n次方的计算方法、printf函数的实现、大小端的概念及区分方法、new与malloc的区别、程序链接后的组成部分、Linux、Windows与FreeRTOS的区别等。关键词:嵌入式, 进程, 线程, 位运算, 快速排序图片 1、线程、进程的区别?最小执行单元是进程还是线程? 2、如何计算一个整数是不是2的n次方? 3、printf的具体实现? 4、什么是大小端?如何区分?有几种方法? 5、new与malloc的区别? 6、程序链接完毕之后分几部分? 7、Linux、Windows与FreeRtos的区别? 8、Linux系统中的中断为什么分为上下两个部分? 9、会快速排序吗?简要说一下? 10、static关键字的作用? 11、extern 关键字的作用? 12、volatile关键字的作用? 13、编译原理分哪几步? 14、内存分区? 15、freertos启动流程? 16、互斥锁与信号量的区别? 17、什么是死锁?死锁产生的原因?如何避免? 18、什么是内存泄漏? 19、系统死机了怎么排查原因?逐一看代码?工程量太大了吧? 20、同一类型的结构体定义两个变量能用内存大小来比较判断两者一样吗?(没懂) 21、freertos中EventBits_t是干啥的? 22、freertos使任务切换的方式有哪些? 23、项目中用到网络了吗? 24、了解Socket吗? 25、c++中set是什么? 26、有没有用到C++模板? 27、有没有对代码裁剪的经验 28、freertos系统是买模块时人家配置好的?还是移植的? 29、任务里有两把锁的时候该怎么处理 30、熟悉Shell脚本吗?$和#啥意思? 表示注释的开始,可以用来对代码进行说明,不会被执行,例如#echo hello,#这是一个注释,表示打印hello,后面的内容是一个注释。31、知道#error吗? 32、freertos消息队列的的具体实现? 33、堆栈区别? 34、程序存放状态和区别 1、线程、进程的区别?最小执行单元是进程还是线程? 线程和进程都是程序的执行实体,但是它们有以下区别: 进程是操作系统分配资源的基本单位,每个进程都有自己的独立的地址空间,代码段,数据段,堆栈段等。进程之间的切换需要保存和恢复上下文,开销较大。 线程是操作系统调度的基本单位,每个线程都属于某个进程,一个进程可以有多个线程,它们共享进程的地址空间,但是有自己的栈和寄存器。线程之间的切换只需要保存和恢复少量的寄存器,开销较小。 最小的执行单元是线程,因为一个进程至少要有一个线程,而一个线程可以独立运行。 2、如何计算一个整数是不是2的n次方? 一个整数是2的n次方,当且仅当它的二进制表示中只有一个1,其余都是0。例如,23=8=(1000)2 ,只有一个1。所以,我们可以用以下的方法来判断一个整数x是否是2的n次方: 如果x小于等于0,那么它不是2的n次方。 如果x大于0,那么我们可以用位运算的技巧,将x与x-1做按位与,如果结果为0,那么x是2的n次方,否则不是。例如,8&(8−1)=8&7=(1000)2&(0111)2=(0000)2=0 ,所以8是2的n次方。而9&(9−1)=9&8=(1001)2&(1000)2=(1000)2=0 ,所以9不是2的n次方。 3、printf的具体实现? printf是C语言中的一个标准库函数,用于向标准输出流(通常是屏幕)打印格式化的字符串。它的具体实现可能因编译器和操作系统的不同而有所差异,但是一般来说,它的主要步骤如下: 首先,printf会解析第一个参数,也就是格式化字符串,根据其中的转换说明符(如%d, %f, %s等),确定需要打印的数据类型和格式。 然后,printf会从第二个参数开始,依次获取对应的数据,并将其转换为字符串,拼接到格式化字符串的相应位置。如果参数的个数和类型与格式化字符串不匹配,可能会导致错误或未定义的行为。 最后,printf会调用底层的系统函数,将拼接好的字符串写入到标准输出流中,并返回成功写入的字符数。如果发生错误,返回负值。 4、什么是大小端?如何区分?有几种方法? 大小端是指数据在内存中的存储顺序,大端表示高位字节存放在低地址,低位字节存放在高地址,小端表示高位字节存放在高地址,低位字节存放在低地址。例如,一个32位的整数0x12345678,在大端模式下,存储为0x12 0x34 0x56 0x78,而在小端模式下,存储为0x78 0x56 0x34 0x12。 区分大小端的方法有以下几种: 通过联合体(union)的方式,将一个整数和一个字符数组放在同一个联合体中,然后判断字符数组的第一个元素是不是整数的最低字节,如果是,说明是小端,否则是大端。 通过指针的方式,将一个整数的地址赋给一个字符指针,然后判断指针指向的内容是不是整数的最低字节,如果是,说明是小端,否则是大端。 通过位运算的方式,将一个整数右移24位,然后与0xFF做按位与,得到的结果是不是整数的最高字节,如果是,说明是大端,否则是小端。 5、new与malloc的区别? new和malloc都是用于动态分配内存的,但是它们有以下区别: new是C++中的运算符,malloc是C语言中的函数,它们的用法不同。new可以直接分配对象,而malloc只能分配字节,需要强制类型转换。 new会调用对象的构造函数,初始化对象,而malloc只是分配原始的内存空间,不做任何初始化。 new会根据对象的类型,自动计算所需的内存大小,而malloc需要手动指定分配的字节数。 new分配失败时,会抛出异常,而malloc分配失败时,会返回NULL指针。 new对应的释放内存的运算符是delete,而malloc对应的释放内存的函数是free。 6、程序链接完毕之后分几部分? 程序链接完毕之后,一般分为以下几个部分: 代码段(text segment),存放程序的指令和常量。 数据段(data segment),存放程序的全局变量和静态变量。 堆(heap),存放程序动态分配的内存空间。 栈(stack),存放程序的局部变量,函数参数,返回地址等。 BSS段(bss segment),存放程序未初始化的全局变量和静态变量。 7、Linux、Windows与FreeRtos的区别? Linux、Windows和FreeRtos都是操作系统,但是它们有以下区别: Linux是一个开源的,基于Unix的,多用户,多任务,支持多种硬件平台的操作系统,它有很多不同的发行版,如Ubuntu,RedHat,Debian等。Linux适合用于服务器,嵌入式系统,桌面系统等。 Windows是一个闭源的,基于NT内核的,多用户,多任务,主要支持x86和x64架构的操作系统,它有很多不同的版本,如Windows 10,Windows Server,Windows CE等。Windows适合用于桌面系统,移动设备,游戏机等。 FreeRtos是一个开源的,基于微内核的,实时,多任务,支持多种嵌入式平台的操作系统,它有很多不同的移植,如ARM,MIPS,AVR等。FreeRtos适合用于实时控制,物联网,低功耗设备等。 8、Linux系统中的中断为什么分为上下两个部分? Linux系统中的中断为了提高效率和响应时间,分为上半部(top half)和下半部(bottom half)。上半部是指中断处理程序(interrupt handler),它负责处理中断的紧急事务,如保存寄存器,清除中断标志,识别中断源等。下半部是指中断延迟服务程序(interrupt deferred service routine),它负责处理中断的非紧急事务,如数据传输,设备驱动,信号发送等。上半部和下半部的区别如下: 上半部在中断上下文中执行,下半部在进程上下文中执行。 上半部不能被其他中断打断,下半部可以被其他中断打断。 上半部不能睡眠,下半部可以睡眠。 上半部不能调用可能导致阻塞的函数,如malloc,copy_to_user等,下半部可以调用这些函数。 上半部的执行时间应该尽可能短,下半部的执行时间可以较长。 9、会快速排序吗?简要说一下? 快速排序是一种基于分治思想的排序算法,它的基本步骤如下: 从待排序的数组中选择一个元素作为基准(pivot),通常选择第一个或者最后一个元素。 将数组分成两个子数组,一个子数组中的元素都小于或等于基准,另一个子数组中的元素都大于基准,这个过程称为划分(partition)。 对两个子数组递归地进行快速排序,直到子数组的长度为1或0。 将排好序的子数组合并,得到最终的排序结果。 快速排序的平均时间复杂度是O(nlogn) ,最坏情况是O(n^2) ,空间复杂度是O(logn) ,它是一种不稳定的排序算法。 10、static关键字的作用? static是一个修饰符,它可以用于变量和函数,它有以下作用: 用于全局变量,表示该变量只能在本文件中访问,不能被其他文件引用,这样可以避免命名冲突。 用于局部变量,表示该变量的生命周期是整个程序,而不是函数调用结束,这样可以保持变量的值不被销毁。 用于函数,表示该函数只能在本文件中调用,不能被其他文件引用,这样可以提高函数的封装性和安全性。 11、extern 关键字的作用? extern是一个修饰符,它可以用于变量和函数,它有以下作用: 用于变量,表示该变量是在其他文件中定义的,需要在本文件中引用,这样可以避免重复定义。 用于函数,表示该函数是在其他文件中定义的,需要在本文件中声明,这样可以避免隐式声明。 12、volatile关键字的作用? volatile是一个修饰符,它可以用于变量,它有以下作用: 用于变量,表示该变量可能会被外部因素(如中断,多线程,硬件等)改变,需要每次都从内存中读取,而不是从寄存器或缓存中读取,这样可以保证变量的实时性和一致性。 用于变量,表示该变量不会被编译器优化,需要按照程序的顺序执行,而不是进行重排或删除,这样可以避免编译器的干扰。 13、编译原理分哪几步? 编译原理是指将一种高级语言(源语言)的程序转换为另一种低级语言(目标语言)的程序的原理和方法,它一般分为以下几个步骤: 词法分析(lexical analysis),将源程序的字符序列分割成有意义的单词(token)。 语法分析(syntax analysis),将单词序列组织成语法树(parse tree)或抽象语法树(abstract syntax tree),表示程序的结构和语义。 语义分析(semantic analysis),检查程序是否符合语言的语法规则和语义规则,如类型检查,作用域分析等。 中间代码生成(intermediate code generation),将抽象语法树转换为一种中间表示(intermediate representation),如三地址码,四元式,后缀表达式等,便于优化和目标代码生成。 代码优化(code optimization),对中间表示进行一些变换,以提高程序的执行效率,如常量折叠,公共子表达式消除,循环优化,死代码删除等。 目标代码生成(target code generation),将中间表示转换为目标语言的代码,如汇编语言,机器语言等,同时进行一些分配,如寄存器分配,指令选择等。 14、内存分区? 内存分区是指将物理内存划分为若干个逻辑区域,以便于管理和使用。内存分区的方式有以下几种: 固定分区,将内存分为大小相等或不等的若干个区域,每个区域只能装入一个进程,如果进程的大小超过区域的大小,就会产生内部碎片。 动态分区,根据进程的大小和数量,动态地分配和回收内存空间,每个区域可以装入一个或多个进程,如果进程的大小不是区域的整数倍,就会产生外部碎片。 页式分区,将进程的地址空间划分为大小相等的若干个页,将物理内存划分为大小相等的若干个页框,然后将页映射到页框,实现非连续的内存分配,避免了外部碎片,但是可能产生内部碎片。 段式分区,将进程的地址空间划分为大小不等的若干个段,每个段有自己的逻辑地址和属性,然后将段映射到物理内存,实现非连续的内存分配,避免了内部碎片,但是可能产生外部碎片。 段页式分区,将进程的地址空间划分为若干个段,每个段再划分为若干个页,然后将页映射到物理内存的页框,实现非连续的内存分配,避免了内部碎片和外部碎片,但是增加了地址转换的复杂度。 15、freertos启动流程? freertos是一个实时操作系统,它的启动流程一般如下: 首先,执行硬件初始化,如设置时钟,中断,堆栈等。 然后,执行软件初始化,如创建任务,队列,信号量,定时器等。 接着,调用vTaskStartScheduler ()函数,启动调度器,选择优先级最高的就绪任务运行。 最后,当发生中断,延时,阻塞等事件时,调度器会根据算法,如优先级抢占式,时间片轮转式等,切换任务,实现多任务的并发执行。 16、互斥锁与信号量的区别? 互斥锁(mutex)和信号量(semaphore)都是用于实现多任务的同步和互斥的机制,但是它们有以下区别: 互斥锁是一个二元的同步对象,它只有两种状态:锁定和解锁。一个互斥锁只能被一个任务拥有,当一个任务获取互斥锁后,其他任务就不能再获取该互斥锁,直到拥有者释放它。互斥锁通常用于保护临界区的访问,避免数据的不一致。 信号量是一个计数的同步对象,它有一个初始值,表示可用的资源数量。一个信号量可以被多个任务共享,当一个任务获取信号量后,信号量的值减一,表示资源被占用。当信号量的值为零时,表示没有可用的资源,其他任务就要等待,直到有任务释放信号量,信号量的值加一,表示资源被释放。信号量通常用于实现生产者-消费者模型,控制资源的分配和回收。 17、什么是死锁?死锁产生的原因?如何避免? 死锁是指多个任务因为争夺有限的资源而相互等待,导致无法继续执行的现象。死锁产生的原因一般有以下四个必要条件: 互斥条件,指每个资源只能被一个任务拥有,其他任务不能访问。 占有且等待条件,指一个任务已经占有了至少一个资源,但是又申请了其他已经被占有的资源,同时不释放自己已经占有的资源。 不可抢占条件,指一个任务占有的资源不能被其他任务强行剥夺,只能由占有者主动释放。 循环等待条件,指多个任务形成一个环路,每个任务都在等待下一个任务占有的资源。 避免死锁的方法有以下几种: 破坏互斥条件,使用非互斥的资源,如可复制的资源,或者使用软件技术,如事务,来实现对资源的虚拟访问。 破坏占有且等待条件,要求一个任务在申请资源时,必须一次性申请所有需要的资源,或者在申请新的资源时,必须先释放已经占有的资源。 破坏不可抢占条件,允许一个任务在占有资源时,被其他任务抢占,或者主动释放资源,以满足其他任务的需求。 破坏循环等待条件,给每个资源分配一个优先级,要求一个任务只能申请优先级高于或等于自己已经占有的资源的资源,或者按照一定的顺序申请资源,避免形成环路。 18、什么是内存泄漏? 内存泄漏是指程序在运行过程中,动态分配了一些内存空间,但是没有及时释放,导致这些内存空间无法被其他程序使用,造成内存的浪费和紧张。内存泄漏可能会导致程序的性能下降,甚至崩溃。 19、系统死机了怎么排查原因?逐一看代码?工程量太大了吧? 系统死机是指系统无法响应用户的输入,或者出现异常的错误,导致系统无法正常运行。排查系统死机的原因有以下几种方法: 通过日志文件,查看系统在死机前的运行状态,是否有异常的信息,如错误码,警告,断言等,以及死机的时间,位置,频率等,从而定位可能的问题源。 通过调试工具,如gdb,lldb等,对系统进行调试,查看系统的内存,寄存器,堆栈,断点等,分析系统的运行流程,发现潜在的错误,如内存泄漏,空指针,死锁等。 通过测试工具,如valgrind,asan等,对系统进行测试,检测系统的内存管理,性能,覆盖率等,发现系统的缺陷,如内存错误,资源泄漏,性能瓶颈等。 通过代码审查,对系统的代码进行分析,检查代码的风格,规范,逻辑,注释等,发现代码的不合理,不一致,不完善等,提高代码的质量,可读性,可维护性等。 通过重现问题,对系统的死机现象进行复现,观察系统的表现,输入,输出等,找出问题的触发条件,规律,范围等,缩小问题的范围,提高问题的可解决性。 20、同一类型的结构体定义两个变量能用内存大小来比较判断两者一样吗?(没懂) 同一类型的结构体定义两个变量,不能用内存大小来比较判断两者一样,因为内存大小只能反映结构体的占用空间,而不能反映结构体的内容。例如,以下两个结构体变量的内存大小都是8字节,但是它们的内容是不一样的: struct Point { int x; int y; }; struct Point p1 = {1, 2}; struct Point p2 = {3, 4}; 如果要比较两个结构体变量是否一样,需要逐个比较它们的成员,或者使用memcmp函数比较它们的内存内容。例如: // 逐个比较 if (p1.x == p2.x && p1.y == p2.y) { printf("p1 and p2 are equal\n"); } else { printf("p1 and p2 are not equal\n"); } // 使用memcmp比较 if (memcmp(&p1, &p2, sizeof(struct Point)) == 0) { printf("p1 and p2 are equal\n"); } else { printf("p1 and p2 are not equal\n"); }21、freertos中EventBits_t是干啥的? EventBits_t是一个数据类型,它用于表示事件标志组(event group)中的每个位的状态,每个位可以表示一个事件的发生或者一个条件的满足。EventBits_t通常是一个无符号整数,它可以使用位运算来设置,清除,读取或等待事件标志。 22、freertos使任务切换的方式有哪些? freertos使任务切换的方式有以下几种: 时间片轮转法,按照任务的优先级和时间片的长度,依次轮流执行每个就绪任务,当一个任务的时间片用完或者主动放弃时,切换到下一个任务。 优先级抢占法,按照任务的优先级,总是执行优先级最高的就绪任务,当有更高优先级的任务就绪时,立即抢占当前任务,切换到更高优先级的任务。 混合法,结合时间片轮转法和优先级抢占法,对于同一优先级的任务,使用时间片轮转法,对于不同优先级的任务,使用优先级抢占法,实现任务的公平性和效率。 23、项目中用到网络了吗? 这个问题的答案取决于你的项目的具体情况,如果你的项目需要与其他设备或服务器进行通信,或者需要访问互联网上的资源,那么你的项目就用到了网络。如果你的项目只是在本地运行,不需要与外界交互,那么你的项目就没有用到网络。 24、了解Socket吗? Socket是一种通信机制,它可以实现不同进程或不同设备之间的数据交换。Socket通常基于TCP/IP协议,提供了可靠的,双向的,面向连接的通信服务。Socket的基本操作包括创建,绑定,监听,连接,发送,接收,关闭等。Socket的编程接口通常是一组函数或类,不同的编程语言或平台可能有不同的实现,如C语言的socket.h,Java语言的java.net.Socket等。 25、c++中set是什么? set是C++标准模板库(STL)中的一个容器,它可以存储一组不重复的元素,并且按照一定的顺序排列。set的元素可以是任意类型,但是必须支持比较操作,如<,==等。set的底层实现通常是红黑树,所以它的插入,删除,查找等操作的时间复杂度都是O(logn) ,其中n是元素的个数。set的优点是可以快速地检查一个元素是否存在,以及保持元素的有序性。set的缺点是不能存储重复的元素,以及不能直接访问元素,只能通过迭代器遍历。 26、有没有用到C++模板? C++模板是一种泛型编程的技术,它可以让程序员定义一种通用的模式,然后根据不同的类型或参数,生成不同的代码,从而实现代码的复用和抽象。C++模板有两种,一种是函数模板,用于定义通用的函数,另一种是类模板,用于定义通用的类。例如,以下是一个函数模板,用于比较两个值的大小: template <typename T> T max(T x, T y) { return (x > y) ? x : y; } 我有用过C++模板,它们可以让我的代码更简洁,更灵活,更高效。我用过STL中的一些类模板,如vector,map,set等,也用过自己定义的一些函数模板和类模板,来实现一些通用的算法和数据结构。 27、有没有对代码裁剪的经验 代码裁剪是指对代码进行优化,删除不必要的或冗余的代码,减少代码的体积和复杂度,提高代码的可读性和可维护性。代码裁剪的目的是为了提高程序的性能,节省内存空间,降低编译时间,避免错误和漏洞等。 我有对代码裁剪的经验,我用过一些工具和方法来进行代码裁剪,如: 使用编译器的优化选项,如-Os,-O3等,让编译器自动进行一些代码裁剪,如常量折叠,死代码删除,循环展开等。 使用代码分析工具,如lint,coverity等,检查代码的质量,发现代码的缺陷,如未使用的变量,函数,参数等,以及代码的风格,规范,注释等,然后根据工具的建议,修改或删除代码。 使用代码重构工具,如refactor,eclipse等,对代码进行重构,改善代码的结构,设计,逻辑等,消除代码的冗余,重复,复杂等,提高代码的可读性,可维护性,可扩展性等。 使用代码压缩工具,如upx,gzip等,对代码进行压缩,减少代码的体积,提高代码的传输速度,节省存储空间等。 28、freertos系统是买模块时人家配置好的?还是移植的? freertos系统是一个开源的,可移植的,实时的操作系统,它可以运行在多种嵌入式平台上,如ARM,MIPS,AVR等。freertos系统不是买模块时人家配置好的,而是需要根据不同的硬件和需求进行移植和定制的。移植freertos系统的步骤一般如下: 下载freertos的源码,选择合适的移植层,如portable/GCC/ARM_CM3等,根据目标平台的特性,修改一些配置参数,如configCPU_CLOCK_HZ,configTICK_RATE_HZ等。 编写启动代码,如设置时钟,中断,堆栈等,调用vPortStartFirstTask ()函数,启动第一个任务。 编写应用代码,如创建任务,队列,信号量,定时器等,调用vTaskStartScheduler ()函数,启动调度器。 编译,链接,下载,调试代码,检查系统的运行情况,如任务切换,中断响应,内存管理等。 29、任务里有两把锁的时候该怎么处理 任务里有两把锁的时候,可能会出现死锁的问题,即两个或多个任务因为互相等待对方占有的锁而无法继续执行。处理任务里有两把锁的时候,有以下几种方法: 避免使用两把锁,如果可能的话,尽量使用一把锁来保护临界区,或者使用其他同步机制,如信号量,事件标志等,来实现任务之间的协作。 按照一定的顺序获取和释放锁,如果必须使用两把锁,那么要求所有的任务都按照相同的顺序获取和释放锁,避免形成循环等待的条件。 使用超时机制,如果一个任务在获取锁时,发现锁已经被占用,那么不要无限期地等待,而是设置一个超时时间,如果超时时间到了,还没有获取到锁,那么就放弃获取,释放已经占有的锁,然后重新尝试或者执行其他操作。 使用优先级继承机制,如果一个任务在获取锁时,发现锁已经被占用,那么就把自己的优先级赋给占有锁的任务,让占有锁的任务尽快执行完毕,释放锁,然后恢复原来的优先级,这样可以避免优先级反转的问题。 30、熟悉Shell脚本吗?$和#啥意思? Shell脚本是一种用于控制Unix或Linux系统的命令行解释器,它可以实现一些自动化的任务,如文件操作,文本处理,程序运行等。Shell脚本的语法和结构类似于C语言,但是更加简洁和灵活。Shell脚本的文件名通常以.sh为后缀,例如test.sh。 $和#是Shell脚本中的两个特殊符号,它们有以下含义: $表示变量的引用,可以用来获取或设置变量的值,例如x=10,echo $x,表示将10赋值给变量x,然后打印x的值。 表示注释的开始,可以用来对代码进行说明,不会被执行,例如#echo hello,#这是一个注释,表示打印hello,后面的内容是一个注释。 31、知道#error吗? 、#error是一个预处理指令,它可以用来在编译时产生一个错误信息,中断编译过程。#error通常用来检查一些条件,如宏定义,平台,版本等,如果不满足条件,就提示错误,防止编译出错的代码。例如: #ifdef __linux__ #error This code is not compatible with Linux #endif 这段代码表示如果定义了__linux__宏,就产生一个错误信息,表示这段代码不兼容Linux系统。 32、freertos消息队列的的具体实现? freertos消息队列是一种用于实现任务之间或任务与中断之间的异步通信的机制,它可以存储一组有序的消息,每个消息可以是任意类型的数据。freertos消息队列的具体实现如下: 消息队列是一个结构体,它包含了一些成员,如队列的头指针,尾指针,长度,容量,锁,信号量等,用来管理队列的状态和操作。 消息队列的存储空间是一个数组,它可以是静态分配的或动态分配的,它的大小要能够容纳队列的最大容量乘以每个消息的大小。 消息队列的操作有以下几种,如创建,删除,发送,接收等,它们都是通过调用一些API函数来实现的,如xQueueCreate,vQueueDelete,xQueueSend,xQueueReceive等。 消息队列的操作都是原子的,即在操作过程中,不会被其他任务或中断打断,这是通过使用临界区或中断屏蔽来实现的,以保证队列的一致性和完整性。 消息队列的操作都是阻塞的,即如果队列满了,就不能发送消息,如果队列空了,就不能接收消息,这是通过使用信号量来实现的,以实现任务的同步和等待。 33、堆栈区别? 堆(heap)和栈(stack)都是程序运行时使用的内存空间,但是它们有以下区别: 堆是动态分配的,程序员可以自由地申请和释放堆上的内存空间,堆的大小受到物理内存的限制,堆上的内存空间的地址是不连续的。 栈是静态分配的,编译器会自动地分配和回收栈上的内存空间,栈的大小受到操作系统的限制,栈上的内存空间的地址是连续的。 堆是全局共享的,堆上的内存空间可以被任何函数或模块访问,堆上的内存空间的生命周期是由程序员控制的,如果不及时释放,可能会导致内存泄漏。 栈是局部私有的,栈上的内存空间只能被当前函数或模块访问,栈上的内存空间的生命周期是由编译器控制的,当函数调用结束时,栈上的内存空间就会被自动释放。 34、程序存放状态和区别 程序存放状态是指程序在运行过程中的不同阶段,它有以下几种: 新建状态,指程序刚刚被创建,还没有被加载到内存中,等待调度器的调度。 就绪状态,指程序已经被加载到内存中,已经分配了必要的资源,等待处理器的分配。 运行状态,指程序已经被分配了处理器,正在执行程序的指令。 阻塞状态,指程序在执行过程中,因为等待某些事件的发生,如输入输出,信号量,中断等,而暂时停止执行,释放处理器,等待事件的完成。 终止状态,指程序已经执行完毕,或者因为某些原因,如错误,异常,中断等,而被终止,释放内存和资源,从系统中消失。
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
774
4
2023-12-26
AI: 机器学习必须懂的几个术语:Label、Feature、Model...
摘要本文介绍了机器学习中关键术语,包括标签、特征、样本、模型、回归和分类,并简要说明了它们在机器学习中的应用和重要性。关键词:AI, 机器学习, 术语, Label, Feature1.标签 Label 2.特征 Feature 3.样本 Example3.1有标签样本(labeled): 3.2无标签样本(unlabeled): 4.模型 Model 5.回归 Regression 6.分类 Classification 7.机器学习算法地图 1.标签 Label 标签:所预测的东东实际是什么(可理解为结论),如线性回归中的 y 变量,如分类问题中图片中是猫是狗(或图片中狗的种类)、房子未来的价格、音频中的单词等等任何事物,都属于Label。 (如一组图片,已经表明了哪些是狗,哪些是猫,这里Label就是分类问题中每一个类) 图片 2.特征 Feature 特征是事物固有属性,可理解为做出某个判断的依据,如人的特征有长相、衣服、行为动作等等,一个事物可以有N多特征,这些组成了事物的特性,作为机器学习中识别、学习的基本依据。 图片 特征是机器学习模型的输入变量。如线性回归中的 x 变量。 图片 例如在垃圾邮件分类问题中,特征可能包括: 电子邮件中是否包含 “ 广告、贷款、交易” 等短语 电子邮件文本中的字词 发件人的地址 发送电子邮件的时段 其中机器学习重要步骤:特征提取就是通过多种方式,对数据的特征数据进行提取。一般,特征数据越多,训练的机器学习模型就会越精确,但处理难度也越大。 3.样本 Example 样本是指一组或几组数据,样本一般作为训练数据来训练模型 样本分为以下两类: 有标签样本 无标签样本 3.1有标签样本(labeled): 同时包含特征和标签 图片 在监督学习中利用数据做训练时,有标签数据/样本(Labeled data)或叫有/无标记数据,就是指有没有将数据归为要预测的类别。 例如以下房价数据集: 图片 其中包含特征:卧室数量等,最右边一列是标签:房价中间值 (注,因为该问题要预测未来房价走势,所以Label就是某条房屋数据中的房价) 3.2无标签样本(unlabeled): 包含特征,但不包含标签 如以下数据集: 去掉了Label,但是一样有用(如用在测试训练后的模型,即训练好模型后,输入该数据,那到预测后的房价与原标签进行比较,得到模型误差) 图片 4.模型 Model 模型定义了特征与标签之间的关系,就是我们机器学习的一组数据关系表示,也是我们学习机器学习的核心 例如,垃圾邮件检测模型可能会将某些特征与“垃圾邮件”紧密联系起来。 模型生命周期的两个重要阶段: 训练 Training是指创建或学习模型。也就是说,向模型展示有标签样本,让模型逐渐学习特征与标签之间的关系。 训练模型表示通过有标签样本来学习(确定)所有权重和偏差的理想值 推断 Inference是指将训练后的模型应用于无标签样本。也就是说,使用经过训练的模型做出有用的预测 (y’)。 例如,模型训练好后,就可以使用模型进行Inference ,可以针对新的无标签样本预测房价medianHouseValue。 图片 5.回归 Regression 回归就是我们数学学习的线性方程,是一种经典函数逼近算法。 在机器学习中,就是根据数据集,建立一个线性方程组,能够无线逼近数据集中的数据点,是一种基于已有数据关系实现预测的算法。 回归模型可预测连续值(线性) 例如,回归模型做出的预测可回答如下问题: 某小区房价的趋势? 用户点击此广告的概率是多少? 图片 当机器学习模型最终目标(模型输出)是求一个具体数值时,例如房价的模型输出为25000,则大多数可以通过回归问题来解决。 线性回归的好处在与模型简单,计算速度快,方便应用在分布式系统对大数据进行处理。 线性回归还有个姐妹:逻辑回归(Logistic Regression),主要应用在分类领域 6.分类 Classification 顾名思义,分类模型可用来预测离散值 例如,分类模型做出的预测可回答如下问题: 是/否问题,某个指定电子邮件是垃圾邮件还是非垃圾邮件? 图片是动物还是人? 垃圾分类 图片 当机器学习模型最终目标(模型输出)是布尔或一定范围的数时,例如判断一张图片是不是人,模型输出0/1:0不是,1是;又例如垃圾分类,模型输出1-10之间的整数,1代表生活垃圾,2代表厨余垃圾。。等等,这类需求则大多数可以通过分类问题来解决。 7.机器学习算法地图 机器学习算法多种多样,许多情况下,建模和算法设计是Designer所选择的,具体采用哪种算法也没有一定要求,根据实际具体问题具体分析。 图片
机器学习
# 机器学习
刘航宇
3年前
0
1,300
2
上一页
1
2
3
...
14
下一页