🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,264 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,790 阅读
3
【高数】形心计算公式讲解大全
9,138 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,204 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,923 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
ed(共165篇)
找到
165
篇与
ed
相关的结果
- 第 3 页
面向对象在编程中的概念
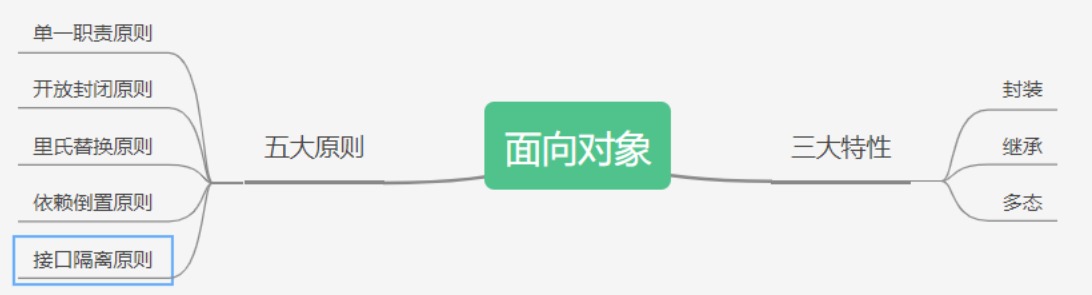
摘要本文介绍了面向对象编程(OOP)的概念,包括其与面向过程的区别、三大特性(封装、继承、多态)和五大基本原则。同时,阐述了OOP的用途和应用领域,如人工智能、企业级应用等。关键词:面向对象编程, OOP, 面向过程, 封装, 继承前言 那么究竟什么是面向对象呢?面向过程 面向对象 面向对象的三大特性封装 继承 多态 面向对象的五大基本原则单一职责原则(Single-Responsibility Principle) 开放封闭原则(Open-Closed principle) 里氏替换原则(Liskov-Substitution Principle) 依赖倒置原则(Dependecy-Inversion Principle) 接口隔离原则(Interface-Segregation Principle) 面向对象编程的用途 面向对象编程的应用领域 前言 在刚接触java、C++、Python语言的时候,就知道这是一门面向对象的语言。学不好java的原因找到了,面向对象的语言,没有对象怎么学 ::(狗头) 图片 那么究竟什么是面向对象呢? 面向对象,Object Oriented Programming,简称为OOP。说到面向对象,不得不提一嘴面向过程。 面向过程 面向过程是一种自顶而下的编程模式。 把问题分解成一个一个步骤,每个步骤用函数实现,依次调用即可。 举个生活中的例子,假如你想吃红烧肉,你需要买肉,买调料,洗肉,切肉,烧肉,装盘。 需要我们具体每一步去实现,每个步骤相互协调,最终盛出来的才是正宗好吃的红烧肉。 面向对象 面向对象就是将问题分解成一个一个步骤,对每个步骤进行相应的抽象,形成对象,通过不同对象之间的调用,组合解决问题。 还是你想吃红烧肉这个例子,不过这次不同的是你发现了一家餐馆里有红烧肉这道菜,你要做的只是去点菜,就可以吃到红烧肉。 针不戳,针不戳,面向对象针不戳,你不用再去关心红烧肉繁琐的制作流程,就能吃到美味的红烧肉。 我们接着往下看 图片 面向对象的三大特性 封装 封装就是把客观的事物封装成抽象的类,并且类可以把自己的数据和方法只让可信的类或者对象操作,对不可信的类进行信息的隐藏。简单的说就是:封装使对象的设计者与对象的使用者分开,使用者只要知道对象可以做什么就可以了,不需要知道具体是怎么实现的。封装可以有助于提高类和系统的安全性 这里有点像FPGA的IP了,电子人懂! 继承 当多个类中存在相同属性和行为时,将这些内容就可以抽取到一个单独的类中,使得多个类无需再定义这些属性和行为,只需继承那个类即可。通过继承创建的新类称为“子类”或“派生类”,被继承的类称为“基类”、“父类”或“超类” 多态 多态同一个行为具有多个不同表现形式或形态的能力。是指一个类实例(对象)的相同方法在不同情形有不同表现形式。多态机制使具有不同内部结构的对象可以共享相同的外部接口。这意味着,虽然针对不同对象的具体操作不同,但通过一个公共的类,它们(那些操作)可以通过相同的方式予以调用。 菜鸟教程中的例子就很形象 现实中,比如我们按下 F1 键这个动作: 如果当前在 Flash 界面下弹出的就是 AS 3 的帮助文档; 如果当前在 Word 下弹出的就是 Word 帮助; 在 Windows 下弹出的就是 Windows 帮助和支持。 同一个事件发生在不同的对象上会产生不同的结果。 面向对象的五大基本原则 单一职责原则(Single-Responsibility Principle) 简而言之,就是一个类最好只有一个能引起变化的原因,只做一件事,单一职责原则可以看做是低耦合高内聚思想的延伸,提高高内聚来减少引起变化的原因。 开放封闭原则(Open-Closed principle) 简而言之,就是软件实体应该是可扩展的,但是不可修改。因为修改程序有可能会对原来的程序造成错误。即对扩展开放,对修改封闭 里氏替换原则(Liskov-Substitution Principle) 简而言之,就是子类一定可以替换父类,子类包含其基类(父类)的功能 依赖倒置原则(Dependecy-Inversion Principle) 高层次的模块不应该依赖于低层次的模块,他们都应该依赖于抽象。抽象不应该依赖于具体实现,具体实现应该依赖于抽象。依赖于抽象即对接口编程,不要对实现编程 接口隔离原则(Interface-Segregation Principle) 图片 简而言之,就是使用多个小的专门的接口,而不要使用一个大的总接口。例如将一个房子再分割成卧室,厨房,厕所等等,而不是将所有功能放在一起 面向对象编程的用途 使用封装(信息隐藏)可以对外部隐藏数据 使用继承可以重用代码 使用多态可以重载操作符/方法/函数,即相同的函数名或操作符名称可用于多种任务 数据抽象可以用抽象实现 项目易于迁移(可以从小项目转换成大项目) 同一项目分工 软件复杂性可控 面向对象编程的应用领域 人工智能与专家系统 企业级应用 神经网络与并行编程 办公自动化系统
编程&脚本笔记
# 软件算法
# C/C++
刘航宇
3年前
0
521
4
2023-12-11
华为C++算法-识别有效的IP地址和掩码并进行分类统计
摘要本文介绍了华为C++算法,用于识别和分类IP地址及掩码。算法可识别A/B/C/D/E类地址,统计不合法地址和掩码、私有IP数量。通过字符分割、合法性判断和类别归类实现。关键词:华为,C++,IP地址分类,子网掩码,算法问题 注意: 输入描述: 输出描述: 示例 需要注意的细节 思路 具体实现 代码 问题 请解析IP地址和对应的掩码,进行分类识别。要求按照A/B/C/D/E类地址归类,不合法的地址和掩码单独归类。 所有的IP地址划分为 A,B,C,D,E五类 A类地址从1.0.0.0到126.255.255.255; B类地址从128.0.0.0到191.255.255.255; C类地址从192.0.0.0到223.255.255.255; D类地址从224.0.0.0到239.255.255.255; E类地址从240.0.0.0到255.255.255.255 私网IP范围是: 从10.0.0.0到10.255.255.255 从172.16.0.0到172.31.255.255 从192.168.0.0到192.168.255.255 子网掩码为二进制下前面是连续的1,然后全是0。(例如:255.255.255.32就是一个非法的掩码) (注意二进制下全是1或者全是0均为非法子网掩码) 注意: 类似于【0...】和【127...】的IP地址不属于上述输入的任意一类,也不属于不合法ip地址,计数时请忽略 私有IP地址和A,B,C,D,E类地址是不冲突的 输入描述: 多行字符串。每行一个IP地址和掩码,用~隔开。 输出描述: 统计A、B、C、D、E、错误IP地址或错误掩码、私有IP的个数,之间以空格隔开。 示例 输入: 10.70.44.68~255.254.255.0 1.0.0.1~255.0.0.0 192.168.0.2~255.255.255.0 19..0.~255.255.255.0 输出: 1 0 1 0 0 2 1 说明: 10.70.44.68~255.254.255.0的子网掩码非法,19..0.~255.255.255.0的IP地址非法,所以错误IP地址或错误掩码的计数为2; 1.0.0.1~255.0.0.0是无误的A类地址; 192.168.0.2~255.255.255.0是无误的C类地址且是私有IP; 所以最终的结果为1 0 1 0 0 2 1 示例2 输入: 0.201.56.50~255.255.111.255 127.201.56.50~255.255.111.255 输出: 0 0 0 0 0 0 0 说明: 类似于【0...】和【127...】的IP地址不属于上述输入的任意一类,也不属于不合法ip地址,计数时请忽略 需要注意的细节 类似于【0...】和【127...】的IP地址不属于上述输入的任意一类,也不属于不合法ip地址,计数时可以忽略 私有IP地址和A,B,C,D,E类地址是不冲突的,也就是说需要同时+1 如果子网掩码是非法的,则不再需要查看IP地址 全零【0.0.0.0】或者全一【255.255.255.255】的子网掩码也是非法的 思路 按行读取输入,根据字符‘~’ 将IP地址与子网掩码分开 查看子网掩码是否合法。 合法,则继续检查IP地址 非法,则相应统计项+1,继续下一行的读入 查看IP地址是否合法 合法,查看IP地址属于哪一类,是否是私有ip地址;相应统计项+1 非法,相应统计项+1 具体实现 判断IP地址是否合法,如果满足下列条件之一即为非法地址 数字段数不为4 存在空段,即【192..1.0】这种 某个段的数字大于255 判断子网掩码是否合法,如果满足下列条件之一即为非法掩码 不是一个合格的IP地址 在二进制下,不满足前面连续是1,然后全是0 在二进制下,全为0或全为1 如何判断一个掩码地址是不是满足前面连续是1,然后全是0? 将掩码地址转换为32位无符号整型,假设这个数为b。如果此时b为0,则为非法掩码 将b按位取反后+1。如果此时b为1,则b原来是二进制全1,非法掩码 如果b和b-1做按位与运算后为0,则说明是合法掩码,否则为非法掩码 代码 注意getline函数可以指定分割字符串的字符 // 引入输入输出流、字符串、字符串流和向量等头文件 #include<iostream> #include<string> #include<sstream> #include<vector> // 使用标准命名空间 using namespace std; // 定义一个函数,判断一个字符串是否是合法的IP地址 bool judge_ip(string ip){ // 定义一个整数变量,记录IP地址的段数 int j = 0; // 定义一个字符串流对象,用于分割IP地址 istringstream iss(ip); // 定义一个字符串变量,用于存储IP地址的每一段 string seg; // 使用循环,以'.'为分隔符,获取IP地址的每一段 while(getline(iss,seg,'.')) // 如果段数加一大于4,或者该段为空,或者该段的数值大于255,说明不是合法的IP地址,返回false if(++j > 4 || seg.empty() || stoi(seg) > 255) return false; // 如果循环结束后,段数等于4,说明是合法的IP地址,返回true return j == 4; } // 定义一个函数,判断一个字符串是否是私有的IP地址 bool is_private(string ip){ // 定义一个字符串流对象,用于分割IP地址 istringstream iss(ip); // 定义一个字符串变量,用于存储IP地址的每一段 string seg; // 定义一个整数向量,用于存储IP地址的每一段的数值 vector<int> v; // 使用循环,以'.'为分隔符,获取IP地址的每一段,并将其转换为整数,存入向量中 while(getline(iss,seg,'.')) v.push_back(stoi(seg)); // 如果IP地址的第一段等于10,说明是私有的IP地址,返回true if(v[0] == 10) return true; // 如果IP地址的第一段等于172,并且第二段在16到31之间,说明是私有的IP地址,返回true if(v[0] == 172 && (v[1] >= 16 && v[1] <= 31)) return true; // 如果IP地址的第一段等于192,并且第二段等于168,说明是私有的IP地址,返回true if(v[0] == 192 && v[1] == 168) return true; // 如果以上条件都不满足,说明不是私有的IP地址,返回false return false; } // 定义一个函数,判断一个字符串是否是合法的子网掩码 bool is_mask(string ip){ // 定义一个字符串流对象,用于分割IP地址 istringstream iss(ip); // 定义一个字符串变量,用于存储IP地址的每一段 string seg; // 定义一个无符号整数变量,用于存储IP地址的二进制表示 unsigned b = 0; // 使用循环,以'.'为分隔符,获取IP地址的每一段,并将其转换为整数,左移8位后与b进行按位或运算,得到IP地址的二进制表示 while(getline(iss,seg,'.')) b = (b << 8) + stoi(seg); // 如果b等于0,说明不是合法的子网掩码,返回false if(!b) return false; // 将b按位取反后加一,得到b的补码 b = ~b + 1; // 如果b等于1,说明不是合法的子网掩码,返回false if(b == 1) return false; // 如果b与b减一进行按位与运算,结果等于0,说明b只有一个1,说明是合法的子网掩码,返回true if((b & (b-1)) == 0) return true; // 如果以上条件都不满足,说明不是合法的子网掩码,返回false return false; } // 定义主函数 int main(){ // 定义一个字符串变量,用于存储输入的IP地址和子网掩码 string input; // 定义七个整数变量,用于统计A、B、C、D、E类地址、错误地址和私有地址的个数 int a = 0,b = 0,c = 0,d = 0,e = 0,err = 0,p = 0; // 使用循环,读取输入的IP地址和子网掩码,直到输入结束 while(cin >> input){ // 定义一个字符串流对象,用于分割IP地址和子网掩码 istringstream is(input); // 定义一个字符串变量,用于存储IP地址或子网掩码 string add; // 定义一个字符串向量,用于存储IP地址和子网掩码 vector<string> v; // 使用循环,以'~'为分隔符,获取IP地址和子网掩码,并存入向量中 while(getline(is,add,'~')) v.push_back(add); // 如果IP地址或子网掩码不合法,错误地址的个数加一 if(!judge_ip(v[1]) || !is_mask(v[1])) err++; else{ // 如果IP地址不合法,错误地址的个数加一 if(!judge_ip(v[0])) err++; else{ // 获取IP地址的第一段的数值 int first = stoi(v[0].substr(0,v[0].find_first_of('.'))); // 如果IP地址是私有的,私有地址的个数加一 if(is_private(v[0])) p++; // 根据IP地址的第一段的数值,判断IP地址的类别,并相应的类别的个数加一 if(first > 0 && first <127) a++; else if(first > 127 && first <192) b++; else if(first > 191 && first <224) c++; else if(first > 223 && first <240) d++; else if(first > 239 && first <256) e++; } } } // 输出A、B、C、D、E类地址、错误地址和私有地址的个数 cout << a << " " << b << " " << c << " " << d << " " << e << " " << err << " " << p << endl; // 返回0,表示程序正常结束 return 0; }
嵌入式&系统
编程&脚本笔记
软硬件算法
# 嵌入式
# 笔试面试
# C/C++
刘航宇
3年前
0
640
1
2023-12-11
大疆题解:跨时钟域脉冲信号处理—脉冲同步器(快到慢)
摘要本文介绍了如何将快时钟域(300M)的脉冲信号同步到慢时钟域(100M)中。通过将脉冲信号转换为沿信号,并在慢时钟域中进行两拍处理,最终实现脉冲信号的同步。文章还提供了相应的Verilog代码实现。关键词:大疆, 脉冲同步器, 跨时钟域, 信号处理, Verilog问题描述 题解1.1 电路波形图 1.2 代码 注意 问题描述 sig_a 是 clka(300M)时钟域的一个单时钟脉冲信号(高电平持续一个时钟clka周期),请设计脉冲同步电路,将sig_a信号同步到时钟域 clkb(100M)中,产生sig_b单时钟脉冲信号(高电平持续一个时钟clkb周期)输出。请用 Verilog 代码描述。 clka时钟域脉冲之间的间隔很大,无需考虑脉冲间隔太小的问题。 电路的接口如下图所示: 图片 题解 1.1 电路波形图 图片 如上图所述,aclk快时钟域发送的信号signal_a,慢时钟域的时钟bclk根本就采集不到,此时不能使用打两拍的方式,要想办法转换思路, 如果能够让同步于快时钟域aclk下的脉冲信号signal_a变长到可以让慢时钟域bclk检测到,那么这个问题就可以完美解决了。 所以先将快时钟域clka下的脉冲信号signal_a,在快时钟域clka的作用下,变为沿信号,产生一个名为adata的中间变量来作为脉冲信号signal_a的沿信号。如上图所示,每当快时钟域aclk检测到signal_a脉冲信号为高时,让adata信号取反,使得signal_a的第一个脉冲变为adata信号的上升沿,signal_a的第二个脉冲变为adata信号的下降沿,后面如果Signal_a信号还有脉冲依然是变为adata信号的上升沿和下降沿。 巧妙的利用将“脉冲信号”转化为“沿信号”的思想就可以使慢时钟域的时钟bclk检测到同步于快时钟域aclk且将脉冲信号signal_a转化为沿信号adata, 相当于是把同步于快时钟域aclk的脉冲信号signal_a进行了展宽处理,这样我们就把快时钟域aclk的脉冲信号signal_a通过adata信号“沿”的形式在慢时钟域bclk中得到了保留。 接着,我们再对adata信号做打两拍的处理就可以将adata信号同步到慢时钟域clkb中了。bdata0信号是adata信号在慢时钟域bclk下打的第一拍,bdata1信号是adata信号在慢速时钟域bclk下打第二拍,bdata1就是同步于慢速时钟域bclk的稳定信号。 最后,采用 边沿检测 的方法,将变为bdata1信号的“沿”再转化为脉冲信号,这里我们使用的方法是采用异或门。需要注意的是不能直接使用bdata0和bdata1来产生沿标志信号,因为bdata0信号的不稳定性可能会导致产生的沿信号也不稳定,所以需要将bdata1信号再打一拍,产生signal_b信号。 1.2 代码 //快时钟数据同步 module pulse_detect( input clka , input clkb , input rst_n , input sig_a , output sig_b ); wire sig_a; reg adata; reg bdata0; reg bdata1; reg bdata2; always @(posedge clka or negedge rst_n) begin if(~rst_n) begin adata <= 1'd0; end else begin adata <= adata ^ sig_a; end end always @(posedge clkb or negedge rst_n) begin if(~rst_n) begin bdata0 <= 1'd0; bdata1 <= 1'd0; bdata2 <= 1'd0; end else begin bdata0 <= adata; bdata1 <= bdata0; bdata2 <= bdata1; end end assign sig_b = bdata1 ^ bdata2; endmodule注意 signal_a是两个脉冲,但是使用“脉冲同步”同步到bclk时钟域确只有一个脉冲了,在使用“脉冲同步”时应注意这一点。所以,脉冲同步一般适用于单比特信号从快时钟域传递慢时钟域的场景。
FPGA&ASIC
# ASIC/FPGA
# Verilog
刘航宇
3年前
0
1,245
4
2023-11-20
超声模块HC_SR04基本原理与FPGA、STM32应用
摘要本文介绍了HC-SR04超声波距离传感器的基本原理,包括其硬件构成、接口定义和测量操作。同时,详细阐述了如何利用FPGA和STM32实现超声波测距,包括FPGA模块代码和STM32的CubeMX配置及代码编写。关键词:HC-SR04, 超声波传感器, 距离测量, FPGA应用, STM32应用HC-SR04硬件概述 接口定义: 模式选择: 测量操作: FPGA实现超声测距模块代码 STM32(Cubemax)实现超声波测距CubeMX配置STM32 编写代码 HC-SR04 硬件概述 HC-SR04超声波距离传感器的核心是两个超声波传感器。一个用作发射器,将电信号转换为40 KHz超声波脉冲。接收器监听发射的脉冲。如果接收到它们,它将产生一个输出脉冲,其宽度可用于确定脉冲传播的距离。就是如此简单! 该传感器体积小,易于在任何机器人项目中使用,并提供2厘米至600厘米(约1英寸至13英尺)之间出色的非接触范围检测,精度为3mm。 图片 接口定义: 图片 模式选择: 图片 测量操作: 一:GPIO模式 图片 外部MCU给模块Trig脚一个大于10uS的高电平脉冲;模块会给出一个与距离等比的高电平脉冲信号,可根据脉宽时间“T” 算出: 距离=T*C/2 (C为声速) 声速温度公式:c=(331.45+0.61t/℃)m•s-1 (其中330.45是在0℃) 0℃声速: 330.45M/S 20℃声速: 342.62M/S 40℃声速: 354.85M/S0℃-40℃声速误差7%左右。实际应用,如果需要精确距离值,必需要考虑温度影响,做温度补偿。 二:UART模式 UART 模式波特率设置: 9600 N 1 图片 连接串口。外部MCU或PC发命令0XA0,模块完成测距后发3个返回距离 数据,BYTE_H,BYTE_M与BYTE_L。 距离计算方式如下(单位mm): 距离=((BYTE_H<<16)+(BYTE_M<<8)+ BYTE_L)/1000 三:IIC模式 IIC地址: 0X57 IIC传输格式: 写数据: 图片 读数据: 图片 命令格式: 图片 向模块写入0X01,模块开始测距;等待200mS(模块最大测距时间) 以上。直接读出3个距离数据。BYTE_H,BYTE_M与BYTE_L。 距离计算方式如下(单位mm): 距离=((BYTE_H<<16)+(BYTE_M<<8)+ BYTE_L)/1000 FPGA实现超声测距 本次测距教程一律按基本原理实现,至于UART、ICC测距原理可以网上查询 FPGA 产生周期性的 TRIG 脉冲信号,使得超声波模块周期性发出测距脉冲,当这些脉冲发出后遇到障碍物返回,超声波模块将返回的脉冲处理整形后返回给 FPGA,即 ECHO 信号。我们通过对 ECHO 信号的高脉冲保持时间就可以推算出超声波脉冲和障碍物之间的距离。 本实例的功能如图三所示,FPGA 产生 10us 脉冲 TRIG 给超声波测距模块,然后以 10us 为单位计算超声波测距模块返回的回响信号 ECHO 的高电平保持时间。ECHO 的高电平保持时间通过一定的换算后可以得到障碍物和超声波测距模块之间的距离(由距离公式计算&进制换算模块实现),我们将最终获得的以 mm 为单位的距离信息显示在 4 位数码管上。 图片 模块代码 1、vlg_en模块 /* * @Author: Hangyu Liu * @Date: 2023-11-20 15:24:01 * @Email: hyliu@ee.ac.cn * @Descripttion: 板子时钟转化1us * @Last Modified time: 2023-11-20 15:24:01 */ //1us/50ns=20 module vlg_1us#(parameter P_CLK_PERIORD = 50) //i_clk的时钟周期50ns,20MHZ ( input i_clk, input i_rst_n, output reg o_clk //时钟周期1us ); parameter NUM_DIV = 20;// (1MHZ = 1us,20MHZ/20 = 1MHZ) reg [3:0] cnt; always @(posedge i_clk or negedge i_rst_n) begin if(!i_rst_n) begin cnt <= 4'd0; o_clk <= 1'b0; end else if(cnt == NUM_DIV/2 - 1) begin cnt <= 4'b0; o_clk <= ~o_clk; end else cnt <= cnt + 1'b1; end endmodule2、vlg_trig模块 /* * @Author: Hangyu Liu * @Date: 2023-11-20 16:50:44 * @Email: hyliu@ee.ac.cn * @Descripttion: 产生10us的触发超声信号 * @Last Modified time: 2023-11-20 16:50:44 */ module vlg_trig ( input i_rst_n, input clk_1us, //1us output reg o_trig ); reg[17:0] r_tricnt; //200ms的周期计数 1us一个单位 always @(posedge clk_1us or negedge i_rst_n)begin if(!i_rst_n) r_tricnt <= 18'd0; else if((r_tricnt == 18'd199999)) r_tricnt <= 18'd0; else r_tricnt <= r_tricnt + 1'b1; end //产生保持10us的高脉冲o_tring信号 always @(posedge clk_1us or negedge i_rst_n) begin if(!i_rst_n) o_trig<=1'b0; else if((r_tricnt > 18'd0) && (r_tricnt <= 18'd10)) o_trig <= 1'b1; //不从0开始0~9,防止出现不到10us的波干扰 else o_trig <= 1'b0; end endmodule3、vlg_echo模块 module vlg_echo ( input i_clk, //1us input i_rst_n, input i_clk_1us, input i_echo, output reg[15:0] o_t_us ); reg[1:0] r_echo; wire pos_echo,neg_echo; reg r_cnt_en; reg[15:0] r_echo_cnt; //对i_echo信号同步处理,获取边沿检测信号,产生计数使能信号r_cnt_en always @(posedge i_clk or negedge i_rst_n) begin if(!i_rst_n) r_echo <= 2'd0; else r_echo <= {r_echo[0],i_echo}; //设置两个寄存器进行打拍寄存 end assign pos_echo = r_echo[0] & ~r_echo[1]; //现状态是1上状态是0,就是上升沿 assign neg_echo = ~r_echo[0] & r_echo[1]; always @(posedge i_clk or negedge i_rst_n) begin if(!i_rst_n) r_cnt_en <= 1'b0; else if(pos_echo) r_cnt_en <= 1'b1; else if(neg_echo) r_cnt_en <= 1'b0; else r_cnt_en <= r_cnt_en; end //对i_echo信号的高脉冲计时,以us为单位 always @(posedge i_clk_1us or negedge i_rst_n) begin if(!i_rst_n) r_echo_cnt <= 1'b0; else if(r_cnt_en) r_echo_cnt <= r_echo_cnt + 1'b1; else r_echo_cnt <= 1'b0; end //在下降沿对计数最大值进行保存 always @(negedge i_clk or negedge i_rst_n) begin if(!i_rst_n) o_t_us <= 16'd0; else if(neg_echo) o_t_us <= r_echo_cnt; else o_t_us <= o_t_us; end endmodule4、顶层模块例化 /* * @Author: Hangyu Liu * @Date: 2023-11-23 17:16:40 * @Email: hyliu@ee.ac.cn * @Descripttion:HR04驱动模块 * @Last Modified time: 2023-11-23 17:16:40 */ module vlg_design ( input i_clk, //200MHZ input i_rst_n, input i_echo, //这是超声模块给的输入 output o_trig, output wire[15:0] w_t_us ); wire clk_20MHZ; clk_div_20MHZ UU( .i_clk(i_clk), .i_rst_n(i_rst_n), .clk_div(clk_20MHZ) ); localparam P_CLK_PERIORD = 50; wire clk_1us; //使能时钟产生模块 vlg_1us #( .P_CLK_PERIORD(P_CLK_PERIORD) //i_clk的时钟周期50ns,20MHZ )U1( .i_clk(clk_20MHZ), .i_rst_n(i_rst_n), .o_clk(clk_1us) ); //产生超声波测距模块的触发信号o_trig vlg_trig U2( .i_rst_n(i_rst_n), .clk_1us(clk_1us), .o_trig(o_trig) ); //超声波测距模块的回响信号i_echo的高电平时间采集 vlg_echo U3( .i_clk(clk_20MHZ), .i_rst_n(i_rst_n), .i_clk_1us(clk_1us), .i_echo(i_echo), .o_t_us(w_t_us) ); endmoduleSTM32(Cubemax)实现超声波测距 CubeMX配置STM32 1 时钟配置 这里我用的是STM32F103C8T6的核心板,时钟配置如下图,我用了8MHz的HSE,HCLK调到了最大值72MHz 图片 2 设置输入捕获的定时器 设置定时器TIM2每1us向上计数一次,通道4为上升沿捕获并连接到超声波模块的ECHO引脚,记得开启定时器中断(涉及到捕获中断+定时器溢出中断)。 图片 3 触发引脚 PB10接到了HC-SR04的TIRG触发引脚,默认输出低电平 图片 4 串口配置 还要开启一个串口,以便通过串口查看测距结果 图片 编写代码 hc-sr04.h #ifndef HCSR04_H_ #define HCSR04_H_ #include "main.h" #include "delay.h" typedef struct { uint8_t edge_state; uint16_t tim_overflow_counter; uint32_t prescaler; uint32_t period; uint32_t t1; // 上升沿时间 uint32_t t2; // 下降沿时间 uint32_t high_level_us; // 高电平持续时间 float distance; TIM_TypeDef* instance; uint32_t ic_tim_ch; HAL_TIM_ActiveChannel active_channel; }Hcsr04InfoTypeDef; extern Hcsr04InfoTypeDef Hcsr04Info; /** * @description: 超声波模块的输入捕获定时器通道初始化 * @param {TIM_HandleTypeDef} *htim * @param {uint32_t} Channel * @return {*} */ void Hcsr04Init(TIM_HandleTypeDef *htim, uint32_t Channel); /** * @description: HC-SR04触发 * @param {*} * @return {*} */ void Hcsr04Start(); /** * @description: 定时器计数溢出中断处理函数 * @param {*} main.c中重定义void HAL_TIM_PeriodElapsedCallback(TIM_HandleTypeDef* htim) * @return {*} */ void Hcsr04TimOverflowIsr(TIM_HandleTypeDef *htim); /** * @description: 输入捕获计算高电平时间->距离 * @param {*} main.c中重定义void HAL_TIM_IC_CaptureCallback(TIM_HandleTypeDef *htim) * @return {*} */ void Hcsr04TimIcIsr(TIM_HandleTypeDef* htim); /** * @description: 读取距离 * @param {*} * @return {*} */ float Hcsr04Read(); #endif /* HCSR04_H_ */ hc-sr04.c #include "hc-sr04.h" Hcsr04InfoTypeDef Hcsr04Info; /** * @description: 超声波模块的输入捕获定时器通道初始化 * @param {TIM_HandleTypeDef} *htim * @param {uint32_t} Channel * @return {*} */ void Hcsr04Init(TIM_HandleTypeDef *htim, uint32_t Channel) { /*--------[ Configure The HCSR04 IC Timer Channel ] */ // MX_TIM2_Init(); // cubemx中配置 Hcsr04Info.prescaler = htim->Init.Prescaler; // 72-1 Hcsr04Info.period = htim->Init.Period; // 65535 Hcsr04Info.instance = htim->Instance; // TIM2 Hcsr04Info.ic_tim_ch = Channel; if(Hcsr04Info.ic_tim_ch == TIM_CHANNEL_1) { Hcsr04Info.active_channel = HAL_TIM_ACTIVE_CHANNEL_1; // TIM_CHANNEL_4 } else if(Hcsr04Info.ic_tim_ch == TIM_CHANNEL_2) { Hcsr04Info.active_channel = HAL_TIM_ACTIVE_CHANNEL_2; // TIM_CHANNEL_4 } else if(Hcsr04Info.ic_tim_ch == TIM_CHANNEL_3) { Hcsr04Info.active_channel = HAL_TIM_ACTIVE_CHANNEL_3; // TIM_CHANNEL_4 } else if(Hcsr04Info.ic_tim_ch == TIM_CHANNEL_4) { Hcsr04Info.active_channel = HAL_TIM_ACTIVE_CHANNEL_4; // TIM_CHANNEL_4 } else if(Hcsr04Info.ic_tim_ch == TIM_CHANNEL_4) { Hcsr04Info.active_channel = HAL_TIM_ACTIVE_CHANNEL_4; // TIM_CHANNEL_4 } /*--------[ Start The ICU Channel ]-------*/ HAL_TIM_Base_Start_IT(htim); HAL_TIM_IC_Start_IT(htim, Channel); } /** * @description: HC-SR04触发 * @param {*} * @return {*} */ void Hcsr04Start() { HAL_GPIO_WritePin(TRIG_GPIO_Port, TRIG_Pin, GPIO_PIN_SET); DelayUs(10); // 10us以上 HAL_GPIO_WritePin(TRIG_GPIO_Port, TRIG_Pin, GPIO_PIN_RESET); } /** * @description: 定时器计数溢出中断处理函数 * @param {*} main.c中重定义void HAL_TIM_PeriodElapsedCallback(TIM_HandleTypeDef* htim) * @return {*} */ void Hcsr04TimOverflowIsr(TIM_HandleTypeDef *htim) { if(htim->Instance == Hcsr04Info.instance) // TIM2 { Hcsr04Info.tim_overflow_counter++; } } /** * @description: 输入捕获计算高电平时间->距离 * @param {*} main.c中重定义void HAL_TIM_IC_CaptureCallback(TIM_HandleTypeDef *htim) * @return {*} */ void Hcsr04TimIcIsr(TIM_HandleTypeDef* htim) { if((htim->Instance == Hcsr04Info.instance) && (htim->Channel == Hcsr04Info.active_channel)) { if(Hcsr04Info.edge_state == 0) // 捕获上升沿 { // 得到上升沿开始时间T1,并更改输入捕获为下降沿 Hcsr04Info.t1 = HAL_TIM_ReadCapturedValue(htim, Hcsr04Info.ic_tim_ch); __HAL_TIM_SET_CAPTUREPOLARITY(htim, Hcsr04Info.ic_tim_ch, TIM_INPUTCHANNELPOLARITY_FALLING); Hcsr04Info.tim_overflow_counter = 0; // 定时器溢出计数器清零 Hcsr04Info.edge_state = 1; // 上升沿、下降沿捕获标志位 } else if(Hcsr04Info.edge_state == 1) // 捕获下降沿 { // 捕获下降沿时间T2,并计算高电平时间 Hcsr04Info.t2 = HAL_TIM_ReadCapturedValue(htim, Hcsr04Info.ic_tim_ch); Hcsr04Info.t2 += Hcsr04Info.tim_overflow_counter * Hcsr04Info.period; // 需要考虑定时器溢出中断 Hcsr04Info.high_level_us = Hcsr04Info.t2 - Hcsr04Info.t1; // 高电平持续时间 = 下降沿时间点 - 上升沿时间点 // 计算距离 Hcsr04Info.distance = (Hcsr04Info.high_level_us / 1000000.0) * 340.0 / 2.0 * 100.0; // 重新开启上升沿捕获 Hcsr04Info.edge_state = 0; // 一次采集完毕,清零 __HAL_TIM_SET_CAPTUREPOLARITY(htim, Hcsr04Info.ic_tim_ch, TIM_INPUTCHANNELPOLARITY_RISING); } } } /** * @description: 读取距离 * @param {*} * @return {*} */ float Hcsr04Read() { // 测距结果限幅 if(Hcsr04Info.distance >= 450) { Hcsr04Info.distance = 450; } return Hcsr04Info.distance; } main.c 1、引用对应的头文件 /* USER CODE BEGIN Includes */ #include "hc-sr04.h" #include "printf.h" /* USER CODE END Includes */2、200ms测距一次 /** * @brief The application entry point. * @retval int */ int main(void) { /* USER CODE BEGIN 1 */ /* USER CODE END 1 */ /* MCU Configuration--------------------------------------------------------*/ /* Reset of all peripherals, Initializes the Flash interface and the Systick. */ HAL_Init(); /* USER CODE BEGIN Init */ /* USER CODE END Init */ /* Configure the system clock */ SystemClock_Config(); /* USER CODE BEGIN SysInit */ /* USER CODE END SysInit */ /* Initialize all configured peripherals */ MX_GPIO_Init(); MX_TIM2_Init(); MX_USART1_UART_Init(); /* USER CODE BEGIN 2 */ DelayInit(72); Hcsr04Init(&htim2, TIM_CHANNEL_4); // 超声波模块初始化 Hcsr04Start(); // 开启超声波模块测距 printf("hc-sr04 start!\r\n"); /* USER CODE END 2 */ /* Infinite loop */ /* USER CODE BEGIN WHILE */ while (1) { // 打印测距结果 printf("distance:%.1f cm\r\n", Hcsr04Read()); Hcsr04Start(); DelayMs(200); // 测距周期200ms /* USER CODE END WHILE */ /* USER CODE BEGIN 3 */ } /* USER CODE END 3 */ } 3、重定义定时器的中断服务函数 /* USER CODE BEGIN 4 */ /** * @description: 定时器输出捕获中断 * @param {TIM_HandleTypeDef} *htim * @return {*} */ void HAL_TIM_IC_CaptureCallback(TIM_HandleTypeDef *htim) { Hcsr04TimIcIsr(htim); } /** * @description: 定时器溢出中断 * @param {*} * @return {*} */ void HAL_TIM_PeriodElapsedCallback(TIM_HandleTypeDef* htim) { Hcsr04TimOverflowIsr(htim); } /* USER CODE END 4 */ 4、串口打印结果 图片
嵌入式&系统
FPGA&ASIC
# ASIC/FPGA
# 嵌入式
刘航宇
3年前
0
1,477
2
嵌入式/SOC开发利器-ZYNQ简介与入门
摘要ZYNQ是一款集ARM处理器和FPGA可编程逻辑的SoC芯片,适用于多种领域。它具有可编程性,可执行代码程序,也可实现FPGA。ZYNQ开发流程包括硬件和软件两部分,使用Vivado、Vitis IDE和PetaLinux等工具。入门简单,精通需要大量知识储备。关键词:ZYNQ, ARM处理器, FPGA, SoC设计, 嵌入式系统ZYNQ是什么? ZYNQ为什么厉害 ZYNQ的结构 开发工具 ZYNQ开发流程 ZYNQ是什么? 这是一款由Xilinx公司开发的集成了ARM处理器和FPGA可编程逻辑的片上系统(SoC)芯片。ZYNQ7000有多个型号,根据处理器核心数和FPGA系列的不同,可以应用于多种领域,如图像处理,通信,嵌入式系统等。 ZYNQ中国人读法 “zingke”、“任克”,“Soc”,英文全称叫 System on one Chip ,也就是片上系统的意思。没有微机基础的同学可能不明白什么叫Soc,但是你可以细细琢磨一下,我们的手机和台式电脑的不同,你就可以理解Soc的内含了。 传统计算机是将CPU,内存,GPU,南北桥焊接在印刷电路板上,各个组件之间是分立的。但是Soc则将CPU和各种外设集中到一块芯片上,集合成一个系统,因此像手机这种使用了Soc芯片的这种微机可以做的很轻薄,我们可以说,Soc是未来微机发展的一个趋势,我之前遇见过的像什么全志的A33就是典型的Soc。 ZYNQ为什么厉害 就在于它是一块可编程的Soc。其内部往往有处理器硬核和一些定制外设,并且外设当中有一个很厉害的玩意:PL,即可编程逻辑模块,也就是我们一般意义上的FPGA,所以简单理解ZYNQ就是“ 单片机 + FPGA “,它既可以执行代码程序,也可以实现FPGA。因此我们设计ZYNQ就是在做Soc设计。 ZYNQ的结构 我们先来开一下简化版的模型 图片 上面的模型细致低展开后就是下图的样子: 图片 图是 ZYNQ 7000的结构图,大体分为PS(Processing System)和 PL(Programmable Logic)两部分,其中的PS部分主要是由双核APU和外围的一些外设组成,说实话很像单片机的结构,而外围的PL则类似FPGA,并且两者通过AXI接口进行互联以实现功能. 重点介绍一下APU,应用处理单元:Application Processing Unit,位于PS(processing system)中,包括一个单核或者双核的cortex-A9处理器,处理器连接一个512KB的共享L2cache,每个处理器都有一个32KB的高速L1 cache,A9支持虚拟内存和32bit arm 指令。APU中的A9处理器由可配置的MP组成,MP包含SCU(snoop control unit:监控控制单元)单元,这个单元主要负责获取两个处理器的L1 cache和ACP(accelerator coherency port:加速器相关接口) PL的一致性。应用单元还有一个低延迟的片上memory,与L2 cache并行的,ACP(加速器接口)是PL与APU通信接口,该接口是PL作为主机的AXI协议的接口,最多支持64bit位宽,PL通过ACP接口访问L2 cache 和片上memory,同时保持和L1 cache的内存一致性。L2 cache 可以访问 DDR 控制,这个ddr 控制器是专用的,大大降低内存读写的延迟APU 还包括一个32bit的看门狗,一个64bit的全局定时器,APU 架构图如下所示: 图片 开发工具 在Vivado 19.2之前,我们开发Zynq需要三样必须的软件: Vivado SDK PetaLinux 其中Vivado用来开发硬件平台,SDK开发软件,PetaLinux则制作配套的Linux系统。可能有些人还有用到HLS ,即VIvado HLS 或者Vitis HLS;其中Vivado HLS 2020.1将是Vivado HLS的最后一个版本,取而代之的是VitisHLS。 到了Vivado 19.2之后,事情发生了变化。为了方便大家理解,我愿意称之这些软件成了为Vitis 家族的各个部分,原来的SDK被Vitis IDE取代,Vivado导出的 .hdf 文件被 .xsa文件代替,用来给vitis平台使用。因此我们需要的开发Zynq 最基本的软件变成了 Vivado Vitis IDE PetaLinux 各软件发挥的作用和之前的差不多,不过除了上面提到的四款软件外,Vitis家族还有 Vitis AI 等组件,他们共同组成了所谓的“Vitis™ Unified Software Platform ”,从发展趋势来看,这些开发软件应该会逐步的统一,入门的同学也不会再一头雾水地纠结 Vitis 和 Vivado 的区别和联系了。 ZYNQ开发流程 ZYNQ类似于一个 单片机 + FPGA的结构,其实我觉得如果大家接触过一些 Soc就会更好地理解ZYNQ的作用,就例如全志A33这块Soc,它是一块ASIC,不可以通过编程来对芯片的硬件进行重设计的。 图片 我们可以看到,灰色部分的外设都是固定的,像什么摄像头接口,什么视频接口都是设计好的,定制化的好处就使得总体比较高效,制造成本也低;但是如果我要运用到其它场景下,比如说我需要多个摄像头,那这块芯片就不再适合了(硬件控制的上限就是前后两颗摄像头) 而ZYNQ的意义相当于只给你定制的蓝色部分,也就是处理器内核,灰色的部分都可以通过FPGA实现,这让电子工程师们可以快速开发出各种各样有针对性的Soc;当然了,看过我第一篇博客的同学都知道,其实固定的硬核不止只有处理器内核,其实还有串口和内存控制器之类的外设,这其实是追寻一种固定和变化之间的平衡。 咱们把话说回ZYNQ的开发上来。 图片 ZYNQ的开发流程分为硬件和软件两部分,在SDK之前的属于硬件开发,也就是我们常说的PL部分的开发,而SDK后就属于软件部分的开发了,类似单片机,属于PS部分。当然现在最新的Vitis IDE已经取代了SDK,所以后半部分一般在SDK中进行。 PL部分的开发包括对 嵌入式最小系统的构建,以及FPGA外设的设计两个方面。我觉得要转变的一个思维是,我们现在不是在开发一个什么SDRAM控制器,什么IIC协议控制器,我们在开发的是一个小型的微机系统!因此嵌入式最小系统的设计是我们的核心。 首先,在IP INTEGRATOR中我们要创建BLOCK DESIGN。 图片 IP是用来进行 Embedded System Design ,也就是咱们常说的嵌入式系统设计。也就是咱们上面说的嵌入式最小系统的设计。 图片 大家可以看到,一个最小的系统其实不需要PL参与的,PL可以作为PS的一个外设使用,或者是自己做自己的事情,仅仅作为一个PL工作。既然是外设,当然是可用可不用的,毕竟咱们有好多的外设可以在Block Design 中直接配置使用,即下图绿色部分。 图片 配置好嵌入式系统后,咱们根据需要进行PL部分的设计。这里涉及一个问题,那就是PS和PL之间的数据传输方式有哪些: 中断 IO方式:MIO EMIO GPIO BRAM或FIFO或EMIF AXI DMA:PS通过AXI-lite向AXI DMA发送指令,AXI DMA通过HP通路和DDR交换数据,PL通过AXI-S读写DMA的数据。 等等。。。 可以看出,其实两个部分的交互方式还是很多的,以后咱们遇到一个说一个。 在Vivado端完成对嵌入式系统的设计后,我们就要进入Vitis IDE 端进行软件的开发。 图片 Vitis IDE简单来说流程一般是:新建一个工程,选择Platform ,也就是我们之前在Vivado中生成的 XSA文件,然后添加文件,进行开发。我相信使用过Keil 5的同学们应该心中对文件目录结构应该更胸有成竹,Src文件夹中存放的是源文件。 代码编写完之后是编译,编译完就是下载了。不过这里要注意以下,如果我们使用了PL的资源,那么在下载软件编译生成的 elf 文件之前,需要先下载硬件设计过程中生成的 bitstream 文件,对 PL 部分进行配置。 最后就是验证工作了,上述的流程是普通的ZYNQ开发流程;玩的花一点的同学可能是直接上Linux操作系统,这部分等后面我接触到了再说吧! 其实我觉得ZYNQ入门简单,精通的话需要大量的知识储备,但也不是不可能,开发ZYNQ相比于做单片机开发肯定路子会更广一些,向上可以做IC设计,向下嵌入式、单片机什么的工作也能胜任。
FPGA&ASIC
IP&SOC设计
# ASIC/FPGA
# 嵌入式
# SOC设计
刘航宇
3年前
0
4,852
5
2023-11-01
机器学习/深度学习-10个激活函数详解
摘要本文详细介绍了深度学习中常见的十种激活函数,包括Sigmoid、Tanh、ReLU、Leaky ReLU、ELU、PReLU、Softmax、Swish、Maxout和Softplus,并分析了它们的优缺点。关键词:机器学习, 深度学习, 激活函数, Sigmoid, ReLU图片 综述 1. Sigmoid 激活函数 2. Tanh / 双曲正切激活函数 3. ReLU 激活函数 4. Leaky ReLU 5. ELU 6. PReLU(Parametric ReLU) 7. Softmax 8. Swish 9. Maxout 10. Softplus 综述 激活函数(Activation Function)是一种添加到人工神经网络中的函数,旨在帮助网络学习数据中的复杂模式。类似于人类大脑中基于神经元的模型,激活函数最终决定了要发射给下一个神经元的内容。 在人工神经网络中,一个节点的激活函数定义了该节点在给定的输入或输入集合下的输出。标准的计算机芯片电路可以看作是根据输入得到开(1)或关(0)输出的数字电路激活函数。因此,激活函数是确定神经网络输出的数学方程式,本文概述了深度学习中常见的十种激活函数及其优缺点。 首先我们来了解一下人工神经元的工作原理,大致如下: 图片 上述过程的数学可视化过程如下图所示: 图片 1. Sigmoid 激活函数 lofj8ajx.png图片 Sigmoid 函数的图像看起来像一个 S 形曲线。 函数表达式如下: $$\[\mathrm{f(z)=1/(1+e^{\wedge}-z)}\]$$ 在什么情况下适合使用 Sigmoid 激活函数呢? Sigmoid 函数的输出范围是 0 到 1。由于输出值限定在 0 到 1,因此它对每个神经元的输出进行了归一化; 用于将预测概率作为输出的模型。由于概率的取值范围是 0 到 1,因此 Sigmoid 函数非常合适; 梯度平滑,避免「跳跃」的输出值; 函数是可微的。这意味着可以找到任意两个点的 sigmoid 曲线的斜率; 明确的预测,即非常接近 1 或 0。 Sigmoid 激活函数有哪些缺点? 倾向于梯度消失; 函数输出不是以 0 为中心的,这会降低权重更新的效率; Sigmoid 函数执行指数运算,计算机运行得较慢。 2. Tanh / 双曲正切激活函数 图片 tanh 激活函数的图像也是 S 形,表达式如下: $$f(x)=tanh(x)=\frac{2}{1+e^{-2x}}-1$$ tanh 是一个双曲正切函数。tanh 函数和 sigmoid 函数的曲线相对相似。但是它比 sigmoid 函数更有一些优势。 图片 首先,当输入较大或较小时,输出几乎是平滑的并且梯度较小,这不利于权重更新。二者的区别在于输出间隔,tanh 的输出间隔为 1,并且整个函数以 0 为中心,比 sigmoid 函数更好; 在 tanh 图中,负输入将被强映射为负,而零输入被映射为接近零。 注意:在一般的二元分类问题中,tanh 函数用于隐藏层,而 sigmoid 函数用于输出层,但这并不是固定的,需要根据特定问题进行调整。 3. ReLU 激活函数 图片 ReLU 激活函数图像如上图所示,函数表达式如下: 图片 ReLU 函数是深度学习中较为流行的一种激活函数,相比于 sigmoid 函数和 tanh 函数,它具有如下优点: 当输入为正时,不存在梯度饱和问题。 计算速度快得多。ReLU 函数中只存在线性关系,因此它的计算速度比 sigmoid 和 tanh 更快 当然,它也有缺点: Dead ReLU 问题。当输入为负时,ReLU 完全失效,在正向传播过程中,这不是问题。有些区域很敏感,有些则不敏感。但是在反向传播过程中,如果输入负数,则梯度将完全为零,sigmoid 函数和 tanh 函数也具有相同的问题; 我们发现 ReLU 函数的输出为 0 或正数,这意味着 ReLU 函数不是以 0 为中心的函数。 4. Leaky ReLU 它是一种专门设计用于解决 Dead ReLU 问题的激活函数: 图片 ReLU vs Leaky ReLU 为什么 Leaky ReLU 比 ReLU 更好? $$f(y_i)=\begin{cases}y_i,&\text{if }y_i>0\\a_iy_i,&\text{if }y_i\leq0\end{cases}.$$ 1、Leaky ReLU 通过把 x 的非常小的线性分量给予负输入(0.01x)来调整负值的零梯度(zero gradients)问题; 2、leak 有助于扩大 ReLU 函数的范围,通常 a 的值为 0.01 左右; 3、Leaky ReLU 的函数范围是(负无穷到正无穷)。 注意:从理论上讲,Leaky ReLU 具有 ReLU 的所有优点,而且 Dead ReLU 不会有任何问题,但在实际操作中,尚未完全证明 Leaky ReLU 总是比 ReLU 更好。 5. ELU 图片 ELU vs Leaky ReLU vs ReLU ELU 的提出也解决了 ReLU 的问题。与 ReLU 相比,ELU 有负值,这会使激活的平均值接近零。均值激活接近于零可以使学习更快,因为它们使梯度更接近自然梯度。 图片 显然,ELU 具有 ReLU 的所有优点,并且: 没有 Dead ReLU 问题,输出的平均值接近 0,以 0 为中心; ELU 通过减少偏置偏移的影响,使正常梯度更接近于单位自然梯度,从而使均值向零加速学习; ELU 在较小的输入下会饱和至负值,从而减少前向传播的变异和信息。 一个小问题是它的计算强度更高。与 Leaky ReLU 类似,尽管理论上比 ReLU 要好,但目前在实践中没有充分的证据表明 ELU 总是比 ReLU 好。 6. PReLU(Parametric ReLU) 图片 PReLU 也是 ReLU 的改进版本: $$f(y_i)=\begin{cases}y_i,&\text{if }y_i>0\\a_iy_i,&\text{if }y_i\leq0\end{cases}.$$ 看一下 PReLU 的公式:参数α通常为 0 到 1 之间的数字,并且通常相对较小。 如果 a_i= 0,则 f 变为 ReLU 如果 a_i> 0,则 f 变为 leaky ReLU 如果 a_i 是可学习的参数,则 f 变为 PReLU PReLU 的优点如下: 在负值域,PReLU 的斜率较小,这也可以避免 Dead ReLU 问题。 与 ELU 相比,PReLU 在负值域是线性运算。尽管斜率很小,但不会趋于 0。 7. Softmax 图片 Softmax 是用于多类分类问题的激活函数,在多类分类问题中,超过两个类标签则需要类成员关系。对于长度为 K 的任意实向量,Softmax 可以将其压缩为长度为 K,值在(0,1)范围内,并且向量中元素的总和为 1 的实向量。 图片 Softmax 与正常的 max 函数不同:max 函数仅输出最大值,但 Softmax 确保较小的值具有较小的概率,并且不会直接丢弃。我们可以认为它是 argmax 函数的概率版本或「soft」版本。 Softmax 函数的分母结合了原始输出值的所有因子,这意味着 Softmax 函数获得的各种概率彼此相关。 Softmax 激活函数的主要缺点是: 在零点不可微; 负输入的梯度为零,这意味着对于该区域的激活,权重不会在反向传播期间更新,因此会产生永不激活的死亡神经元。 8. Swish 图片 函数表达式:y = x * sigmoid (x) Swish 的设计受到了 LSTM 和高速网络中 gating 的 sigmoid 函数使用的启发。我们使用相同的 gating 值来简化 gating 机制,这称为 self-gating。 self-gating 的优点在于它只需要简单的标量输入,而普通的 gating 则需要多个标量输入。这使得诸如 Swish 之类的 self-gated 激活函数能够轻松替换以单个标量为输入的激活函数(例如 ReLU),而无需更改隐藏容量或参数数量。 Swish 激活函数的主要优点如下: 「无界性」有助于防止慢速训练期间,梯度逐渐接近 0 并导致饱和;(同时,有界性也是有优势的,因为有界激活函数可以具有很强的正则化,并且较大的负输入问题也能解决); 导数恒 > 0; 平滑度在优化和泛化中起了重要作用。 9. Maxout 图片 在 Maxout 层,激活函数是输入的最大值,因此只有 2 个 maxout 节点的多层感知机就可以拟合任意的凸函数。 单个 Maxout 节点可以解释为对一个实值函数进行分段线性近似 (PWL) ,其中函数图上任意两点之间的线段位于图(凸函数)的上方。 $ReLU=\max\bigl(0,x\bigr),\mathrm{abs}\bigl(x\bigr)=\max\bigl(x,-x\bigr)$ Maxout 也可以对 d 维向量(V)实现: 图片 假设两个凸函数 h_1(x) 和 h_2(x),由两个 Maxout 节点近似化,函数 g(x) 是连续的 PWL 函数。 $$g\bigl(x\bigr)=h_1\bigl(x\bigr)-h_2\bigl(x\bigr)$$ 因此,由两个 Maxout 节点组成的 Maxout 层可以很好地近似任何连续函数。 图片 10. Softplus 图片 Softplus 函数:f(x)= ln(1 + exp x) Softplus 的导数为 f ′(x)=exp(x) / ( 1+exp x ) = 1/ (1 +exp(−x )) ,也称为 logistic / sigmoid 函数。 Softplus 函数类似于 ReLU 函数,但是相对较平滑,像 ReLU 一样是单侧抑制。它的接受范围很广:(0, + inf)。
机器学习
# 机器学习
# 软件算法
# DL/ML
刘航宇
3年前
0
723
0
Python-BP神经网络实现单特征多分类
摘要本文使用Python和BP神经网络对同半径的圆进行多分类(3分类),通过生成圆的坐标,计算半径作为输入,构建神经网络模型,并使用训练数据和测试数据进行训练和测试,最终实现了对圆的分类。关键词:Python, BP神经网络, 单特征多分类, 圆半径分类, 神经网络实现不同于图像处理,神经网络在处理其他不少领域,常常需要单特征分类,本例实现同半径的圆进行多分类(3分类),特征即为圆的半径。 输入层12节点,一个6节点的隐藏层,输出层3个节点。 1.目标 2.开发环境 3.准备数据 4.处理数据 5.构建BP神经网络 总结 1.目标 通过BP算法实现对不同半径的圆的分类。 2.开发环境 Python3.10;jupyter notebook 3.准备数据 目的: 生成3类圆在第一象限内的坐标(圆心都是原点) 第1类:半径范围为1~10,分类标识为‘0’ 第2类:半径范围为10~20,分类标识为‘1’ 第3类:半径范围为20~30,分类标识为‘2’ 代码如下:data_generate.py import numpy as np import math import random import csv # 只生成第一象限内的坐标即可。每个圆生成12个坐标(x,y),相当于12个特征维度 def generate_circle(lower, upper): # 圆在第一象限内的坐标 data_ur = np.zeros(shape=(12, 2)) # 在上下限范围内,随机产生一个值作为半径 radius = random.randint(int(lower), int(upper)) # 在0~90度内,每隔7.5度取一次坐标,正好取12次 angles = np.arange(0, 0.5 * np.pi, 1 / 24 * np.pi) for i in range(12): temp_ur = np.zeros(2) x = round(radius * math.cos(angles[i]), 2) y = round(radius * math.sin(angles[i]), 2) temp_ur[0] = x temp_ur[1] = y data_ur[i] = temp_ur return data_ur, label # 将坐标保存到CSV文件中 def save2csv(data, batch, label): out = open("D:\\circles.csv", 'a', newline='') csv_write = csv.writer(out, dialect='excel') length = int(data.size / 2) for i in range(length): string = str(data[i][0]) + ',' + str(data[i][1]) + ',' + str(batch) + ',' + str(label) temp = string.split(',') csv_write.writerow(temp) out.close() if __name__ == "__main__": ''' 生成3类圆,标签(label)分别为:0、1、2 第1类圆的半径下限为1,上限为10 第2类圆的半径下限为10,上限为20 第3类圆的半径下限为20,上限为30 圆心都为原点 ''' lower = [1, 10, 20] # 半径随机值的下限 upper = [10, 20, 30] # 半径随机值的上限 label = ['0', '1', '2'] # 种类的标签 for i in range(len(label)): # 每类数据生成50组 for j in range(50): data, label = generate_circle(lower[i], upper[i]) batch = 50 * i + j + 1 # 数据的批次,用来区分每个坐标是属于哪个圆的 save2csv(data, batch, label[i])共3类圆,每类生成50个圆,每个圆 有12个坐标,因此在输出文件D:\circles.csv中总共有3×50×12=1800行数据: 图片 通过生成的坐标绘制散点图如下: 图片 图中蓝色的点是label为0的圆,绿色的点是label为1的圆,红色的点是label为2的圆。 4.处理数据 目标: 根据第3步获得的坐标,计算每个圆的半径(勾股定理)作为神经网络的输入。 代码如下:data_process.py import csv import math def process(file_name): # 要读取的CSV文件 csv_file = csv.reader(open(file_name, encoding='utf-8')) # 要生成的CSV文件 out_file = open("D:\\circles_data.csv", 'a', newline='') csv_write = csv.writer(out_file, dialect='excel') # 将csv_file每一行的圆坐标取出,如果是同一批次的(同一个圆),则写入到out_file的一行中 rows = [row for row in csv_file] current_batch = 'unknown' current_label = 'unknown' data_list = [] for r in rows: # 将无关字符都替换为空格 temp_string = str(r).replace('[', '').replace(']', '').replace('\'', '') # 将字符串以逗号分隔 item = str(temp_string).split(',') # 分别取出x轴坐标、y轴坐标、批次、标签 x = float(item[0]) y = float(item[1]) batch = item[2] label = item[3] # 如果是同一批次(同一个圆),则都放入data_list中 if current_batch == batch: # 根据勾股定理计算半径 distance = math.sqrt(pow(x, 2) + pow(y, 2)) data_list.append(distance) # 如果不是同一批次(同一个圆),则在末尾加上标签后,作为一行写入输出文件 else: if len(data_list) != 0: # 这个地方需注意一下,最后的标签用3列来表示,而不是一列 if label.strip() == '0': data_list.append(1) data_list.append(0) data_list.append(0) elif label.strip() == '1': data_list.append(0) data_list.append(1) data_list.append(0) else: data_list.append(0) data_list.append(0) data_list.append(1) result_string = str(data_list).replace('[', '').replace(']', '').replace('\'', '').strip() csv_write.writerow(result_string.split(',')) # 清空data_list,继续写入下一个批次 data_list.clear() distance = math.sqrt(pow(x, 2) + pow(y, 2)) data_list.append(distance) current_batch = batch current_label = label # 确保最后一个批次的数据能写入 if current_label.strip() == '0': data_list.append(1) data_list.append(0) data_list.append(0) elif current_label.strip() == '1': data_list.append(0) data_list.append(1) data_list.append(0) else: data_list.append(0) data_list.append(0) data_list.append(1) result_string = str(data_list).replace('[', '').replace(']', '').replace('\'', '').strip() csv_write.writerow(result_string.split(',')) # 关闭输出文件 out_file.close() if __name__ == "__main__": process('D:\\circles.csv')需要注意的是,生成的CSV文件共有15列,前12列为坐标对应的半径值,最后三列组合起来表示分类(label): 图片 (1,0,0)表示类型为“0”的圆,(0,1,0)表示类型为“1”的圆,(0,0,1)表示类型为“2”的圆,这样做的目的是为了下一步使用神经网络时处理起来方便。 5.构建BP神经网络 上一步处理好的数据可以作为训练数据,命名为:circles_data_training.csv 重复第3步和第4步,可以生成另一批数据作为测试数据,命名为:circles_data_test.csv 当然,也可以手动划分出训练数据和测试数据。 训练数据和测试数据在输入时,做了矩阵的转置,将列转置为行。 代码如下:data_analysis_bpnn.py import pandas as pd import numpy as np import datetime from sklearn.utils import shuffle # 1.初始化参数 def initialize_parameters(n_x, n_h, n_y): np.random.seed(2) # 权重和偏置矩阵 w1 = np.random.randn(n_h, n_x) * 0.01 b1 = np.zeros(shape=(n_h, 1)) w2 = np.random.randn(n_y, n_h) * 0.01 b2 = np.zeros(shape=(n_y, 1)) # 通过字典存储参数 parameters = {'w1': w1, 'b1': b1, 'w2': w2, 'b2': b2} return parameters # 2.前向传播 def forward_propagation(X, parameters): w1 = parameters['w1'] b1 = parameters['b1'] w2 = parameters['w2'] b2 = parameters['b2'] # 通过前向传播来计算a2 z1 = np.dot(w1, X) + b1 # 这个地方需注意矩阵加法:虽然(w1*X)和b1的维度不同,但可以相加 a1 = np.tanh(z1) # 使用tanh作为第一层的激活函数 z2 = np.dot(w2, a1) + b2 a2 = 1 / (1 + np.exp(-z2)) # 使用sigmoid作为第二层的激活函数 # 通过字典存储参数 cache = {'z1': z1, 'a1': a1, 'z2': z2, 'a2': a2} return a2, cache # 3.计算代价函数 def compute_cost(a2, Y, parameters): m = Y.shape[1] # Y的列数即为总的样本数 # 采用交叉熵(cross-entropy)作为代价函数 logprobs = np.multiply(np.log(a2), Y) + np.multiply((1 - Y), np.log(1 - a2)) cost = - np.sum(logprobs) / m return cost # 4.反向传播(计算代价函数的导数) def backward_propagation(parameters, cache, X, Y): m = Y.shape[1] w2 = parameters['w2'] a1 = cache['a1'] a2 = cache['a2'] # 反向传播,计算dw1、db1、dw2、db2 dz2 = a2 - Y dw2 = (1 / m) * np.dot(dz2, a1.T) db2 = (1 / m) * np.sum(dz2, axis=1, keepdims=True) dz1 = np.multiply(np.dot(w2.T, dz2), 1 - np.power(a1, 2)) dw1 = (1 / m) * np.dot(dz1, X.T) db1 = (1 / m) * np.sum(dz1, axis=1, keepdims=True) grads = {'dw1': dw1, 'db1': db1, 'dw2': dw2, 'db2': db2} return grads # 5.更新参数 def update_parameters(parameters, grads, learning_rate=0.0075): w1 = parameters['w1'] b1 = parameters['b1'] w2 = parameters['w2'] b2 = parameters['b2'] dw1 = grads['dw1'] db1 = grads['db1'] dw2 = grads['dw2'] db2 = grads['db2'] # 更新参数 w1 = w1 - dw1 * learning_rate b1 = b1 - db1 * learning_rate w2 = w2 - dw2 * learning_rate b2 = b2 - db2 * learning_rate parameters = {'w1': w1, 'b1': b1, 'w2': w2, 'b2': b2} return parameters # 建立神经网络 def nn_model(X, Y, n_h, n_input, n_output, num_iterations=10000, print_cost=False): np.random.seed(3) n_x = n_input # 输入层节点数 n_y = n_output # 输出层节点数 # 1.初始化参数 parameters = initialize_parameters(n_x, n_h, n_y) # 梯度下降循环 for i in range(0, num_iterations): # 2.前向传播 a2, cache = forward_propagation(X, parameters) # 3.计算代价函数 cost = compute_cost(a2, Y, parameters) # 4.反向传播 grads = backward_propagation(parameters, cache, X, Y) # 5.更新参数 parameters = update_parameters(parameters, grads) # 每1000次迭代,输出一次代价函数 if print_cost and i % 1000 == 0: print('迭代第%i次,代价函数为:%f' % (i, cost)) return parameters # 对模型进行测试 def predict(parameters, x_test, y_test): w1 = parameters['w1'] b1 = parameters['b1'] w2 = parameters['w2'] b2 = parameters['b2'] z1 = np.dot(w1, x_test) + b1 a1 = np.tanh(z1) z2 = np.dot(w2, a1) + b2 a2 = 1 / (1 + np.exp(-z2)) # 结果的维度 n_rows = y_test.shape[0] n_cols = y_test.shape[1] # 预测值结果存储 output = np.empty(shape=(n_rows, n_cols), dtype=int) # 取出每条测试数据的预测结果 for i in range(n_cols): # 将每条测试数据的预测结果(概率)存为一个行向量 temp = np.zeros(shape=n_rows) for j in range(n_rows): temp[j] = a2[j][i] # 将每条结果(概率)从小到大排序,并获得相应下标 sorted_dist = np.argsort(temp) length = len(sorted_dist) # 将概率最大的置为1,其它置为0 for k in range(length): if k == sorted_dist[length - 1]: output[k][i] = 1 else: output[k][i] = 0 print('预测结果:') print(output) print('真实结果:') print(y_test) count = 0 for k in range(0, n_cols): if output[0][k] == y_test[0][k] and output[1][k] == y_test[1][k] and output[2][k] == y_test[2][k]: count = count + 1 acc = count / int(y_test.shape[1]) * 100 print('准确率:%.2f%%' % acc) if __name__ == "__main__": # 读取数据 data_set = pd.read_csv('D:\\circles_data_training.csv', header=None) data_set = shuffle(data_set) # 打乱数据的输入顺序 # 取出“特征”和“标签”,并做了转置,将列转置为行 X = data_set.ix[:, 0:11].values.T # 前12列是特征 Y = data_set.ix[:, 12:14].values.T # 后3列是标签 Y = Y.astype('uint8') # 开始训练 start_time = datetime.datetime.now() # 输入12个节点,隐层6个节点,输出3个节点,迭代10000次 parameters = nn_model(X, Y, n_h=6, n_input=12, n_output=3, num_iterations=10000, print_cost=True) end_time = datetime.datetime.now() print("用时:" + str((end_time - start_time).seconds) + 's' + str(round((end_time - start_time).microseconds / 1000)) + 'ms') # 对模型进行测试 data_test = pd.read_csv('D:\\circles_data_test.csv', header=None) x_test = data_test.ix[:, 0:11].values.T y_test = data_test.ix[:, 12:14].values.T y_test = y_test.astype('uint8') predict(parameters, x_test, y_test)码中需要注意的几个关键参数: learning_rate=0.0075,学习率(可调) n_h=6,隐藏层节点数(可调) n_input=12,输入层节点数 n_output=3,输出层节点数 num_iterations=10000,迭代次数(可调) 另外,对于predict(parameters, x_test, y_test)函数需要说明一下: a2矩阵是最终的预测结果,但是是以概率的形式表示的(可以打印看一下)。通过比较3个类的概率,选出概率最大的那个置为1,其它两个置为0,形成output矩阵。 运行结果: 图片 上图中第一红框表示神经网络预测出的分类结果,第二个红框表示测试集中真实的分类((1,0,0)表示这个圆属于类型“0”)。 每次运行时,正确率可能不一样,最高能达到100%。通过调整刚才提到的关键参数中的学习率、隐藏层节点数、迭代次数可以提高正确率。 总结 神经网络的输入为12个半径值,输出结果为一个3维向量,其中置1的位就是对应的分类。 在实际应用中,12个半径值对应12个特征,3维向量表示能分3类。只要根据实际应用的需要修改特征数和分类数即可将上述程序应用于不同分类场景。
机器学习
# 机器学习
刘航宇
3年前
0
508
1
2023-10-15
DL-神经网络的正向传播与反向传播
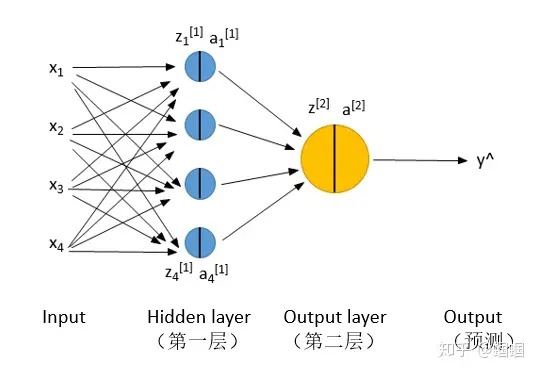
摘要本文介绍了神经网络的基本概念,包括前向传播和反向传播。前向传播从输入层开始,通过隐层计算输出;反向传播则根据损失函数计算参数的梯度,以更新网络参数。同时,文章还讨论了深层神经网络和单个神经元的工作原理。关键词:神经网络, 正向传播, 反向传播, 激活函数, 梯度下降神经网络简述 前向传播 反向传播 四、深层神经网络(Deep Neural Network) 1.单个神经元 2.由神经元组成的神经网络 3.目标函数 4.求解损失函数对某个权值的梯度 5.反向传播算法Backpropgation 5.2 计算一个梯度 5.3 反向传播误差 6.优化示例 神经网络简述 神经网络,就是在Logistic regression的基础上增加了一个或几个隐层(hidden layer),下面展示的是一个最最最简单的神经网络,只有两层: 两层神经网络 图片 需要注意的是,上面的图是“两层”,而不是三层或者四层,输入和输出不算层! 这里,我们先规定一下记号(Notation): z是x和w、b线性运算的结果,z=wx+b; a是z的激活值; 下标的1,2,3,4代表该层的第i个神经元(unit); 上标的[1],[2]等代表当前是第几层。 y^代表模型的输出,y才是真实值,也就是标签 另外,有一点经常搞混: 上图中的x1,x2,x3,x4不是代表4个样本!而是一个样本的四个特征(4个维度的值)! 你如果有m个样本,代表要把上图的过程重复m次: 图片 神经网络的“两个传播”: 前向传播(Forward Propagation)前向传播就是从input,经过一层层的layer,不断计算每一层的z和a,最后得到输出y^ 的过程,计算出了y^,就可以根据它和真实值y的差别来计算损失(loss)。 反向传播(Backward Propagation)反向传播就是根据损失函数L(y^,y)来反方向地计算每一层的z、a、w、b的偏导数(梯度),从而更新参数。 前向传播和反向传播: 图片 每经过一次前向传播和反向传播之后,参数就更新一次,然后用新的参数再次循环上面的过程。这就是神经网络训练的整个过程。 前向传播 如果用for循环一个样本一个样本的计算,显然太慢,是使用Vectorization,把m个样本压缩成一个向量X来计算,同样的把z、a都进行向量化处理得到Z、A,这样就可以对m的样本同时进行表示和计算了。不熟悉的朋友可以看这里: 这样,我们用公式在表示一下我们的两层神经网络的前向传播过程: Layer 1:Z[1] = W[1]·X + b[1]A[1] = σ(Z[1]) Layer 2:Z[2] = W[2]·A[1] + b[2]A[2] = σ(Z[2]) 而我们知道,X其实就是A[0],所以不难看出:每一层的计算都是一样的: Layer i:Z[i] = W[i]·A[i-1] + b[i]A[i] = σ(Z[i]) (注:σ是sigmoid函数) 因此,其实不管我们神经网络有几层,都是将上面过程的重复。 对于 损失函数,就跟Logistic regression中的一样,使用 “交叉熵(cross-entropy)”,公式就是 二分类问题:L(y^,y) = -[y·log(y^ )+(1-y)·log(1-y^ )]- 多分类问题:L=-Σy(j)·y^(j) 这个是每个样本的loss,我们一般还要计算整个样本集的loss,也称为cost,用J表示,J就是L的平均: J(W,b) = 1/m·ΣL(y^(i),y(i)) 上面的求Z、A、L、J的过程就是正向传播。 反向传播 反向传播说白了根据根据J的公式对W和b求偏导,也就是求梯度。因为我们需要用梯度下降法来对参数进行更新,而更新就需要梯度。 但是,根据求偏导的链式法则我们知道,第l层的参数的梯度,需要通过l+1层的梯度来求得,因此我们求导的过程是“反向”的,这也就是为什么叫“反向传播”。 具体求导的过程,这里就不赘述了。像各种 深度学习框架TensorFlow、Keras,它们都是 只需要我们自己构建正向传播过程, 反向传播的过程是自动完成的,所以大家也确实不用操这个心。 进行了反向传播之后,我们就可以根据每一层的参数的梯度来更新参数了,更新了之后,重复正向、反向传播的过程,就可以不断训练学习更好的参数了。 四、深层神经网络(Deep Neural Network) 前面的讲解都是拿一个两层的很浅的神经网络为例的。 深层神经网络也没什么神秘,就是多了几个/几十个/上百个hidden layers罢了。 可以用一个简单的示意图表示: 深层神经网络: 图片 注意,在深层神经网络中,我们在中间层使用了 “ReLU”激活函数,而不是sigmoid函数了,只有在最后的输出层才使用了sigmoid函数,这是因为 ReLU函数在求梯度的时候更快,还可以一定程度上防止梯度消失现象,因此在深层的网络中常常采用。 关于深层神经网络,我们有必要再详细的观察一下它的结构,尤其是 每一层的各个变量的维度,毕竟我们在搭建模型的时候,维度至关重要。 图片 我们设: 总共有m个样本,问题为二分类问题(即y为0,1); 网络总共有L层,当前层为l层(l=1,2,...,L); 第l层的单元数为n[l];那么下面参数或变量的维度为: W[l]:(n[l],n[l-1])(该层的单元数,上层的单元数) b[l]:(n[l],1) z[l]:(n[l],1) Z[l]:(n[l],m) a[l]:(n[l],1) A[l]:(n[l],m) X:(n[0],m) Y:(1,m) 可能有人问,为什么 W和b的维度里面没有m? 因为 W和b对每个样本都是一样的,所有样本采用同一套参数(W,b), 而Z和A就不一样了,虽然计算时的参数一样,但是样本不一样的话,计算结果也不一样,所以维度中有m。 深度神经网络的正向传播、反向传播和前面写的2层的神经网络类似,就是多了几层,然后中间的激活函数由sigmoid变为ReLU了。 1.单个神经元 神经网络是由一系列神经元组成的模型,每一个神经元实际上做得事情就是实现非线性变换。 如下图就是一个神经元的结构: 图片 神经元将两个部分:上一层的输出(x1,x2,....,xn)与权重(w1,w2,....,wn),对应相乘相加,然后再加上一个偏置 b之后的值经过激活函数处理后完成非线性变换。 记 z = w ⋅ x + b ,a=σ(z),则 z 是神经元非线性变换之前的结果,这部分仅仅是一个简单的线性函数。σ 是Sigmod激活函数,该函数可以将无穷区间内的数映射到(-1,1)的范围内。a 是神经元将 z z 进行非线性变换之后的结果。 Sigmod函数图像如下图 $$\mathrm{sigmod(x)=\frac{1}{1+e^{-x}}}$$ 图片 因此,结果 a 就等于: 图片 这里再强调一遍,神经元的本质就是做非线性变换 2.由神经元组成的神经网络 神经元可以理解成一个函数,神经网络就是由很多个非线性变换的神经元组成的模型,因此神经网络可以理解成是一个非常复杂的复合函数。 图片 对于上图中的网络: (x1,x2,....,xn)为n维输入向量 Wij,表示后一层低i个神经元与前一层第j个神经元之间的权值 z = Wx + b是没有经过激活函数非线性变换之前的结果 a=σ(z),是 z 经过激活函数非线性变换之后的结果 \mathrm{s=U^Ta},为网络最终的输出结果。 3.目标函数 以折页损失为目标函数: $$\mathrm{minmizeJ}=\max(\Delta+s_{c}-s,0)$$ 其中$\mathrm{s_c=U^T\sigma(Wx_c+b),s=U^T\sigma(Wx+b)}$。一般可以把$\Delta$固定下来,比如设为1或者10。 一般来说,学习算法的学习过程就是优化调整参数,使得损失函数,或者说预测结果和实际结果的误差减小。BP算法其实是一个双向算法,包含两个步骤: 1.正向传递输入信息,得到 Loss 值。 2.反向传播误差,从而由优化算法来调整网络权值。 4.求解损失函数对某个权值的梯度 图片 其中$\mathrm{s_c=U^T\sigma(Wx_c+b),s=U^T\sigma(Wx+b)}$。一般可以把$\Delta$固定下来,比如设为1或者10。 对于上面的图, 假设图中指示出的网络中的某个权值 w$_\mathrm{jk}^\mathrm{l}$ 发生了一个小的改变 $\Delta w_\mathrm{jk}^\mathrm{l}$ , 假设网络最终损失函数的输出为$\mathbb{C}$,则 C 应该是关于 $\mathrm{w}_\mathrm{jk}^{\mathrm{l}}$ 的一个复合函数。 所谓复合函数,就是把 $\mathbb{C}$ 看成因变量,则$\mathrm{w}_\mathrm{jk}^{\mathrm{l}}$ 可以看成导致 C 改变的自变量, 比如假设有一个复 合函数 $\mathrm{y=f(g(x))}$,则 y 就好比这里的$\mathbb{C}$ , x 就好比$\mathrm{w}_{\mathrm{jk}}^{\mathrm{l}}$, w$_{jk}^{\mathrm{l}}$ 每经过一层网络可以看成是经过某个函数的处理。而下面求写的时候都用偏导数, 是因为虽然我们这里只关注了一个 w$_\mathrm{jk}^{\mathrm{l}}$,但是实际上网络中的每一个 w 都可以看成一个 x。 显然,这个$\Delta w_\mathrm{jk}^\mathrm{l}$的变化会引起下一层直接与其相连的一个神经元,以及下一层之后所有神经元直到 最终输出 C 的变化, 如图中蓝线标记的就是该权值变化的影响传播路径。 把 C 的改变记为 $\Delta\mathbb{C}$, 则根据高等数学中导数的知识可以得到: 则神经元 a$_\mathrm{j}^1$ 下面一层第 q 个与其相连的神经元 a$_{\mathrm{q}}^{1+1}$ 的变化为: $$ \Delta\mathrm{a_q^{1+1}}\approx\frac{\partial\mathrm{a_q^{1+1}}}{\partial\mathrm{a_j^1}}\Delta\mathrm{a_j^1} $$将 $(2)$ 代入 (3) 可以得到: $$ \Delta\mathrm{a_{q}^{l+1}}\:\approx\:\frac{\partial\mathrm{a_{q}^{l+1}}}{\partial\mathrm{a_{j}^{l}}}\:\frac{\partial\mathrm{a_{j}^{l}}}{\partial\mathrm{w_{jk}^{l}}}\:\Delta\mathrm{w_{jk}^{l}} $$假设从 $\mathrm{a_j}^1$ 到 C的一条路径为$\mathrm{a_j}^1,\mathrm{a_q}^{1+1},...,\mathrm{a_n}^{\mathrm{L-1}},\mathrm{a_m}^{\mathrm{L}}$,则在该条路径上 C 的变化量 $\Delta C$ 为: $$\Delta\mathrm{C}\approx\frac{\partial\mathrm{C}}{\partial\mathrm{a}_\mathrm{m}^\mathrm{L}}\frac{\partial\mathrm{a}_\mathrm{m}^\mathrm{L}}{\partial\mathrm{a}_\mathrm{n}^\mathrm{L-1}}\frac{\partial\mathrm{a}_\mathrm{n}^\mathrm{L-1}}{\partial\mathrm{a}_\mathrm{p}^\mathrm{L-2}}[USD3P]\frac{\partial\mathrm{a}_\mathrm{q}^\mathrm{l+1}}{\partial\mathrm{a}_\mathrm{j}^\mathrm{l}}\frac{\partial\mathrm{a}_\mathrm{j}^\mathrm{l}}{\partial\mathrm{w}_\mathrm{jk}^\mathrm{l}}\Delta\mathrm{w}_\mathrm{jk}^\mathrm{l}$$ 至此,我们已经得到了一条路径上的变化量, 其实本质就是链式求导法则,或者说是复合函数求导法则。那么整个的变化量就县把所有可能链路上的变化量加起来: $$\Delta\mathrm{C}\approx\sum_{\mathrm{minp[USD3P]q}}\frac{\partial\mathrm{C}}{\partial\mathrm{a_{m}^{L}}}\frac{\partial\mathrm{a_{m}^{L}}}{\partial\mathrm{a_{n}^{L-1}}}\frac{\partial\mathrm{a_{n}^{L-1}}}{\partial\mathrm{a_{p}^{L-2}}}[USD3P]\frac{\partial\mathrm{a_{q}^{l+1}}}{\partial\mathrm{a_{j}^{l}}}\frac{\partial\mathrm{a_{j}^{l}}}{\partial\mathrm{w_{jk}^{l}}}\Delta\mathrm{w_{jk}^{l}}$$ $$\begin{aligned}\text{则 C 对某个权值 w}_{\mathrm{jk}}^{\dagger}&\text{的梯度为:}\\&\frac{\partial\mathrm{C}}{\partial\mathrm{w}_{\mathrm{jk}}^{\dagger}}\approx\sum_{\mathrm{nmp},
机器学习
# DL/ML
刘航宇
3年前
0
703
2
2023-07-23
Python机器学习- 鸢尾花分类
摘要本文介绍了使用Python和sklearn库实现鸢尾花分类的机器学习项目。首先,通过train_and_predict函数使用高斯朴素贝叶斯分类器进行分类,然后通过transform_three2two_cate函数将数据集转化为二分类问题,并使用决策树分类器进行训练和评估,要求测试集准确率不小于0.95。关键词:Python, 机器学习, 鸢尾花分类, sklearn, 朴素贝叶斯1、描述 2、code 3、描述 4、code 1、描述 请编写代码实现train_and_predict功能,实现能够根据四个特征对三种类型的鸢尾花进行分类。 train_and_predict函数接收三个参数: train_input_features—二维NumPy数组,其中每个元素都是一个数组,它包含:萼片长度、萼片宽度、花瓣长度和花瓣宽度。 train_outputs—一维NumPy数组,其中每个元素都是一个数字,表示在train_input_features的同一行中描述的鸢尾花种类。0表示鸢尾setosa,1表示versicolor,2代表Iris virginica。 prediction_features—二维NumPy数组,其中每个元素都是一个数组,包含:萼片长度、萼片宽度、花瓣长度和花瓣宽度。 该函数使用train_input_features作为输入数据,使用train_outputs作为预期结果来训练分类器。请使用训练过的分类器来预测prediction_features的标签,并将它们作为可迭代对象返回(如list或numpy.ndarray)。结果中的第n个位置是prediction_features参数的第n行。 2、code # 导入numpy库,用于处理多维数组 import numpy as np # 导入sklearn库中的数据集、模型选择、度量和朴素贝叶斯模块 from sklearn import datasets from sklearn.model_selection import train_test_split from sklearn import metrics from sklearn.naive_bayes import GaussianNB # 定义train_and_predict函数,接收三个参数:训练输入特征、训练输出标签和预测输入特征 def train_and_predict(train_input_features, train_outputs, prediction_features): # 创建一个高斯朴素贝叶斯分类器对象 clf = GaussianNB() # 使用训练输入特征和训练输出标签来训练分类器 clf.fit(train_input_features, train_outputs) # 使用预测输入特征来预测输出标签,并将结果返回 y_pred = clf.predict(prediction_features) return y_pred # 加载鸢尾花数据集,包含150个样本,每个样本有四个特征和一个标签 iris = datasets.load_iris() # 将数据集随机分成训练集和测试集,其中训练集占70%,测试集占30%,并设置随机种子为0 X_train, X_test, y_train, y_test = train_test_split( iris.data, iris.target, test_size=0.3, random_state=0 ) # 调用train_and_predict函数,使用训练集来训练分类器,并使用测试集来预测标签,将结果赋值给y_pred y_pred = train_and_predict(X_train, y_train, X_test) # 如果y_pred不为空,打印预测标签和真实标签的准确率,即正确预测的比例 if y_pred is not None: print(metrics.accuracy_score(y_test, y_pred))3、描述 机器学习库 sklearn 自带鸢尾花分类数据集,分为四个特征和三个类别,其中这三个类别在数据集中分别表示为 0, 1 和 2,请实现 transform_three2two_cate 函数的功能,该函数是一个无参函数,要求将数据集中 label 为 2 的数据进行移除,也就是说仅保留 label 为 0 和为 1 的情况,并且对 label 为 0 和 1 的特征数据进行保留,返回值为 numpy.ndarray 格式的训练特征数据和 label 数据,分别为命名为 new_feat 和 new_label。 然后在此基础上,实现 train_and_evaluate 功能,并使用生成的 new_feat 和 new_label 数据集进行二分类训练,限定机器学习分类器只能从逻辑回归和决策树中进行选择,将训练数据和测试数据按照 8:2 的比例进行分割。 要求输出测试集上的 accuracy_score,同时要求 accuracy_score 要不小于 0.95。 4、code #导入numpy库,它是一个提供了多维数组和矩阵运算等功能的Python库 import numpy as np #导入sklearn库中的datasets模块,它提供了一些内置的数据集 from sklearn import datasets #导入sklearn库中的model_selection模块,它提供了一些用于模型选择和评估的工具,比如划分训练集和测试集 from sklearn.model_selection import train_test_split #导入sklearn库中的preprocessing模块,它提供了一些用于数据预处理的工具,比如归一化 from sklearn.preprocessing import MinMaxScaler #导入sklearn库中的linear_model模块,它提供了一些线性模型,比如逻辑回归 from sklearn.linear_model import LogisticRegression #导入sklearn库中的metrics模块,它提供了一些用于评估模型性能的指标,比如F1分数、ROC曲线面积、准确率等 from sklearn.metrics import f1_score,roc_auc_score,accuracy_score #导入sklearn库中的tree模块,它提供了一些树形模型,比如决策树 from sklearn.tree import DecisionTreeClassifier #定义一个函数transform_three2two_cate,它的作用是将鸢尾花数据集中的三分类问题转化为二分类问题 def transform_three2two_cate(): #从datasets模块中加载鸢尾花数据集,并赋值给data变量 data = datasets.load_iris() #其中data特征数据的key为data,标签数据的key为target #需要取出原来的特征数据和标签数据,移除标签为2的label和特征数据,返回值new_feat为numpy.ndarray格式特征数据,new_label为对应的numpy.ndarray格式label数据 #需要注意特征和标签的顺序一致性,否则数据集将混乱 #code start here #使用numpy库中的where函数找出标签为2的索引,并赋值给index_arr变量 index_arr = np.where(data.target == 2)[0] #使用numpy库中的delete函数删除特征数据中对应索引的行,并赋值给new_feat变量 new_feat = np.delete(data.data, index_arr, 0) #使用numpy库中的delete函数删除标签数据中对应索引的元素,并赋值给new_label变量 new_label = np.delete(data.target, index_arr) #code end here #返回新的特征数据和标签数据 return new_feat,new_label #定义一个函数train_and_evaluate,它的作用是用决策树分类器来训练和评估鸢尾花数据集 def train_and_evaluate(): #调用transform_three2two_cate函数,得到新的特征数据和标签数据,并赋值给data_X和data_Y变量 data_X,data_Y = transform_three2two_cate() #使用train_test_split函数,将数据集划分为训练集和测试集,其中测试集占20%,并赋值给train_x,test_x,train_y,test_y变量 train_x,test_x,train_y,test_y = train_test_split(data_X,data_Y,test_size = 0.2) #已经划分好训练集和测试集,接下来请实现对数据的训练 #code start here #创建一个决策树分类器的实例,并赋值给estimator变量 estimator = DecisionTreeClassifier() #使用fit方法,用训练集的特征和标签来训练决策树分类器 estimator.fit(train_x, train_y) #使用predict方法,用测试集的特征来预测标签,并赋值给y_predict变量 y_predict = estimator.predict(test_x) #code end here #注意模型预测的label需要定义为 y_predict,格式为list或numpy.ndarray #使用accuracy_score函数,计算测试集上的准确率分数,并打印出来 print(accuracy_score(y_predict,test_y)) #如果这个文件是作为主程序运行,则执行以下代码 if __name__ == "__main__": #调用train_and_evaluate函数 train_and_evaluate() #要求执行train_and_evaluate()后输出为: #1、{0,1},代表数据label为0和1 #2、测试集上的准确率分数,要求>0.95
机器学习
# 机器学习
# Python
刘航宇
3年前
0
616
0
2023-07-19
嵌入式软件-基于C语言小端转大端
摘要本文介绍了嵌入式系统中大端小端转换的意义,并提供了四种基于C语言的实现方法,包括使用char指针、union联合体、按位操作和宏函数,以将小端模式的整数转换为大端模式。关键词:嵌入式软件,C语言,字节序转换,大端小端,网络通信意义 题目 示例 解答1.char指针,按字节替换 2.利用union联合体共用内存空间特性,使用char数组来改变 3. 使用按位与运算保留以获取每个字节,然后按位左移到正确位置并拼接 4. 使用预定义好的宏函数 意义 大端小端转化对嵌入式系统有意义,因为不同的处理器或者通信协议可能采用不同的字节序来存储或者传输数据。字节序是指一个多字节数据在内存中的存放顺序,它有两种主要的形式: 大端:最高有效位(MSB)存放在最低的内存地址,最低有效位(LSB)存放在最高的内存地址。 小端:最低有效位(LSB)存放在最低的内存地址,最高有效位(MSB)存放在最高的内存地址。 例如,一个32位的整数0x12345678,在大端系统中,它的内存布局是: pC703EF.png图片 而在小端系统中,它的内存布局是: pC70G4J.png图片 如果一个嵌入式系统需要和不同字节序的设备或者网络进行交互,就需要进行字节序的转换,否则会导致数据错误或者通信失败。例如,TCP/IP协议族中的所有层都采用大端字节序来表示数据包头中的16位或32位的值,如IP地址、包长、校验和等。如果一个嵌入式系统使用小端字节序的处理器,并且想要建立一个TCP连接,就需要将IP地址等信息从小端转换为大端再发送出去,否则对方无法正确解析。 题目 输入一个数字n,假设它是以小端模式保存在机器的,请将其转换为大端方式保存时的值。 示例 输入:1 返回值:16777216 解答 1.char指针,按字节替换 /* * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here int tmp = 0x00000000; //开辟新的int空间用于接收转化结果 unsigned char *p = &tmp, *q = &n; p[0] = q[3]; p[1] = q[2]; p[2] = q[1]; p[3] = q[0]; return tmp; }2.利用union联合体共用内存空间特性,使用char数组来改变 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ typedef union { int i; unsigned char c[4] } inc_u; int convert(int n ) { // write code here inc_u x; //这里也可以用新开辟空间进行置换 x.i = n; //利用按位异或运算可叠加、可还原性 x.c[0] ^= x.c[3], x.c[3] ^= x.c[0], x.c[0] ^= x.c[3]; //首尾两字节对调 x.c[1] ^= x.c[2], x.c[2] ^= x.c[1], x.c[1] ^= x.c[2]; //中间两字节对调 return x.i; /* 按位<<到正确位置,并用|拼装 return (x.c[0]<<24)|(x.c[1]<<16)|(x.c[2]<<8)|x.c[3]; */ }3. 使用按位与运算保留以获取每个字节,然后按位左移到正确位置并拼接 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here return (((n & 0xff000000)>>24) | ((n & 0x00ff0000)>>8 ) | ((n & 0x0000ff00)<<8 ) | ((n & 0x000000ff)<<24); //按位与时,遇0清零,遇1保留 ); }4. 使用预定义好的宏函数 本条方法参考 https://www.codeproject.com/Articles/4804/Basic-concepts-on-Endianness 文中提到网络上常用的套接字接口(socket API)指定了一种称为网络字节顺序的标准字节顺序,这个顺序其实就是大端模式;而当时,同时代的 x86 系列主机反而是小端模式。所以就促使产生了如: ntohs() convert Network order TO Host order in Short (16 bit 大转小); ntohl() convert Network order TO Host order in Long (32 bit 大转小); htons() convert Host order TO Network order in Short (16 bit 小转大); htonl() convert Host order TO Network order in Long (32 bit 小转大). 所以我们这里使用 32 bit 小转大的 htonl() 宏函数来解决这个问题。 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here return htonl(n); ); }
嵌入式&系统
编程&脚本笔记
# 嵌入式
# C/C++
刘航宇
3年前
0
673
1
【转载】Libero SOC Debug教程-片上逻辑分析仪IDENTIFY
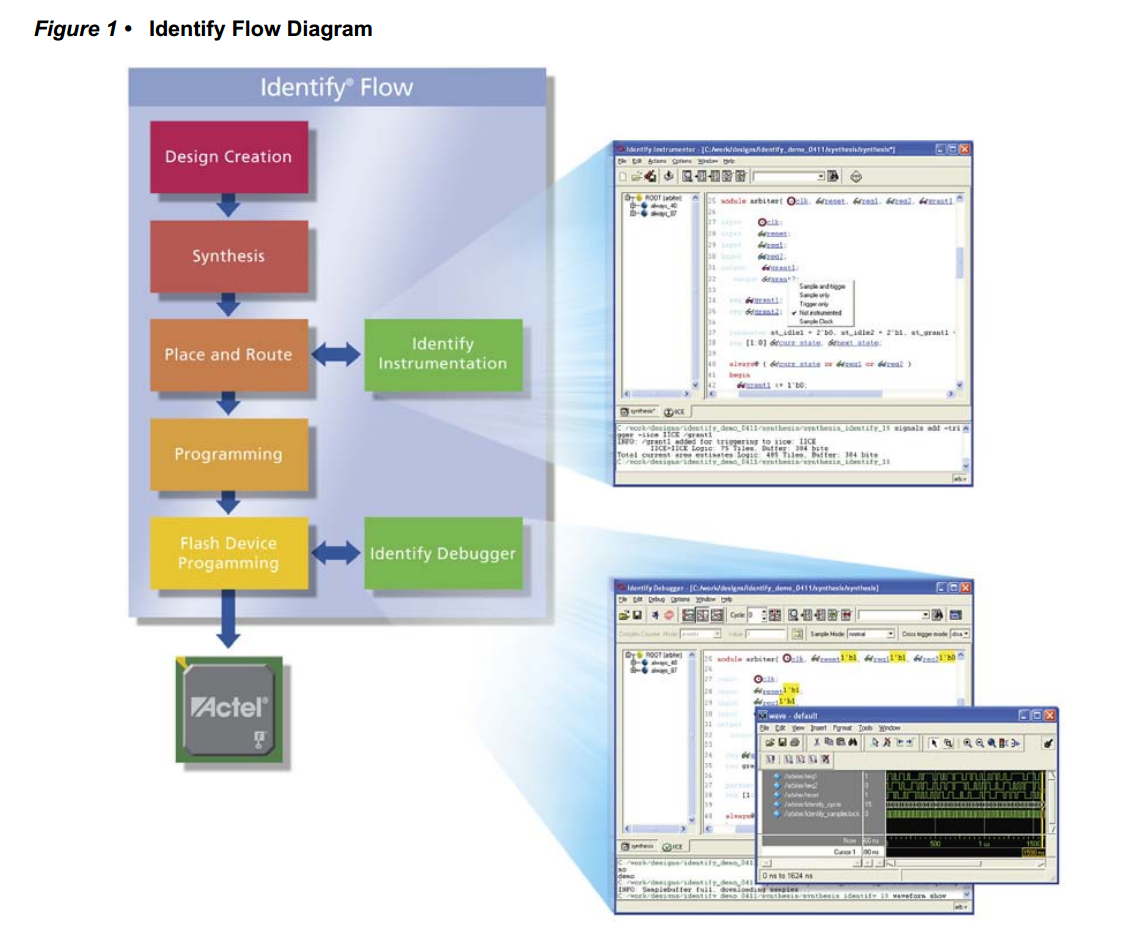
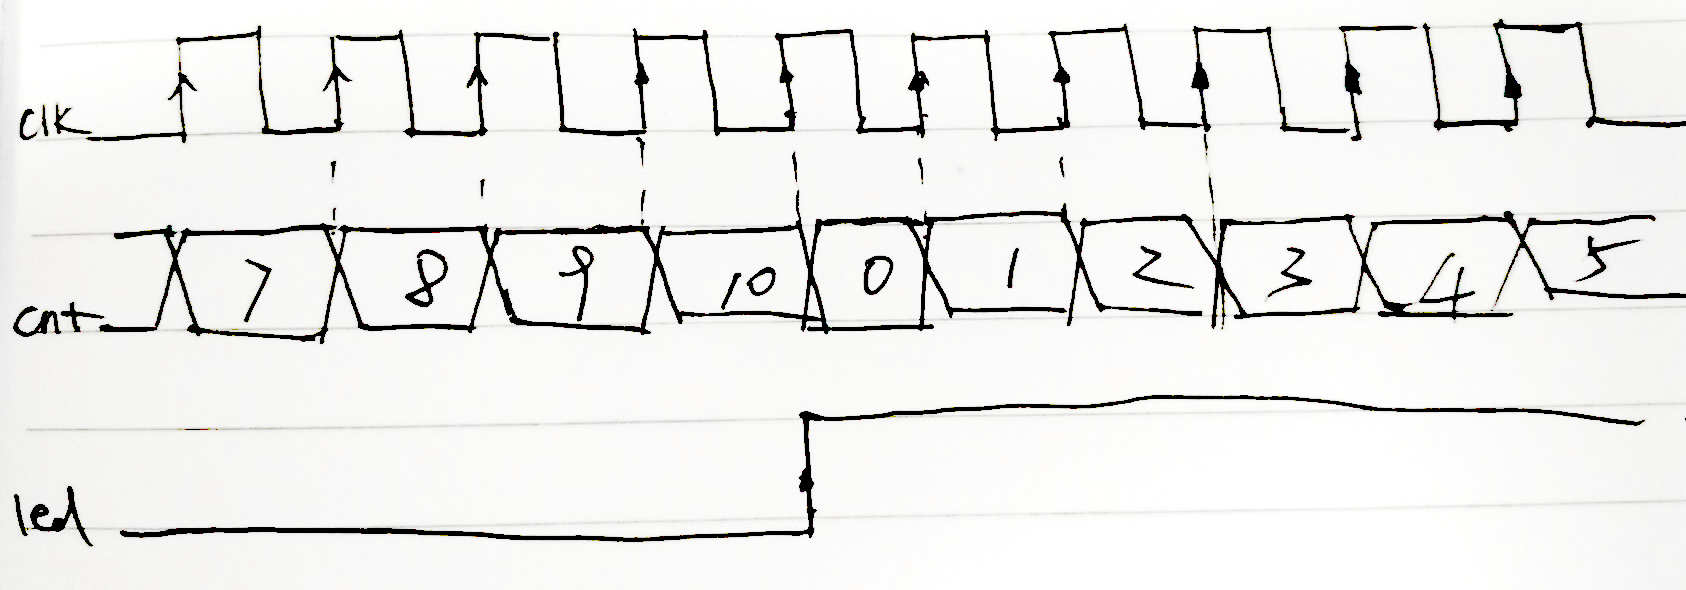
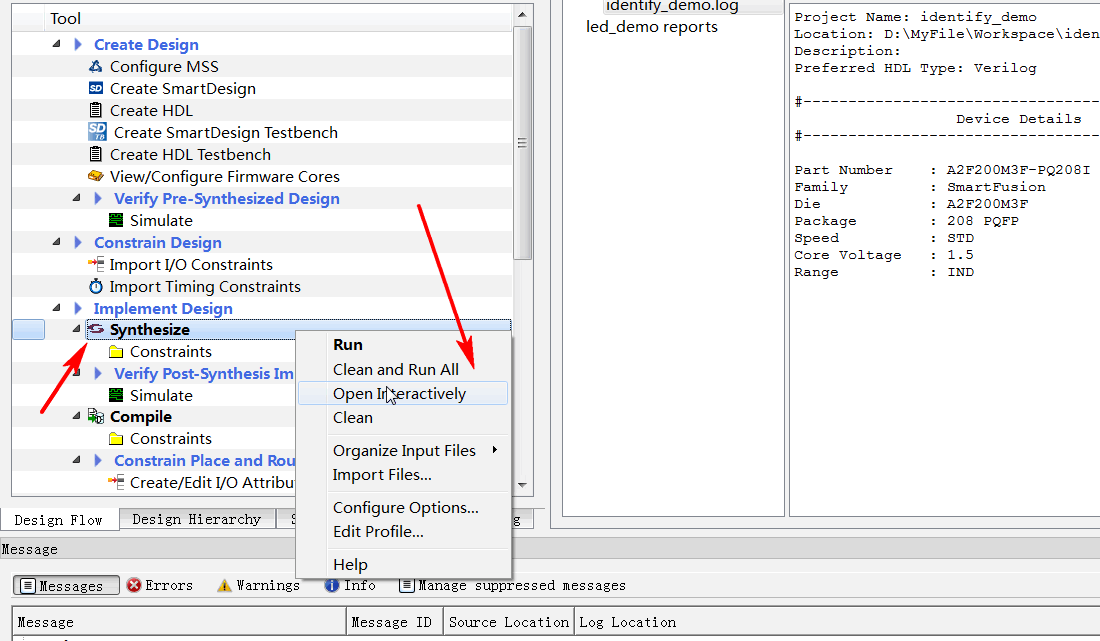
摘要本文介绍了Microsemi FPGA片上逻辑分析仪Identify的使用方法,包括原理、配置步骤和资源占用情况,适用于FPGA工程师进行硬件级程序调试。关键词:FPGA调试, 片上逻辑分析仪, Libero SoC, Identify工具, 逻辑资源本文转载于https://blog.csdn.net/whik1194/article/details/107074187 FPGA在线调试 关于MICROSEMI片上逻辑分析仪 FPGA片上逻辑分析仪原理 预期效果 0.准备一个创建好的LIBERO工程 1.新建IDENTIFY工程,并添加想要监测的信号 2.管脚分配,编译下载 3.设置触发类型 4.IICE逻辑分析仪核资源占用 原文: 参考: FPGA在线调试 对于嵌入式系统来说,如单片机,进行硬件级程序调试时,通常采用的是JLink/ST-Link调试器,在线调试的方式来获取程序实时运行的状态,可以观察程序运行流程、各种变量的值、中断的触发情况,还可以设置断点、单步运行,方便快速的发现BUG,解决问题。 但是对于FPGA来说,并不是顺序执行的,而是根据每一个Clk并行执行,所以我们不能使用调试器进行单步调试。 FPGA调试需要观察内部信号的值,各个信号之间的时序关系,所以使用逻辑分析仪是最好的调试方式了。 有些FPGA工程,对外的接口,即输入输出,可能只有几个,但是他们之间的逻辑和时序关系非常复杂,所以内部有几十个中间寄存器,程序下载进去了,发现不是我们想要的效果,怎么办?你可能会说,查代码吧!如果这个工程非常简单,你可能只需要耗费几分钟或者几个小时就可以定位代码的问题所在。 但是如果这是一个非常庞大的工程,内部的中间寄存器、信号,几百上千个,各个模块单独软件仿真都正常,整体仿真也正常,就是下载到实际的芯片中运行不正常。你如何进行问题定位?如果再去进行代码审查,这将会消耗非常多的时间。那么如果能在FPGA芯片内部装上一个逻辑分析仪,那不就直接可以看到内部信号的值了,而且还可以看到各个信号之间的时序关系。需求推动技术发展,既然开发者有这个需求,那么FPGA厂商肯定会实现这个功能!下面来一起看一下Microsemi FPGA片上逻辑分析仪的使用方法吧! 关于MICROSEMI片上逻辑分析仪 几大厂商的片上逻辑分析仪: Xilinx厂商ISE开发环境下的ChipScope工具 Altera厂商Quartus开发环境下的SignalTap工具 Lattice厂商Diamod开发环境下的Reveal工具 对于 FPGA 工程师来说,这些都是很熟悉的名字。和以上几大FPGA厂商一样,Microsemi Libero也支持片上逻辑分析仪工具,只不过不是自己家研发的,使用的是Synospsy公司出品的Identify工具,其实,Libero中的综合器synplify也是Synospsy公司的。 根据Synospsy官网的描述:Identify RTL 调试仪,这个调试工具除了支持Microsemi的FPGA产品外,还支持Altera和Xilinx的FPGA产品。 FPGA片上逻辑分析仪原理 Identify片上逻辑分析仪的原理,是通过在FPGA工程中加入一个IICE逻辑分析仪IP核,这个IP核,由控制器和采集器组成,采集器用于采集信号,控制器用于和JTAG调试器连接,并把数据发送到上位机,IICE内部有RAM空间,用于存储触发位置附近的信号,RAM空间的大小,即采样深度,可以自己调整。FPGA工程中加入IICE核,会占用一定的资源,资源占用的大小取决于:采样深度,采样信号的个数,采样信号的触发方式等。 所以综上,FPGA片上逻辑分析仪需要3个组件:片上的IICE逻辑分析仪核、JTAG下载器、上位机。 pC5Uq6e.png图片 JTAG下载器也就是我们下载程序时使用的FlashPro x下载器,上位机软件也就是Identify工具,这个工具已经在安装Libero SoC时一同安装并注册**了。所以不需要安装其他的工具软件,只需要在已经设计好的FPGA公司中,配置一下IIC逻辑分析仪核就可以了。 在已经创建好的Libero工程中,加入IICE逻辑分析仪核,并演示Identify工具的使用。 预期效果 以Microsemi SmartFusion系列的A2F200M3F芯片为例,其他芯片使用操作方法类似。示例工程功能:led每隔10个clk翻转一次为例,演示identify的使用。 identify添加完成之后,把led设置为上升沿触发,会抓取到类似如下的波形。 pChB2qJ.png图片 0.准备一个创建好的LIBERO工程 这里以LED每隔10个时钟周期翻转为例。HDL文件内容: module led_demo( //inputs input clk, input rst_n, //outputs output reg led ); reg [3:0] cnt; always @ (posedge clk) begin if(!rst_n) cnt <= 0; else if(cnt == 10) /* max=10, 0-10 */ cnt <= 0; else cnt <= cnt + 1; end always @ (posedge clk) begin if(!rst_n) led <= 0; else if(cnt == 10) led <= ~led; end endmodule1.新建IDENTIFY工程,并添加想要监测的信号 1.0 先运行Synthesize 1.1 在Synthesize上右键,选择Open Interactively pChr5jO.png图片 1.2 在Synthesis上右键新建一个Identify工程 pChrTDe.png图片 1.3 输入新建的identify工程的名称和保存路径,选择默认的就行。 pChrqUA.png图片 1.4 在新建的identify工程上右键选择identify instrumentor pChsSKS.png图片 1.5 在HDL文件中选择要监测的信号和采样时钟,采样时钟选择Sample Clock,作为触发的信号选择Trigger Only,要监测的信号选择Sample Only,也可以选择Sample and Trigger,这样会占用更多的资源。 pChsG26.png图片 pChsNrD.png图片 设置完成的信号会有标注 pChsgsS.png图片 sample clock 表示采样时钟,所有在 IICE 中添加的信号都会在 sample clock 的边沿进行采样,设为 sample clock 的信号前会出现一个时钟状的图标。 设置为 sample 和 trigger 的信号都将作为被采样信号,区别在于 sample 信号只能被采样,而 trigger 信号可以作为触发采集的条件,当然你可以把一个信号同时设置为 sample 和 trigger 。 1.6 设置采样深度,选择Instrumentor->IICE pChsWZQ.png图片 采样深度最大支持1048576 pChsfaj.png图片 输入采样深度,数值越大,采样时间越长,相应的FPGA资源占用也越多。 pChsqLF.png图片 1.7 选择Run->Run pChsOZ4.png图片 或者直接点击主界面的Run按钮 pChsjo9.png图片 1.8 编译完成之后,保存退出。 pChsxiR.png图片 2.管脚分配,编译下载 2.1 和正常流程一样,管脚分配,编译下载。可以看到JTAG部分的管脚已经被IICE逻辑分析仪核使用了 pChyiLD.png图片 2.2 在Identify Debug Design上右键,选择Open Interactively,打开identify工具 pChymWt.png图片 3.设置触发类型 3.1 选择要触发的信号,和触发类型,这里我选择的是led,上升沿触发。 pChyYYn.png图片 3.2 连接FlashPro下载器,点击小人图标,启动抓取,满足触发条件自动停止。 pChy6YR.png图片 D:/identify_demo/synthesis$ run -iice {IICE} INFO: run -iice IICE INFO: Info: Attempting to connect to: usb Info: Type: FlashPro4 Info: ID: 08152 Info: Connection: usb2.0 Info: Revision: UndefRev INFO: Checking communication with the Microsemi_BuiltinJTAG cable and the hardware INFO: The hardware is responding correctly INFO: Auto-detecting the device chain INFO: Device at chain position 1 is "A2F200M3F" INFO: IICE 'IICE' configured, waiting for trigger INFO: IICE 'IICE' Trigger detected, downloading samples INFO: notify -notify INFO: waveform viewer INFO: waveform viewer INFO: write vcd -iice IICE -comment {Identify created VCD dump} -gtkwave -noequiv IICE.vcd D:/identify_demo/synthesis$ 3.3 右侧黄色的显示就是触发瞬间时信号的值。右键可以改变数据格式。 pChyO6f.png图片 3.4 选择Debugger preferences可以设置采样时钟的周期,用于后面波形的时间测量 pChyz7Q.png图片 3.5 设置采样时钟的周期 pCh6Chn.png图片 3.6 点击波形按钮,在GTKWave中打开抓取到的波形。 pCh6kcV.png图片 3.7 可以按住左键拖动测量时间差 pCh6uN9.png图片 3.8 还可以给每个通道设置不同的颜色,和显示方式。 pCh6Q91.png图片 4.IICE逻辑分析仪核资源占用 IICE逻辑分析仪核占用的主要是逻辑资源和RAM资源,可以看到资源占用还是很多的。 图片 图片 原文: https://blog.csdn.net/whik1194/article/details/107074187 参考: https://zhuanlan.zhihu.com/p/88314552 https://www.synopsys.com/zh-cn/implementation-and-signoff/fpga-based-design/identify-rtl-debugger.html http://training.eeworld.com.cn/video/1059 https://www.microsemi.com/document-portal/doc_view/132760-synopsys-identify-me-h-2013-03m-sp1-user-guide
嵌入式&系统
FPGA&ASIC
# ASIC/FPGA
# 嵌入式
刘航宇
3年前
2
3,291
3
2023-07-10
Verilog实现AMBA--AHB To APB Bridge
摘要本文介绍了AMBA AHB到APB桥的Verilog实现,包括APB桥的功能、读/写传输过程、背靠背传输以及仿真验证。通过Verilog代码展示了AHB到APB桥的实现方法,并通过仿真验证了其正确性。关键词:Verilog, AMBA, AHB To APB Bridge, APB总线, 仿真1、APB桥 2、读传输 3、写传输 4、背靠背传输 5、AHB_to_APB Bridge的Verilog实现 6、仿真 1、APB桥 APB桥是AMBA APB总线上的唯一主机,也是AMBA AHB的一个从机。下图表示了APB桥接口信号: 图片 APB Bridge将AHB传输转成APB传输并实现一下功能: (1)对锁存的地址进行译码并产生选择信号PSELx,在传输过程中只有一个选择信号可以被激活。 也就是选择出唯一 一个APB从设备以进行读写动作。 (2)写操作时:负责将AHB送来的数据送上APB总线。 (3)读操作时:负责将APB的数据送上AHB系统总线。 (4)产生一时序选通信号PENABLE来作为数据传递时的启动信号 2、读传输 下图表示了APB到AHB的读传输: 图片 传输开始于AHB总线上的T1时刻,在T2时刻地址信息被APB采样,如果传输目标是外设总线,那么这个地址就会被译码成选择信号发给外设,T2即为APB总线的SETUP周期,T3为APB的ENABLE周期,PENABLE信号拉高。在该周期内,外设必须提供读数据,通常情况下,读数据直接AHB读数据总线上,总线主机在T4时刻对读数据进行采样。 在频率很高的情况下,在ENABLE CYCLE中可能数据不能够直接映射到AHB总线,需要在APB桥中在T4的时候打插入一个额外的等待周期,并在T5的时候才被AHB主采样。虽然需要多一个等待周期(一共2个),但是由于频率提升了因此总的性能也提升了。 下图表示了一个读突发传输,所有的传输都只有一个等待周期 图片 3、写传输 下图表示了一个写传输: 图片 APB总线上的单块数据写操作不需要等待周期。 APB桥负责对地址和数据进行采样,并在写操作的过程中保持它们的值。 下图表示了一个写突发传输: 图片 虽然第一个传输可以零等待完成,但后续每一个传输都需要插入一个等待状态。 APB桥需要两个地址寄存器,以便在当前传输进行时,锁存下一次传输的地址。 4、背靠背传输 下图表示了一个背靠背传输,顺序为写、读、写、读: 如果写操作之后跟随着读操作,那么需要 3 个等待周期来完成这个读操作。通常的情况下,不会有读操作之后紧跟着写操作的发生,因为两者之间 CPU 会进行指令读取,并且指令存储器也不太可能挂在在APB总线上。 图片 下面以ARM DesignStart项目提供的软件包里的AHB转APB桥的代码,对其进行学习与仿真,以深入理解APB桥的实现方法,该转换桥比较简单,实现的是一对一的转换,也可以配合APB slave multiplexer模块,实现一对多的方式(主要依靠APB高位地址译码得到各个从机的PSEL信号)。如果想学习APB系统总线,可以参考Synopsys公司的DW_APB IP,该IP最多可支持16个APB从机,并支持所有的突发传输类型。 5、AHB_to_APB Bridge的Verilog实现 `timescale 1ns / 1ps module ahb_to_apb #( // Parameter to define address width // 16 = 2^16 = 64KB APB address space parameter ADDRWIDTH = 16, parameter REGISTER_RDATA = 1, parameter REGISTER_WDATA = 0 ) ( //---------------------------------- // IO Declarations //---------------------------------- input wire HCLK, // Clock input wire HRESETn, // Reset input wire PCLKEN, // APB clock enable signal input wire HSEL, // Device select input wire [ADDRWIDTH-1:0] HADDR, // Address input wire [1:0] HTRANS, // Transfer control input wire [2:0] HSIZE, // Transfer size input wire [3:0] HPROT, // Protection control input wire HWRITE, // Write control input wire HREADY, // Transfer phase done input wire [31:0] HWDATA, // Write data output reg HREADYOUT, // Device ready output wire [31:0] HRDATA, // Read data output output wire HRESP, // Device response // APB Output output wire [ADDRWIDTH-1:0] PADDR, // APB Address output wire PENABLE, // APB Enable output wire PWRITE, // APB Write output wire [3:0] PSTRB, // APB Byte Strobe output wire [2:0] PPROT, // APB Prot output wire [31:0] PWDATA, // APB write data output wire PSEL, // APB Select output wire APBACTIVE, // APB bus is active, for clock gating of APB bus // APB Input input wire [31:0] PRDATA, // Read data for each APB slave input wire PREADY, // Ready for each APB slave input wire PSLVERR // Error state for each APB slave ); //---------------------------------- // Variable Declarations //---------------------------------- reg [ADDRWIDTH-3:0] addr_reg; // Address sample register reg wr_reg; // Write control sample register reg [2:0] state_reg; // State for finite state machine reg [3:0] pstrb_reg; // Byte lane strobe register wire [3:0] pstrb_nxt; // Byte lane strobe next state reg [1:0] pprot_reg; // PPROT register wire [1:0] pprot_nxt; // PPROT register next state wire apb_select; // APB bridge is selected wire apb_tran_end; // Transfer is completed on APB reg [2:0] next_state; // Next state for finite state machine reg [31:0] rwdata_reg; // Read/Write data sample register wire reg_rdata_cfg; // REGISTER_RDATA paramater wire reg_wdata_cfg; // REGISTER_WDATA paramater reg sample_wdata_reg; // Control signal to sample HWDATA //---------------------------------- // Local Parameter Declarations //---------------------------------- // State machine localparam ST_BITS = 3; localparam [ST_BITS-1:0] ST_IDLE = 3'b000; // Idle waiting for transaction localparam [ST_BITS-1:0] ST_APB_WAIT = 3'b001; // Wait APB transfer localparam [ST_BITS-1:0] ST_APB_TRNF = 3'b010; // Start APB transfer localparam [ST_BITS-1:0] ST_APB_TRNF2 = 3'b011; // Second APB transfer cycle localparam [ST_BITS-1:0] ST_APB_ENDOK = 3'b100; // Ending cycle for OKAY localparam [ST_BITS-1:0] ST_APB_ERR1 = 3'b101; // First cycle for Error response localparam [ST_BITS-1:0] ST_APB_ERR2 = 3'b110; // Second cycle for Error response localparam [ST_BITS-1:0] ST_ILLEGAL = 3'b111; // Illegal state //---------------------------------- // Start of Main Code //---------------------------------- // Configuration signal assign reg_rdata_cfg = (REGISTER_RDATA == 0) ? 1'b0 : 1'b1; assign reg_wdata_cfg = (REGISTER_WDATA == 0) ? 1'b0 : 1'b1; // Generate APB bridge select assign apb_select = HSEL & HTRANS[1] & HREADY; // Generate APB transfer ended assign apb_tran_end = (state_reg == 3'b011) & PREADY; assign pprot_nxt[0] = HPROT[1]; // (0) Normal, (1) Privileged assign pprot_nxt[1] = ~HPROT[0]; // (0) Data, (1) Instruction // Byte strobe generation // - Only enable for write operations // - For word write transfers (HSIZE[1]=1), all byte strobes are 1 // - For hword write transfers (HSIZE[0]=1), check HADDR[1] // - For byte write transfers, check HADDR[1:0] assign pstrb_nxt[0] = HWRITE & ((HSIZE[1])|((HSIZE[0])&(~HADDR[1]))|(HADDR[1:0]==2'b00)); assign pstrb_nxt[1] = HWRITE & ((HSIZE[1])|((HSIZE[0])&(~HADDR[1]))|(HADDR[1:0]==2'b01)); assign pstrb_nxt[2] = HWRITE & ((HSIZE[1])|((HSIZE[0])&( HADDR[1]))|(HADDR[1:0]==2'b10)); assign pstrb_nxt[3] = HWRITE & ((HSIZE[1])|((HSIZE[0])&( HADDR[1]))|(HADDR[1:0]==2'b11)); // Sample control signals always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) begin addr_reg <= {(ADDRWIDTH-2){1'b0}}; wr_reg <= 1'b0; pprot_reg <= {2{1'b0}}; pstrb_reg <= {4{1'b0}}; end else if (apb_select) begin // Capture transfer information at the end of AHB address phase addr_reg <= HADDR[ADDRWIDTH-1:2]; wr_reg <= HWRITE; pprot_reg <= pprot_nxt; pstrb_reg <= pstrb_nxt; end end // Sample write data control signal // Assert after write address phase, deassert after PCLKEN=1 wire sample_wdata_set = apb_select & HWRITE & reg_wdata_cfg; wire sample_wdata_clr = sample_wdata_reg & PCLKEN; always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) sample_wdata_reg <= 1'b0; else if (sample_wdata_set | sample_wdata_clr) sample_wdata_reg <= sample_wdata_set; end // Generate next state for FSM // Note : case 3'b111 is not used. The design has been checked that // this illegal state cannot be entered using formal verification. always @(state_reg or PREADY or PSLVERR or apb_select or reg_rdata_cfg or PCLKEN or reg_wdata_cfg or HWRITE) begin case (state_reg) // Idle ST_IDLE : begin if (PCLKEN & apb_select & ~(reg_wdata_cfg & HWRITE)) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else if (apb_select) next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high else next_state = ST_IDLE; // Remain idle end // Transfer announced on AHB, but PCLKEN was low, so waiting ST_APB_WAIT : begin if (PCLKEN) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high end // First APB transfer cycle ST_APB_TRNF : begin if (PCLKEN) next_state = ST_APB_TRNF2; // Change to second cycle of APB transfer else next_state = ST_APB_TRNF; // Change to state-2 end // Second APB transfer cycle ST_APB_TRNF2 : begin if (PREADY & PSLVERR & PCLKEN) // Error received - Generate two cycle // Error response on AHB by next_state = ST_APB_ERR1; // Changing to state-5 and 6 else if (PREADY & (~PSLVERR) & PCLKEN) begin // Okay received if (reg_rdata_cfg) // Registered version next_state = ST_APB_ENDOK; // Generate okay response in state 4 else // Non-registered version next_state = {2'b00, apb_select}; // Terminate transfer end else // Slave not ready next_state = ST_APB_TRNF2; // Unchange end // Ending cycle for OKAY (registered response) ST_APB_ENDOK : begin if (PCLKEN & apb_select & ~(reg_wdata_cfg & HWRITE)) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else if (apb_select) next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high else next_state = ST_IDLE; // Remain idle end // First cycle for Error response ST_APB_ERR1 : next_state = ST_APB_ERR2; // Goto 2nd cycle of error response // Second cycle for Error response ST_APB_ERR2 : begin if (PCLKEN & apb_select & ~(reg_wdata_cfg & HWRITE)) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else if (apb_select) next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high else next_state = ST_IDLE; // Remain idle end default : // Not used next_state = 3'bxxx; // X-Propagation endcase end // Registering state machine always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) state_reg <= 3'b000; else state_reg <= next_state; end // Sample PRDATA or HWDATA always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) rwdata_reg <= {32{1'b0}}; else if (sample_wdata_reg & reg_wdata_cfg & PCLKEN) rwdata_reg <= HWDATA; else if (apb_tran_end & reg_rdata_cfg & PCLKEN) rwdata_reg <= PRDATA; end // Connect outputs to top level assign PADDR = {addr_reg, 2'b00}; // from sample register assign PWRITE = wr_reg; // from sample register // From sample register or from HWDATA directly assign PWDATA = (reg_wdata_cfg) ? rwdata_reg : HWDATA; assign PSEL = (state_reg == ST_APB_TRNF) | (state_reg == ST_APB_TRNF2); assign PENABLE = (state_reg == ST_APB_TRNF2); assign PPROT = {pprot_reg[1], 1'b0, pprot_reg[0]}; assign PSTRB = pstrb_reg[3:0]; // Generate HREADYOUT always @(state_reg or reg_rdata_cfg or PREADY or PSLVERR or PCLKEN) begin case (state_reg) ST_IDLE : HREADYOUT = 1'b1; // Idle ST_APB_WAIT : HREADYOUT = 1'b0; // Transfer announced on AHB, but PCLKEN was low, so waiting ST_APB_TRNF : HREADYOUT = 1'b0; // First APB transfer cycle // Second APB transfer cycle: // if Non-registered feedback version, and APB transfer completed without error // Then response with ready immediately. If registered feedback version, // wait until state_reg == ST_APB_ENDOK ST_APB_TRNF2 : HREADYOUT = (~reg_rdata_cfg) & PREADY & (~PSLVERR) & PCLKEN; ST_APB_ENDOK : HREADYOUT = reg_rdata_cfg; // Ending cycle for OKAY (registered response only) ST_APB_ERR1 : HREADYOUT = 1'b0; // First cycle for Error response ST_APB_ERR2 : HREADYOUT = 1'b1; // Second cycle for Error response default : HREADYOUT = 1'bx; // x propagation (note :3'b111 is illegal state) endcase end // From sample register or from PRDATA directly assign HRDATA = (reg_rdata_cfg) ? rwdata_reg : PRDATA; assign HRESP = (state_reg == ST_APB_ERR1) | (state_reg == ST_APB_ERR2); assign APBACTIVE = (HSEL & HTRANS[1]) | (|state_reg); endmodule使用的测试用例和AHB从机的测试用例基本一样,首先是顶层: `timescale 1ns / 1ps module top_tb(); //---------------------------------- // Local Parameter Declarations //---------------------------------- localparam AHB_CLK_PERIOD = 5; // Assuming AHB CLK to be 100MHz localparam SIZE_IN_BYTES = 2048; localparam ADDRWIDTH = 32; //---------------------------------- // Variable Declarations //---------------------------------- reg HCLK = 0; wire HWRITE; wire [1:0] HTRANS; wire [2:0] HSIZE; wire [2:0] HBURST; wire HREADYIN; wire [31:0] HADDR; wire [3:0] HPROT; wire [31:0] HWDATA; wire HREADYOUT; wire [1:0] HRESP; wire [31:0] HRDATA; reg HRESETn; wire HREADY; wire [ADDRWIDTH-1:0] PADDR; // APB Address wire PENABLE; // APB Enable wire PWRITE; // APB Write wire [31:0] PWDATA; // APB write data wire PSEL; // APB Select wire PREADY; wire PSLVERR; wire [2:0] PPROT; wire [3:0] PSTRB; wire [31:0] PRDATA; //---------------------------------- // Start of Main Code //---------------------------------- assign HREADY = HREADYOUT; //----------------------------------------------------------------------- // Generate HCLK //----------------------------------------------------------------------- always #AHB_CLK_PERIOD HCLK <= ~HCLK; //----------------------------------------------------------------------- // Generate HRESETn //----------------------------------------------------------------------- initial begin HRESETn = 1'b0; repeat(5) @(posedge HCLK); HRESETn = 1'b1; end ahb_master #( .START_ADDR (32'h0), .DEPTH_IN_BYTES (SIZE_IN_BYTES) ) u_ahb_master ( .HRESETn (HRESETn), .HCLK (HCLK), .HADDR (HADDR), .HPROT (HPROT), .HTRANS (HTRANS), .HWRITE (HWRITE), .HSIZE (HSIZE), .HBURST (HBURST), .HWDATA (HWDATA), .HRDATA (HRDATA), .HRESP (HRESP), .HREADY (HREADYOUT) ); ahb_to_apb #( .ADDRWIDTH (ADDRWIDTH), .REGISTER_RDATA (0), .REGISTER_WDATA (0) ) u_ahb_to_apb( .HCLK (HCLK), .HRESETn (HRESETn), .PCLKEN (1'b1), .HSEL (1'b1), .HADDR (HADDR), .HTRANS (HTRANS), .HSIZE (HSIZE), .HPROT (HPROT), .HWRITE (HWRITE), .HREADY (HREADY), .HWDATA (HWDATA), .HREADYOUT (HREADYOUT), .HRDATA (HRDATA), .HRESP (HRESP), .PADDR (PADDR), .PENABLE (PENABLE), .PWRITE (PWRITE), .PREADY (PREADY), .PSLVERR (PSLVERR), .PSTRB (PSTRB), .PPROT (PPROT), .PWDATA (PWDATA), .PSEL (PSEL), .APBACTIVE (APBACTIVE), .PRDATA (PRDATA) ); apb_mem #( .P_SLV_ID (0), .ADDRWIDTH (ADDRWIDTH), .P_SIZE_IN_BYTES (SIZE_IN_BYTES), .P_DELAY (0) ) u_apb_mem ( `ifdef AMBA_APB3 .PREADY (PREADY), .PSLVERR (PSLVERR), `endif `ifdef AMBA_APB4 .PSTRB (PSTRB), .PPROT (PPROT), `endif .PRESETn (HRESETn), .PCLK (HCLK), .PSEL (PSEL), .PENABLE (PENABLE), .PADDR (PADDR), .PWRITE (PWRITE), .PRDATA (PRDATA), .PWDATA (PWDATA) ); `ifdef VCS initial begin $fsdbDumpfile("top_tb.fsdb"); $fsdbDumpvars; end initial begin `ifdef DUMP_VPD $vcdpluson(); `endif end `endif endmodule然后是AHB master的功能模型: `timescale 1ns / 1ps `define SINGLE_TEST `define BURST_TEST module ahb_master #( //---------------------------------- // Paramter Declarations //---------------------------------- parameter START_ADDR = 0, parameter DEPTH_IN_BYTES = 32'h100, parameter END_ADDR = START_ADDR+DEPTH_IN_BYTES-1 ) ( //---------------------------------- // IO Declarations //---------------------------------- input wire HRESETn, input wire HCLK, output reg [31:0] HADDR, output reg [1:0] HTRANS, output reg HWRITE, output reg [2:0] HSIZE, output reg [2:0] HBURST, output reg [3:0] HPROT, output reg [31:0] HWDATA, input wire [31:0] HRDATA, input wire [1:0] HRESP, input wire HREADY ); //---------------------------------- // Variable Declarations //---------------------------------- reg [31:0] data_burst[0:1023]; //---------------------------------- // Start of Main Code //---------------------------------- initial begin HADDR = 0; HTRANS = 0; HPROT = 0; HWRITE = 0; HSIZE = 0; HBURST = 0; HWDATA = 0; while(HRESETn === 1'bx) @(posedge HCLK); while(HRESETn === 1'b1) @(posedge HCLK); while(HRESETn === 1'b0) @(posedge HCLK); `ifdef SINGLE_TEST repeat(3) @(posedge HCLK); memory_test(START_ADDR, END_ADDR, 1); memory_test(START_ADDR, END_ADDR, 2); memory_test(START_ADDR, END_ADDR, 4); `endif `ifdef BURST_TEST repeat(5) @(posedge HCLK); memory_test_burst(START_ADDR, END_ADDR, 1); memory_test_burst(START_ADDR, END_ADDR, 2); memory_test_burst(START_ADDR, END_ADDR, 4); memory_test_burst(START_ADDR, END_ADDR, 6); memory_test_burst(START_ADDR, END_ADDR, 8); memory_test_burst(START_ADDR, END_ADDR, 10); memory_test_burst(START_ADDR, END_ADDR, 16); memory_test_burst(START_ADDR, END_ADDR, 32); memory_test_burst(START_ADDR, END_ADDR, 64); memory_test_burst(START_ADDR, END_ADDR, 128); memory_test_burst(START_ADDR, END_ADDR, 255); repeat(5) @(posedge HCLK); `endif $finish(2); end //----------------------------------------------------------------------- // Single transfer test //----------------------------------------------------------------------- task memory_test; input [31:0] start; // start address input [31:0] finish; // end address input [2:0] size; // data size: 1, 2, 4 integer i; integer error; reg [31:0] data; reg [31:0] gen; reg [31:0] got; reg [31:0] reposit[START_ADDR:END_ADDR]; begin $display("%m: read-after-write test with %d-byte access", size); error = 0; gen = $random(7); for (i = start; i < (finish-size+1); i = i + size) begin gen = $random & ~32'b0; data = align(i, gen, size); ahb_write(i, size, data); ahb_read(i, size, got); got = align(i, got, size); if (got !== data) begin $display("[%10d] %m A:%x D:%x, but %x expected", $time, i, got, data); error = error + 1; end end if (error == 0) $display("[%10d] %m OK: from %x to %x", $time, start, finish); $display("%m read-all-after-write-all with %d-byte access", size); error = 0; gen = $random(1); for (i = start; i < (finish-size+1); i = i + size) begin gen = {$random} & ~32'b0; data = align(i, gen, size); reposit[i] = data; ahb_write(i, size, data); end for (i = start; i < (finish-size+1); i = i + size) begin data = reposit[i]; ahb_read(i, size, got); got = align(i, got, size); if (got !== data) begin $display("[%10d] %m A:%x D:%x, but %x expected", $time, i, got, data); error = error + 1; end end if (error == 0) $display("[%10d] %m OK: from %x to %x", $time, start, finish); end endtask //----------------------------------------------------------------------- // Burst transfer test //----------------------------------------------------------------------- task memory_test_burst; input [31:0] start; // start address input [31:0] finish; // end address input [7:0] leng; // burst length integer i; integer j; integer k; integer r; integer error; reg [31:0] data; reg [31:0] gen; reg [31:0] got; reg [31:0] reposit[0:1023]; integer seed; begin $display("[%10d] %m: read-all-after-write-all burst test with %d-beat access", $time, leng); error = 0; seed = 111; gen = $random(seed); k = 0; if (finish > (start+leng*4)) begin for (i = start; i < (finish-(leng*4)+1); i = i + leng*4) begin for (j = 0; j < leng; j = j + 1) begin data_burst[j] = $random; reposit[j+k*leng] = data_burst[j]; end @(posedge HCLK); ahb_write_burst(i, leng); k = k + 1; end gen = $random(seed); k = 0; for (i = start; i < (finish-(leng*4)+1); i = i + leng*4) begin @(posedge HCLK); ahb_read_burst(i, leng); for (j = 0; j < leng; j = j + 1) begin if (data_burst[j] != reposit[j+k*leng]) begin error = error+1; $display("[%10d] %m A=%hh D=%hh, but %hh expected", $time, i+j*leng, data_burst[j], reposit[j+k*leng]); end end k = k + 1; r = $random & 8'h0F; repeat(r) @(posedge HCLK); end if (error == 0) $display("%m %d-length burst read-after-write OK: from %hh to %hh",leng, start, finish); end else begin $display("%m %d-length burst read-after-write from %hh to %hh ???",leng, start, finish); end end endtask //----------------------------------------------------------------------- // As AMBA AHB bus uses non-justified data bus scheme, data should be // aligned according to the address. //----------------------------------------------------------------------- function [31:0] align; input [ 1:0] addr; input [31:0] data; input [ 2:0] size; // num of bytes begin `ifdef BIG_ENDIAN case (size) 1 : case (addr[1:0]) 0 : align = data & 32'hFF00_0000; 1 : align = data & 32'h00FF_0000; 2 : align = data & 32'h0000_FF00; 3 : align = data & 32'h0000_00FF; endcase 2 : case (addr[1]) 0 : align = data & 32'hFFFF_0000; 1 : align = data & 32'h0000_FFFF; endcase 4 : align = data&32'hFFFF_FFFF; default : $display($time,,"%m ERROR %d-byte not supported for size", size); endcase `else case (size) 1 : case (addr[1:0]) 0 : align = data & 32'h0000_00FF; 1 : align = data & 32'h0000_FF00; 2 : align = data & 32'h00FF_0000; 3 : align = data & 32'hFF00_0000; endcase 2 : case (addr[1]) 0 : align = data & 32'h0000_FFFF; 1 : align = data & 32'hFFFF_0000; endcase 4 : align = data&32'hFFFF_FFFF; default : $display($time,,"%m ERROR %d-byte not supported for size", size); endcase `endif end endfunction `include "ahb_transaction_tasks.v" endmoduleahb_transaction_tasks.v文件如下: `ifndef __AHB_TRANSACTION_TASKS_V__ `define __AHB_TRANSACTION_TASKS_V__ //----------------------------------------------------------------------- // AHB Read Task //----------------------------------------------------------------------- task ahb_read; input [31:0] address; input [2:0] size; output [31:0] data; begin @(posedge HCLK); HADDR <= #1 address; HPROT <= #1 4'b0001; // DATA HTRANS <= #1 2'b10; // NONSEQ; HBURST <= #1 3'b000; // SINGLE; HWRITE <= #1 1'b0; // READ; case (size) 1 : HSIZE <= #1 3'b000; // BYTE; 2 : HSIZE <= #1 3'b001; // HWORD; 4 : HSIZE <= #1 3'b010; // WORD; default : $display($time,, "ERROR: unsupported transfer size: %d-byte", size); endcase @(posedge HCLK); while (HREADY !== 1'b1) @(posedge HCLK); HTRANS <= #1 2'b0; // IDLE @(posedge HCLK); while (HREADY === 0) @(posedge HCLK); data = HRDATA; // must be blocking if (HRESP != 2'b00) $display($time,, "ERROR: non OK response for read"); @(posedge HCLK); end endtask //----------------------------------------------------------------------- // AHB Write Task //----------------------------------------------------------------------- task ahb_write; input [31:0] address; input [2:0] size; input [31:0] data; begin @(posedge HCLK); HADDR <= #1 address; HPROT <= #1 4'b0001; // DATA HTRANS <= #1 2'b10; // NONSEQ HBURST <= #1 3'b000; // SINGLE HWRITE <= #1 1'b1; // WRITE case (size) 1 : HSIZE <= #1 3'b000; // BYTE 2 : HSIZE <= #1 3'b001; // HWORD 4 : HSIZE <= #1 3'b010; // WORD default : $display($time,, "ERROR: unsupported transfer size: %d-byte", size); endcase @(posedge HCLK); while (HREADY !== 1) @(posedge HCLK); HWDATA <= #1 data; HTRANS <= #1 2'b0; // IDLE @(posedge HCLK); while (HREADY === 0) @(posedge HCLK); if (HRESP != 2'b00) $display($time,, "ERROR: non OK response write"); @(posedge HCLK); end endtask //----------------------------------------------------------------------- // AHB Read Burst Task //----------------------------------------------------------------------- task ahb_read_burst; input [31:0] addr; input [31:0] leng; integer i; integer ln; integer k; begin k = 0; @(posedge HCLK); HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR ln = leng; end HWRITE <= #1 1'b0; // READ HSIZE <= #1 3'b010; // WORD @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); while (leng > 0) begin for (i = 0; i < ln-1; i = i + 1) begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b11; // SEQ; @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); data_burst[k%1024] <= HRDATA; k = k + 1; end leng = leng - ln; if (leng == 0) begin HADDR <= #1 0; HTRANS <= #1 0; HBURST <= #1 0; HWRITE <= #1 0; HSIZE <= #1 0; end else begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR1 ln = leng; end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); data_burst[k%1024] = HRDATA; // must be blocking k = k + 1; end end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); data_burst[k%1024] = HRDATA; // must be blocking end endtask //----------------------------------------------------------------------- // AHB Write Burst Task // It takes suitable burst first and then incremental. //----------------------------------------------------------------------- task ahb_write_burst; input [31:0] addr; input [31:0] leng; integer i; integer j; integer ln; begin j = 0; ln = 0; @(posedge HCLK); while (leng > 0) begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR ln = leng; end HWRITE <= #1 1'b1; // WRITE HSIZE <= #1 3'b010; // WORD for (i = 0; i < ln-1; i = i + 1) begin @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); HWDATA <= #1 data_burst[(j+i)%1024]; HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b11; // SEQ; while (HREADY == 1'b0) @(posedge HCLK); end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); HWDATA <= #1 data_burst[(j+i)%1024]; if (ln == leng) begin HADDR <= #1 0; HTRANS <= #1 0; HBURST <= #1 0; HWRITE <= #1 0; HSIZE <= #1 0; end leng = leng - ln; j = j + ln; end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); if (HRESP != 2'b00) begin // OKAY $display($time,, "ERROR: non OK response write"); end `ifdef DEBUG $display($time,, "INFO: write(%x, %d, %x)", addr, size, data); `endif HWDATA <= #1 0; @(posedge HCLK); end endtask `endif还需要一个APB的从机模块: `timescale 1ns / 1ps `define AMBA_APB3 `define AMBA_APB4 module apb_mem #( parameter P_SLV_ID = 0, parameter ADDRWIDTH = 32, parameter P_SIZE_IN_BYTES = 1024, // memory depth parameter P_DELAY = 0 // reponse delay ) ( //---------------------------------- // IO Declarations //---------------------------------- `ifdef AMBA_APB3 output wire PREADY, output wire PSLVERR, `endif `ifdef AMBA_APB4 input wire [2:0] PPROT, input wire [3:0] PSTRB, `endif input wire PRESETn, input wire PCLK, input wire PSEL, input wire PENABLE, input wire [ADDRWIDTH-1:0] PADDR, input wire PWRITE, output reg [31:0] PRDATA = 32'h0, input wire [31:0] PWDATA ); //---------------------------------- // Local Parameter Declarations //---------------------------------- localparam DEPTH = (P_SIZE_IN_BYTES+3)/4; localparam AW = logb2(P_SIZE_IN_BYTES); //---------------------------------- // Variable Declarations //---------------------------------- `ifndef AMBA_APB3 wire PREADY; `else assign PSLVERR = 1'b0; `endif `ifndef AMBA_APB4 wire [3:0] PSTRB = 4'hF; `endif reg [7:0] mem0[0:DEPTH-1]; reg [7:0] mem1[0:DEPTH-1]; reg [7:0] mem2[0:DEPTH-1]; reg [7:0] mem3[0:DEPTH-1]; wire [AW-3:0] TA = PADDR[AW-1:2]; //---------------------------------- // Start of Main Code //---------------------------------- //-------------------------------------------------------------------------- // write transfer // ____ ____ ____ // PCLK ___| |____| |____| |_ // ____ ___________________ _____ // PADDR ____X__A________________X_____ // ____ ___________________ _____ // PWDATA ____X__DW_______________X_____ // ___________________ // PWRITE ____| |_____ // ___________________ // PSEL ____| |_____ // _________ // PENABLE ______________| |_____ //-------------------------------------------------------------------------- always @(posedge PCLK) begin if (PRESETn & PSEL & PENABLE & PWRITE & PREADY) begin if (PSTRB[0]) mem0[TA] <= PWDATA[ 7: 0]; if (PSTRB[1]) mem1[TA] <= PWDATA[15: 8]; if (PSTRB[2]) mem2[TA] <= PWDATA[23:16]; if (PSTRB[3]) mem3[TA] <= PWDATA[31:24]; end end //-------------------------------------------------------------------------- // read // ____ ____ ____ // PCLK ___| |____| |____| |_ // ____ ___________________ _____ // PADDR ____X__A________________X_____ // ____ _________ _____ // PRDATA ____XXXXXXXXXXX__DR_____X_____ // ____ _____ // PWRITE ____|___________________|_____ // ___________________ // PSEL ____| |_____ // _________ // PENABLE ______________| |_____ //-------------------------------------------------------------------------- always @(posedge PCLK) begin if (PRESETn & PSEL & ~PENABLE & ~PWRITE) begin PRDATA[ 7: 0] <= mem0[TA]; PRDATA[15: 8] <= mem1[TA]; PRDATA[23:16] <= mem2[TA]; PRDATA[31:24] <= mem3[TA]; end end `ifdef AMBA_APB3 localparam ST_IDLE = 'h0, ST_CNT = 'h1, ST_WAIT = 'h2; reg [7:0] count; reg ready; reg [1:0] state=ST_IDLE; assign PREADY = (P_DELAY == 0) ? 1'b1 : ready; always @(posedge PCLK or negedge PRESETn) begin if (PRESETn == 1'b0) begin count <= 'h0; ready <= 'b1; state <= ST_IDLE; end else begin case (state) ST_IDLE : begin if (PSEL && (P_DELAY > 0)) begin ready <= 1'b0; count <= 'h1; state <= ST_CNT; end else begin ready <= 1'b1; end end // ST_IDLE ST_CNT : begin count <= count + 1; if (count >= P_DELAY) begin count <= 'h0; ready <= 1'b1; state <= ST_WAIT; end end // ST_CNT ST_WAIT : begin ready <= 1'b1; state <= ST_IDLE; end // ST_WAIT default : begin ready <= 1'b1; state <= ST_IDLE; end endcase end // if end // always `else assign PREADY = 1'b1; `endif // Calculate log-base2 function integer logb2; input [31:0] value; reg [31:0] tmp; begin tmp = value - 1; for (logb2 = 0; tmp > 0; logb2 = logb2 + 1) tmp = tmp >> 1; end endfunction // synopsys translate_off `ifdef RIGOR always @(posedge PCLK or negedge PRESETn) begin if (PRESETn == 1'b0) begin end else begin if (PSEL & PENABLE) begin if (TA >= DEPTH) $display($time,,"%m: ERROR: out-of-bound 0x%x", PADDR); end end end `endif // synopsys translate_on endmodule6、仿真 用VCS进行仿真,打印信息如下 图片 可见仿真完全正确,这里也只是做了AHB总线的单一传输和各种长度的增量突发,回环突发未涉及(对APB桥来说,它并不关心HBURST的信号值)。 下面挂两张仿真截图: 单一传输,先写后读: 图片 突发传输,先写完,再读完 图片
IP&SOC设计
# SOC设计
刘航宇
3年前
1
1,615
1
上一页
1
2
3
4
...
14
下一页