🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,230 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,761 阅读
3
【高数】形心计算公式讲解大全
9,123 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,172 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,899 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
21(共157篇)
找到
157
篇与
21
相关的结果
- 第 2 页
通讯等不确定性条件下设计无人机之间的安全距离
摘要本文针对无人机通信不确定性,提出基于分离原理的安全半径设计方法。通过仿真和实验验证,该方法有效提高了无人机飞行安全性和效率。关键词:无人机安全距离, 通信不确定性, 安全半径设计, 分离原理, 无人机控制器引用文章: 简介 1. 研究问题 2. 分离原理介绍 3. 安全半径设计 4. 仿真及实验验证 引用文章: Q. Quan, R. Fu and K. -Y. Cai, "How Far Two UAVs Should Be subject to Communication Uncertainties," in IEEE Transactions on Intelligent Transportation Systems, doi: 10.1109/TITS.2022.3213555. 简介 近年来,无人机技术的快速发展使得低空空域中无人机的数量爆炸增长。碰撞避免作为无人机应用的关键技术,近年来人们已经进行了大量研究,设计出各种方法使得无人机在飞行过程中与障碍物保持一定安全距离(本文将该距离称为无人机的 安全半径)。然而, 在碰撞避免相关研究中,不确定性往往是难以处理的问题。针对不确定性,主流的方法包括对不确定性进行预测,以及在闭环控制中给予补偿。然而,以上方法很依赖于预测及补偿的精准设计,设计不当将有可能导致控制器失效。本研究受地面交通中车辆间安全距离启发,基于对通信不确定性和无人机控制器性能的假设,提出了 安全半径设计和控制器设计的原则 (本文称为 分离原理 )。进一步,安全半径具体通常通过经验预先设计,如果设计得过大或过小将分别影响无人机飞行的高效性及安全性。 如何根据无人机模型及通信不确定性确定其安全半径下界仍然是悬而未决的问题 。利用分离原理,本文研究了 设计阶段(无不确定性)和飞行阶段(受不确定性影响)的无人机安全半径设计 。最后,通过仿真和实验表明了所提方法的有效性。 图片 1. 研究问题 本研究中,无人机与障碍物的运动模型均建模为多旋翼模型,换句话说,我们考虑的障碍物可以等效为另一架多旋翼飞行器。对于多旋翼飞行器而言,其可以获得自身以及障碍物的实时位置和速度。为简单描述起见,本文建模均为二维,类似的建模及分析方法可以扩展到三维情况。 我们首先建立多旋翼的具体控制模型如下。 其中多旋翼的位置和速度分别表示为 ,速度控制模型建立为一阶惯性环节,其时间常数 与无人机的机动性能相关,控制输入 为期望速度。在此基础上,本文定义一种新的滤波位置模型如下。 多旋翼滤波位置的物理意义是根据多旋翼的当前位置、速度及机动能力,对其运动趋势预测。在此基础上,定义多旋翼的安全区域为以滤波位置为圆心的圆形区域,其半径称为安全半径 。对于障碍物,我们类似定义其滤波位置,以及以障碍物滤波位置为圆心的圆形障碍物区域,半径称为障碍物半径 。 图片 进一步,我们针对不确定性做了以下2点假设:(1)无人机和障碍物对自身的三维位置及三维速度估计均存在噪声;(2)无人机在获取障碍物状态信息时,存在通信延迟及丢包。该通信网络模型如下图所示。 图片 本研究中,丢包模型进一步建模为均值模型,且假设估计噪声、通信延迟、丢包均值模型误差均存在上界且上界已知。其数学定义如下: 图片 进一步,本文对无人机的控制器性能做出如下假设:(1)在无不确定性的理想状态下,无人机的控制器可以使无人机和障碍物之间的 真实距离 始终大于给定安全距离;(2)在存在以上不确定性的实际情况中,无人机的控制器可以使无人机和障碍物之间的 估计距离 始终保持给定安全距离。本研究的具体目标是在不确定性上界已知的条件下计算出无人机安全半径的下界。 图片 2. 分离原理介绍 无人机在理想状态下设计的控制器中给定的安全半径值 ,在实际含有不确定性的环境中将转化为估计安全半径 ;直观上理解,将含有不确定性的无人机与障碍物之间的估计位置误差代替真实位置误差作为反馈时,控制器将难以维持给定的安全半径。本研究中, 分离原理具体研究的是不确定性在满足什么条件时无人机的控制器设计和安全半径设计过程可分离 ,也就是估计安全半径和安全半径相等, 成立。分离原理具体数学描述如下: 图片 分离原理中提出的三个条件包括一个充分必要条件(i)以及两个充分条件(ii)和(iii)。其中,条件(i)为理论推导,在实际中难以得到验证,通常可通过条件(ii)和(iii)进行验证。条件(ii)对无人机速度的限制较宽,该式在障碍物主动躲避无人机的条件下容易达成。反之,条件(iii)对无人机速度的限制较苛刻,要求无人机速度严格大于障碍物速度,适用于在障碍物不主动躲避无人机的情况下。以上两种情况的区别如下图所示。 图片 3. 安全半径设计 根据上述分离原理的提出,在分离原理满足的前提下,基于无人机的安全半径模型和通信网络模型,可以进一步设计 合适大小的无人机安全半径 。如前文所述,安全半径设计过大会增加环境的冗余度,设计过小则无法保证飞行过程的安全。在本研究中,给出了在理想情况下以及实际情况下安全半径的下界,分别如下: 图片 4. 仿真及实验验证 仿真及实验验证在仿真中,我们针对单障碍物、多非合作障碍物、多合作障碍物设计了三种场景来验证我们方法的有效性。在实验中,我们使用DJI tello无人机对以上情况进行测试,结果与我们的理论一致。实验视频: https://youtu.be/LkSDPFGa_1E 论文地址 https://rfly.buaa.edu.cn/pdfs/2022/How_far_two_UAVs_should_be_subject_to_communication_uncertainties.pdf
软硬件算法
# 软件算法
刘航宇
2年前
0
1,068
2
泛化能力,过拟合,欠拟合,不收敛,奥卡姆剃刀
摘要本文介绍了机器学习中的泛化能力、欠拟合、过拟合和不收敛等概念,并分析了它们的成因和解决方法,包括增加数据特征、使用更高级的模型、降低模型复杂度、数据集扩增、数据增强、正则化、dropout、早停、重新清洗数据和集成学习方法等。关键词:泛化能力, 过拟合, 欠拟合, 不收敛, 正则化泛化能力 欠拟合过拟合与不收敛 解决手段一、模型训练拟合的分类和表现 二、欠拟合 三、过拟合 总结: 泛化能力 泛化能力(generalization ability)是指机器学习算法对新鲜样本的适应能力,简而言之是在原有的数据集上添加新的数据集,通过训练输出一个合理的结果。学习的目的是学到隐含在数据背后的规律,对具有同一规律的学习集以外的数据,经过训练的网络也能给出合适的输出,该能力称为泛化能力。 欠拟合过拟合与不收敛 用比较直白的话来讲,就是通过数据训练学习的模型,拿到真实场景去试,这个模型到底行不行,如果达到了一定的要求和标准,它就是行,说明泛化能力好,如果表现很差,说明泛化能力就差。为了更好的理解泛化能力,这里引入三种现象,欠拟合、过拟合以及不收敛。 欠拟合(under-fitting),是指模型拟合程度不高,数据距离拟合曲线较远,或指模型没有很好地捕捉到数据特征,不能够很好地拟合数据。即,在训练数据集上表现差,在测试集数据也表现差。 过拟合(over-fitting),是指模型在训练集上表现很好,在测试集上效果差。 不收敛(non-convergence),指误差函数一直在振荡,不能趋近一个定值,没有找到局部或者全局最小值。 举个例子来说明下,好比高考数学考试,为了在高考能有个好成绩,高一到高三,好多人会采用“题海战术”来训练自己的做题能力,但高考试卷上的题,都是新题,几乎没有一模一样的题,学生们为了掌握解题规律就不停的刷题,希望最后自己碰到类似的题,能够举一反三,能学以致用,这种规律掌握的适用性,就是泛化能力。 有的人对相似题型的解题规律掌握的很好,并且解题效果也很好,这种就是泛化能力强,这种同学往往数学成绩就好。 有的同学成绩不好,就是泛化能力差,可能有三种情况 1.做了不少题,但没有找到解题规律,不管碰到老题和新题都不会做,这种就是欠拟合。 2.做了很多题,自认为做过的每一类题型的解题规律都掌握了,而且在之前“题海战术”的题目中,确实表现的很好,但是一碰到新的题目,完全就不会,或者做错,这种学生就是那种喜欢死记硬背的,这种就是过拟合。 3.平常也不做题,然后每次一做题就瞎蒙,导致偶尔对,偶尔错,这种就是不收敛。 为了更直观展示,引用了几张图来说明,如下图所示,真实曲线是正弦曲线,蓝色的点是训练数据,红色的线为拟合曲线。 图片 图片 解决手段 在深度学习的模型建立过程中,一般都是用已经产生的数据训练,然后使用训练得到的模型去拟合未来的数据,借此来预测一些东西。在机器学习和深度学习的训练过程中,经常会出现欠拟合和过拟合的现象。训练一开始,模型通常会欠拟合,所以会对模型进行优化,等训练到一定程度后,就需要解决过拟合的问题了。 一、模型训练拟合的分类和表现 如何判断过拟合呢?我们在训练的时候会定义训练误差,验证集误差,测试集误差(即泛化误差)。训练误差总是减少的,而泛化误差一开始会减少,到了一定程度后不减少反而开始增加,这时候便出现了过拟合的现象。 如下图,直观理解,欠拟合就是还没有学习到数据的特征,还有待继续学习,所以此时判断的不准确;而过拟合则是学习的太彻底,以至于把数据的一些不需要的局部特征或者噪声所带来的特征都给学习到了,所以在测试的时候泛化误差也不佳。 图片 从方差和偏差的角度来说,欠拟合就是在训练集上高方差,高偏差,过拟合就是高方差,低偏差。为了更加直观,我们看下面的图 图片 对比上图,图一的拟合并没有把大体的规律给拟合出来,拟合效果不好,这个就是欠拟合,还需要继续学习规律,此时模型简单;图三的拟合过于复杂,拟合的过于细致,以至于拟合了一些没有必要的东西,这样在训练集上效果很好,但放到测试集和验证集就会不好。图二是最好的,把数据的规律拟合出来了,也没有更复杂,更换数据集后也不会效果很差。 在上面的拟合函数中,可以想到,图三过拟合的拟合函数肯定是一个高次函数,其参数个数肯定比图二多,可以说图三的拟合函数比图二要大,模型更加复杂。这也是过拟合的一个判断经验,模型是否过于复杂。另外针对图三,我们把一些高次变量对应的参数值变小,也就相当于把模型变简单了。从这个角度上讲,可以减少参数值,也就是一般模型过拟合,参数值整体比较大。从模型复杂性上讲,可以是: ——模型的参数个数; ——模型的参数值的大小。 个数越多,参数值越大,模型越复杂。 二、欠拟合 欠拟合的表现 有什么方法来判断模型是否欠拟合呢?其实一般都是依靠模型在训练集和验证集上的表现,有一个大概的判断就行了。如果要有一个具体的方法,可以参考机器学中,学习曲线来判断模型是否过拟合,如下图: 图片 欠拟合的解决方案 (1)增加数据特征:欠拟合是由于学习不足导致的,可以考虑添加特征,从数据中挖掘更多的特征,有时候嗨需要对特征进行变换,使用组合特征和高次特征; (2)使用更高级的模型:模型简单也会导致欠拟合,即模型参数过少,结构过于简单,例如线性模型只能拟合一次函数的数据。尝试使用更高级的模型有助于解决欠拟合,增加神经网络的层数,增加参数个数,或者使用更高级的方法; (3)减少正则化参数:正则化参数是用来防止过拟合的,出现欠拟合的情况就要考虑减少正则化参数。 三、过拟合 过拟合的定义 模型在训练集上表现好,但在测试集和验证集上表现很差,这就是过拟合 图片 过拟合的原因 (1)数据量太小 这是很容易产生过拟合的原因。设想我们有一组数据很好的满足了三次函数的规律,但我们只取了一小部分数据进行训练,那么得到的模型很可能是一个线性函数,把这个线性函数用于测试集上,可想而知肯定效果很差。(此时训练集上效果好,测试集效果差) (2)训练集和验证集分布不一致 这也是很大一个原因。训练集上训练出来的模型适合训练集,当把模型应用到一个不一样分布的数据集上,效果肯定大打折扣,这个是显而易见的。 (3)网络模型过于复杂 选择模型算法时,选择了一个复杂度很高的模型,然而数据的规律是很简单的,复杂的模型反而不适用了。 (4)数据质量很差 数据有很多噪声,模型在学习的时候,肯定也会把噪声规律学习到,从而减少了一般性的规律。这个时候模型预测效果也不好。 (5)过度训练 这是同第四个相联系的,只要模型训练时间足够长,那么模型肯定会把一些噪声隐含的规律学习到,这时候降低模型的性能也是显而易见的。 解决方法 (1)降低模型复杂度 处理过拟合的第一步就是降低模型复杂度。为了降低复杂度,我们可以简单地移除层或者减少神经元的数量使得网络规模变小。与此同时,计算神经网络中不同层的输入和输出维度也十分重要。虽然移除层的数量或神经网络的规模并无通用的规定,但如果你的神经网络发生了过拟合,就尝试缩小它的规模。 (2)数据集扩增 在数据挖掘领域流行着这样的一句话,“有时候往往拥有更多的数据胜过一个好的模型”。因为我们在使用训练数据训练模型,通过这个模型对将来的数据进行拟合,而在这之间又一个假设便是,训练数据与将来的数据是独立同分布的。即使用当前的训练数据来对将来的数据进行估计与模拟,而更多的数据往往估计与模拟地更准确。因此,更多的数据有时候更优秀。但是往往条件有限,如人力物力财力的不足,而不能收集到更多的数据,如在进行分类的任务中,需要对数据进行打标,并且很多情况下都是人工得进行打标,因此一旦需要打标的数据量过多,就会导致效率低下以及可能出错的情况。所以,往往在这时候,需要采取一些计算的方式与策略在已有的数据集上进行手脚,以得到更多的数据。 通俗的讲,数据机扩增即需要得到更多的符合要求的数据,即和已有的数据是独立同分布的,或者近似独立同分布的。一般有以下方法: ——从数据源头采集更多数据 ——复制原有数据加上噪声 ——重采样 ——根据当前数据集估计数据分布参数,利用该分布产生更多数据(3)数据增强 使用数据增强可以生成多幅相似图像。这可以帮助我们增加数据集从而减少过拟合。因为随着数据量的增加,模型无法过拟合所有样本,因此不得不进行泛化。计算机视觉领域通常的做法有:翻转,平移,旋转,缩放,改变亮度,添加噪声等。 (4)正则化 正则化是指在进行目标函数或者代价函数优化时,在目标函数或者代价函数后面加上一个正则项,一般有L1正则和L2正则等。 L1惩罚项的目的是使权重绝对值最小化,公式如下: 图片 L1惩罚项的目的是使权重的平方最小化,公式如下: 图片 下面对两种正则化方法进行了比较: 图片 如果数据过于复杂以致没有办法进行准确的建模,那么L2是更好的选择,因为它能够学习数据中呈现的内在模式。而当数据足够简单,可以精确建模的话,L1更合适,对于我遇到的大多数计算机视觉问题,L2正则化几乎总是可以给出最好的结果。然而L1不容易受到离群值的影响。所以正确的正则化选项取决于我们想要解决的问题。 总结: 正则项是为了降低模型的复杂度,从而避免模型过分拟合训练数据,包括噪声与异常点。从另一个角度讲,正则化即是假设模型参数服从先验概率,即为模型参数添加先验,只是不同的正则化方式的先验分布是不一样的。这样就规定了参数的分布,使得模型的复杂度降低(试想一下,限定条件多了,是不是模型的复杂度就降低了呢),这样模型对于噪声和异常点的抗干扰性的能力增强,从而提高模型的泛化能力。还有个解释,从贝叶斯学派来看,加了先验,在数据少的时候,先验知识可以防止过拟合;从频率学派来看,正则项限定了参数的取值,从而提高了模型的稳定性,而稳定性强的模型不会过拟合,即控制模型空间。 另外一个角度,过拟合从直观上理解便是,在对训练数据进行拟合时,需要照顾到每个点,从而使得拟合函数波动性非常大,即方差大。在某些小区间里,函数值的变化很剧烈,意味着函数在某些小区间的导数值的绝对值非常大,由于自变量的值在给定的训练数据集中是一定的,因为只有系数足够大,才能保证导数的绝对值足够大,如下图: 图片 另一个解释,规则化项的引入,在训练(最小化cost)的过程中,当某一维的特征所对应的权重过大时,而此时模型的预测和真实数据之间的距离很小,通过规则化项就可以使整体的cost取较大的值,从而,在训练的过程中避免了去选择了那些某一维(或几维)特征权重过大的情况,即过分依赖某一维(或几维)的特征。 L1和L2的区别是,L1正则是拉普拉斯先验,L2正则则是高斯先验。它们都是服从均值为0,协方差为1/λ。当λ=0,即没有先验,没有正则项,则相当于先验分布具有无穷大的协方差,那么这个先验约束则会非常弱,模型为了拟合拟合所有的训练集数据,参数可以变得任意大从而使得模型不稳定,即方差大而偏差小。λ越大,表明先验分布协方差越小,偏差越大,模型越稳定。即,加入正则项是在偏差bias与方差variance之间做平衡tradeoff。下图即为L2与L1正则的区别: 图片 上图中的模型是线性回归,有两个特征,要优化的参数分别是w1和w2,左图的正则化是L2,右图是L1。蓝色线就是优化过程中遇到的等高线,一圈代表一个目标函数值,圆心就是样本观测值(假设一个样本),半径就是误差值,受限条件就是红色边界(就是正则化那部分),二者相交处,才是最优参数。可见右边的最优参数只可能在坐标轴上,所以就会出现0权重参数,使得模型稀疏。 其实拉普拉斯分布和高斯分布是数学家从试验中误差服从什么分布研究得出的。一般直观上的认识是服从均值为0的对称分布,并且误差大的概率低,误差小的概率高,因为拉普拉斯使用拉普拉斯分布对误差的分布进行拟合,如下图: 图片 而拉普拉斯在最高点,即自变量为0处不可导,因为不便于计算,于是高斯在这基础上使用高斯分布对其进行拟合,如下图: 图片 (5)dropout 正则时通过再代价函数后面加上正则项来防止过拟合的。而在神经网络中,有一种方法时通过修改神经网络本身结构实现的,其名为dropout。该方法是对网络进行训练时用的一种技巧,对于如下的三层人工神经网络: 图片 对于上图所示的网络,在训练开始时,随即删除一些(可自己设定概率)隐藏层神经元,即认为这些神经元不存在,同时保持输入层和输出层的个数不变,这样便得到如下的ANN: 图片 然后按照BP学习算法对ANN中的参数进行学习更新(虚线链接的单元不更新,因为认为这些连接元被临时删除了)。这样一次迭代更新便完成了,下一次迭代中,同样随机删除一些神经元,与上次不一样,做随机选择,这样一直进行,直至训练结束。 这种技术被证明可以减少很多问题的过拟合,这些问题包括图像分类,图像切割,词嵌入,语义匹配等问题。 (6)早停 对模型的训练即是对模型的参数进行更新的过程,这个参数学习的过程往往会用到一些迭代方法,如梯度下降(Gradient descent)学习算法。Early stopping一种迭代次数截断的方法来防止过拟合的方法,即在模型对训练数据集迭代收敛之前停止迭代来防止过拟合。 Early stopping方法的具体做法是,在每一个Epoch结束时(一个Epoch集为对所有的训练数据的一轮遍历)计算验证集的正确率,当正确率不再提高时,就停止训练。这种做法很符合直观感受,因为正确率都不在提高了,再继续训练也是无益的,只会提高训练的时间。如下图,在几次迭代后,即使训练误差仍然在减少,但测验误差已经开始增加了。 图片 那么该做法的一个重点便是怎样才认为验证准确率validation accurary不再提高了呢?并不是说验证准确率validation accurary一降下来便认为不再提高了,因为可能经过这个Epoch后,正确率降低了,但是随后的Epoch又让正确率又上去了,所以不能根据一两次的连续降低就判断不再提高。一般的做法是,在训练的过程中,记录到目前为止最好的验证准确率validation accurary,当连续10次没达到最佳正确率时,认为不再提高了,此时便可以停止迭代。这种策略也称为“No-improvement-in-n”,n即Epoch的次数,可以根据实际情况取,如10、20、30…… (7)重新清洗数据 把明显异常的数据剔除。 (8)使用集成学习方法 把多个模型集成在一起,降低单个模型的过拟合风险。
机器学习
# 机器学习
刘航宇
2年前
0
1,346
2
2024-01-11
嵌入式常见知识点
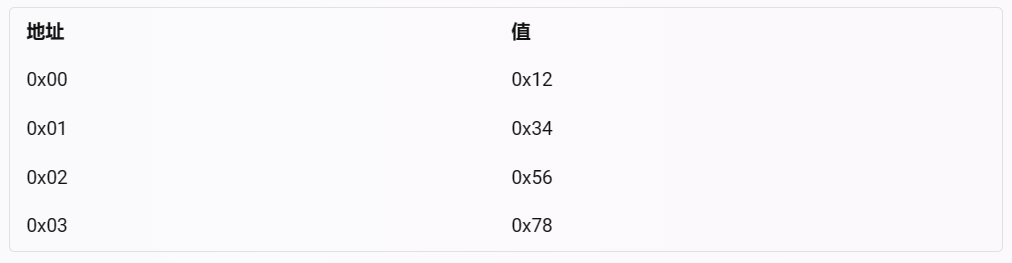
摘要本文介绍了嵌入式系统开发中常见的知识点,包括线程与进程的区别、整数是否为2的n次方的计算方法、printf函数的实现、大小端的概念及区分方法、new与malloc的区别、程序链接后的组成部分、Linux、Windows与FreeRTOS的区别等。关键词:嵌入式, 进程, 线程, 位运算, 快速排序图片 1、线程、进程的区别?最小执行单元是进程还是线程? 2、如何计算一个整数是不是2的n次方? 3、printf的具体实现? 4、什么是大小端?如何区分?有几种方法? 5、new与malloc的区别? 6、程序链接完毕之后分几部分? 7、Linux、Windows与FreeRtos的区别? 8、Linux系统中的中断为什么分为上下两个部分? 9、会快速排序吗?简要说一下? 10、static关键字的作用? 11、extern 关键字的作用? 12、volatile关键字的作用? 13、编译原理分哪几步? 14、内存分区? 15、freertos启动流程? 16、互斥锁与信号量的区别? 17、什么是死锁?死锁产生的原因?如何避免? 18、什么是内存泄漏? 19、系统死机了怎么排查原因?逐一看代码?工程量太大了吧? 20、同一类型的结构体定义两个变量能用内存大小来比较判断两者一样吗?(没懂) 21、freertos中EventBits_t是干啥的? 22、freertos使任务切换的方式有哪些? 23、项目中用到网络了吗? 24、了解Socket吗? 25、c++中set是什么? 26、有没有用到C++模板? 27、有没有对代码裁剪的经验 28、freertos系统是买模块时人家配置好的?还是移植的? 29、任务里有两把锁的时候该怎么处理 30、熟悉Shell脚本吗?$和#啥意思? 表示注释的开始,可以用来对代码进行说明,不会被执行,例如#echo hello,#这是一个注释,表示打印hello,后面的内容是一个注释。31、知道#error吗? 32、freertos消息队列的的具体实现? 33、堆栈区别? 34、程序存放状态和区别 1、线程、进程的区别?最小执行单元是进程还是线程? 线程和进程都是程序的执行实体,但是它们有以下区别: 进程是操作系统分配资源的基本单位,每个进程都有自己的独立的地址空间,代码段,数据段,堆栈段等。进程之间的切换需要保存和恢复上下文,开销较大。 线程是操作系统调度的基本单位,每个线程都属于某个进程,一个进程可以有多个线程,它们共享进程的地址空间,但是有自己的栈和寄存器。线程之间的切换只需要保存和恢复少量的寄存器,开销较小。 最小的执行单元是线程,因为一个进程至少要有一个线程,而一个线程可以独立运行。 2、如何计算一个整数是不是2的n次方? 一个整数是2的n次方,当且仅当它的二进制表示中只有一个1,其余都是0。例如,23=8=(1000)2 ,只有一个1。所以,我们可以用以下的方法来判断一个整数x是否是2的n次方: 如果x小于等于0,那么它不是2的n次方。 如果x大于0,那么我们可以用位运算的技巧,将x与x-1做按位与,如果结果为0,那么x是2的n次方,否则不是。例如,8&(8−1)=8&7=(1000)2&(0111)2=(0000)2=0 ,所以8是2的n次方。而9&(9−1)=9&8=(1001)2&(1000)2=(1000)2=0 ,所以9不是2的n次方。 3、printf的具体实现? printf是C语言中的一个标准库函数,用于向标准输出流(通常是屏幕)打印格式化的字符串。它的具体实现可能因编译器和操作系统的不同而有所差异,但是一般来说,它的主要步骤如下: 首先,printf会解析第一个参数,也就是格式化字符串,根据其中的转换说明符(如%d, %f, %s等),确定需要打印的数据类型和格式。 然后,printf会从第二个参数开始,依次获取对应的数据,并将其转换为字符串,拼接到格式化字符串的相应位置。如果参数的个数和类型与格式化字符串不匹配,可能会导致错误或未定义的行为。 最后,printf会调用底层的系统函数,将拼接好的字符串写入到标准输出流中,并返回成功写入的字符数。如果发生错误,返回负值。 4、什么是大小端?如何区分?有几种方法? 大小端是指数据在内存中的存储顺序,大端表示高位字节存放在低地址,低位字节存放在高地址,小端表示高位字节存放在高地址,低位字节存放在低地址。例如,一个32位的整数0x12345678,在大端模式下,存储为0x12 0x34 0x56 0x78,而在小端模式下,存储为0x78 0x56 0x34 0x12。 区分大小端的方法有以下几种: 通过联合体(union)的方式,将一个整数和一个字符数组放在同一个联合体中,然后判断字符数组的第一个元素是不是整数的最低字节,如果是,说明是小端,否则是大端。 通过指针的方式,将一个整数的地址赋给一个字符指针,然后判断指针指向的内容是不是整数的最低字节,如果是,说明是小端,否则是大端。 通过位运算的方式,将一个整数右移24位,然后与0xFF做按位与,得到的结果是不是整数的最高字节,如果是,说明是大端,否则是小端。 5、new与malloc的区别? new和malloc都是用于动态分配内存的,但是它们有以下区别: new是C++中的运算符,malloc是C语言中的函数,它们的用法不同。new可以直接分配对象,而malloc只能分配字节,需要强制类型转换。 new会调用对象的构造函数,初始化对象,而malloc只是分配原始的内存空间,不做任何初始化。 new会根据对象的类型,自动计算所需的内存大小,而malloc需要手动指定分配的字节数。 new分配失败时,会抛出异常,而malloc分配失败时,会返回NULL指针。 new对应的释放内存的运算符是delete,而malloc对应的释放内存的函数是free。 6、程序链接完毕之后分几部分? 程序链接完毕之后,一般分为以下几个部分: 代码段(text segment),存放程序的指令和常量。 数据段(data segment),存放程序的全局变量和静态变量。 堆(heap),存放程序动态分配的内存空间。 栈(stack),存放程序的局部变量,函数参数,返回地址等。 BSS段(bss segment),存放程序未初始化的全局变量和静态变量。 7、Linux、Windows与FreeRtos的区别? Linux、Windows和FreeRtos都是操作系统,但是它们有以下区别: Linux是一个开源的,基于Unix的,多用户,多任务,支持多种硬件平台的操作系统,它有很多不同的发行版,如Ubuntu,RedHat,Debian等。Linux适合用于服务器,嵌入式系统,桌面系统等。 Windows是一个闭源的,基于NT内核的,多用户,多任务,主要支持x86和x64架构的操作系统,它有很多不同的版本,如Windows 10,Windows Server,Windows CE等。Windows适合用于桌面系统,移动设备,游戏机等。 FreeRtos是一个开源的,基于微内核的,实时,多任务,支持多种嵌入式平台的操作系统,它有很多不同的移植,如ARM,MIPS,AVR等。FreeRtos适合用于实时控制,物联网,低功耗设备等。 8、Linux系统中的中断为什么分为上下两个部分? Linux系统中的中断为了提高效率和响应时间,分为上半部(top half)和下半部(bottom half)。上半部是指中断处理程序(interrupt handler),它负责处理中断的紧急事务,如保存寄存器,清除中断标志,识别中断源等。下半部是指中断延迟服务程序(interrupt deferred service routine),它负责处理中断的非紧急事务,如数据传输,设备驱动,信号发送等。上半部和下半部的区别如下: 上半部在中断上下文中执行,下半部在进程上下文中执行。 上半部不能被其他中断打断,下半部可以被其他中断打断。 上半部不能睡眠,下半部可以睡眠。 上半部不能调用可能导致阻塞的函数,如malloc,copy_to_user等,下半部可以调用这些函数。 上半部的执行时间应该尽可能短,下半部的执行时间可以较长。 9、会快速排序吗?简要说一下? 快速排序是一种基于分治思想的排序算法,它的基本步骤如下: 从待排序的数组中选择一个元素作为基准(pivot),通常选择第一个或者最后一个元素。 将数组分成两个子数组,一个子数组中的元素都小于或等于基准,另一个子数组中的元素都大于基准,这个过程称为划分(partition)。 对两个子数组递归地进行快速排序,直到子数组的长度为1或0。 将排好序的子数组合并,得到最终的排序结果。 快速排序的平均时间复杂度是O(nlogn) ,最坏情况是O(n^2) ,空间复杂度是O(logn) ,它是一种不稳定的排序算法。 10、static关键字的作用? static是一个修饰符,它可以用于变量和函数,它有以下作用: 用于全局变量,表示该变量只能在本文件中访问,不能被其他文件引用,这样可以避免命名冲突。 用于局部变量,表示该变量的生命周期是整个程序,而不是函数调用结束,这样可以保持变量的值不被销毁。 用于函数,表示该函数只能在本文件中调用,不能被其他文件引用,这样可以提高函数的封装性和安全性。 11、extern 关键字的作用? extern是一个修饰符,它可以用于变量和函数,它有以下作用: 用于变量,表示该变量是在其他文件中定义的,需要在本文件中引用,这样可以避免重复定义。 用于函数,表示该函数是在其他文件中定义的,需要在本文件中声明,这样可以避免隐式声明。 12、volatile关键字的作用? volatile是一个修饰符,它可以用于变量,它有以下作用: 用于变量,表示该变量可能会被外部因素(如中断,多线程,硬件等)改变,需要每次都从内存中读取,而不是从寄存器或缓存中读取,这样可以保证变量的实时性和一致性。 用于变量,表示该变量不会被编译器优化,需要按照程序的顺序执行,而不是进行重排或删除,这样可以避免编译器的干扰。 13、编译原理分哪几步? 编译原理是指将一种高级语言(源语言)的程序转换为另一种低级语言(目标语言)的程序的原理和方法,它一般分为以下几个步骤: 词法分析(lexical analysis),将源程序的字符序列分割成有意义的单词(token)。 语法分析(syntax analysis),将单词序列组织成语法树(parse tree)或抽象语法树(abstract syntax tree),表示程序的结构和语义。 语义分析(semantic analysis),检查程序是否符合语言的语法规则和语义规则,如类型检查,作用域分析等。 中间代码生成(intermediate code generation),将抽象语法树转换为一种中间表示(intermediate representation),如三地址码,四元式,后缀表达式等,便于优化和目标代码生成。 代码优化(code optimization),对中间表示进行一些变换,以提高程序的执行效率,如常量折叠,公共子表达式消除,循环优化,死代码删除等。 目标代码生成(target code generation),将中间表示转换为目标语言的代码,如汇编语言,机器语言等,同时进行一些分配,如寄存器分配,指令选择等。 14、内存分区? 内存分区是指将物理内存划分为若干个逻辑区域,以便于管理和使用。内存分区的方式有以下几种: 固定分区,将内存分为大小相等或不等的若干个区域,每个区域只能装入一个进程,如果进程的大小超过区域的大小,就会产生内部碎片。 动态分区,根据进程的大小和数量,动态地分配和回收内存空间,每个区域可以装入一个或多个进程,如果进程的大小不是区域的整数倍,就会产生外部碎片。 页式分区,将进程的地址空间划分为大小相等的若干个页,将物理内存划分为大小相等的若干个页框,然后将页映射到页框,实现非连续的内存分配,避免了外部碎片,但是可能产生内部碎片。 段式分区,将进程的地址空间划分为大小不等的若干个段,每个段有自己的逻辑地址和属性,然后将段映射到物理内存,实现非连续的内存分配,避免了内部碎片,但是可能产生外部碎片。 段页式分区,将进程的地址空间划分为若干个段,每个段再划分为若干个页,然后将页映射到物理内存的页框,实现非连续的内存分配,避免了内部碎片和外部碎片,但是增加了地址转换的复杂度。 15、freertos启动流程? freertos是一个实时操作系统,它的启动流程一般如下: 首先,执行硬件初始化,如设置时钟,中断,堆栈等。 然后,执行软件初始化,如创建任务,队列,信号量,定时器等。 接着,调用vTaskStartScheduler ()函数,启动调度器,选择优先级最高的就绪任务运行。 最后,当发生中断,延时,阻塞等事件时,调度器会根据算法,如优先级抢占式,时间片轮转式等,切换任务,实现多任务的并发执行。 16、互斥锁与信号量的区别? 互斥锁(mutex)和信号量(semaphore)都是用于实现多任务的同步和互斥的机制,但是它们有以下区别: 互斥锁是一个二元的同步对象,它只有两种状态:锁定和解锁。一个互斥锁只能被一个任务拥有,当一个任务获取互斥锁后,其他任务就不能再获取该互斥锁,直到拥有者释放它。互斥锁通常用于保护临界区的访问,避免数据的不一致。 信号量是一个计数的同步对象,它有一个初始值,表示可用的资源数量。一个信号量可以被多个任务共享,当一个任务获取信号量后,信号量的值减一,表示资源被占用。当信号量的值为零时,表示没有可用的资源,其他任务就要等待,直到有任务释放信号量,信号量的值加一,表示资源被释放。信号量通常用于实现生产者-消费者模型,控制资源的分配和回收。 17、什么是死锁?死锁产生的原因?如何避免? 死锁是指多个任务因为争夺有限的资源而相互等待,导致无法继续执行的现象。死锁产生的原因一般有以下四个必要条件: 互斥条件,指每个资源只能被一个任务拥有,其他任务不能访问。 占有且等待条件,指一个任务已经占有了至少一个资源,但是又申请了其他已经被占有的资源,同时不释放自己已经占有的资源。 不可抢占条件,指一个任务占有的资源不能被其他任务强行剥夺,只能由占有者主动释放。 循环等待条件,指多个任务形成一个环路,每个任务都在等待下一个任务占有的资源。 避免死锁的方法有以下几种: 破坏互斥条件,使用非互斥的资源,如可复制的资源,或者使用软件技术,如事务,来实现对资源的虚拟访问。 破坏占有且等待条件,要求一个任务在申请资源时,必须一次性申请所有需要的资源,或者在申请新的资源时,必须先释放已经占有的资源。 破坏不可抢占条件,允许一个任务在占有资源时,被其他任务抢占,或者主动释放资源,以满足其他任务的需求。 破坏循环等待条件,给每个资源分配一个优先级,要求一个任务只能申请优先级高于或等于自己已经占有的资源的资源,或者按照一定的顺序申请资源,避免形成环路。 18、什么是内存泄漏? 内存泄漏是指程序在运行过程中,动态分配了一些内存空间,但是没有及时释放,导致这些内存空间无法被其他程序使用,造成内存的浪费和紧张。内存泄漏可能会导致程序的性能下降,甚至崩溃。 19、系统死机了怎么排查原因?逐一看代码?工程量太大了吧? 系统死机是指系统无法响应用户的输入,或者出现异常的错误,导致系统无法正常运行。排查系统死机的原因有以下几种方法: 通过日志文件,查看系统在死机前的运行状态,是否有异常的信息,如错误码,警告,断言等,以及死机的时间,位置,频率等,从而定位可能的问题源。 通过调试工具,如gdb,lldb等,对系统进行调试,查看系统的内存,寄存器,堆栈,断点等,分析系统的运行流程,发现潜在的错误,如内存泄漏,空指针,死锁等。 通过测试工具,如valgrind,asan等,对系统进行测试,检测系统的内存管理,性能,覆盖率等,发现系统的缺陷,如内存错误,资源泄漏,性能瓶颈等。 通过代码审查,对系统的代码进行分析,检查代码的风格,规范,逻辑,注释等,发现代码的不合理,不一致,不完善等,提高代码的质量,可读性,可维护性等。 通过重现问题,对系统的死机现象进行复现,观察系统的表现,输入,输出等,找出问题的触发条件,规律,范围等,缩小问题的范围,提高问题的可解决性。 20、同一类型的结构体定义两个变量能用内存大小来比较判断两者一样吗?(没懂) 同一类型的结构体定义两个变量,不能用内存大小来比较判断两者一样,因为内存大小只能反映结构体的占用空间,而不能反映结构体的内容。例如,以下两个结构体变量的内存大小都是8字节,但是它们的内容是不一样的: struct Point { int x; int y; }; struct Point p1 = {1, 2}; struct Point p2 = {3, 4}; 如果要比较两个结构体变量是否一样,需要逐个比较它们的成员,或者使用memcmp函数比较它们的内存内容。例如: // 逐个比较 if (p1.x == p2.x && p1.y == p2.y) { printf("p1 and p2 are equal\n"); } else { printf("p1 and p2 are not equal\n"); } // 使用memcmp比较 if (memcmp(&p1, &p2, sizeof(struct Point)) == 0) { printf("p1 and p2 are equal\n"); } else { printf("p1 and p2 are not equal\n"); }21、freertos中EventBits_t是干啥的? EventBits_t是一个数据类型,它用于表示事件标志组(event group)中的每个位的状态,每个位可以表示一个事件的发生或者一个条件的满足。EventBits_t通常是一个无符号整数,它可以使用位运算来设置,清除,读取或等待事件标志。 22、freertos使任务切换的方式有哪些? freertos使任务切换的方式有以下几种: 时间片轮转法,按照任务的优先级和时间片的长度,依次轮流执行每个就绪任务,当一个任务的时间片用完或者主动放弃时,切换到下一个任务。 优先级抢占法,按照任务的优先级,总是执行优先级最高的就绪任务,当有更高优先级的任务就绪时,立即抢占当前任务,切换到更高优先级的任务。 混合法,结合时间片轮转法和优先级抢占法,对于同一优先级的任务,使用时间片轮转法,对于不同优先级的任务,使用优先级抢占法,实现任务的公平性和效率。 23、项目中用到网络了吗? 这个问题的答案取决于你的项目的具体情况,如果你的项目需要与其他设备或服务器进行通信,或者需要访问互联网上的资源,那么你的项目就用到了网络。如果你的项目只是在本地运行,不需要与外界交互,那么你的项目就没有用到网络。 24、了解Socket吗? Socket是一种通信机制,它可以实现不同进程或不同设备之间的数据交换。Socket通常基于TCP/IP协议,提供了可靠的,双向的,面向连接的通信服务。Socket的基本操作包括创建,绑定,监听,连接,发送,接收,关闭等。Socket的编程接口通常是一组函数或类,不同的编程语言或平台可能有不同的实现,如C语言的socket.h,Java语言的java.net.Socket等。 25、c++中set是什么? set是C++标准模板库(STL)中的一个容器,它可以存储一组不重复的元素,并且按照一定的顺序排列。set的元素可以是任意类型,但是必须支持比较操作,如<,==等。set的底层实现通常是红黑树,所以它的插入,删除,查找等操作的时间复杂度都是O(logn) ,其中n是元素的个数。set的优点是可以快速地检查一个元素是否存在,以及保持元素的有序性。set的缺点是不能存储重复的元素,以及不能直接访问元素,只能通过迭代器遍历。 26、有没有用到C++模板? C++模板是一种泛型编程的技术,它可以让程序员定义一种通用的模式,然后根据不同的类型或参数,生成不同的代码,从而实现代码的复用和抽象。C++模板有两种,一种是函数模板,用于定义通用的函数,另一种是类模板,用于定义通用的类。例如,以下是一个函数模板,用于比较两个值的大小: template <typename T> T max(T x, T y) { return (x > y) ? x : y; } 我有用过C++模板,它们可以让我的代码更简洁,更灵活,更高效。我用过STL中的一些类模板,如vector,map,set等,也用过自己定义的一些函数模板和类模板,来实现一些通用的算法和数据结构。 27、有没有对代码裁剪的经验 代码裁剪是指对代码进行优化,删除不必要的或冗余的代码,减少代码的体积和复杂度,提高代码的可读性和可维护性。代码裁剪的目的是为了提高程序的性能,节省内存空间,降低编译时间,避免错误和漏洞等。 我有对代码裁剪的经验,我用过一些工具和方法来进行代码裁剪,如: 使用编译器的优化选项,如-Os,-O3等,让编译器自动进行一些代码裁剪,如常量折叠,死代码删除,循环展开等。 使用代码分析工具,如lint,coverity等,检查代码的质量,发现代码的缺陷,如未使用的变量,函数,参数等,以及代码的风格,规范,注释等,然后根据工具的建议,修改或删除代码。 使用代码重构工具,如refactor,eclipse等,对代码进行重构,改善代码的结构,设计,逻辑等,消除代码的冗余,重复,复杂等,提高代码的可读性,可维护性,可扩展性等。 使用代码压缩工具,如upx,gzip等,对代码进行压缩,减少代码的体积,提高代码的传输速度,节省存储空间等。 28、freertos系统是买模块时人家配置好的?还是移植的? freertos系统是一个开源的,可移植的,实时的操作系统,它可以运行在多种嵌入式平台上,如ARM,MIPS,AVR等。freertos系统不是买模块时人家配置好的,而是需要根据不同的硬件和需求进行移植和定制的。移植freertos系统的步骤一般如下: 下载freertos的源码,选择合适的移植层,如portable/GCC/ARM_CM3等,根据目标平台的特性,修改一些配置参数,如configCPU_CLOCK_HZ,configTICK_RATE_HZ等。 编写启动代码,如设置时钟,中断,堆栈等,调用vPortStartFirstTask ()函数,启动第一个任务。 编写应用代码,如创建任务,队列,信号量,定时器等,调用vTaskStartScheduler ()函数,启动调度器。 编译,链接,下载,调试代码,检查系统的运行情况,如任务切换,中断响应,内存管理等。 29、任务里有两把锁的时候该怎么处理 任务里有两把锁的时候,可能会出现死锁的问题,即两个或多个任务因为互相等待对方占有的锁而无法继续执行。处理任务里有两把锁的时候,有以下几种方法: 避免使用两把锁,如果可能的话,尽量使用一把锁来保护临界区,或者使用其他同步机制,如信号量,事件标志等,来实现任务之间的协作。 按照一定的顺序获取和释放锁,如果必须使用两把锁,那么要求所有的任务都按照相同的顺序获取和释放锁,避免形成循环等待的条件。 使用超时机制,如果一个任务在获取锁时,发现锁已经被占用,那么不要无限期地等待,而是设置一个超时时间,如果超时时间到了,还没有获取到锁,那么就放弃获取,释放已经占有的锁,然后重新尝试或者执行其他操作。 使用优先级继承机制,如果一个任务在获取锁时,发现锁已经被占用,那么就把自己的优先级赋给占有锁的任务,让占有锁的任务尽快执行完毕,释放锁,然后恢复原来的优先级,这样可以避免优先级反转的问题。 30、熟悉Shell脚本吗?$和#啥意思? Shell脚本是一种用于控制Unix或Linux系统的命令行解释器,它可以实现一些自动化的任务,如文件操作,文本处理,程序运行等。Shell脚本的语法和结构类似于C语言,但是更加简洁和灵活。Shell脚本的文件名通常以.sh为后缀,例如test.sh。 $和#是Shell脚本中的两个特殊符号,它们有以下含义: $表示变量的引用,可以用来获取或设置变量的值,例如x=10,echo $x,表示将10赋值给变量x,然后打印x的值。 表示注释的开始,可以用来对代码进行说明,不会被执行,例如#echo hello,#这是一个注释,表示打印hello,后面的内容是一个注释。 31、知道#error吗? 、#error是一个预处理指令,它可以用来在编译时产生一个错误信息,中断编译过程。#error通常用来检查一些条件,如宏定义,平台,版本等,如果不满足条件,就提示错误,防止编译出错的代码。例如: #ifdef __linux__ #error This code is not compatible with Linux #endif 这段代码表示如果定义了__linux__宏,就产生一个错误信息,表示这段代码不兼容Linux系统。 32、freertos消息队列的的具体实现? freertos消息队列是一种用于实现任务之间或任务与中断之间的异步通信的机制,它可以存储一组有序的消息,每个消息可以是任意类型的数据。freertos消息队列的具体实现如下: 消息队列是一个结构体,它包含了一些成员,如队列的头指针,尾指针,长度,容量,锁,信号量等,用来管理队列的状态和操作。 消息队列的存储空间是一个数组,它可以是静态分配的或动态分配的,它的大小要能够容纳队列的最大容量乘以每个消息的大小。 消息队列的操作有以下几种,如创建,删除,发送,接收等,它们都是通过调用一些API函数来实现的,如xQueueCreate,vQueueDelete,xQueueSend,xQueueReceive等。 消息队列的操作都是原子的,即在操作过程中,不会被其他任务或中断打断,这是通过使用临界区或中断屏蔽来实现的,以保证队列的一致性和完整性。 消息队列的操作都是阻塞的,即如果队列满了,就不能发送消息,如果队列空了,就不能接收消息,这是通过使用信号量来实现的,以实现任务的同步和等待。 33、堆栈区别? 堆(heap)和栈(stack)都是程序运行时使用的内存空间,但是它们有以下区别: 堆是动态分配的,程序员可以自由地申请和释放堆上的内存空间,堆的大小受到物理内存的限制,堆上的内存空间的地址是不连续的。 栈是静态分配的,编译器会自动地分配和回收栈上的内存空间,栈的大小受到操作系统的限制,栈上的内存空间的地址是连续的。 堆是全局共享的,堆上的内存空间可以被任何函数或模块访问,堆上的内存空间的生命周期是由程序员控制的,如果不及时释放,可能会导致内存泄漏。 栈是局部私有的,栈上的内存空间只能被当前函数或模块访问,栈上的内存空间的生命周期是由编译器控制的,当函数调用结束时,栈上的内存空间就会被自动释放。 34、程序存放状态和区别 程序存放状态是指程序在运行过程中的不同阶段,它有以下几种: 新建状态,指程序刚刚被创建,还没有被加载到内存中,等待调度器的调度。 就绪状态,指程序已经被加载到内存中,已经分配了必要的资源,等待处理器的分配。 运行状态,指程序已经被分配了处理器,正在执行程序的指令。 阻塞状态,指程序在执行过程中,因为等待某些事件的发生,如输入输出,信号量,中断等,而暂时停止执行,释放处理器,等待事件的完成。 终止状态,指程序已经执行完毕,或者因为某些原因,如错误,异常,中断等,而被终止,释放内存和资源,从系统中消失。
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
759
4
嵌入式/SOC开发利器-ZYNQ简介与入门
摘要ZYNQ是一款集ARM处理器和FPGA可编程逻辑的SoC芯片,适用于多种领域。它具有可编程性,可执行代码程序,也可实现FPGA。ZYNQ开发流程包括硬件和软件两部分,使用Vivado、Vitis IDE和PetaLinux等工具。入门简单,精通需要大量知识储备。关键词:ZYNQ, ARM处理器, FPGA, SoC设计, 嵌入式系统ZYNQ是什么? ZYNQ为什么厉害 ZYNQ的结构 开发工具 ZYNQ开发流程 ZYNQ是什么? 这是一款由Xilinx公司开发的集成了ARM处理器和FPGA可编程逻辑的片上系统(SoC)芯片。ZYNQ7000有多个型号,根据处理器核心数和FPGA系列的不同,可以应用于多种领域,如图像处理,通信,嵌入式系统等。 ZYNQ中国人读法 “zingke”、“任克”,“Soc”,英文全称叫 System on one Chip ,也就是片上系统的意思。没有微机基础的同学可能不明白什么叫Soc,但是你可以细细琢磨一下,我们的手机和台式电脑的不同,你就可以理解Soc的内含了。 传统计算机是将CPU,内存,GPU,南北桥焊接在印刷电路板上,各个组件之间是分立的。但是Soc则将CPU和各种外设集中到一块芯片上,集合成一个系统,因此像手机这种使用了Soc芯片的这种微机可以做的很轻薄,我们可以说,Soc是未来微机发展的一个趋势,我之前遇见过的像什么全志的A33就是典型的Soc。 ZYNQ为什么厉害 就在于它是一块可编程的Soc。其内部往往有处理器硬核和一些定制外设,并且外设当中有一个很厉害的玩意:PL,即可编程逻辑模块,也就是我们一般意义上的FPGA,所以简单理解ZYNQ就是“ 单片机 + FPGA “,它既可以执行代码程序,也可以实现FPGA。因此我们设计ZYNQ就是在做Soc设计。 ZYNQ的结构 我们先来开一下简化版的模型 图片 上面的模型细致低展开后就是下图的样子: 图片 图是 ZYNQ 7000的结构图,大体分为PS(Processing System)和 PL(Programmable Logic)两部分,其中的PS部分主要是由双核APU和外围的一些外设组成,说实话很像单片机的结构,而外围的PL则类似FPGA,并且两者通过AXI接口进行互联以实现功能. 重点介绍一下APU,应用处理单元:Application Processing Unit,位于PS(processing system)中,包括一个单核或者双核的cortex-A9处理器,处理器连接一个512KB的共享L2cache,每个处理器都有一个32KB的高速L1 cache,A9支持虚拟内存和32bit arm 指令。APU中的A9处理器由可配置的MP组成,MP包含SCU(snoop control unit:监控控制单元)单元,这个单元主要负责获取两个处理器的L1 cache和ACP(accelerator coherency port:加速器相关接口) PL的一致性。应用单元还有一个低延迟的片上memory,与L2 cache并行的,ACP(加速器接口)是PL与APU通信接口,该接口是PL作为主机的AXI协议的接口,最多支持64bit位宽,PL通过ACP接口访问L2 cache 和片上memory,同时保持和L1 cache的内存一致性。L2 cache 可以访问 DDR 控制,这个ddr 控制器是专用的,大大降低内存读写的延迟APU 还包括一个32bit的看门狗,一个64bit的全局定时器,APU 架构图如下所示: 图片 开发工具 在Vivado 19.2之前,我们开发Zynq需要三样必须的软件: Vivado SDK PetaLinux 其中Vivado用来开发硬件平台,SDK开发软件,PetaLinux则制作配套的Linux系统。可能有些人还有用到HLS ,即VIvado HLS 或者Vitis HLS;其中Vivado HLS 2020.1将是Vivado HLS的最后一个版本,取而代之的是VitisHLS。 到了Vivado 19.2之后,事情发生了变化。为了方便大家理解,我愿意称之这些软件成了为Vitis 家族的各个部分,原来的SDK被Vitis IDE取代,Vivado导出的 .hdf 文件被 .xsa文件代替,用来给vitis平台使用。因此我们需要的开发Zynq 最基本的软件变成了 Vivado Vitis IDE PetaLinux 各软件发挥的作用和之前的差不多,不过除了上面提到的四款软件外,Vitis家族还有 Vitis AI 等组件,他们共同组成了所谓的“Vitis™ Unified Software Platform ”,从发展趋势来看,这些开发软件应该会逐步的统一,入门的同学也不会再一头雾水地纠结 Vitis 和 Vivado 的区别和联系了。 ZYNQ开发流程 ZYNQ类似于一个 单片机 + FPGA的结构,其实我觉得如果大家接触过一些 Soc就会更好地理解ZYNQ的作用,就例如全志A33这块Soc,它是一块ASIC,不可以通过编程来对芯片的硬件进行重设计的。 图片 我们可以看到,灰色部分的外设都是固定的,像什么摄像头接口,什么视频接口都是设计好的,定制化的好处就使得总体比较高效,制造成本也低;但是如果我要运用到其它场景下,比如说我需要多个摄像头,那这块芯片就不再适合了(硬件控制的上限就是前后两颗摄像头) 而ZYNQ的意义相当于只给你定制的蓝色部分,也就是处理器内核,灰色的部分都可以通过FPGA实现,这让电子工程师们可以快速开发出各种各样有针对性的Soc;当然了,看过我第一篇博客的同学都知道,其实固定的硬核不止只有处理器内核,其实还有串口和内存控制器之类的外设,这其实是追寻一种固定和变化之间的平衡。 咱们把话说回ZYNQ的开发上来。 图片 ZYNQ的开发流程分为硬件和软件两部分,在SDK之前的属于硬件开发,也就是我们常说的PL部分的开发,而SDK后就属于软件部分的开发了,类似单片机,属于PS部分。当然现在最新的Vitis IDE已经取代了SDK,所以后半部分一般在SDK中进行。 PL部分的开发包括对 嵌入式最小系统的构建,以及FPGA外设的设计两个方面。我觉得要转变的一个思维是,我们现在不是在开发一个什么SDRAM控制器,什么IIC协议控制器,我们在开发的是一个小型的微机系统!因此嵌入式最小系统的设计是我们的核心。 首先,在IP INTEGRATOR中我们要创建BLOCK DESIGN。 图片 IP是用来进行 Embedded System Design ,也就是咱们常说的嵌入式系统设计。也就是咱们上面说的嵌入式最小系统的设计。 图片 大家可以看到,一个最小的系统其实不需要PL参与的,PL可以作为PS的一个外设使用,或者是自己做自己的事情,仅仅作为一个PL工作。既然是外设,当然是可用可不用的,毕竟咱们有好多的外设可以在Block Design 中直接配置使用,即下图绿色部分。 图片 配置好嵌入式系统后,咱们根据需要进行PL部分的设计。这里涉及一个问题,那就是PS和PL之间的数据传输方式有哪些: 中断 IO方式:MIO EMIO GPIO BRAM或FIFO或EMIF AXI DMA:PS通过AXI-lite向AXI DMA发送指令,AXI DMA通过HP通路和DDR交换数据,PL通过AXI-S读写DMA的数据。 等等。。。 可以看出,其实两个部分的交互方式还是很多的,以后咱们遇到一个说一个。 在Vivado端完成对嵌入式系统的设计后,我们就要进入Vitis IDE 端进行软件的开发。 图片 Vitis IDE简单来说流程一般是:新建一个工程,选择Platform ,也就是我们之前在Vivado中生成的 XSA文件,然后添加文件,进行开发。我相信使用过Keil 5的同学们应该心中对文件目录结构应该更胸有成竹,Src文件夹中存放的是源文件。 代码编写完之后是编译,编译完就是下载了。不过这里要注意以下,如果我们使用了PL的资源,那么在下载软件编译生成的 elf 文件之前,需要先下载硬件设计过程中生成的 bitstream 文件,对 PL 部分进行配置。 最后就是验证工作了,上述的流程是普通的ZYNQ开发流程;玩的花一点的同学可能是直接上Linux操作系统,这部分等后面我接触到了再说吧! 其实我觉得ZYNQ入门简单,精通的话需要大量的知识储备,但也不是不可能,开发ZYNQ相比于做单片机开发肯定路子会更广一些,向上可以做IC设计,向下嵌入式、单片机什么的工作也能胜任。
FPGA&ASIC
IP&SOC设计
# ASIC/FPGA
# 嵌入式
# SOC设计
刘航宇
3年前
0
4,837
5
2023-11-01
机器学习/深度学习-10个激活函数详解
摘要本文详细介绍了深度学习中常见的十种激活函数,包括Sigmoid、Tanh、ReLU、Leaky ReLU、ELU、PReLU、Softmax、Swish、Maxout和Softplus,并分析了它们的优缺点。关键词:机器学习, 深度学习, 激活函数, Sigmoid, ReLU图片 综述 1. Sigmoid 激活函数 2. Tanh / 双曲正切激活函数 3. ReLU 激活函数 4. Leaky ReLU 5. ELU 6. PReLU(Parametric ReLU) 7. Softmax 8. Swish 9. Maxout 10. Softplus 综述 激活函数(Activation Function)是一种添加到人工神经网络中的函数,旨在帮助网络学习数据中的复杂模式。类似于人类大脑中基于神经元的模型,激活函数最终决定了要发射给下一个神经元的内容。 在人工神经网络中,一个节点的激活函数定义了该节点在给定的输入或输入集合下的输出。标准的计算机芯片电路可以看作是根据输入得到开(1)或关(0)输出的数字电路激活函数。因此,激活函数是确定神经网络输出的数学方程式,本文概述了深度学习中常见的十种激活函数及其优缺点。 首先我们来了解一下人工神经元的工作原理,大致如下: 图片 上述过程的数学可视化过程如下图所示: 图片 1. Sigmoid 激活函数 lofj8ajx.png图片 Sigmoid 函数的图像看起来像一个 S 形曲线。 函数表达式如下: $$\[\mathrm{f(z)=1/(1+e^{\wedge}-z)}\]$$ 在什么情况下适合使用 Sigmoid 激活函数呢? Sigmoid 函数的输出范围是 0 到 1。由于输出值限定在 0 到 1,因此它对每个神经元的输出进行了归一化; 用于将预测概率作为输出的模型。由于概率的取值范围是 0 到 1,因此 Sigmoid 函数非常合适; 梯度平滑,避免「跳跃」的输出值; 函数是可微的。这意味着可以找到任意两个点的 sigmoid 曲线的斜率; 明确的预测,即非常接近 1 或 0。 Sigmoid 激活函数有哪些缺点? 倾向于梯度消失; 函数输出不是以 0 为中心的,这会降低权重更新的效率; Sigmoid 函数执行指数运算,计算机运行得较慢。 2. Tanh / 双曲正切激活函数 图片 tanh 激活函数的图像也是 S 形,表达式如下: $$f(x)=tanh(x)=\frac{2}{1+e^{-2x}}-1$$ tanh 是一个双曲正切函数。tanh 函数和 sigmoid 函数的曲线相对相似。但是它比 sigmoid 函数更有一些优势。 图片 首先,当输入较大或较小时,输出几乎是平滑的并且梯度较小,这不利于权重更新。二者的区别在于输出间隔,tanh 的输出间隔为 1,并且整个函数以 0 为中心,比 sigmoid 函数更好; 在 tanh 图中,负输入将被强映射为负,而零输入被映射为接近零。 注意:在一般的二元分类问题中,tanh 函数用于隐藏层,而 sigmoid 函数用于输出层,但这并不是固定的,需要根据特定问题进行调整。 3. ReLU 激活函数 图片 ReLU 激活函数图像如上图所示,函数表达式如下: 图片 ReLU 函数是深度学习中较为流行的一种激活函数,相比于 sigmoid 函数和 tanh 函数,它具有如下优点: 当输入为正时,不存在梯度饱和问题。 计算速度快得多。ReLU 函数中只存在线性关系,因此它的计算速度比 sigmoid 和 tanh 更快 当然,它也有缺点: Dead ReLU 问题。当输入为负时,ReLU 完全失效,在正向传播过程中,这不是问题。有些区域很敏感,有些则不敏感。但是在反向传播过程中,如果输入负数,则梯度将完全为零,sigmoid 函数和 tanh 函数也具有相同的问题; 我们发现 ReLU 函数的输出为 0 或正数,这意味着 ReLU 函数不是以 0 为中心的函数。 4. Leaky ReLU 它是一种专门设计用于解决 Dead ReLU 问题的激活函数: 图片 ReLU vs Leaky ReLU 为什么 Leaky ReLU 比 ReLU 更好? $$f(y_i)=\begin{cases}y_i,&\text{if }y_i>0\\a_iy_i,&\text{if }y_i\leq0\end{cases}.$$ 1、Leaky ReLU 通过把 x 的非常小的线性分量给予负输入(0.01x)来调整负值的零梯度(zero gradients)问题; 2、leak 有助于扩大 ReLU 函数的范围,通常 a 的值为 0.01 左右; 3、Leaky ReLU 的函数范围是(负无穷到正无穷)。 注意:从理论上讲,Leaky ReLU 具有 ReLU 的所有优点,而且 Dead ReLU 不会有任何问题,但在实际操作中,尚未完全证明 Leaky ReLU 总是比 ReLU 更好。 5. ELU 图片 ELU vs Leaky ReLU vs ReLU ELU 的提出也解决了 ReLU 的问题。与 ReLU 相比,ELU 有负值,这会使激活的平均值接近零。均值激活接近于零可以使学习更快,因为它们使梯度更接近自然梯度。 图片 显然,ELU 具有 ReLU 的所有优点,并且: 没有 Dead ReLU 问题,输出的平均值接近 0,以 0 为中心; ELU 通过减少偏置偏移的影响,使正常梯度更接近于单位自然梯度,从而使均值向零加速学习; ELU 在较小的输入下会饱和至负值,从而减少前向传播的变异和信息。 一个小问题是它的计算强度更高。与 Leaky ReLU 类似,尽管理论上比 ReLU 要好,但目前在实践中没有充分的证据表明 ELU 总是比 ReLU 好。 6. PReLU(Parametric ReLU) 图片 PReLU 也是 ReLU 的改进版本: $$f(y_i)=\begin{cases}y_i,&\text{if }y_i>0\\a_iy_i,&\text{if }y_i\leq0\end{cases}.$$ 看一下 PReLU 的公式:参数α通常为 0 到 1 之间的数字,并且通常相对较小。 如果 a_i= 0,则 f 变为 ReLU 如果 a_i> 0,则 f 变为 leaky ReLU 如果 a_i 是可学习的参数,则 f 变为 PReLU PReLU 的优点如下: 在负值域,PReLU 的斜率较小,这也可以避免 Dead ReLU 问题。 与 ELU 相比,PReLU 在负值域是线性运算。尽管斜率很小,但不会趋于 0。 7. Softmax 图片 Softmax 是用于多类分类问题的激活函数,在多类分类问题中,超过两个类标签则需要类成员关系。对于长度为 K 的任意实向量,Softmax 可以将其压缩为长度为 K,值在(0,1)范围内,并且向量中元素的总和为 1 的实向量。 图片 Softmax 与正常的 max 函数不同:max 函数仅输出最大值,但 Softmax 确保较小的值具有较小的概率,并且不会直接丢弃。我们可以认为它是 argmax 函数的概率版本或「soft」版本。 Softmax 函数的分母结合了原始输出值的所有因子,这意味着 Softmax 函数获得的各种概率彼此相关。 Softmax 激活函数的主要缺点是: 在零点不可微; 负输入的梯度为零,这意味着对于该区域的激活,权重不会在反向传播期间更新,因此会产生永不激活的死亡神经元。 8. Swish 图片 函数表达式:y = x * sigmoid (x) Swish 的设计受到了 LSTM 和高速网络中 gating 的 sigmoid 函数使用的启发。我们使用相同的 gating 值来简化 gating 机制,这称为 self-gating。 self-gating 的优点在于它只需要简单的标量输入,而普通的 gating 则需要多个标量输入。这使得诸如 Swish 之类的 self-gated 激活函数能够轻松替换以单个标量为输入的激活函数(例如 ReLU),而无需更改隐藏容量或参数数量。 Swish 激活函数的主要优点如下: 「无界性」有助于防止慢速训练期间,梯度逐渐接近 0 并导致饱和;(同时,有界性也是有优势的,因为有界激活函数可以具有很强的正则化,并且较大的负输入问题也能解决); 导数恒 > 0; 平滑度在优化和泛化中起了重要作用。 9. Maxout 图片 在 Maxout 层,激活函数是输入的最大值,因此只有 2 个 maxout 节点的多层感知机就可以拟合任意的凸函数。 单个 Maxout 节点可以解释为对一个实值函数进行分段线性近似 (PWL) ,其中函数图上任意两点之间的线段位于图(凸函数)的上方。 $ReLU=\max\bigl(0,x\bigr),\mathrm{abs}\bigl(x\bigr)=\max\bigl(x,-x\bigr)$ Maxout 也可以对 d 维向量(V)实现: 图片 假设两个凸函数 h_1(x) 和 h_2(x),由两个 Maxout 节点近似化,函数 g(x) 是连续的 PWL 函数。 $$g\bigl(x\bigr)=h_1\bigl(x\bigr)-h_2\bigl(x\bigr)$$ 因此,由两个 Maxout 节点组成的 Maxout 层可以很好地近似任何连续函数。 图片 10. Softplus 图片 Softplus 函数:f(x)= ln(1 + exp x) Softplus 的导数为 f ′(x)=exp(x) / ( 1+exp x ) = 1/ (1 +exp(−x )) ,也称为 logistic / sigmoid 函数。 Softplus 函数类似于 ReLU 函数,但是相对较平滑,像 ReLU 一样是单侧抑制。它的接受范围很广:(0, + inf)。
机器学习
# 机器学习
# 软件算法
# DL/ML
刘航宇
3年前
0
709
0
2023-10-15
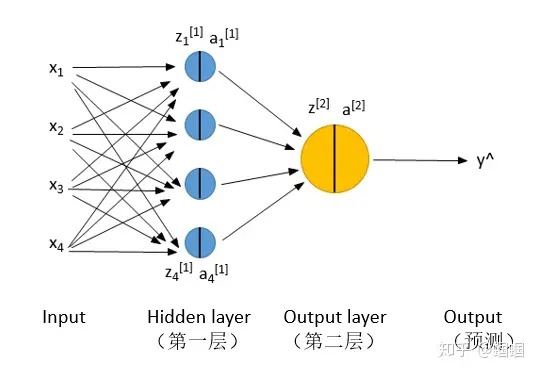
DL-神经网络的正向传播与反向传播
摘要本文介绍了神经网络的基本概念,包括前向传播和反向传播。前向传播从输入层开始,通过隐层计算输出;反向传播则根据损失函数计算参数的梯度,以更新网络参数。同时,文章还讨论了深层神经网络和单个神经元的工作原理。关键词:神经网络, 正向传播, 反向传播, 激活函数, 梯度下降神经网络简述 前向传播 反向传播 四、深层神经网络(Deep Neural Network) 1.单个神经元 2.由神经元组成的神经网络 3.目标函数 4.求解损失函数对某个权值的梯度 5.反向传播算法Backpropgation 5.2 计算一个梯度 5.3 反向传播误差 6.优化示例 神经网络简述 神经网络,就是在Logistic regression的基础上增加了一个或几个隐层(hidden layer),下面展示的是一个最最最简单的神经网络,只有两层: 两层神经网络 图片 需要注意的是,上面的图是“两层”,而不是三层或者四层,输入和输出不算层! 这里,我们先规定一下记号(Notation): z是x和w、b线性运算的结果,z=wx+b; a是z的激活值; 下标的1,2,3,4代表该层的第i个神经元(unit); 上标的[1],[2]等代表当前是第几层。 y^代表模型的输出,y才是真实值,也就是标签 另外,有一点经常搞混: 上图中的x1,x2,x3,x4不是代表4个样本!而是一个样本的四个特征(4个维度的值)! 你如果有m个样本,代表要把上图的过程重复m次: 图片 神经网络的“两个传播”: 前向传播(Forward Propagation)前向传播就是从input,经过一层层的layer,不断计算每一层的z和a,最后得到输出y^ 的过程,计算出了y^,就可以根据它和真实值y的差别来计算损失(loss)。 反向传播(Backward Propagation)反向传播就是根据损失函数L(y^,y)来反方向地计算每一层的z、a、w、b的偏导数(梯度),从而更新参数。 前向传播和反向传播: 图片 每经过一次前向传播和反向传播之后,参数就更新一次,然后用新的参数再次循环上面的过程。这就是神经网络训练的整个过程。 前向传播 如果用for循环一个样本一个样本的计算,显然太慢,是使用Vectorization,把m个样本压缩成一个向量X来计算,同样的把z、a都进行向量化处理得到Z、A,这样就可以对m的样本同时进行表示和计算了。不熟悉的朋友可以看这里: 这样,我们用公式在表示一下我们的两层神经网络的前向传播过程: Layer 1:Z[1] = W[1]·X + b[1]A[1] = σ(Z[1]) Layer 2:Z[2] = W[2]·A[1] + b[2]A[2] = σ(Z[2]) 而我们知道,X其实就是A[0],所以不难看出:每一层的计算都是一样的: Layer i:Z[i] = W[i]·A[i-1] + b[i]A[i] = σ(Z[i]) (注:σ是sigmoid函数) 因此,其实不管我们神经网络有几层,都是将上面过程的重复。 对于 损失函数,就跟Logistic regression中的一样,使用 “交叉熵(cross-entropy)”,公式就是 二分类问题:L(y^,y) = -[y·log(y^ )+(1-y)·log(1-y^ )]- 多分类问题:L=-Σy(j)·y^(j) 这个是每个样本的loss,我们一般还要计算整个样本集的loss,也称为cost,用J表示,J就是L的平均: J(W,b) = 1/m·ΣL(y^(i),y(i)) 上面的求Z、A、L、J的过程就是正向传播。 反向传播 反向传播说白了根据根据J的公式对W和b求偏导,也就是求梯度。因为我们需要用梯度下降法来对参数进行更新,而更新就需要梯度。 但是,根据求偏导的链式法则我们知道,第l层的参数的梯度,需要通过l+1层的梯度来求得,因此我们求导的过程是“反向”的,这也就是为什么叫“反向传播”。 具体求导的过程,这里就不赘述了。像各种 深度学习框架TensorFlow、Keras,它们都是 只需要我们自己构建正向传播过程, 反向传播的过程是自动完成的,所以大家也确实不用操这个心。 进行了反向传播之后,我们就可以根据每一层的参数的梯度来更新参数了,更新了之后,重复正向、反向传播的过程,就可以不断训练学习更好的参数了。 四、深层神经网络(Deep Neural Network) 前面的讲解都是拿一个两层的很浅的神经网络为例的。 深层神经网络也没什么神秘,就是多了几个/几十个/上百个hidden layers罢了。 可以用一个简单的示意图表示: 深层神经网络: 图片 注意,在深层神经网络中,我们在中间层使用了 “ReLU”激活函数,而不是sigmoid函数了,只有在最后的输出层才使用了sigmoid函数,这是因为 ReLU函数在求梯度的时候更快,还可以一定程度上防止梯度消失现象,因此在深层的网络中常常采用。 关于深层神经网络,我们有必要再详细的观察一下它的结构,尤其是 每一层的各个变量的维度,毕竟我们在搭建模型的时候,维度至关重要。 图片 我们设: 总共有m个样本,问题为二分类问题(即y为0,1); 网络总共有L层,当前层为l层(l=1,2,...,L); 第l层的单元数为n[l];那么下面参数或变量的维度为: W[l]:(n[l],n[l-1])(该层的单元数,上层的单元数) b[l]:(n[l],1) z[l]:(n[l],1) Z[l]:(n[l],m) a[l]:(n[l],1) A[l]:(n[l],m) X:(n[0],m) Y:(1,m) 可能有人问,为什么 W和b的维度里面没有m? 因为 W和b对每个样本都是一样的,所有样本采用同一套参数(W,b), 而Z和A就不一样了,虽然计算时的参数一样,但是样本不一样的话,计算结果也不一样,所以维度中有m。 深度神经网络的正向传播、反向传播和前面写的2层的神经网络类似,就是多了几层,然后中间的激活函数由sigmoid变为ReLU了。 1.单个神经元 神经网络是由一系列神经元组成的模型,每一个神经元实际上做得事情就是实现非线性变换。 如下图就是一个神经元的结构: 图片 神经元将两个部分:上一层的输出(x1,x2,....,xn)与权重(w1,w2,....,wn),对应相乘相加,然后再加上一个偏置 b之后的值经过激活函数处理后完成非线性变换。 记 z = w ⋅ x + b ,a=σ(z),则 z 是神经元非线性变换之前的结果,这部分仅仅是一个简单的线性函数。σ 是Sigmod激活函数,该函数可以将无穷区间内的数映射到(-1,1)的范围内。a 是神经元将 z z 进行非线性变换之后的结果。 Sigmod函数图像如下图 $$\mathrm{sigmod(x)=\frac{1}{1+e^{-x}}}$$ 图片 因此,结果 a 就等于: 图片 这里再强调一遍,神经元的本质就是做非线性变换 2.由神经元组成的神经网络 神经元可以理解成一个函数,神经网络就是由很多个非线性变换的神经元组成的模型,因此神经网络可以理解成是一个非常复杂的复合函数。 图片 对于上图中的网络: (x1,x2,....,xn)为n维输入向量 Wij,表示后一层低i个神经元与前一层第j个神经元之间的权值 z = Wx + b是没有经过激活函数非线性变换之前的结果 a=σ(z),是 z 经过激活函数非线性变换之后的结果 \mathrm{s=U^Ta},为网络最终的输出结果。 3.目标函数 以折页损失为目标函数: $$\mathrm{minmizeJ}=\max(\Delta+s_{c}-s,0)$$ 其中$\mathrm{s_c=U^T\sigma(Wx_c+b),s=U^T\sigma(Wx+b)}$。一般可以把$\Delta$固定下来,比如设为1或者10。 一般来说,学习算法的学习过程就是优化调整参数,使得损失函数,或者说预测结果和实际结果的误差减小。BP算法其实是一个双向算法,包含两个步骤: 1.正向传递输入信息,得到 Loss 值。 2.反向传播误差,从而由优化算法来调整网络权值。 4.求解损失函数对某个权值的梯度 图片 其中$\mathrm{s_c=U^T\sigma(Wx_c+b),s=U^T\sigma(Wx+b)}$。一般可以把$\Delta$固定下来,比如设为1或者10。 对于上面的图, 假设图中指示出的网络中的某个权值 w$_\mathrm{jk}^\mathrm{l}$ 发生了一个小的改变 $\Delta w_\mathrm{jk}^\mathrm{l}$ , 假设网络最终损失函数的输出为$\mathbb{C}$,则 C 应该是关于 $\mathrm{w}_\mathrm{jk}^{\mathrm{l}}$ 的一个复合函数。 所谓复合函数,就是把 $\mathbb{C}$ 看成因变量,则$\mathrm{w}_\mathrm{jk}^{\mathrm{l}}$ 可以看成导致 C 改变的自变量, 比如假设有一个复 合函数 $\mathrm{y=f(g(x))}$,则 y 就好比这里的$\mathbb{C}$ , x 就好比$\mathrm{w}_{\mathrm{jk}}^{\mathrm{l}}$, w$_{jk}^{\mathrm{l}}$ 每经过一层网络可以看成是经过某个函数的处理。而下面求写的时候都用偏导数, 是因为虽然我们这里只关注了一个 w$_\mathrm{jk}^{\mathrm{l}}$,但是实际上网络中的每一个 w 都可以看成一个 x。 显然,这个$\Delta w_\mathrm{jk}^\mathrm{l}$的变化会引起下一层直接与其相连的一个神经元,以及下一层之后所有神经元直到 最终输出 C 的变化, 如图中蓝线标记的就是该权值变化的影响传播路径。 把 C 的改变记为 $\Delta\mathbb{C}$, 则根据高等数学中导数的知识可以得到: 则神经元 a$_\mathrm{j}^1$ 下面一层第 q 个与其相连的神经元 a$_{\mathrm{q}}^{1+1}$ 的变化为: $$ \Delta\mathrm{a_q^{1+1}}\approx\frac{\partial\mathrm{a_q^{1+1}}}{\partial\mathrm{a_j^1}}\Delta\mathrm{a_j^1} $$将 $(2)$ 代入 (3) 可以得到: $$ \Delta\mathrm{a_{q}^{l+1}}\:\approx\:\frac{\partial\mathrm{a_{q}^{l+1}}}{\partial\mathrm{a_{j}^{l}}}\:\frac{\partial\mathrm{a_{j}^{l}}}{\partial\mathrm{w_{jk}^{l}}}\:\Delta\mathrm{w_{jk}^{l}} $$假设从 $\mathrm{a_j}^1$ 到 C的一条路径为$\mathrm{a_j}^1,\mathrm{a_q}^{1+1},...,\mathrm{a_n}^{\mathrm{L-1}},\mathrm{a_m}^{\mathrm{L}}$,则在该条路径上 C 的变化量 $\Delta C$ 为: $$\Delta\mathrm{C}\approx\frac{\partial\mathrm{C}}{\partial\mathrm{a}_\mathrm{m}^\mathrm{L}}\frac{\partial\mathrm{a}_\mathrm{m}^\mathrm{L}}{\partial\mathrm{a}_\mathrm{n}^\mathrm{L-1}}\frac{\partial\mathrm{a}_\mathrm{n}^\mathrm{L-1}}{\partial\mathrm{a}_\mathrm{p}^\mathrm{L-2}}[USD3P]\frac{\partial\mathrm{a}_\mathrm{q}^\mathrm{l+1}}{\partial\mathrm{a}_\mathrm{j}^\mathrm{l}}\frac{\partial\mathrm{a}_\mathrm{j}^\mathrm{l}}{\partial\mathrm{w}_\mathrm{jk}^\mathrm{l}}\Delta\mathrm{w}_\mathrm{jk}^\mathrm{l}$$ 至此,我们已经得到了一条路径上的变化量, 其实本质就是链式求导法则,或者说是复合函数求导法则。那么整个的变化量就县把所有可能链路上的变化量加起来: $$\Delta\mathrm{C}\approx\sum_{\mathrm{minp[USD3P]q}}\frac{\partial\mathrm{C}}{\partial\mathrm{a_{m}^{L}}}\frac{\partial\mathrm{a_{m}^{L}}}{\partial\mathrm{a_{n}^{L-1}}}\frac{\partial\mathrm{a_{n}^{L-1}}}{\partial\mathrm{a_{p}^{L-2}}}[USD3P]\frac{\partial\mathrm{a_{q}^{l+1}}}{\partial\mathrm{a_{j}^{l}}}\frac{\partial\mathrm{a_{j}^{l}}}{\partial\mathrm{w_{jk}^{l}}}\Delta\mathrm{w_{jk}^{l}}$$ $$\begin{aligned}\text{则 C 对某个权值 w}_{\mathrm{jk}}^{\dagger}&\text{的梯度为:}\\&\frac{\partial\mathrm{C}}{\partial\mathrm{w}_{\mathrm{jk}}^{\dagger}}\approx\sum_{\mathrm{nmp},
机器学习
# DL/ML
刘航宇
3年前
0
697
2
2023-07-21
嵌入式软件-无需排序找数字
摘要文章介绍了在不允许排序的情况下,如何快速找到一组随机排列的1000个整数中,从小到大排序后第450小的数字。通过使用哈希表或频率表的方法,可以统计每个数字出现的次数,然后累加直到达到或超过450次,从而找到目标数字。关键词:嵌入式软件, 数字查找, 无需排序, 哈希表, 频率统计题目 示例 解答code1 code2 题目 有1000个整数,每个数字都在1~200之间,数字随机排布。假设不允许你使用任何排序方法将这些整数有序化,你能快速找到从0开始的第450小的数字吗?(从小到大第450位) 示例 输入 - [184, 87, 178, 116, 194, 136, 187, 93, 50, 22, 163, 28, 91, 60, 164, 127, 141, 27, 173, 137, 12, 169, 168, 30, 183, 131, 63, 124, 68, 136, 130, 3, 23, 59, 70, 168, 194, 57, 12, 43, 30, 174, 22, 120, 185, 138, 199, 125, 116, 171, 14, 127, 92, 181, 157, 74, 63, 171, 197, 82, 106, 126, 85, 128, 137, 106, 47, 130, 114, 58, 125, 96, 183, 146, 15, 168, 35, 165, 44, 151, 88, 9, 77, 179, 189, 185, 4, 52, 155, 200, 133, 61, 77, 169, 140, 13, 27, 187, 95, 140, 196, 171, 35, 179, 68, 2, 98, 103, 118, 93, 53, 157, 102, 81, 87, 42, 66, 90, 45, 20, 41, 130, 32, 118, 98, 172, 82, 76, 110, 128, 168, 57, 98, 154, 187, 166, 107, 84, 20, 25, 129, 72, 133, 30, 104, 20, 71, 169, 109, 116, 141, 150, 197, 124, 19, 46, 47, 52, 122, 156, 180, 89, 165, 29, 42, 151, 194, 101, 35, 165, 125, 115, 188, 57, 144, 92, 28, 166, 60, 137, 33, 152, 38, 29, 76, 8, 75, 122, 59, 196, 30, 38, 36, 194, 19, 29, 144, 12, 129, 130, 177, 5, 44, 164, 14, 139, 7, 41, 105, 19, 129, 89, 170, 118, 118, 197, 125, 144, 71, 184, 91, 100, 173, 126, 45, 191, 106, 140, 155, 187, 70, 83, 143, 65, 198, 108, 156, 5, 149, 12, 23, 29, 100, 144, 147, 169, 141, 23, 112, 11, 6, 2, 62, 131, 79, 106, 121, 137, 45, 27, 123, 66, 109, 17, 83, 59, 125, 38, 63, 25, 1, 37, 53, 100, 180, 151, 69, 72, 174, 132, 82, 131, 134, 95, 61, 164, 200, 182, 100, 197, 160, 174, 14, 69, 191, 96, 127, 67, 85, 141, 91, 85, 177, 143, 137, 108, 46, 157, 180, 19, 88, 13, 149, 173, 60, 10, 137, 11, 143, 188, 7, 102, 114, 173, 122, 56, 20, 200, 122, 105, 140, 12, 141, 68, 106, 29, 128, 151, 185, 59, 121, 25, 23, 70, 197, 82, 31, 85, 93, 173, 73, 51, 26, 186, 23, 100, 41, 43, 99, 114, 99, 191, 125, 191, 10, 182, 20, 137, 133, 156, 195, 5, 180, 170, 74, 177, 51, 56, 61, 143, 180, 85, 194, 6, 22, 168, 105, 14, 162, 155, 127, 60, 145, 3, 3, 107, 185, 22, 43, 69, 129, 190, 73, 109, 159, 99, 37, 9, 154, 49, 104, 134, 134, 49, 91, 155, 168, 147, 169, 130, 101, 47, 189, 198, 50, 191, 104, 34, 164, 98, 54, 93, 87, 126, 153, 197, 176, 189, 158, 130, 37, 61, 15, 122, 61, 105, 29, 28, 51, 149, 157, 103, 195, 98, 100, 44, 40, 3, 29, 4, 101, 82, 48, 139, 160, 152, 136, 135, 140, 93, 16, 128, 105, 30, 50, 165, 86, 30, 144, 136, 178, 101, 39, 172, 150, 90, 168, 189, 93, 196, 144, 145, 30, 191, 83, 141, 142, 170, 27, 33, 62, 43, 161, 118, 24, 162, 82, 110, 191, 26, 197, 168, 78, 35, 91, 27, 125, 58, 15, 169, 6, 159, 113, 187, 101, 147, 127, 195, 117, 153, 179, 130, 147, 91, 48, 171, 52, 81, 32, 194, 58, 28, 113, 87, 15, 156, 113, 91, 13, 80, 11, 170, 190, 75, 156, 42, 21, 34, 188, 89, 139, 167, 171, 85, 57, 18, 7, 61, 50, 38, 6, 60, 18, 119, 146, 184, 74, 59, 74, 38, 90, 84, 8, 79, 158, 115, 72, 130, 101, 60, 19, 39, 26, 189, 75, 34, 158, 82, 94, 159, 71, 100, 18, 40, 170, 164, 23, 195, 174, 48, 32, 63, 83, 191, 93, 192, 58, 116, 122, 158, 175, 92, 148, 152, 32, 22, 138, 141, 55, 31, 99, 126, 82, 117, 117, 3, 32, 140, 197, 5, 139, 181, 19, 22, 171, 63, 13, 180, 178, 86, 137, 105, 177, 84, 8, 160, 58, 145, 100, 112, 128, 151, 37, 161, 19, 106, 164, 50, 45, 112, 6, 135, 92, 176, 156, 15, 190, 169, 194, 119, 6, 83, 23, 183, 118, 31, 94, 175, 127, 194, 87, 54, 144, 75, 15, 114, 180, 178, 163, 176, 89, 120, 111, 133, 95, 18, 147, 36, 138, 92, 154, 144, 174, 129, 126, 92, 111, 19, 18, 37, 164, 56, 91, 59, 131, 105, 172, 62, 34, 86, 190, 74, 5, 52, 6, 51, 69, 104, 86, 7, 196, 40, 150, 121, 168, 27, 164, 78, 197, 182, 66, 161, 37, 156, 171, 119, 12, 143, 133, 197, 180, 122, 71, 185, 173, 28, 35, 41, 84, 73, 199, 31, 64, 148, 151, 31, 174, 115, 60, 123, 48, 125, 83, 36, 33, 5, 155, 44, 99, 87, 41, 79, 160, 63, 63, 84, 42, 49, 124, 125, 73, 123, 155, 136, 22, 58, 166, 148, 172, 177, 70, 19, 102, 104, 54, 134, 108, 160, 129, 7, 198, 121, 85, 109, 135, 99, 192, 177, 99, 116, 53, 172, 190, 160, 107, 11, 17, 25, 110, 140, 1, 179, 110, 54, 82, 115, 139, 190, 27, 68, 148, 24, 188, 32, 133, 123, 82, 76, 51, 180, 191, 55, 151, 132, 14, 58, 95, 182, 82, 4, 121, 34, 183, 182, 88, 16, 97, 26, 5, 123, 93, 152, 98, 33, 135, 182, 107, 16, 58, 109, 196, 200, 163, 98, 84, 177, 155, 178, 110, 188, 133, 183, 22, 67, 164, 61, 83, 12, 86, 87, 86, 131, 191, 184, 115, 77, 117, 21, 93, 126, 129, 40, 126, 91, 137, 161, 19, 44, 138, 129, 183, 22, 111, 156, 89, 26, 16, 171, 38, 54, 9, 123, 184, 151, 58, 98, 28, 127, 70, 72, 52, 150, 111, 129, 40, 199, 89, 11, 194, 178, 91, 177, 200, 153, 132, 88, 178, 100, 58, 167, 153, 18, 42, 136, 169, 99, 185, 196, 177, 6, 67, 29, 155, 129, 109, 194, 79, 198, 156, 73, 175, 46, 1, 126, 198, 84, 13, 128, 183, 22] 输出 - 94 解答 解法一:1、不能排序 2、找从0开始的第450位小的数,注意的“从0开始”这句话。[0-450]这个区间总共有451个数,因此我们需要找的是第451位小的数 开始做题---------------------------------------------------------- 可以利用hash表的特性,使用一个201大小的数组,数组的下标为数据的值,数组的值为数据出现的次数。 可以这么理解 key->代表数据,同时也是数组下标 value->代表数据出现的次数 首先给数组元素初始化为0,也就是每个数据出现的次数都是0。 接着使用循环将每个数据出现的次数添加到数组中 再利用循环将出现的次数累加,如果次数累加到450,就说明找到了第450大的数 code1 /* 1、定义一个大小为201的整型数组arr,用来存储每个数在数组numbers中出现的次数。使用memset函数将所有元素初始化为0。 2、定义一个整型变量i,用来作为循环的计数器。初始化为0。 3、使用while循环遍历数组numbers,对于每个数,将其作为arr的下标,将arr对应的元素加一,表示该数出现了一次。同时将i加一,表示下一个数。 4、重新将i赋值为1,表示从第一个数开始计算出现次数之和。 5、定义一个整型变量sum,用来累计前面的数出现的次数之和。初始化为0。 6、使用while循环遍历arr,从下标1开始,对于每个元素,将其加到sum上,然后判断sum是否大于或等于451。如果是,则跳出循环,表示找到了满足条件的数。如果不是,则继续遍历。 7、返回i,表示找到的数。 */ int find(int* numbers, int numbersLen ) { // write code here int arr[201], i=0, sum=0; //定义一个大小为201的整型数组arr,用来存储每个数在数组numbers中出现的次数。定义一个整型变量i,用来作为循环的计数器。定义一个整型变量sum,用来累计前面的数出现的次数之和。 //初始化数组元素 memset(arr,0,sizeof(arr)); //使用memset函数将所有元素初始化为0。 //循环添加每个数据出现的次数 while(i < numbersLen){ //使用while循环遍历数组numbers arr[numbers[i]]++; //对于每个数,将其作为arr的下标,将arr对应的元素加一,表示该数出现了一次。 i++; //同时将i加一,表示下一个数。 } //循环计算次数,当次数超过451次,那就是找到了 i=1; //重新将i赋值为1,表示从第一个数开始计算出现次数之和。 while((sum=sum+arr[i]) < 451){ //使用while循环遍历arr,从下标1开始 i++; //对于每个元素,将其加到sum上,并将i加一。 } return i; //返回i,表示找到的数。 } code2 解法二:因为知道每个数字的大小:1~200,所以无论序列有多少个数字,可以根据一个200行的表,然后统计所有数字出现的频率。 这个思路在硬件设计上常见,即用数字的值代表查表的地址。 /* 1、定义一个大小为201的整型数组table,用来存储每个数在数组numbers中出现的次数。初始化为0。 2、遍历数组numbers,对于每个数,将其作为table的下标,将table对应的元素加一,表示该数出现了一次。 3、定义一个整型变量acc,用来累计前面的数出现的次数之和。初始化为0。 4、遍历table,从下标1开始,对于每个元素,将其加到acc上,然后判断acc是否大于或等于451。如果是,则返回当前的下标,表示找到了满足条件的数。如果不是,则继续遍历。 5、如果遍历完table都没有找到满足条件的数,则返回0。 */ /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param numbers int整型一维数组 * @param numbersLen int numbers数组长度 * @return int整型 */ int find(int* numbers, int numbersLen ) { // write code here int table[201] = {0}; //定义一个大小为201的整型数组table,用来存储每个数在数组numbers中出现的次数。初始化为0。 for (int i = 0; i < numbersLen; i++) { table[numbers[i]]++; //遍历数组numbers,对于每个数,将其作为table的下标,将table对应的元素加一,表示该数出现了一次。 } int acc = 0; //定义一个整型变量acc,用来累计前面的数出现的次数之和。初始化为0。 for (int i = 1; i < 201; i++) { acc += table[i]; //遍历table,从下标1开始,对于每个元素,将其加到acc上。 if (acc >= 451) return i; //判断acc是否大于或等于451。如果是,则返回当前的下标,表示找到了满足条件的数。 } return 0; //如果遍历完table都没有找到满足条件的数,则返回0。 }
嵌入式&系统
编程&脚本笔记
# 嵌入式
# C/C++
刘航宇
3年前
0
444
0
2023-07-19
嵌入式软件-基于C语言小端转大端
摘要本文介绍了嵌入式系统中大端小端转换的意义,并提供了四种基于C语言的实现方法,包括使用char指针、union联合体、按位操作和宏函数,以将小端模式的整数转换为大端模式。关键词:嵌入式软件,C语言,字节序转换,大端小端,网络通信意义 题目 示例 解答1.char指针,按字节替换 2.利用union联合体共用内存空间特性,使用char数组来改变 3. 使用按位与运算保留以获取每个字节,然后按位左移到正确位置并拼接 4. 使用预定义好的宏函数 意义 大端小端转化对嵌入式系统有意义,因为不同的处理器或者通信协议可能采用不同的字节序来存储或者传输数据。字节序是指一个多字节数据在内存中的存放顺序,它有两种主要的形式: 大端:最高有效位(MSB)存放在最低的内存地址,最低有效位(LSB)存放在最高的内存地址。 小端:最低有效位(LSB)存放在最低的内存地址,最高有效位(MSB)存放在最高的内存地址。 例如,一个32位的整数0x12345678,在大端系统中,它的内存布局是: pC703EF.png图片 而在小端系统中,它的内存布局是: pC70G4J.png图片 如果一个嵌入式系统需要和不同字节序的设备或者网络进行交互,就需要进行字节序的转换,否则会导致数据错误或者通信失败。例如,TCP/IP协议族中的所有层都采用大端字节序来表示数据包头中的16位或32位的值,如IP地址、包长、校验和等。如果一个嵌入式系统使用小端字节序的处理器,并且想要建立一个TCP连接,就需要将IP地址等信息从小端转换为大端再发送出去,否则对方无法正确解析。 题目 输入一个数字n,假设它是以小端模式保存在机器的,请将其转换为大端方式保存时的值。 示例 输入:1 返回值:16777216 解答 1.char指针,按字节替换 /* * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here int tmp = 0x00000000; //开辟新的int空间用于接收转化结果 unsigned char *p = &tmp, *q = &n; p[0] = q[3]; p[1] = q[2]; p[2] = q[1]; p[3] = q[0]; return tmp; }2.利用union联合体共用内存空间特性,使用char数组来改变 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ typedef union { int i; unsigned char c[4] } inc_u; int convert(int n ) { // write code here inc_u x; //这里也可以用新开辟空间进行置换 x.i = n; //利用按位异或运算可叠加、可还原性 x.c[0] ^= x.c[3], x.c[3] ^= x.c[0], x.c[0] ^= x.c[3]; //首尾两字节对调 x.c[1] ^= x.c[2], x.c[2] ^= x.c[1], x.c[1] ^= x.c[2]; //中间两字节对调 return x.i; /* 按位<<到正确位置,并用|拼装 return (x.c[0]<<24)|(x.c[1]<<16)|(x.c[2]<<8)|x.c[3]; */ }3. 使用按位与运算保留以获取每个字节,然后按位左移到正确位置并拼接 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here return (((n & 0xff000000)>>24) | ((n & 0x00ff0000)>>8 ) | ((n & 0x0000ff00)<<8 ) | ((n & 0x000000ff)<<24); //按位与时,遇0清零,遇1保留 ); }4. 使用预定义好的宏函数 本条方法参考 https://www.codeproject.com/Articles/4804/Basic-concepts-on-Endianness 文中提到网络上常用的套接字接口(socket API)指定了一种称为网络字节顺序的标准字节顺序,这个顺序其实就是大端模式;而当时,同时代的 x86 系列主机反而是小端模式。所以就促使产生了如: ntohs() convert Network order TO Host order in Short (16 bit 大转小); ntohl() convert Network order TO Host order in Long (32 bit 大转小); htons() convert Host order TO Network order in Short (16 bit 小转大); htonl() convert Host order TO Network order in Long (32 bit 小转大). 所以我们这里使用 32 bit 小转大的 htonl() 宏函数来解决这个问题。 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here return htonl(n); ); }
嵌入式&系统
编程&脚本笔记
# 嵌入式
# C/C++
刘航宇
3年前
0
665
1
2023-07-13
反向散射理论与ADG902电路实现
摘要后向散射通信技术通过改变标签反射系数实现信号传递,利用ADG902电路控制天线端口阻抗匹配,通过射频开关调节反射和吸收,实现基带信号传输。关键词:反向散射通信, ADG902电路, 后向散射通信技术, 阻抗匹配, 无线电波传输后向散射通信技术,是在天线对信号散射的基础上,采用标签后向散射的方式,通过改变发射端标签的反射系数来实现后向散射通信。无线电波在传输过程中,当通过不同介质时,因为介质阻抗的差异性,会产生反射作用,根据介质材料和阻抗的不同,会产生不同的反射量。因此通过调节天线端口的阻抗匹配度,入射的无线电波就可以产生不同反射量,导致入射信号和反射信号的差异性,也就是反射系数 Γ 。具体表示如下: $$\Gamma=\frac{Z_L-Z_0}{Z_L+Z_0}$$ 式中 Z0表示天线端的特征阻抗,一般是 50 Ω,ZL表示标签端口的输入阻抗,Γ表示入射信号振幅和反射信号振幅的复数比。当Γ=0 时,阻抗匹配,入射信号全部传递,无反射信号的产生;Γ = 1时,标签端的输入阻抗为开路,阻抗失配,入射信号被全部反射,产生幅值相同相位相同的反射信号;Γ = −1时,标签端的输入阻抗为短路状态,阻抗失配,入射信号被全部反射,产生幅值相同相位相反的反射信号。因此,通过改变标签的输入阻抗,产生不同的反射系数,就可以控制无线电波的入射和反射,实现有效信号的传递,这也就是后向散射通信的基本原理。为了实现上述后向散射通信,还需要加载天线端口的控制,结构如下图。通过射频开关来控制两个不同的负载阻抗与天线端口的连接,实现阻抗的匹配和失调,完成信号的入射和反射。当开关在负载 Z1和 Z2间转化时,由于负载阻抗的不同,载波信号在天线端的反射比例也不同,因此就产生了不同的调制载波。在实际通信中,为了达到最优传输质量,通常要使反射信号的差异最大,对应完全反射和完全吸收两种形式。对调制后的反射信号进行解调处理后,就可以得到所传递的基带信号,完成后向散射的通信。采用负载 50 Ω 的完全吸收和负载短路的完全反射两种信号传输差异,来实现后向散射的信息传输。 图片 使用后向散射开关 ADG 902 来实现基带信号对天线状态的控制,ADG 902 电路结构如图 4.12 所示。将数字基带信号的接入 ADG 902 的 CTRL 端,通过数字基带信号的“0”、“1”来控制 ADG 902 的关断和闭合,RF2 端连接射频天线。通过 ADG 902 中开关的关断,来控制天线对外界调制载波的反射和吸收。 注意:RF1接天线,RF2接地也可以,这里读者可自行证明 图片 当逻辑电平 CTRL=0时,S1关断,S2闭合,此时天线接收端口接地,由式可得,Z=0,T=1,载波信号被完全反射;当逻辑电平 CTRL=1 时,S1 闭合,S2 关断,此时天线接收端匹配,载波被完全吸收。
通信&信息处理
# 通信&射频
# 物联网
刘航宇
3年前
1
1,609
2
【转载】Libero SOC Debug教程-片上逻辑分析仪IDENTIFY
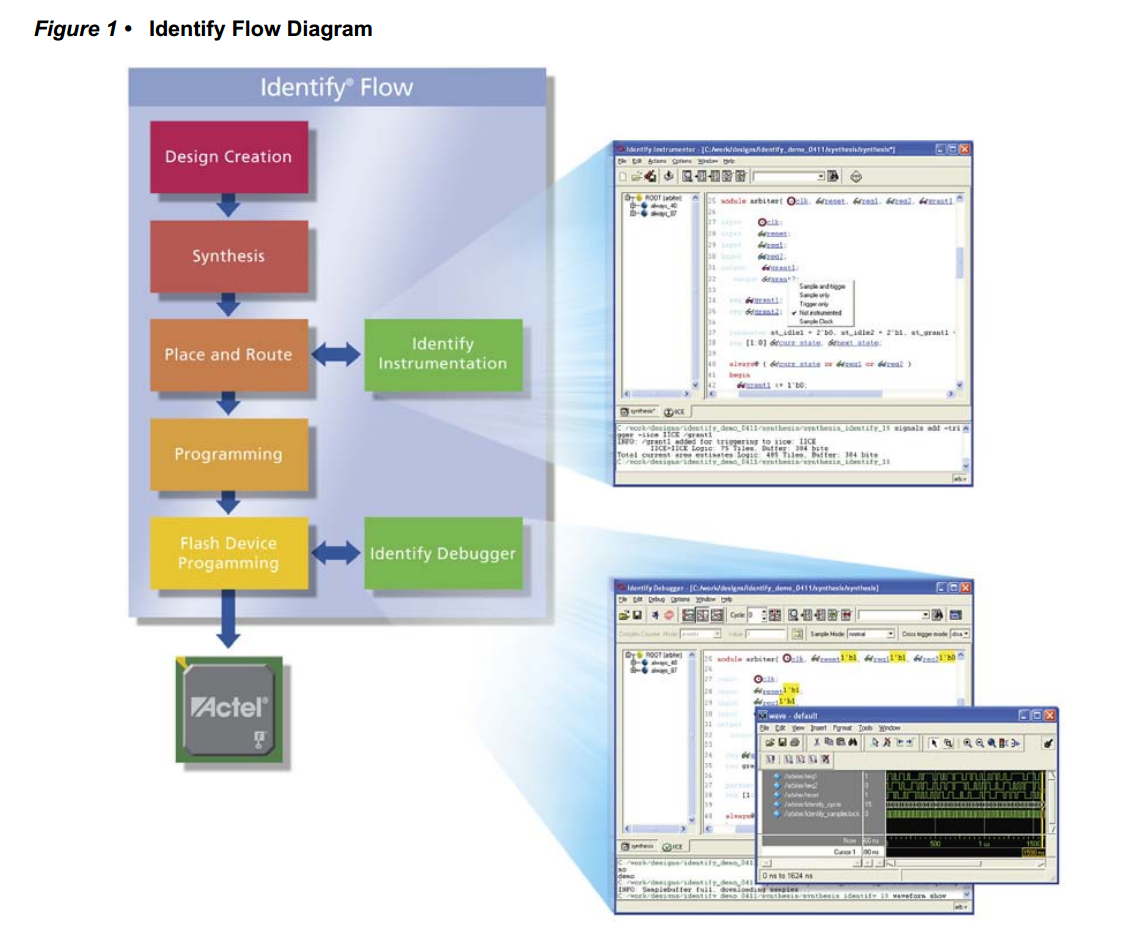
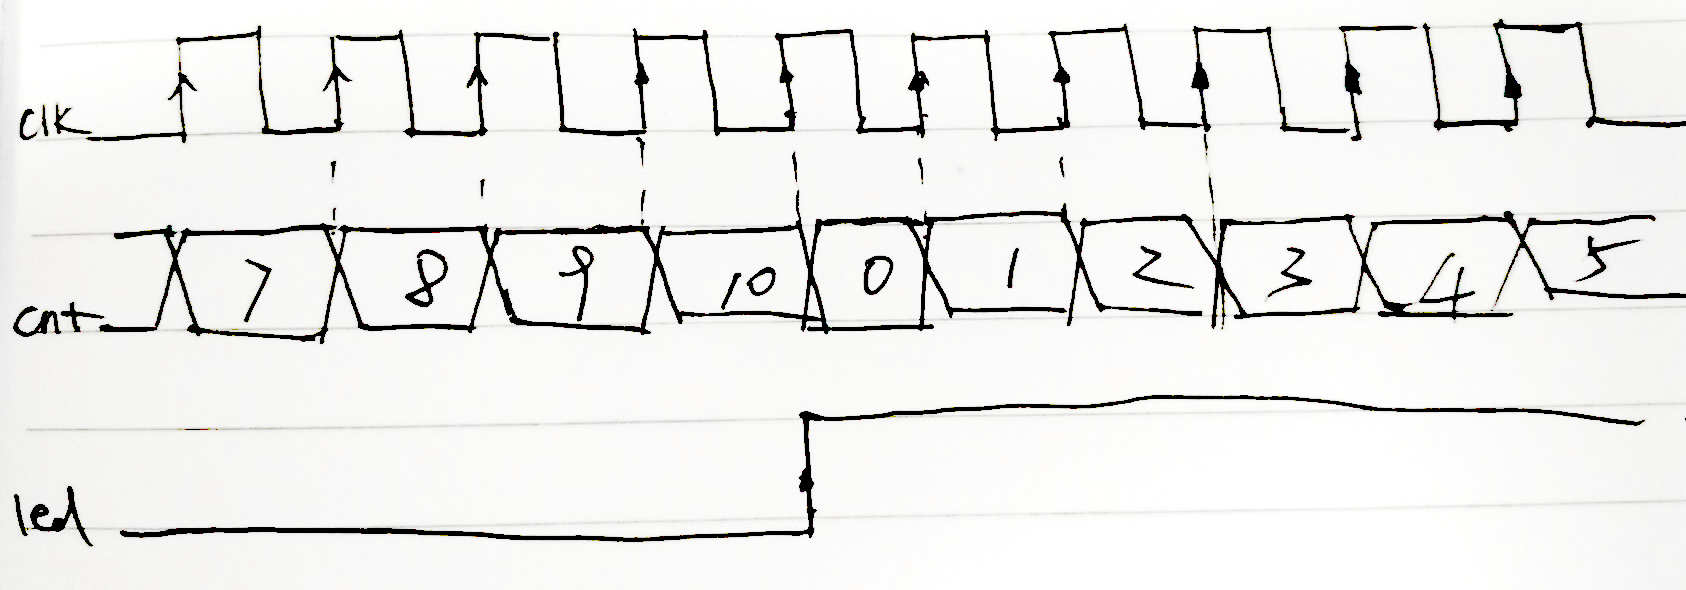
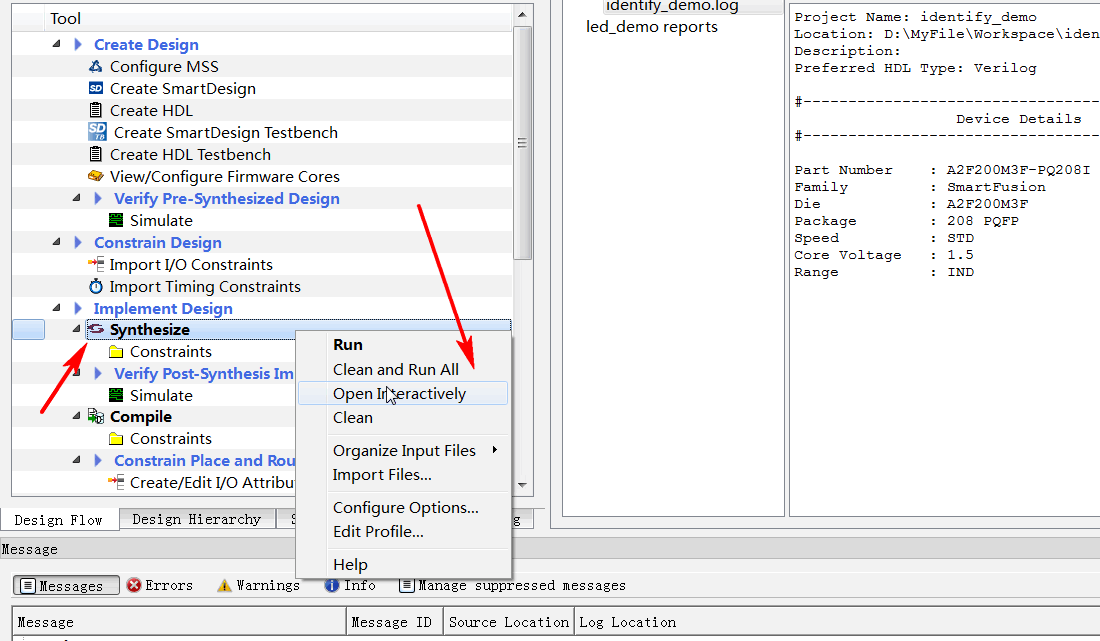
摘要本文介绍了Microsemi FPGA片上逻辑分析仪Identify的使用方法,包括原理、配置步骤和资源占用情况,适用于FPGA工程师进行硬件级程序调试。关键词:FPGA调试, 片上逻辑分析仪, Libero SoC, Identify工具, 逻辑资源本文转载于https://blog.csdn.net/whik1194/article/details/107074187 FPGA在线调试 关于MICROSEMI片上逻辑分析仪 FPGA片上逻辑分析仪原理 预期效果 0.准备一个创建好的LIBERO工程 1.新建IDENTIFY工程,并添加想要监测的信号 2.管脚分配,编译下载 3.设置触发类型 4.IICE逻辑分析仪核资源占用 原文: 参考: FPGA在线调试 对于嵌入式系统来说,如单片机,进行硬件级程序调试时,通常采用的是JLink/ST-Link调试器,在线调试的方式来获取程序实时运行的状态,可以观察程序运行流程、各种变量的值、中断的触发情况,还可以设置断点、单步运行,方便快速的发现BUG,解决问题。 但是对于FPGA来说,并不是顺序执行的,而是根据每一个Clk并行执行,所以我们不能使用调试器进行单步调试。 FPGA调试需要观察内部信号的值,各个信号之间的时序关系,所以使用逻辑分析仪是最好的调试方式了。 有些FPGA工程,对外的接口,即输入输出,可能只有几个,但是他们之间的逻辑和时序关系非常复杂,所以内部有几十个中间寄存器,程序下载进去了,发现不是我们想要的效果,怎么办?你可能会说,查代码吧!如果这个工程非常简单,你可能只需要耗费几分钟或者几个小时就可以定位代码的问题所在。 但是如果这是一个非常庞大的工程,内部的中间寄存器、信号,几百上千个,各个模块单独软件仿真都正常,整体仿真也正常,就是下载到实际的芯片中运行不正常。你如何进行问题定位?如果再去进行代码审查,这将会消耗非常多的时间。那么如果能在FPGA芯片内部装上一个逻辑分析仪,那不就直接可以看到内部信号的值了,而且还可以看到各个信号之间的时序关系。需求推动技术发展,既然开发者有这个需求,那么FPGA厂商肯定会实现这个功能!下面来一起看一下Microsemi FPGA片上逻辑分析仪的使用方法吧! 关于MICROSEMI片上逻辑分析仪 几大厂商的片上逻辑分析仪: Xilinx厂商ISE开发环境下的ChipScope工具 Altera厂商Quartus开发环境下的SignalTap工具 Lattice厂商Diamod开发环境下的Reveal工具 对于 FPGA 工程师来说,这些都是很熟悉的名字。和以上几大FPGA厂商一样,Microsemi Libero也支持片上逻辑分析仪工具,只不过不是自己家研发的,使用的是Synospsy公司出品的Identify工具,其实,Libero中的综合器synplify也是Synospsy公司的。 根据Synospsy官网的描述:Identify RTL 调试仪,这个调试工具除了支持Microsemi的FPGA产品外,还支持Altera和Xilinx的FPGA产品。 FPGA片上逻辑分析仪原理 Identify片上逻辑分析仪的原理,是通过在FPGA工程中加入一个IICE逻辑分析仪IP核,这个IP核,由控制器和采集器组成,采集器用于采集信号,控制器用于和JTAG调试器连接,并把数据发送到上位机,IICE内部有RAM空间,用于存储触发位置附近的信号,RAM空间的大小,即采样深度,可以自己调整。FPGA工程中加入IICE核,会占用一定的资源,资源占用的大小取决于:采样深度,采样信号的个数,采样信号的触发方式等。 所以综上,FPGA片上逻辑分析仪需要3个组件:片上的IICE逻辑分析仪核、JTAG下载器、上位机。 pC5Uq6e.png图片 JTAG下载器也就是我们下载程序时使用的FlashPro x下载器,上位机软件也就是Identify工具,这个工具已经在安装Libero SoC时一同安装并注册**了。所以不需要安装其他的工具软件,只需要在已经设计好的FPGA公司中,配置一下IIC逻辑分析仪核就可以了。 在已经创建好的Libero工程中,加入IICE逻辑分析仪核,并演示Identify工具的使用。 预期效果 以Microsemi SmartFusion系列的A2F200M3F芯片为例,其他芯片使用操作方法类似。示例工程功能:led每隔10个clk翻转一次为例,演示identify的使用。 identify添加完成之后,把led设置为上升沿触发,会抓取到类似如下的波形。 pChB2qJ.png图片 0.准备一个创建好的LIBERO工程 这里以LED每隔10个时钟周期翻转为例。HDL文件内容: module led_demo( //inputs input clk, input rst_n, //outputs output reg led ); reg [3:0] cnt; always @ (posedge clk) begin if(!rst_n) cnt <= 0; else if(cnt == 10) /* max=10, 0-10 */ cnt <= 0; else cnt <= cnt + 1; end always @ (posedge clk) begin if(!rst_n) led <= 0; else if(cnt == 10) led <= ~led; end endmodule1.新建IDENTIFY工程,并添加想要监测的信号 1.0 先运行Synthesize 1.1 在Synthesize上右键,选择Open Interactively pChr5jO.png图片 1.2 在Synthesis上右键新建一个Identify工程 pChrTDe.png图片 1.3 输入新建的identify工程的名称和保存路径,选择默认的就行。 pChrqUA.png图片 1.4 在新建的identify工程上右键选择identify instrumentor pChsSKS.png图片 1.5 在HDL文件中选择要监测的信号和采样时钟,采样时钟选择Sample Clock,作为触发的信号选择Trigger Only,要监测的信号选择Sample Only,也可以选择Sample and Trigger,这样会占用更多的资源。 pChsG26.png图片 pChsNrD.png图片 设置完成的信号会有标注 pChsgsS.png图片 sample clock 表示采样时钟,所有在 IICE 中添加的信号都会在 sample clock 的边沿进行采样,设为 sample clock 的信号前会出现一个时钟状的图标。 设置为 sample 和 trigger 的信号都将作为被采样信号,区别在于 sample 信号只能被采样,而 trigger 信号可以作为触发采集的条件,当然你可以把一个信号同时设置为 sample 和 trigger 。 1.6 设置采样深度,选择Instrumentor->IICE pChsWZQ.png图片 采样深度最大支持1048576 pChsfaj.png图片 输入采样深度,数值越大,采样时间越长,相应的FPGA资源占用也越多。 pChsqLF.png图片 1.7 选择Run->Run pChsOZ4.png图片 或者直接点击主界面的Run按钮 pChsjo9.png图片 1.8 编译完成之后,保存退出。 pChsxiR.png图片 2.管脚分配,编译下载 2.1 和正常流程一样,管脚分配,编译下载。可以看到JTAG部分的管脚已经被IICE逻辑分析仪核使用了 pChyiLD.png图片 2.2 在Identify Debug Design上右键,选择Open Interactively,打开identify工具 pChymWt.png图片 3.设置触发类型 3.1 选择要触发的信号,和触发类型,这里我选择的是led,上升沿触发。 pChyYYn.png图片 3.2 连接FlashPro下载器,点击小人图标,启动抓取,满足触发条件自动停止。 pChy6YR.png图片 D:/identify_demo/synthesis$ run -iice {IICE} INFO: run -iice IICE INFO: Info: Attempting to connect to: usb Info: Type: FlashPro4 Info: ID: 08152 Info: Connection: usb2.0 Info: Revision: UndefRev INFO: Checking communication with the Microsemi_BuiltinJTAG cable and the hardware INFO: The hardware is responding correctly INFO: Auto-detecting the device chain INFO: Device at chain position 1 is "A2F200M3F" INFO: IICE 'IICE' configured, waiting for trigger INFO: IICE 'IICE' Trigger detected, downloading samples INFO: notify -notify INFO: waveform viewer INFO: waveform viewer INFO: write vcd -iice IICE -comment {Identify created VCD dump} -gtkwave -noequiv IICE.vcd D:/identify_demo/synthesis$ 3.3 右侧黄色的显示就是触发瞬间时信号的值。右键可以改变数据格式。 pChyO6f.png图片 3.4 选择Debugger preferences可以设置采样时钟的周期,用于后面波形的时间测量 pChyz7Q.png图片 3.5 设置采样时钟的周期 pCh6Chn.png图片 3.6 点击波形按钮,在GTKWave中打开抓取到的波形。 pCh6kcV.png图片 3.7 可以按住左键拖动测量时间差 pCh6uN9.png图片 3.8 还可以给每个通道设置不同的颜色,和显示方式。 pCh6Q91.png图片 4.IICE逻辑分析仪核资源占用 IICE逻辑分析仪核占用的主要是逻辑资源和RAM资源,可以看到资源占用还是很多的。 图片 图片 原文: https://blog.csdn.net/whik1194/article/details/107074187 参考: https://zhuanlan.zhihu.com/p/88314552 https://www.synopsys.com/zh-cn/implementation-and-signoff/fpga-based-design/identify-rtl-debugger.html http://training.eeworld.com.cn/video/1059 https://www.microsemi.com/document-portal/doc_view/132760-synopsys-identify-me-h-2013-03m-sp1-user-guide
嵌入式&系统
FPGA&ASIC
# ASIC/FPGA
# 嵌入式
刘航宇
3年前
2
3,281
2
2023-07-10
Verilog实现AMBA--AHB To APB Bridge
摘要本文介绍了AMBA AHB到APB桥的Verilog实现,包括APB桥的功能、读/写传输过程、背靠背传输以及仿真验证。通过Verilog代码展示了AHB到APB桥的实现方法,并通过仿真验证了其正确性。关键词:Verilog, AMBA, AHB To APB Bridge, APB总线, 仿真1、APB桥 2、读传输 3、写传输 4、背靠背传输 5、AHB_to_APB Bridge的Verilog实现 6、仿真 1、APB桥 APB桥是AMBA APB总线上的唯一主机,也是AMBA AHB的一个从机。下图表示了APB桥接口信号: 图片 APB Bridge将AHB传输转成APB传输并实现一下功能: (1)对锁存的地址进行译码并产生选择信号PSELx,在传输过程中只有一个选择信号可以被激活。 也就是选择出唯一 一个APB从设备以进行读写动作。 (2)写操作时:负责将AHB送来的数据送上APB总线。 (3)读操作时:负责将APB的数据送上AHB系统总线。 (4)产生一时序选通信号PENABLE来作为数据传递时的启动信号 2、读传输 下图表示了APB到AHB的读传输: 图片 传输开始于AHB总线上的T1时刻,在T2时刻地址信息被APB采样,如果传输目标是外设总线,那么这个地址就会被译码成选择信号发给外设,T2即为APB总线的SETUP周期,T3为APB的ENABLE周期,PENABLE信号拉高。在该周期内,外设必须提供读数据,通常情况下,读数据直接AHB读数据总线上,总线主机在T4时刻对读数据进行采样。 在频率很高的情况下,在ENABLE CYCLE中可能数据不能够直接映射到AHB总线,需要在APB桥中在T4的时候打插入一个额外的等待周期,并在T5的时候才被AHB主采样。虽然需要多一个等待周期(一共2个),但是由于频率提升了因此总的性能也提升了。 下图表示了一个读突发传输,所有的传输都只有一个等待周期 图片 3、写传输 下图表示了一个写传输: 图片 APB总线上的单块数据写操作不需要等待周期。 APB桥负责对地址和数据进行采样,并在写操作的过程中保持它们的值。 下图表示了一个写突发传输: 图片 虽然第一个传输可以零等待完成,但后续每一个传输都需要插入一个等待状态。 APB桥需要两个地址寄存器,以便在当前传输进行时,锁存下一次传输的地址。 4、背靠背传输 下图表示了一个背靠背传输,顺序为写、读、写、读: 如果写操作之后跟随着读操作,那么需要 3 个等待周期来完成这个读操作。通常的情况下,不会有读操作之后紧跟着写操作的发生,因为两者之间 CPU 会进行指令读取,并且指令存储器也不太可能挂在在APB总线上。 图片 下面以ARM DesignStart项目提供的软件包里的AHB转APB桥的代码,对其进行学习与仿真,以深入理解APB桥的实现方法,该转换桥比较简单,实现的是一对一的转换,也可以配合APB slave multiplexer模块,实现一对多的方式(主要依靠APB高位地址译码得到各个从机的PSEL信号)。如果想学习APB系统总线,可以参考Synopsys公司的DW_APB IP,该IP最多可支持16个APB从机,并支持所有的突发传输类型。 5、AHB_to_APB Bridge的Verilog实现 `timescale 1ns / 1ps module ahb_to_apb #( // Parameter to define address width // 16 = 2^16 = 64KB APB address space parameter ADDRWIDTH = 16, parameter REGISTER_RDATA = 1, parameter REGISTER_WDATA = 0 ) ( //---------------------------------- // IO Declarations //---------------------------------- input wire HCLK, // Clock input wire HRESETn, // Reset input wire PCLKEN, // APB clock enable signal input wire HSEL, // Device select input wire [ADDRWIDTH-1:0] HADDR, // Address input wire [1:0] HTRANS, // Transfer control input wire [2:0] HSIZE, // Transfer size input wire [3:0] HPROT, // Protection control input wire HWRITE, // Write control input wire HREADY, // Transfer phase done input wire [31:0] HWDATA, // Write data output reg HREADYOUT, // Device ready output wire [31:0] HRDATA, // Read data output output wire HRESP, // Device response // APB Output output wire [ADDRWIDTH-1:0] PADDR, // APB Address output wire PENABLE, // APB Enable output wire PWRITE, // APB Write output wire [3:0] PSTRB, // APB Byte Strobe output wire [2:0] PPROT, // APB Prot output wire [31:0] PWDATA, // APB write data output wire PSEL, // APB Select output wire APBACTIVE, // APB bus is active, for clock gating of APB bus // APB Input input wire [31:0] PRDATA, // Read data for each APB slave input wire PREADY, // Ready for each APB slave input wire PSLVERR // Error state for each APB slave ); //---------------------------------- // Variable Declarations //---------------------------------- reg [ADDRWIDTH-3:0] addr_reg; // Address sample register reg wr_reg; // Write control sample register reg [2:0] state_reg; // State for finite state machine reg [3:0] pstrb_reg; // Byte lane strobe register wire [3:0] pstrb_nxt; // Byte lane strobe next state reg [1:0] pprot_reg; // PPROT register wire [1:0] pprot_nxt; // PPROT register next state wire apb_select; // APB bridge is selected wire apb_tran_end; // Transfer is completed on APB reg [2:0] next_state; // Next state for finite state machine reg [31:0] rwdata_reg; // Read/Write data sample register wire reg_rdata_cfg; // REGISTER_RDATA paramater wire reg_wdata_cfg; // REGISTER_WDATA paramater reg sample_wdata_reg; // Control signal to sample HWDATA //---------------------------------- // Local Parameter Declarations //---------------------------------- // State machine localparam ST_BITS = 3; localparam [ST_BITS-1:0] ST_IDLE = 3'b000; // Idle waiting for transaction localparam [ST_BITS-1:0] ST_APB_WAIT = 3'b001; // Wait APB transfer localparam [ST_BITS-1:0] ST_APB_TRNF = 3'b010; // Start APB transfer localparam [ST_BITS-1:0] ST_APB_TRNF2 = 3'b011; // Second APB transfer cycle localparam [ST_BITS-1:0] ST_APB_ENDOK = 3'b100; // Ending cycle for OKAY localparam [ST_BITS-1:0] ST_APB_ERR1 = 3'b101; // First cycle for Error response localparam [ST_BITS-1:0] ST_APB_ERR2 = 3'b110; // Second cycle for Error response localparam [ST_BITS-1:0] ST_ILLEGAL = 3'b111; // Illegal state //---------------------------------- // Start of Main Code //---------------------------------- // Configuration signal assign reg_rdata_cfg = (REGISTER_RDATA == 0) ? 1'b0 : 1'b1; assign reg_wdata_cfg = (REGISTER_WDATA == 0) ? 1'b0 : 1'b1; // Generate APB bridge select assign apb_select = HSEL & HTRANS[1] & HREADY; // Generate APB transfer ended assign apb_tran_end = (state_reg == 3'b011) & PREADY; assign pprot_nxt[0] = HPROT[1]; // (0) Normal, (1) Privileged assign pprot_nxt[1] = ~HPROT[0]; // (0) Data, (1) Instruction // Byte strobe generation // - Only enable for write operations // - For word write transfers (HSIZE[1]=1), all byte strobes are 1 // - For hword write transfers (HSIZE[0]=1), check HADDR[1] // - For byte write transfers, check HADDR[1:0] assign pstrb_nxt[0] = HWRITE & ((HSIZE[1])|((HSIZE[0])&(~HADDR[1]))|(HADDR[1:0]==2'b00)); assign pstrb_nxt[1] = HWRITE & ((HSIZE[1])|((HSIZE[0])&(~HADDR[1]))|(HADDR[1:0]==2'b01)); assign pstrb_nxt[2] = HWRITE & ((HSIZE[1])|((HSIZE[0])&( HADDR[1]))|(HADDR[1:0]==2'b10)); assign pstrb_nxt[3] = HWRITE & ((HSIZE[1])|((HSIZE[0])&( HADDR[1]))|(HADDR[1:0]==2'b11)); // Sample control signals always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) begin addr_reg <= {(ADDRWIDTH-2){1'b0}}; wr_reg <= 1'b0; pprot_reg <= {2{1'b0}}; pstrb_reg <= {4{1'b0}}; end else if (apb_select) begin // Capture transfer information at the end of AHB address phase addr_reg <= HADDR[ADDRWIDTH-1:2]; wr_reg <= HWRITE; pprot_reg <= pprot_nxt; pstrb_reg <= pstrb_nxt; end end // Sample write data control signal // Assert after write address phase, deassert after PCLKEN=1 wire sample_wdata_set = apb_select & HWRITE & reg_wdata_cfg; wire sample_wdata_clr = sample_wdata_reg & PCLKEN; always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) sample_wdata_reg <= 1'b0; else if (sample_wdata_set | sample_wdata_clr) sample_wdata_reg <= sample_wdata_set; end // Generate next state for FSM // Note : case 3'b111 is not used. The design has been checked that // this illegal state cannot be entered using formal verification. always @(state_reg or PREADY or PSLVERR or apb_select or reg_rdata_cfg or PCLKEN or reg_wdata_cfg or HWRITE) begin case (state_reg) // Idle ST_IDLE : begin if (PCLKEN & apb_select & ~(reg_wdata_cfg & HWRITE)) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else if (apb_select) next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high else next_state = ST_IDLE; // Remain idle end // Transfer announced on AHB, but PCLKEN was low, so waiting ST_APB_WAIT : begin if (PCLKEN) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high end // First APB transfer cycle ST_APB_TRNF : begin if (PCLKEN) next_state = ST_APB_TRNF2; // Change to second cycle of APB transfer else next_state = ST_APB_TRNF; // Change to state-2 end // Second APB transfer cycle ST_APB_TRNF2 : begin if (PREADY & PSLVERR & PCLKEN) // Error received - Generate two cycle // Error response on AHB by next_state = ST_APB_ERR1; // Changing to state-5 and 6 else if (PREADY & (~PSLVERR) & PCLKEN) begin // Okay received if (reg_rdata_cfg) // Registered version next_state = ST_APB_ENDOK; // Generate okay response in state 4 else // Non-registered version next_state = {2'b00, apb_select}; // Terminate transfer end else // Slave not ready next_state = ST_APB_TRNF2; // Unchange end // Ending cycle for OKAY (registered response) ST_APB_ENDOK : begin if (PCLKEN & apb_select & ~(reg_wdata_cfg & HWRITE)) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else if (apb_select) next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high else next_state = ST_IDLE; // Remain idle end // First cycle for Error response ST_APB_ERR1 : next_state = ST_APB_ERR2; // Goto 2nd cycle of error response // Second cycle for Error response ST_APB_ERR2 : begin if (PCLKEN & apb_select & ~(reg_wdata_cfg & HWRITE)) next_state = ST_APB_TRNF; // Start APB transfer in next cycle else if (apb_select) next_state = ST_APB_WAIT; // Wait for start of APB transfer at PCLKEN high else next_state = ST_IDLE; // Remain idle end default : // Not used next_state = 3'bxxx; // X-Propagation endcase end // Registering state machine always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) state_reg <= 3'b000; else state_reg <= next_state; end // Sample PRDATA or HWDATA always @(posedge HCLK or negedge HRESETn) begin if (~HRESETn) rwdata_reg <= {32{1'b0}}; else if (sample_wdata_reg & reg_wdata_cfg & PCLKEN) rwdata_reg <= HWDATA; else if (apb_tran_end & reg_rdata_cfg & PCLKEN) rwdata_reg <= PRDATA; end // Connect outputs to top level assign PADDR = {addr_reg, 2'b00}; // from sample register assign PWRITE = wr_reg; // from sample register // From sample register or from HWDATA directly assign PWDATA = (reg_wdata_cfg) ? rwdata_reg : HWDATA; assign PSEL = (state_reg == ST_APB_TRNF) | (state_reg == ST_APB_TRNF2); assign PENABLE = (state_reg == ST_APB_TRNF2); assign PPROT = {pprot_reg[1], 1'b0, pprot_reg[0]}; assign PSTRB = pstrb_reg[3:0]; // Generate HREADYOUT always @(state_reg or reg_rdata_cfg or PREADY or PSLVERR or PCLKEN) begin case (state_reg) ST_IDLE : HREADYOUT = 1'b1; // Idle ST_APB_WAIT : HREADYOUT = 1'b0; // Transfer announced on AHB, but PCLKEN was low, so waiting ST_APB_TRNF : HREADYOUT = 1'b0; // First APB transfer cycle // Second APB transfer cycle: // if Non-registered feedback version, and APB transfer completed without error // Then response with ready immediately. If registered feedback version, // wait until state_reg == ST_APB_ENDOK ST_APB_TRNF2 : HREADYOUT = (~reg_rdata_cfg) & PREADY & (~PSLVERR) & PCLKEN; ST_APB_ENDOK : HREADYOUT = reg_rdata_cfg; // Ending cycle for OKAY (registered response only) ST_APB_ERR1 : HREADYOUT = 1'b0; // First cycle for Error response ST_APB_ERR2 : HREADYOUT = 1'b1; // Second cycle for Error response default : HREADYOUT = 1'bx; // x propagation (note :3'b111 is illegal state) endcase end // From sample register or from PRDATA directly assign HRDATA = (reg_rdata_cfg) ? rwdata_reg : PRDATA; assign HRESP = (state_reg == ST_APB_ERR1) | (state_reg == ST_APB_ERR2); assign APBACTIVE = (HSEL & HTRANS[1]) | (|state_reg); endmodule使用的测试用例和AHB从机的测试用例基本一样,首先是顶层: `timescale 1ns / 1ps module top_tb(); //---------------------------------- // Local Parameter Declarations //---------------------------------- localparam AHB_CLK_PERIOD = 5; // Assuming AHB CLK to be 100MHz localparam SIZE_IN_BYTES = 2048; localparam ADDRWIDTH = 32; //---------------------------------- // Variable Declarations //---------------------------------- reg HCLK = 0; wire HWRITE; wire [1:0] HTRANS; wire [2:0] HSIZE; wire [2:0] HBURST; wire HREADYIN; wire [31:0] HADDR; wire [3:0] HPROT; wire [31:0] HWDATA; wire HREADYOUT; wire [1:0] HRESP; wire [31:0] HRDATA; reg HRESETn; wire HREADY; wire [ADDRWIDTH-1:0] PADDR; // APB Address wire PENABLE; // APB Enable wire PWRITE; // APB Write wire [31:0] PWDATA; // APB write data wire PSEL; // APB Select wire PREADY; wire PSLVERR; wire [2:0] PPROT; wire [3:0] PSTRB; wire [31:0] PRDATA; //---------------------------------- // Start of Main Code //---------------------------------- assign HREADY = HREADYOUT; //----------------------------------------------------------------------- // Generate HCLK //----------------------------------------------------------------------- always #AHB_CLK_PERIOD HCLK <= ~HCLK; //----------------------------------------------------------------------- // Generate HRESETn //----------------------------------------------------------------------- initial begin HRESETn = 1'b0; repeat(5) @(posedge HCLK); HRESETn = 1'b1; end ahb_master #( .START_ADDR (32'h0), .DEPTH_IN_BYTES (SIZE_IN_BYTES) ) u_ahb_master ( .HRESETn (HRESETn), .HCLK (HCLK), .HADDR (HADDR), .HPROT (HPROT), .HTRANS (HTRANS), .HWRITE (HWRITE), .HSIZE (HSIZE), .HBURST (HBURST), .HWDATA (HWDATA), .HRDATA (HRDATA), .HRESP (HRESP), .HREADY (HREADYOUT) ); ahb_to_apb #( .ADDRWIDTH (ADDRWIDTH), .REGISTER_RDATA (0), .REGISTER_WDATA (0) ) u_ahb_to_apb( .HCLK (HCLK), .HRESETn (HRESETn), .PCLKEN (1'b1), .HSEL (1'b1), .HADDR (HADDR), .HTRANS (HTRANS), .HSIZE (HSIZE), .HPROT (HPROT), .HWRITE (HWRITE), .HREADY (HREADY), .HWDATA (HWDATA), .HREADYOUT (HREADYOUT), .HRDATA (HRDATA), .HRESP (HRESP), .PADDR (PADDR), .PENABLE (PENABLE), .PWRITE (PWRITE), .PREADY (PREADY), .PSLVERR (PSLVERR), .PSTRB (PSTRB), .PPROT (PPROT), .PWDATA (PWDATA), .PSEL (PSEL), .APBACTIVE (APBACTIVE), .PRDATA (PRDATA) ); apb_mem #( .P_SLV_ID (0), .ADDRWIDTH (ADDRWIDTH), .P_SIZE_IN_BYTES (SIZE_IN_BYTES), .P_DELAY (0) ) u_apb_mem ( `ifdef AMBA_APB3 .PREADY (PREADY), .PSLVERR (PSLVERR), `endif `ifdef AMBA_APB4 .PSTRB (PSTRB), .PPROT (PPROT), `endif .PRESETn (HRESETn), .PCLK (HCLK), .PSEL (PSEL), .PENABLE (PENABLE), .PADDR (PADDR), .PWRITE (PWRITE), .PRDATA (PRDATA), .PWDATA (PWDATA) ); `ifdef VCS initial begin $fsdbDumpfile("top_tb.fsdb"); $fsdbDumpvars; end initial begin `ifdef DUMP_VPD $vcdpluson(); `endif end `endif endmodule然后是AHB master的功能模型: `timescale 1ns / 1ps `define SINGLE_TEST `define BURST_TEST module ahb_master #( //---------------------------------- // Paramter Declarations //---------------------------------- parameter START_ADDR = 0, parameter DEPTH_IN_BYTES = 32'h100, parameter END_ADDR = START_ADDR+DEPTH_IN_BYTES-1 ) ( //---------------------------------- // IO Declarations //---------------------------------- input wire HRESETn, input wire HCLK, output reg [31:0] HADDR, output reg [1:0] HTRANS, output reg HWRITE, output reg [2:0] HSIZE, output reg [2:0] HBURST, output reg [3:0] HPROT, output reg [31:0] HWDATA, input wire [31:0] HRDATA, input wire [1:0] HRESP, input wire HREADY ); //---------------------------------- // Variable Declarations //---------------------------------- reg [31:0] data_burst[0:1023]; //---------------------------------- // Start of Main Code //---------------------------------- initial begin HADDR = 0; HTRANS = 0; HPROT = 0; HWRITE = 0; HSIZE = 0; HBURST = 0; HWDATA = 0; while(HRESETn === 1'bx) @(posedge HCLK); while(HRESETn === 1'b1) @(posedge HCLK); while(HRESETn === 1'b0) @(posedge HCLK); `ifdef SINGLE_TEST repeat(3) @(posedge HCLK); memory_test(START_ADDR, END_ADDR, 1); memory_test(START_ADDR, END_ADDR, 2); memory_test(START_ADDR, END_ADDR, 4); `endif `ifdef BURST_TEST repeat(5) @(posedge HCLK); memory_test_burst(START_ADDR, END_ADDR, 1); memory_test_burst(START_ADDR, END_ADDR, 2); memory_test_burst(START_ADDR, END_ADDR, 4); memory_test_burst(START_ADDR, END_ADDR, 6); memory_test_burst(START_ADDR, END_ADDR, 8); memory_test_burst(START_ADDR, END_ADDR, 10); memory_test_burst(START_ADDR, END_ADDR, 16); memory_test_burst(START_ADDR, END_ADDR, 32); memory_test_burst(START_ADDR, END_ADDR, 64); memory_test_burst(START_ADDR, END_ADDR, 128); memory_test_burst(START_ADDR, END_ADDR, 255); repeat(5) @(posedge HCLK); `endif $finish(2); end //----------------------------------------------------------------------- // Single transfer test //----------------------------------------------------------------------- task memory_test; input [31:0] start; // start address input [31:0] finish; // end address input [2:0] size; // data size: 1, 2, 4 integer i; integer error; reg [31:0] data; reg [31:0] gen; reg [31:0] got; reg [31:0] reposit[START_ADDR:END_ADDR]; begin $display("%m: read-after-write test with %d-byte access", size); error = 0; gen = $random(7); for (i = start; i < (finish-size+1); i = i + size) begin gen = $random & ~32'b0; data = align(i, gen, size); ahb_write(i, size, data); ahb_read(i, size, got); got = align(i, got, size); if (got !== data) begin $display("[%10d] %m A:%x D:%x, but %x expected", $time, i, got, data); error = error + 1; end end if (error == 0) $display("[%10d] %m OK: from %x to %x", $time, start, finish); $display("%m read-all-after-write-all with %d-byte access", size); error = 0; gen = $random(1); for (i = start; i < (finish-size+1); i = i + size) begin gen = {$random} & ~32'b0; data = align(i, gen, size); reposit[i] = data; ahb_write(i, size, data); end for (i = start; i < (finish-size+1); i = i + size) begin data = reposit[i]; ahb_read(i, size, got); got = align(i, got, size); if (got !== data) begin $display("[%10d] %m A:%x D:%x, but %x expected", $time, i, got, data); error = error + 1; end end if (error == 0) $display("[%10d] %m OK: from %x to %x", $time, start, finish); end endtask //----------------------------------------------------------------------- // Burst transfer test //----------------------------------------------------------------------- task memory_test_burst; input [31:0] start; // start address input [31:0] finish; // end address input [7:0] leng; // burst length integer i; integer j; integer k; integer r; integer error; reg [31:0] data; reg [31:0] gen; reg [31:0] got; reg [31:0] reposit[0:1023]; integer seed; begin $display("[%10d] %m: read-all-after-write-all burst test with %d-beat access", $time, leng); error = 0; seed = 111; gen = $random(seed); k = 0; if (finish > (start+leng*4)) begin for (i = start; i < (finish-(leng*4)+1); i = i + leng*4) begin for (j = 0; j < leng; j = j + 1) begin data_burst[j] = $random; reposit[j+k*leng] = data_burst[j]; end @(posedge HCLK); ahb_write_burst(i, leng); k = k + 1; end gen = $random(seed); k = 0; for (i = start; i < (finish-(leng*4)+1); i = i + leng*4) begin @(posedge HCLK); ahb_read_burst(i, leng); for (j = 0; j < leng; j = j + 1) begin if (data_burst[j] != reposit[j+k*leng]) begin error = error+1; $display("[%10d] %m A=%hh D=%hh, but %hh expected", $time, i+j*leng, data_burst[j], reposit[j+k*leng]); end end k = k + 1; r = $random & 8'h0F; repeat(r) @(posedge HCLK); end if (error == 0) $display("%m %d-length burst read-after-write OK: from %hh to %hh",leng, start, finish); end else begin $display("%m %d-length burst read-after-write from %hh to %hh ???",leng, start, finish); end end endtask //----------------------------------------------------------------------- // As AMBA AHB bus uses non-justified data bus scheme, data should be // aligned according to the address. //----------------------------------------------------------------------- function [31:0] align; input [ 1:0] addr; input [31:0] data; input [ 2:0] size; // num of bytes begin `ifdef BIG_ENDIAN case (size) 1 : case (addr[1:0]) 0 : align = data & 32'hFF00_0000; 1 : align = data & 32'h00FF_0000; 2 : align = data & 32'h0000_FF00; 3 : align = data & 32'h0000_00FF; endcase 2 : case (addr[1]) 0 : align = data & 32'hFFFF_0000; 1 : align = data & 32'h0000_FFFF; endcase 4 : align = data&32'hFFFF_FFFF; default : $display($time,,"%m ERROR %d-byte not supported for size", size); endcase `else case (size) 1 : case (addr[1:0]) 0 : align = data & 32'h0000_00FF; 1 : align = data & 32'h0000_FF00; 2 : align = data & 32'h00FF_0000; 3 : align = data & 32'hFF00_0000; endcase 2 : case (addr[1]) 0 : align = data & 32'h0000_FFFF; 1 : align = data & 32'hFFFF_0000; endcase 4 : align = data&32'hFFFF_FFFF; default : $display($time,,"%m ERROR %d-byte not supported for size", size); endcase `endif end endfunction `include "ahb_transaction_tasks.v" endmoduleahb_transaction_tasks.v文件如下: `ifndef __AHB_TRANSACTION_TASKS_V__ `define __AHB_TRANSACTION_TASKS_V__ //----------------------------------------------------------------------- // AHB Read Task //----------------------------------------------------------------------- task ahb_read; input [31:0] address; input [2:0] size; output [31:0] data; begin @(posedge HCLK); HADDR <= #1 address; HPROT <= #1 4'b0001; // DATA HTRANS <= #1 2'b10; // NONSEQ; HBURST <= #1 3'b000; // SINGLE; HWRITE <= #1 1'b0; // READ; case (size) 1 : HSIZE <= #1 3'b000; // BYTE; 2 : HSIZE <= #1 3'b001; // HWORD; 4 : HSIZE <= #1 3'b010; // WORD; default : $display($time,, "ERROR: unsupported transfer size: %d-byte", size); endcase @(posedge HCLK); while (HREADY !== 1'b1) @(posedge HCLK); HTRANS <= #1 2'b0; // IDLE @(posedge HCLK); while (HREADY === 0) @(posedge HCLK); data = HRDATA; // must be blocking if (HRESP != 2'b00) $display($time,, "ERROR: non OK response for read"); @(posedge HCLK); end endtask //----------------------------------------------------------------------- // AHB Write Task //----------------------------------------------------------------------- task ahb_write; input [31:0] address; input [2:0] size; input [31:0] data; begin @(posedge HCLK); HADDR <= #1 address; HPROT <= #1 4'b0001; // DATA HTRANS <= #1 2'b10; // NONSEQ HBURST <= #1 3'b000; // SINGLE HWRITE <= #1 1'b1; // WRITE case (size) 1 : HSIZE <= #1 3'b000; // BYTE 2 : HSIZE <= #1 3'b001; // HWORD 4 : HSIZE <= #1 3'b010; // WORD default : $display($time,, "ERROR: unsupported transfer size: %d-byte", size); endcase @(posedge HCLK); while (HREADY !== 1) @(posedge HCLK); HWDATA <= #1 data; HTRANS <= #1 2'b0; // IDLE @(posedge HCLK); while (HREADY === 0) @(posedge HCLK); if (HRESP != 2'b00) $display($time,, "ERROR: non OK response write"); @(posedge HCLK); end endtask //----------------------------------------------------------------------- // AHB Read Burst Task //----------------------------------------------------------------------- task ahb_read_burst; input [31:0] addr; input [31:0] leng; integer i; integer ln; integer k; begin k = 0; @(posedge HCLK); HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR ln = leng; end HWRITE <= #1 1'b0; // READ HSIZE <= #1 3'b010; // WORD @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); while (leng > 0) begin for (i = 0; i < ln-1; i = i + 1) begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b11; // SEQ; @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); data_burst[k%1024] <= HRDATA; k = k + 1; end leng = leng - ln; if (leng == 0) begin HADDR <= #1 0; HTRANS <= #1 0; HBURST <= #1 0; HWRITE <= #1 0; HSIZE <= #1 0; end else begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR1 ln = leng; end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); data_burst[k%1024] = HRDATA; // must be blocking k = k + 1; end end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); data_burst[k%1024] = HRDATA; // must be blocking end endtask //----------------------------------------------------------------------- // AHB Write Burst Task // It takes suitable burst first and then incremental. //----------------------------------------------------------------------- task ahb_write_burst; input [31:0] addr; input [31:0] leng; integer i; integer j; integer ln; begin j = 0; ln = 0; @(posedge HCLK); while (leng > 0) begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR ln = leng; end HWRITE <= #1 1'b1; // WRITE HSIZE <= #1 3'b010; // WORD for (i = 0; i < ln-1; i = i + 1) begin @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); HWDATA <= #1 data_burst[(j+i)%1024]; HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b11; // SEQ; while (HREADY == 1'b0) @(posedge HCLK); end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); HWDATA <= #1 data_burst[(j+i)%1024]; if (ln == leng) begin HADDR <= #1 0; HTRANS <= #1 0; HBURST <= #1 0; HWRITE <= #1 0; HSIZE <= #1 0; end leng = leng - ln; j = j + ln; end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); if (HRESP != 2'b00) begin // OKAY $display($time,, "ERROR: non OK response write"); end `ifdef DEBUG $display($time,, "INFO: write(%x, %d, %x)", addr, size, data); `endif HWDATA <= #1 0; @(posedge HCLK); end endtask `endif还需要一个APB的从机模块: `timescale 1ns / 1ps `define AMBA_APB3 `define AMBA_APB4 module apb_mem #( parameter P_SLV_ID = 0, parameter ADDRWIDTH = 32, parameter P_SIZE_IN_BYTES = 1024, // memory depth parameter P_DELAY = 0 // reponse delay ) ( //---------------------------------- // IO Declarations //---------------------------------- `ifdef AMBA_APB3 output wire PREADY, output wire PSLVERR, `endif `ifdef AMBA_APB4 input wire [2:0] PPROT, input wire [3:0] PSTRB, `endif input wire PRESETn, input wire PCLK, input wire PSEL, input wire PENABLE, input wire [ADDRWIDTH-1:0] PADDR, input wire PWRITE, output reg [31:0] PRDATA = 32'h0, input wire [31:0] PWDATA ); //---------------------------------- // Local Parameter Declarations //---------------------------------- localparam DEPTH = (P_SIZE_IN_BYTES+3)/4; localparam AW = logb2(P_SIZE_IN_BYTES); //---------------------------------- // Variable Declarations //---------------------------------- `ifndef AMBA_APB3 wire PREADY; `else assign PSLVERR = 1'b0; `endif `ifndef AMBA_APB4 wire [3:0] PSTRB = 4'hF; `endif reg [7:0] mem0[0:DEPTH-1]; reg [7:0] mem1[0:DEPTH-1]; reg [7:0] mem2[0:DEPTH-1]; reg [7:0] mem3[0:DEPTH-1]; wire [AW-3:0] TA = PADDR[AW-1:2]; //---------------------------------- // Start of Main Code //---------------------------------- //-------------------------------------------------------------------------- // write transfer // ____ ____ ____ // PCLK ___| |____| |____| |_ // ____ ___________________ _____ // PADDR ____X__A________________X_____ // ____ ___________________ _____ // PWDATA ____X__DW_______________X_____ // ___________________ // PWRITE ____| |_____ // ___________________ // PSEL ____| |_____ // _________ // PENABLE ______________| |_____ //-------------------------------------------------------------------------- always @(posedge PCLK) begin if (PRESETn & PSEL & PENABLE & PWRITE & PREADY) begin if (PSTRB[0]) mem0[TA] <= PWDATA[ 7: 0]; if (PSTRB[1]) mem1[TA] <= PWDATA[15: 8]; if (PSTRB[2]) mem2[TA] <= PWDATA[23:16]; if (PSTRB[3]) mem3[TA] <= PWDATA[31:24]; end end //-------------------------------------------------------------------------- // read // ____ ____ ____ // PCLK ___| |____| |____| |_ // ____ ___________________ _____ // PADDR ____X__A________________X_____ // ____ _________ _____ // PRDATA ____XXXXXXXXXXX__DR_____X_____ // ____ _____ // PWRITE ____|___________________|_____ // ___________________ // PSEL ____| |_____ // _________ // PENABLE ______________| |_____ //-------------------------------------------------------------------------- always @(posedge PCLK) begin if (PRESETn & PSEL & ~PENABLE & ~PWRITE) begin PRDATA[ 7: 0] <= mem0[TA]; PRDATA[15: 8] <= mem1[TA]; PRDATA[23:16] <= mem2[TA]; PRDATA[31:24] <= mem3[TA]; end end `ifdef AMBA_APB3 localparam ST_IDLE = 'h0, ST_CNT = 'h1, ST_WAIT = 'h2; reg [7:0] count; reg ready; reg [1:0] state=ST_IDLE; assign PREADY = (P_DELAY == 0) ? 1'b1 : ready; always @(posedge PCLK or negedge PRESETn) begin if (PRESETn == 1'b0) begin count <= 'h0; ready <= 'b1; state <= ST_IDLE; end else begin case (state) ST_IDLE : begin if (PSEL && (P_DELAY > 0)) begin ready <= 1'b0; count <= 'h1; state <= ST_CNT; end else begin ready <= 1'b1; end end // ST_IDLE ST_CNT : begin count <= count + 1; if (count >= P_DELAY) begin count <= 'h0; ready <= 1'b1; state <= ST_WAIT; end end // ST_CNT ST_WAIT : begin ready <= 1'b1; state <= ST_IDLE; end // ST_WAIT default : begin ready <= 1'b1; state <= ST_IDLE; end endcase end // if end // always `else assign PREADY = 1'b1; `endif // Calculate log-base2 function integer logb2; input [31:0] value; reg [31:0] tmp; begin tmp = value - 1; for (logb2 = 0; tmp > 0; logb2 = logb2 + 1) tmp = tmp >> 1; end endfunction // synopsys translate_off `ifdef RIGOR always @(posedge PCLK or negedge PRESETn) begin if (PRESETn == 1'b0) begin end else begin if (PSEL & PENABLE) begin if (TA >= DEPTH) $display($time,,"%m: ERROR: out-of-bound 0x%x", PADDR); end end end `endif // synopsys translate_on endmodule6、仿真 用VCS进行仿真,打印信息如下 图片 可见仿真完全正确,这里也只是做了AHB总线的单一传输和各种长度的增量突发,回环突发未涉及(对APB桥来说,它并不关心HBURST的信号值)。 下面挂两张仿真截图: 单一传输,先写后读: 图片 突发传输,先写完,再读完 图片
IP&SOC设计
# SOC设计
刘航宇
3年前
1
1,609
1
数字锁相环(DPLL)研究与设计-面向FPGA/数字IC
摘要本文介绍了数字锁相环(DPLL)的研究与设计,包括其原理、组成、实现方法以及性能评估。文章详细阐述了数字锁相环在数字电路中的应用,并重点介绍了数字鉴相器、数字振荡器和数字缓冲器的设计与实现。关键词:数字锁相环, DPLL, FPGA, 数字IC, 频率合成前言 锁相环的原理和组成 数字锁相环的原理和组成 数字鉴相器设计DPD 数字振荡器(DCO) 数字缓冲器(DB) 数字锁相环(DPLL)的实现 电路硬件与性能评估 工程代码下载 前言 随着数字电路技术的发展,数字锁相环在调制解调、频率合成、FM 立体声解码、彩色副载波同步、图象处理等各个方面得到了广泛的应用。数字锁相环不仅吸收了数字电路可靠性高、体积小、价格低等优点,还解决了模拟锁相环的直流零点漂移、器件饱和及易受电源和环境温度变化等缺点,此外还具有对离散样值的实时处理能力,已成为锁相技术发展的方向。 所谓数字PLL,就是指应用于数字系统的PLL,也就是说数字PLL中的各个模块都是以数字器件来实现的,是一个数字的电路。 数字锁相环的优点是电路最简单有效,可采用没有压控的晶振,降低了成本,提高了晶振的稳定性。但缺点是和模拟锁相环一样,一旦失去基准频率,输出频率立刻跳回振荡器本身的频率;另外还有一个缺点,就是当进行频率调整的时候,输出频率会产生抖动,频差越大,抖动会越大于密,不利于某些场合的应用。随着大规模、超高速的数字集成电路的发展,为数字锁相环路的研究与应用提供了广阔空间。由于晶体振荡器和数字调整技术的加盟,可以在不降低振荡器的频率稳定度的情况下,加大频率的跟踪范围,从而提高整个环路工作的稳定性与可靠性。 简单的说有两个不同来源的信号:一个信号是参考信号,这个信号一般是由芯片的晶振得到的信号,它具有信号的稳定性较好等优点,但是其频率是固定不变的。另一个信号是由芯片或者模块内部的压控振荡器得到的。这种由压控振荡器得到的信号可以是某范围内的任意频率的信号,但是这种信号的稳定型较差,容易受到外界干扰。 那么在实际使用过程中,我们需要一种频率能够变化的,同时质量较好的信号;或者对于一块芯片,我们需要不同的模块的内部时钟(这种时钟可以是压控振荡器产生)都能参考一个总的时钟来进行同步,从而避免两个模块内部时钟的差异而产生的数据传输的漂移等问题。因此,如何将压控振荡器得到的信号能够具有晶振信号的信号质量呢? 那就是通过PLL锁相环来实现,如图1所示。只要压控振荡器产生的时钟(下称输入信号)是参考信号的整数倍(或者整除倍),那么就能将输入信号先进行分频,后得到与参考信号频率相同的时钟,将分频后的信号和参考信号进行比较,从而使分频后的信号和参考信号保持相同的稳定的频率和相位。被分频后的信号稳定,也就是间接的表示输入信号的稳定。从而我们得到了一个频率在一定范围内可变的稳定的信号。 有上述可以看出,锁相环具有以下功能: (1)能够将一个信号和另一参考信号同步; (2)当这个信号是输出信号分频后得到的信号,PLL就能够得到参考信号的倍频信号(实际上倍频器很多都是利用了这个功能); (3)当输入信号频率可变、分频系数可变时,PLL就能够得到在频率一定范围内稳定信号。 图片 锁相环的原理和组成 锁相环(PLL)的作用我们已经大概了解了,其最主要功能的实现,是在于如何将两个频率不同、相位差始终在变化的信号,变成两个相同频率、相同相位的信号。 这里引入一个概念,首先我们都知道,对于三角函数,只有两个同频率的三角函数才能比较其相位差。但这里的相位差是指两个正弦函数的初始相位差。而实际上根据三角函数的欧拉定义的理解来看,我们可以把三角函数看做是在某个圆上逆时针运动的点到x轴的距离。那么频率就是点在圆上运动的角速度,频率越大,其运动的角速度越大。相位就是点在圆上的位置,而初始相位就是点在圆上开始运动时的位置。当两个点的运动角速度相同时,我们可以得到两个点的初始位置差,就是两个正弦函数频率相同时,得到初始相位差。这个差值在运动过程中一直是不变的。但是当两个点运动角速度不同时,我们去看它的初始位置差是没有意义的,因为两个点的位置差是一直在变的,而初始位置差只是一个开始的位置差,是个不变的量,所以说对于频率不同的三角函数,我们讨论起初始相位差是没有意义的。但是不代表不能比较某一时刻两个点的位置。也就是相位差,相位是存在的。 图片 现在我们假设两个点在圆上赛跑,如图3所示,我们想让这两个点角速度相等。那么有一个办法就是以一个点为参考,参考点角速度不变,另一个点是速度可变点。每过一段时间,观察另一个点到参考点的位置,是在前,还是在后。如果在前,就让另一个点速度慢一点;如果在后,就让另一个点速度快一点。就这样不断调整另一个点的角速度,直到每次观察两个点都处于相同的位置。这样我们就可以认为这两个点达到了相同的速度。这种方法就是利用反馈调节来实现两个信号的同频同相。也就是锁相环(PLL)的实现原理。 首先通过一个鉴相器来得到两个信号之间的相位差。并根据相位差输出电压信号。然后通过滤波器稳压后得到稳定的电压信号,该信号驱动压控振荡器得到新的频率的信号。当两个信号存在相位差时,电压信号就会改变,从而使受控信号不断变化。直到当两个信号没有相位差时,电压信号不再改变,从而使受控信号保持当前频率,这时,受控信号不再变化了,就叫做受控信号被锁定了。 由上所述,一个锁相环由鉴相器、滤波器、振荡器三部分组成。外部输入是参考信号,内部输入和总的输出是受控信号。 数字锁相环的原理和组成 在数字电路中,原来模拟信号正弦波、余弦波的频率和相位变成了0和1的脉冲信号,那么我们如何理解数字信号中的频率和相位呢?对于脉冲信号来说,我们可以把频率理解为在某固定时间内脉冲出现的个数,为了方便表示,我们把上升沿的出现视为脉冲的出现,把相邻两个脉冲出现的时间t求倒数,就得到了该信号在这个时刻处的信号频率。而对于相位,相位差就是指,存在两个脉冲信号,以一个脉冲信号为参考,在其出现脉冲后,到另一个信号出现脉冲之间的时间差就是相位差,当另一个信号脉冲晚于参考信号脉冲出现的时间,称之为另一个信号的相位滞后于参考信号。当另一个信号的脉冲出现在参考信号之前,称之为另一个信号的相位提前于参考信号。 上述是一种较为简单的描述方式,适合初识脉冲信号的读者理解。而实际上,对于脉冲信号的频率、相位等问题,严格来说这样理解有一点点问题,但是对于我们来搭建数字锁相环DPLL来说足够了。其实这种三角函数和信号之间的转化,其根本的原理来源于傅里叶变换,从而我们对一个时间域上的信号(例如脉冲信号)可以进行频率域(其代表的三角函数的合成)上的分析。 我们知道了在数字电路中,脉冲信号也有了频率和相位的属性。那么我们的参考信号是以来时钟源的固定频率的信号,因为信号的质量比较好,所以该信号两个脉冲之间的时间差均是相同的,误差很小。我们在参考信号出现上升沿时,观察受控信号此时的状态。如果受控信号为高电平,我们就认为此时受控信号超前于参考信号;反之,如果受控信号是低电平,则认为此时的受控信号滞后于参考信号。当出现超前状态时,鉴相器会输出一个超前信号,超前信号会作用于振荡器,使得振荡器发出的受控信号频率降低。而滞后信号会使振荡器发出的受控信号频率升高,从而实现受控信号频率的反馈调节。 如图4所示,当参考信号出现上升沿时,受控信号为低电平,此时输出一个滞后信号。(由于模块只在时钟为上升沿时触发,所以超前信号的触发延迟了半个时钟周期) 图片 由此我们能够大概了解了数字锁相环中如何看待脉冲信号的频率和相位,如何处理得到相位差以及相位差如何在锁相环中起作用来实现信号频率的反馈控制。同模拟的锁相环(PLL)类似,数字锁相环(DPLL)也是由:数字鉴相器(Digital Phase Detector)、数字缓冲器(Digital Buffer)、数字振荡器(Digital Controlled Oscillator)三个模块构成,其外部输入为参考信号,内部输入和输出为受控信号。下面我们就来具体讨论如何用verilog实现各个模块。 数字鉴相器设计DPD 实现一个数字锁相环(DPLL),最重要的部分就是实现数字鉴相器(DPD)和数字振荡器(DF)。并且,这两个模块并不是独立存在的,而是说,数字振荡器的实现方式和数字振荡器的实现方式相互影响。所以只有两个模块共同设计,才能较好的实现一个数字锁相环的功能。 首先我们来具体讨论一下一个数字鉴相器应该具有那些功能和特性: 顾名思义,数字鉴相器就是能够鉴别两个数字信号相位的差别,并通过信号将这种差别表示出来。由上文我们已经知道了,对于两个矩形方波信号,其相位差可以看做是两个信号先后出现上升沿(或下降沿)之间的时间差。为了方便表示,假设以其中一个信号作为参考信号,另一个信号为受控信号,当参考信号出现上升沿(或下降沿)时,观察另一个信号是否已经出现了上升沿(或下降沿)。 如果还未出现上升沿(或下降沿),则叫做“受控信号滞后于参考信号”,或者简称“滞后”;如果已经出现了上升沿(或下降沿),则叫做“受控信号提前于参考信号”,或者简称“提前”。 而判断上升沿(或下降沿)是否已经出现,方法就是看当参考信号出现上升沿时,受控信号是1还是0:当受控信号为0,表示上升沿还没出现,所以是“滞后”;当受控信号为1,表示上升沿已经出现,所以是“提前”。对于下降沿也是按照同样的方法考虑。 图片 目前为止,我们已经有两个输入,参考信号和受控信号;两个输出,滞后信号和提前信号。如何通过verilog实现上述的输入输出关系呢?首先先讲异或与门,通过图4的描述,我们可以很容易看出来:滞后信号是参考信号与受控信号先异或,异或的结果和受控信号相与得到;提前信号是参考信号与受控信号先异或,异或的结果和参考信号相与得到。再加上一个RST的复位信号,我们可以得到如下图5电路: 图片 根据这个关系,来调节受控信号的频率,从而使受控信号的频率和参考信号最终相同。 再考虑,如果按照上述方法调节,当受控信号和参考信号频率相差很大时,就会出现刚开始有一段时间,受控信号的频率是不断变化,不可预知的。这样的调节效果实时性并不好,需要时间来稳定。因此读者想到,如果能够在参考信号出现上升沿时,就让受控信号也出现上升沿,相当于两个人在赛跑时,当一个人从起点出发时,无论另一个人在哪,强制让另一个人也回到原点,两个人一起从原点出发。这样就能使受控信号和参考信号强制达到相同的频率,只是此时受控信号的占空比不是50%。然后再根据滞后和提前信号,调节受控信号的占空比,从而最终达到50%的占空比。 按照这种方法,鉴相器就需要一个信号输出来表示上升沿的出现。再考虑到电路中的总的时钟源,我们这里采用触发的方法来实现。同时将上述的异或与门加入到代码中可以得到数字鉴相器的代码。但是在实际运用过程中发现,可能存在着受控信号先出现上升沿,从而过早的出现了提前或者滞后信号,导致数字振荡器的计数器上限呈现一个周期变化的不可控的数值的情况。为了避免这种情况,需要仔细考虑参考信号和受控信号如何生成提前和滞后信号这个问题,而不是简单的用异或来实现。如图6表示这种关系。 图片 按照上述代码写出来的数字鉴相器,具有更好的性能。根据这个表格,通过类似状态机的方法,来实现提前信号和滞后信号的输出。 此外异或门配合D触发器方式也可以实现鉴相器效果仍可应用于本设计中。示例代码如下: module DPD_2 ( input reference_signal, // 参考时钟输入(来自外部晶振或基准源) input controlled_signal, // 反馈时钟输入(来自VCO分频后的时钟) input rst, // 异步复位信号,高电平有效 input clk, output reg lead_signal_wire, // 相位超前指示信号(输出到电荷泵) output reg lag_signal_wire, // 相位滞后指示信号(输出到电荷泵) output bothEdge ); // 延迟寄存器:用于检测两个时钟的到达顺序 reg ref_flag, fb_flag; reg ref_nflag, fb_nflag; reg lead_signal,lead_signal_n; reg lag_signal,lag_signal_n; reg reference_signal_d1,reference_signal_d2; reg controlled_signal_d1,controlled_signal_d2; wire bothEdge_fb; reg fb_flag_d1,fb_flag_d2,fb_nflag_d1,fb_nflag_d2; reg ref_flag_d1,ref_flag_d2,ref_nflag_d1,ref_nflag_d2; always @(posedge clk or negedge rst) begin if(!rst) begin reference_signal_d1 <= 'd0; controlled_signal_d1 <= 'd0; fb_flag_d1 <= 'd0; fb_flag_d2 <= 'd0; fb_nflag_d1 <= 'd0; fb_nflag_d2 <= 'd0; ref_flag_d1 <= 'd0; ref_flag_d2 <= 'd0; ref_nflag_d1 <= 'd0; ref_nflag_d2 <= 'd0; end else begin reference_signal_d1 <= reference_signal; reference_signal_d2 <= reference_signal_d1; controlled_signal_d1 <= controlled_signal; controlled_signal_d2 <= controlled_signal_d1; fb_flag_d1 <= fb_flag; fb_flag_d2 <= fb_flag_d1; fb_nflag_d1 <= fb_nflag; fb_nflag_d2 <= fb_nflag_d1; ref_flag_d1 <= fb_flag; ref_flag_d2 <= ref_flag_d1; ref_nflag_d1 <= ref_nflag; ref_nflag_d2 <= ref_nflag_d1; end end assign bothEdge = reference_signal & (~reference_signal_d1); wire bothEdge_n; assign bothEdge_n = (~reference_signal) & reference_signal_d1; // assign bothEdge_fb = controlled_signal & (~controlled_signal_d1); wire bothEdge_fb_n; //控制下降沿 assign bothEdge_fb_n = (~controlled_signal) & controlled_signal_d1; // // 参考时钟延迟寄存器:在reference_signal上升沿采样 // 功能:标记参考时钟是否到来 always @(posedge reference_signal or negedge rst) begin if (!rst) begin ref_flag <= 1'b0; // 复位时清零 ref_nflag <= 1'b0; end else begin ref_flag <= 1'b1; // 参考时钟到来后置1 ref_nflag <= 1'b0; end end // 反馈时钟延迟寄存器:在controlled_signal上升沿采样 // 功能:标记反馈时钟是否到来 always @(posedge controlled_signal or negedge rst) begin if (!rst) begin fb_flag <= 1'b0; // 复位时清零 fb_nflag <= 1'b0; end else begin fb_flag <= 1'b1; // 反馈时钟到来后置1 fb_nflag <= 1'b0; end end // 主逻辑:检测相位关系 - 谁先来谁占优 // 在参考时钟上升沿判断:如果反馈时钟还没来,说明参考超前 always @(posedge reference_signal_d2) begin if (!fb_flag_d2) lag_signal <= 1'b1; // fb_dly为0表示controlled_signal尚未到达,reference_signal超前 else lag_signal <= 1'b0; // fb_dly为1表示controlled_signal已到,两者已对齐或参考滞后 end // 在反馈时钟上升沿判断:如果参考时钟还没来,说明反馈超前(即参考滞后) always @(posedge controlled_signal_d2) begin if (!ref_flag_d2) lead_signal <= 1'b1; // ref_dly为0表示reference_signal尚未到达,controlled_signal超前 else lead_signal <= 1'b0; // ref_dly为1表示reference_signal已到,两者已对齐或反馈滞后 end //下降沿 always @(negedge reference_signal or negedge rst) begin if (!rst) begin ref_nflag <= 1'b0; // 复位时清零 ref_flag <= 1'b0; end else begin ref_nflag <= 1'b1; // 参考时钟到来后置1 ref_flag <= 1'b0; end end always @(negedge controlled_signal or negedge rst) begin if (!rst) begin fb_nflag <= 1'b0; // 复位时清零 fb_flag <= 1'b0; end else begin fb_nflag <= 1'b1; // 反馈时钟到来后置1 fb_flag <= 1'b0; end end always @(negedge reference_signal_d2) begin if (!fb_nflag_d2) lag_signal_n <= 1'b1; // fb_dly为0表示controlled_signal尚未到达,reference_signal超前 else lag_signal_n <= 1'b0; // fb_dly为1表示controlled_signal已到,两者已对齐或参考滞后 end // 在反馈时钟上升沿判断:如果参考时钟还没来,说明反馈超前(即参考滞后) always @(negedge controlled_signal_d2) begin if (!ref_nflag_d2) lead_signal_n <= 1'b1; // ref_dly为0表示reference_signal尚未到达,controlled_signal超前 else lead_signal_n <= 1'b0; // ref_dly为1表示reference_signal已到,两者已对齐或反馈滞后 end // 消毛刺逻辑:在任一时钟下降沿清零lead_signal_wire/lag_signal_wire信号 // 防止多脉冲叠加,确保每个周期只产生一个有效脉冲 /* always @(negedge reference_signal or negedge controlled_signal) begin {lead_signal_wire, lag_signal_wire} <= 2'b00; // 在时钟下降沿同时复位两个输出 end */ always @(posedge clk or negedge rst) begin if (!rst) begin lead_signal_wire <= 'b0; lag_signal_wire <= 'b0; end //else if(bothEdge & bothEdge_fb) begin else if((bothEdge & bothEdge_fb) | (bothEdge_n & bothEdge_fb_n)) begin lead_signal_wire <= 'b0; lag_signal_wire <= 'b0; end else begin lead_signal_wire <= lead_signal | lead_signal_n; lag_signal_wire <= lag_signal | lag_signal_n; end end endmodule数字振荡器(DCO) 现在我们已经构造出来了一个数字鉴相器,接下来我们将继续探讨如何实现一个数字振荡器(DCO)。 实现一个固定脉冲频率的信号,我们可以通过已知的时钟源,分频得到一定频率范围内的脉冲。具体实现方法就是通过计数器的方式,当出现时钟脉冲时,计数器+1,计数器上限就是分频系数,当计数器的数小于上限的1/2时,输出1,当计数器的数大于上限的1/2时,输出0,当计数器的数超过上限时,计数器归零。这样就能实现对时钟源的分频。 根据上述方法,只要改变计数器的上下限,就能改变分频系数,从而改变输出信号的频率。再参考上文受控信号和滞后提前信号的关系,我们就能通过根据滞后提前信号,改变计数器上下限,来实现对受控信号频率的控制。当计数器上限增加时,分频系数增加,频率减小;当计数器上限减小时,分频系数减小,频率增加;因此有: 滞后信号——>受控信号的频率小——>增加受控信号的频率——>计数器上限减小 提前信号——>受控信号的频率大——>减小受控信号的频率——>计数器上限增加 此外根据上述对上升沿触发同步的说法,当出现上升沿触发信号时,受控信号应强制产生上升沿,即受控信号强制从该脉冲周期的开始处开始,即计数器的数回到0从新开始计数。 综上所述,再加上复位信号,一个数字振荡器的所有构成就有了。到这里,一个数字锁相环(DPLL)其实就已经能够实现了,因为数字滤波器(DB)只是让受控信号的抗干扰能力更强,如图所示是仿真后的结果: 图片 数字缓冲器(DB) 下面再介绍一下数字缓冲器,来使受控信号的抗干扰能力更强。前面我们知道了,持续一个时钟周期的提前信号或者滞后信号能够使数字振荡器的计数器上限加一或者减一。当我的预设的数字振荡器的计数器上限与实际的参考信号的频率对应的计数器上限两个数值相差很大时,就有可能出现锁相环调节时间过长等现象。为了解决这种情况,如果能够让原来持续一个周期的提前信号或滞后信号成倍数的增加,变成持续n个周期的提前信号或者滞后信号,就能够使数字振荡器的计数器上限修改更快,从而更快的到达参考频率附近。但是相应的,受控信号的频率精度就会降低。也就是说,牺牲精度,追求速度。 同时考虑另外一种情况,如果我对速度要求不高,但是对于精度要求较高,同时在信号传输过程中可能存在干扰,导致接收到的提前信号或滞后信号不是完全真实的信号,此时就可以通过一个累加器,只有接受到n个周期的提前信号,或者滞后信号,才对数字振荡器输出一个进位信号或者借位信号,此时数字振荡器的计数器上限才只加减1,这样就能有效的提高精度,减少信号干扰带来的影响。但是这种做法牺牲了数字锁相换锁定的时间。 综上所述,一个时钟周期的提前或滞后信号,对应n个时钟周期的借位或进位信号,是提高锁定速度,降低锁定精度。想法,n个时钟周期的提前或滞后信号,对应一个时钟周期的借位或进位信号,是提高锁定精度,降低锁定速度。因此在实际运用中,应该按照自己的工程需要,合理选择比值。 上述过程的实现方法,是通过一个计数器,当接收到一个提前或滞后信号时,计数器加a,当输出一个进位或借位信号时,计数器减b,调节a和b的比值,就能实现上述过程。 数字缓冲器的仿真效果: 1、分时效果 图片 2、倍时效果 图片 数字锁相环(DPLL)的实现 所有的子模块都已经实现了,剩下的数字锁相环的实现,根据实际的要求,将上述几个模块进行例化就行。例化后的测试结果如图9所示,可以看到受控信号逐渐与参考信号对齐达到锁相环效果。 图片 为了方便起见,对输出信号进行2分频,再次观察输出结果,输出相当于2倍频了,成功完成PD、DCO、Divider等模块正确设计。 图片 电路硬件与性能评估 图11为电路硬件图从图中可以看出各模块的连接关系,每个模块由基本门电路构成。通过性能优化后的的电路如图12所示。 图片 利用SMIC180nm工艺进行电路综合, 时序报告:周期2ns 图片 面积报告:2119um2 图片 功耗报告:uw级别 图片 工程代码下载
FPGA&ASIC
# ASIC/FPGA
刘航宇
3年前
1
4,104
5
上一页
1
2
3
...
14
下一页