🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,260 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,787 阅读
3
【高数】形心计算公式讲解大全
9,134 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,201 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,919 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
56(共77篇)
找到
77
篇与
56
相关的结果
- 第 2 页
泛化能力,过拟合,欠拟合,不收敛,奥卡姆剃刀
摘要本文介绍了机器学习中的泛化能力、欠拟合、过拟合和不收敛等概念,并分析了它们的成因和解决方法,包括增加数据特征、使用更高级的模型、降低模型复杂度、数据集扩增、数据增强、正则化、dropout、早停、重新清洗数据和集成学习方法等。关键词:泛化能力, 过拟合, 欠拟合, 不收敛, 正则化泛化能力 欠拟合过拟合与不收敛 解决手段一、模型训练拟合的分类和表现 二、欠拟合 三、过拟合 总结: 泛化能力 泛化能力(generalization ability)是指机器学习算法对新鲜样本的适应能力,简而言之是在原有的数据集上添加新的数据集,通过训练输出一个合理的结果。学习的目的是学到隐含在数据背后的规律,对具有同一规律的学习集以外的数据,经过训练的网络也能给出合适的输出,该能力称为泛化能力。 欠拟合过拟合与不收敛 用比较直白的话来讲,就是通过数据训练学习的模型,拿到真实场景去试,这个模型到底行不行,如果达到了一定的要求和标准,它就是行,说明泛化能力好,如果表现很差,说明泛化能力就差。为了更好的理解泛化能力,这里引入三种现象,欠拟合、过拟合以及不收敛。 欠拟合(under-fitting),是指模型拟合程度不高,数据距离拟合曲线较远,或指模型没有很好地捕捉到数据特征,不能够很好地拟合数据。即,在训练数据集上表现差,在测试集数据也表现差。 过拟合(over-fitting),是指模型在训练集上表现很好,在测试集上效果差。 不收敛(non-convergence),指误差函数一直在振荡,不能趋近一个定值,没有找到局部或者全局最小值。 举个例子来说明下,好比高考数学考试,为了在高考能有个好成绩,高一到高三,好多人会采用“题海战术”来训练自己的做题能力,但高考试卷上的题,都是新题,几乎没有一模一样的题,学生们为了掌握解题规律就不停的刷题,希望最后自己碰到类似的题,能够举一反三,能学以致用,这种规律掌握的适用性,就是泛化能力。 有的人对相似题型的解题规律掌握的很好,并且解题效果也很好,这种就是泛化能力强,这种同学往往数学成绩就好。 有的同学成绩不好,就是泛化能力差,可能有三种情况 1.做了不少题,但没有找到解题规律,不管碰到老题和新题都不会做,这种就是欠拟合。 2.做了很多题,自认为做过的每一类题型的解题规律都掌握了,而且在之前“题海战术”的题目中,确实表现的很好,但是一碰到新的题目,完全就不会,或者做错,这种学生就是那种喜欢死记硬背的,这种就是过拟合。 3.平常也不做题,然后每次一做题就瞎蒙,导致偶尔对,偶尔错,这种就是不收敛。 为了更直观展示,引用了几张图来说明,如下图所示,真实曲线是正弦曲线,蓝色的点是训练数据,红色的线为拟合曲线。 图片 图片 解决手段 在深度学习的模型建立过程中,一般都是用已经产生的数据训练,然后使用训练得到的模型去拟合未来的数据,借此来预测一些东西。在机器学习和深度学习的训练过程中,经常会出现欠拟合和过拟合的现象。训练一开始,模型通常会欠拟合,所以会对模型进行优化,等训练到一定程度后,就需要解决过拟合的问题了。 一、模型训练拟合的分类和表现 如何判断过拟合呢?我们在训练的时候会定义训练误差,验证集误差,测试集误差(即泛化误差)。训练误差总是减少的,而泛化误差一开始会减少,到了一定程度后不减少反而开始增加,这时候便出现了过拟合的现象。 如下图,直观理解,欠拟合就是还没有学习到数据的特征,还有待继续学习,所以此时判断的不准确;而过拟合则是学习的太彻底,以至于把数据的一些不需要的局部特征或者噪声所带来的特征都给学习到了,所以在测试的时候泛化误差也不佳。 图片 从方差和偏差的角度来说,欠拟合就是在训练集上高方差,高偏差,过拟合就是高方差,低偏差。为了更加直观,我们看下面的图 图片 对比上图,图一的拟合并没有把大体的规律给拟合出来,拟合效果不好,这个就是欠拟合,还需要继续学习规律,此时模型简单;图三的拟合过于复杂,拟合的过于细致,以至于拟合了一些没有必要的东西,这样在训练集上效果很好,但放到测试集和验证集就会不好。图二是最好的,把数据的规律拟合出来了,也没有更复杂,更换数据集后也不会效果很差。 在上面的拟合函数中,可以想到,图三过拟合的拟合函数肯定是一个高次函数,其参数个数肯定比图二多,可以说图三的拟合函数比图二要大,模型更加复杂。这也是过拟合的一个判断经验,模型是否过于复杂。另外针对图三,我们把一些高次变量对应的参数值变小,也就相当于把模型变简单了。从这个角度上讲,可以减少参数值,也就是一般模型过拟合,参数值整体比较大。从模型复杂性上讲,可以是: ——模型的参数个数; ——模型的参数值的大小。 个数越多,参数值越大,模型越复杂。 二、欠拟合 欠拟合的表现 有什么方法来判断模型是否欠拟合呢?其实一般都是依靠模型在训练集和验证集上的表现,有一个大概的判断就行了。如果要有一个具体的方法,可以参考机器学中,学习曲线来判断模型是否过拟合,如下图: 图片 欠拟合的解决方案 (1)增加数据特征:欠拟合是由于学习不足导致的,可以考虑添加特征,从数据中挖掘更多的特征,有时候嗨需要对特征进行变换,使用组合特征和高次特征; (2)使用更高级的模型:模型简单也会导致欠拟合,即模型参数过少,结构过于简单,例如线性模型只能拟合一次函数的数据。尝试使用更高级的模型有助于解决欠拟合,增加神经网络的层数,增加参数个数,或者使用更高级的方法; (3)减少正则化参数:正则化参数是用来防止过拟合的,出现欠拟合的情况就要考虑减少正则化参数。 三、过拟合 过拟合的定义 模型在训练集上表现好,但在测试集和验证集上表现很差,这就是过拟合 图片 过拟合的原因 (1)数据量太小 这是很容易产生过拟合的原因。设想我们有一组数据很好的满足了三次函数的规律,但我们只取了一小部分数据进行训练,那么得到的模型很可能是一个线性函数,把这个线性函数用于测试集上,可想而知肯定效果很差。(此时训练集上效果好,测试集效果差) (2)训练集和验证集分布不一致 这也是很大一个原因。训练集上训练出来的模型适合训练集,当把模型应用到一个不一样分布的数据集上,效果肯定大打折扣,这个是显而易见的。 (3)网络模型过于复杂 选择模型算法时,选择了一个复杂度很高的模型,然而数据的规律是很简单的,复杂的模型反而不适用了。 (4)数据质量很差 数据有很多噪声,模型在学习的时候,肯定也会把噪声规律学习到,从而减少了一般性的规律。这个时候模型预测效果也不好。 (5)过度训练 这是同第四个相联系的,只要模型训练时间足够长,那么模型肯定会把一些噪声隐含的规律学习到,这时候降低模型的性能也是显而易见的。 解决方法 (1)降低模型复杂度 处理过拟合的第一步就是降低模型复杂度。为了降低复杂度,我们可以简单地移除层或者减少神经元的数量使得网络规模变小。与此同时,计算神经网络中不同层的输入和输出维度也十分重要。虽然移除层的数量或神经网络的规模并无通用的规定,但如果你的神经网络发生了过拟合,就尝试缩小它的规模。 (2)数据集扩增 在数据挖掘领域流行着这样的一句话,“有时候往往拥有更多的数据胜过一个好的模型”。因为我们在使用训练数据训练模型,通过这个模型对将来的数据进行拟合,而在这之间又一个假设便是,训练数据与将来的数据是独立同分布的。即使用当前的训练数据来对将来的数据进行估计与模拟,而更多的数据往往估计与模拟地更准确。因此,更多的数据有时候更优秀。但是往往条件有限,如人力物力财力的不足,而不能收集到更多的数据,如在进行分类的任务中,需要对数据进行打标,并且很多情况下都是人工得进行打标,因此一旦需要打标的数据量过多,就会导致效率低下以及可能出错的情况。所以,往往在这时候,需要采取一些计算的方式与策略在已有的数据集上进行手脚,以得到更多的数据。 通俗的讲,数据机扩增即需要得到更多的符合要求的数据,即和已有的数据是独立同分布的,或者近似独立同分布的。一般有以下方法: ——从数据源头采集更多数据 ——复制原有数据加上噪声 ——重采样 ——根据当前数据集估计数据分布参数,利用该分布产生更多数据(3)数据增强 使用数据增强可以生成多幅相似图像。这可以帮助我们增加数据集从而减少过拟合。因为随着数据量的增加,模型无法过拟合所有样本,因此不得不进行泛化。计算机视觉领域通常的做法有:翻转,平移,旋转,缩放,改变亮度,添加噪声等。 (4)正则化 正则化是指在进行目标函数或者代价函数优化时,在目标函数或者代价函数后面加上一个正则项,一般有L1正则和L2正则等。 L1惩罚项的目的是使权重绝对值最小化,公式如下: 图片 L1惩罚项的目的是使权重的平方最小化,公式如下: 图片 下面对两种正则化方法进行了比较: 图片 如果数据过于复杂以致没有办法进行准确的建模,那么L2是更好的选择,因为它能够学习数据中呈现的内在模式。而当数据足够简单,可以精确建模的话,L1更合适,对于我遇到的大多数计算机视觉问题,L2正则化几乎总是可以给出最好的结果。然而L1不容易受到离群值的影响。所以正确的正则化选项取决于我们想要解决的问题。 总结: 正则项是为了降低模型的复杂度,从而避免模型过分拟合训练数据,包括噪声与异常点。从另一个角度讲,正则化即是假设模型参数服从先验概率,即为模型参数添加先验,只是不同的正则化方式的先验分布是不一样的。这样就规定了参数的分布,使得模型的复杂度降低(试想一下,限定条件多了,是不是模型的复杂度就降低了呢),这样模型对于噪声和异常点的抗干扰性的能力增强,从而提高模型的泛化能力。还有个解释,从贝叶斯学派来看,加了先验,在数据少的时候,先验知识可以防止过拟合;从频率学派来看,正则项限定了参数的取值,从而提高了模型的稳定性,而稳定性强的模型不会过拟合,即控制模型空间。 另外一个角度,过拟合从直观上理解便是,在对训练数据进行拟合时,需要照顾到每个点,从而使得拟合函数波动性非常大,即方差大。在某些小区间里,函数值的变化很剧烈,意味着函数在某些小区间的导数值的绝对值非常大,由于自变量的值在给定的训练数据集中是一定的,因为只有系数足够大,才能保证导数的绝对值足够大,如下图: 图片 另一个解释,规则化项的引入,在训练(最小化cost)的过程中,当某一维的特征所对应的权重过大时,而此时模型的预测和真实数据之间的距离很小,通过规则化项就可以使整体的cost取较大的值,从而,在训练的过程中避免了去选择了那些某一维(或几维)特征权重过大的情况,即过分依赖某一维(或几维)的特征。 L1和L2的区别是,L1正则是拉普拉斯先验,L2正则则是高斯先验。它们都是服从均值为0,协方差为1/λ。当λ=0,即没有先验,没有正则项,则相当于先验分布具有无穷大的协方差,那么这个先验约束则会非常弱,模型为了拟合拟合所有的训练集数据,参数可以变得任意大从而使得模型不稳定,即方差大而偏差小。λ越大,表明先验分布协方差越小,偏差越大,模型越稳定。即,加入正则项是在偏差bias与方差variance之间做平衡tradeoff。下图即为L2与L1正则的区别: 图片 上图中的模型是线性回归,有两个特征,要优化的参数分别是w1和w2,左图的正则化是L2,右图是L1。蓝色线就是优化过程中遇到的等高线,一圈代表一个目标函数值,圆心就是样本观测值(假设一个样本),半径就是误差值,受限条件就是红色边界(就是正则化那部分),二者相交处,才是最优参数。可见右边的最优参数只可能在坐标轴上,所以就会出现0权重参数,使得模型稀疏。 其实拉普拉斯分布和高斯分布是数学家从试验中误差服从什么分布研究得出的。一般直观上的认识是服从均值为0的对称分布,并且误差大的概率低,误差小的概率高,因为拉普拉斯使用拉普拉斯分布对误差的分布进行拟合,如下图: 图片 而拉普拉斯在最高点,即自变量为0处不可导,因为不便于计算,于是高斯在这基础上使用高斯分布对其进行拟合,如下图: 图片 (5)dropout 正则时通过再代价函数后面加上正则项来防止过拟合的。而在神经网络中,有一种方法时通过修改神经网络本身结构实现的,其名为dropout。该方法是对网络进行训练时用的一种技巧,对于如下的三层人工神经网络: 图片 对于上图所示的网络,在训练开始时,随即删除一些(可自己设定概率)隐藏层神经元,即认为这些神经元不存在,同时保持输入层和输出层的个数不变,这样便得到如下的ANN: 图片 然后按照BP学习算法对ANN中的参数进行学习更新(虚线链接的单元不更新,因为认为这些连接元被临时删除了)。这样一次迭代更新便完成了,下一次迭代中,同样随机删除一些神经元,与上次不一样,做随机选择,这样一直进行,直至训练结束。 这种技术被证明可以减少很多问题的过拟合,这些问题包括图像分类,图像切割,词嵌入,语义匹配等问题。 (6)早停 对模型的训练即是对模型的参数进行更新的过程,这个参数学习的过程往往会用到一些迭代方法,如梯度下降(Gradient descent)学习算法。Early stopping一种迭代次数截断的方法来防止过拟合的方法,即在模型对训练数据集迭代收敛之前停止迭代来防止过拟合。 Early stopping方法的具体做法是,在每一个Epoch结束时(一个Epoch集为对所有的训练数据的一轮遍历)计算验证集的正确率,当正确率不再提高时,就停止训练。这种做法很符合直观感受,因为正确率都不在提高了,再继续训练也是无益的,只会提高训练的时间。如下图,在几次迭代后,即使训练误差仍然在减少,但测验误差已经开始增加了。 图片 那么该做法的一个重点便是怎样才认为验证准确率validation accurary不再提高了呢?并不是说验证准确率validation accurary一降下来便认为不再提高了,因为可能经过这个Epoch后,正确率降低了,但是随后的Epoch又让正确率又上去了,所以不能根据一两次的连续降低就判断不再提高。一般的做法是,在训练的过程中,记录到目前为止最好的验证准确率validation accurary,当连续10次没达到最佳正确率时,认为不再提高了,此时便可以停止迭代。这种策略也称为“No-improvement-in-n”,n即Epoch的次数,可以根据实际情况取,如10、20、30…… (7)重新清洗数据 把明显异常的数据剔除。 (8)使用集成学习方法 把多个模型集成在一起,降低单个模型的过拟合风险。
机器学习
# 机器学习
刘航宇
2年前
0
1,354
2
2024-01-11
嵌入式常见知识点
摘要本文介绍了嵌入式系统开发中常见的知识点,包括线程与进程的区别、整数是否为2的n次方的计算方法、printf函数的实现、大小端的概念及区分方法、new与malloc的区别、程序链接后的组成部分、Linux、Windows与FreeRTOS的区别等。关键词:嵌入式, 进程, 线程, 位运算, 快速排序图片 1、线程、进程的区别?最小执行单元是进程还是线程? 2、如何计算一个整数是不是2的n次方? 3、printf的具体实现? 4、什么是大小端?如何区分?有几种方法? 5、new与malloc的区别? 6、程序链接完毕之后分几部分? 7、Linux、Windows与FreeRtos的区别? 8、Linux系统中的中断为什么分为上下两个部分? 9、会快速排序吗?简要说一下? 10、static关键字的作用? 11、extern 关键字的作用? 12、volatile关键字的作用? 13、编译原理分哪几步? 14、内存分区? 15、freertos启动流程? 16、互斥锁与信号量的区别? 17、什么是死锁?死锁产生的原因?如何避免? 18、什么是内存泄漏? 19、系统死机了怎么排查原因?逐一看代码?工程量太大了吧? 20、同一类型的结构体定义两个变量能用内存大小来比较判断两者一样吗?(没懂) 21、freertos中EventBits_t是干啥的? 22、freertos使任务切换的方式有哪些? 23、项目中用到网络了吗? 24、了解Socket吗? 25、c++中set是什么? 26、有没有用到C++模板? 27、有没有对代码裁剪的经验 28、freertos系统是买模块时人家配置好的?还是移植的? 29、任务里有两把锁的时候该怎么处理 30、熟悉Shell脚本吗?$和#啥意思? 表示注释的开始,可以用来对代码进行说明,不会被执行,例如#echo hello,#这是一个注释,表示打印hello,后面的内容是一个注释。31、知道#error吗? 32、freertos消息队列的的具体实现? 33、堆栈区别? 34、程序存放状态和区别 1、线程、进程的区别?最小执行单元是进程还是线程? 线程和进程都是程序的执行实体,但是它们有以下区别: 进程是操作系统分配资源的基本单位,每个进程都有自己的独立的地址空间,代码段,数据段,堆栈段等。进程之间的切换需要保存和恢复上下文,开销较大。 线程是操作系统调度的基本单位,每个线程都属于某个进程,一个进程可以有多个线程,它们共享进程的地址空间,但是有自己的栈和寄存器。线程之间的切换只需要保存和恢复少量的寄存器,开销较小。 最小的执行单元是线程,因为一个进程至少要有一个线程,而一个线程可以独立运行。 2、如何计算一个整数是不是2的n次方? 一个整数是2的n次方,当且仅当它的二进制表示中只有一个1,其余都是0。例如,23=8=(1000)2 ,只有一个1。所以,我们可以用以下的方法来判断一个整数x是否是2的n次方: 如果x小于等于0,那么它不是2的n次方。 如果x大于0,那么我们可以用位运算的技巧,将x与x-1做按位与,如果结果为0,那么x是2的n次方,否则不是。例如,8&(8−1)=8&7=(1000)2&(0111)2=(0000)2=0 ,所以8是2的n次方。而9&(9−1)=9&8=(1001)2&(1000)2=(1000)2=0 ,所以9不是2的n次方。 3、printf的具体实现? printf是C语言中的一个标准库函数,用于向标准输出流(通常是屏幕)打印格式化的字符串。它的具体实现可能因编译器和操作系统的不同而有所差异,但是一般来说,它的主要步骤如下: 首先,printf会解析第一个参数,也就是格式化字符串,根据其中的转换说明符(如%d, %f, %s等),确定需要打印的数据类型和格式。 然后,printf会从第二个参数开始,依次获取对应的数据,并将其转换为字符串,拼接到格式化字符串的相应位置。如果参数的个数和类型与格式化字符串不匹配,可能会导致错误或未定义的行为。 最后,printf会调用底层的系统函数,将拼接好的字符串写入到标准输出流中,并返回成功写入的字符数。如果发生错误,返回负值。 4、什么是大小端?如何区分?有几种方法? 大小端是指数据在内存中的存储顺序,大端表示高位字节存放在低地址,低位字节存放在高地址,小端表示高位字节存放在高地址,低位字节存放在低地址。例如,一个32位的整数0x12345678,在大端模式下,存储为0x12 0x34 0x56 0x78,而在小端模式下,存储为0x78 0x56 0x34 0x12。 区分大小端的方法有以下几种: 通过联合体(union)的方式,将一个整数和一个字符数组放在同一个联合体中,然后判断字符数组的第一个元素是不是整数的最低字节,如果是,说明是小端,否则是大端。 通过指针的方式,将一个整数的地址赋给一个字符指针,然后判断指针指向的内容是不是整数的最低字节,如果是,说明是小端,否则是大端。 通过位运算的方式,将一个整数右移24位,然后与0xFF做按位与,得到的结果是不是整数的最高字节,如果是,说明是大端,否则是小端。 5、new与malloc的区别? new和malloc都是用于动态分配内存的,但是它们有以下区别: new是C++中的运算符,malloc是C语言中的函数,它们的用法不同。new可以直接分配对象,而malloc只能分配字节,需要强制类型转换。 new会调用对象的构造函数,初始化对象,而malloc只是分配原始的内存空间,不做任何初始化。 new会根据对象的类型,自动计算所需的内存大小,而malloc需要手动指定分配的字节数。 new分配失败时,会抛出异常,而malloc分配失败时,会返回NULL指针。 new对应的释放内存的运算符是delete,而malloc对应的释放内存的函数是free。 6、程序链接完毕之后分几部分? 程序链接完毕之后,一般分为以下几个部分: 代码段(text segment),存放程序的指令和常量。 数据段(data segment),存放程序的全局变量和静态变量。 堆(heap),存放程序动态分配的内存空间。 栈(stack),存放程序的局部变量,函数参数,返回地址等。 BSS段(bss segment),存放程序未初始化的全局变量和静态变量。 7、Linux、Windows与FreeRtos的区别? Linux、Windows和FreeRtos都是操作系统,但是它们有以下区别: Linux是一个开源的,基于Unix的,多用户,多任务,支持多种硬件平台的操作系统,它有很多不同的发行版,如Ubuntu,RedHat,Debian等。Linux适合用于服务器,嵌入式系统,桌面系统等。 Windows是一个闭源的,基于NT内核的,多用户,多任务,主要支持x86和x64架构的操作系统,它有很多不同的版本,如Windows 10,Windows Server,Windows CE等。Windows适合用于桌面系统,移动设备,游戏机等。 FreeRtos是一个开源的,基于微内核的,实时,多任务,支持多种嵌入式平台的操作系统,它有很多不同的移植,如ARM,MIPS,AVR等。FreeRtos适合用于实时控制,物联网,低功耗设备等。 8、Linux系统中的中断为什么分为上下两个部分? Linux系统中的中断为了提高效率和响应时间,分为上半部(top half)和下半部(bottom half)。上半部是指中断处理程序(interrupt handler),它负责处理中断的紧急事务,如保存寄存器,清除中断标志,识别中断源等。下半部是指中断延迟服务程序(interrupt deferred service routine),它负责处理中断的非紧急事务,如数据传输,设备驱动,信号发送等。上半部和下半部的区别如下: 上半部在中断上下文中执行,下半部在进程上下文中执行。 上半部不能被其他中断打断,下半部可以被其他中断打断。 上半部不能睡眠,下半部可以睡眠。 上半部不能调用可能导致阻塞的函数,如malloc,copy_to_user等,下半部可以调用这些函数。 上半部的执行时间应该尽可能短,下半部的执行时间可以较长。 9、会快速排序吗?简要说一下? 快速排序是一种基于分治思想的排序算法,它的基本步骤如下: 从待排序的数组中选择一个元素作为基准(pivot),通常选择第一个或者最后一个元素。 将数组分成两个子数组,一个子数组中的元素都小于或等于基准,另一个子数组中的元素都大于基准,这个过程称为划分(partition)。 对两个子数组递归地进行快速排序,直到子数组的长度为1或0。 将排好序的子数组合并,得到最终的排序结果。 快速排序的平均时间复杂度是O(nlogn) ,最坏情况是O(n^2) ,空间复杂度是O(logn) ,它是一种不稳定的排序算法。 10、static关键字的作用? static是一个修饰符,它可以用于变量和函数,它有以下作用: 用于全局变量,表示该变量只能在本文件中访问,不能被其他文件引用,这样可以避免命名冲突。 用于局部变量,表示该变量的生命周期是整个程序,而不是函数调用结束,这样可以保持变量的值不被销毁。 用于函数,表示该函数只能在本文件中调用,不能被其他文件引用,这样可以提高函数的封装性和安全性。 11、extern 关键字的作用? extern是一个修饰符,它可以用于变量和函数,它有以下作用: 用于变量,表示该变量是在其他文件中定义的,需要在本文件中引用,这样可以避免重复定义。 用于函数,表示该函数是在其他文件中定义的,需要在本文件中声明,这样可以避免隐式声明。 12、volatile关键字的作用? volatile是一个修饰符,它可以用于变量,它有以下作用: 用于变量,表示该变量可能会被外部因素(如中断,多线程,硬件等)改变,需要每次都从内存中读取,而不是从寄存器或缓存中读取,这样可以保证变量的实时性和一致性。 用于变量,表示该变量不会被编译器优化,需要按照程序的顺序执行,而不是进行重排或删除,这样可以避免编译器的干扰。 13、编译原理分哪几步? 编译原理是指将一种高级语言(源语言)的程序转换为另一种低级语言(目标语言)的程序的原理和方法,它一般分为以下几个步骤: 词法分析(lexical analysis),将源程序的字符序列分割成有意义的单词(token)。 语法分析(syntax analysis),将单词序列组织成语法树(parse tree)或抽象语法树(abstract syntax tree),表示程序的结构和语义。 语义分析(semantic analysis),检查程序是否符合语言的语法规则和语义规则,如类型检查,作用域分析等。 中间代码生成(intermediate code generation),将抽象语法树转换为一种中间表示(intermediate representation),如三地址码,四元式,后缀表达式等,便于优化和目标代码生成。 代码优化(code optimization),对中间表示进行一些变换,以提高程序的执行效率,如常量折叠,公共子表达式消除,循环优化,死代码删除等。 目标代码生成(target code generation),将中间表示转换为目标语言的代码,如汇编语言,机器语言等,同时进行一些分配,如寄存器分配,指令选择等。 14、内存分区? 内存分区是指将物理内存划分为若干个逻辑区域,以便于管理和使用。内存分区的方式有以下几种: 固定分区,将内存分为大小相等或不等的若干个区域,每个区域只能装入一个进程,如果进程的大小超过区域的大小,就会产生内部碎片。 动态分区,根据进程的大小和数量,动态地分配和回收内存空间,每个区域可以装入一个或多个进程,如果进程的大小不是区域的整数倍,就会产生外部碎片。 页式分区,将进程的地址空间划分为大小相等的若干个页,将物理内存划分为大小相等的若干个页框,然后将页映射到页框,实现非连续的内存分配,避免了外部碎片,但是可能产生内部碎片。 段式分区,将进程的地址空间划分为大小不等的若干个段,每个段有自己的逻辑地址和属性,然后将段映射到物理内存,实现非连续的内存分配,避免了内部碎片,但是可能产生外部碎片。 段页式分区,将进程的地址空间划分为若干个段,每个段再划分为若干个页,然后将页映射到物理内存的页框,实现非连续的内存分配,避免了内部碎片和外部碎片,但是增加了地址转换的复杂度。 15、freertos启动流程? freertos是一个实时操作系统,它的启动流程一般如下: 首先,执行硬件初始化,如设置时钟,中断,堆栈等。 然后,执行软件初始化,如创建任务,队列,信号量,定时器等。 接着,调用vTaskStartScheduler ()函数,启动调度器,选择优先级最高的就绪任务运行。 最后,当发生中断,延时,阻塞等事件时,调度器会根据算法,如优先级抢占式,时间片轮转式等,切换任务,实现多任务的并发执行。 16、互斥锁与信号量的区别? 互斥锁(mutex)和信号量(semaphore)都是用于实现多任务的同步和互斥的机制,但是它们有以下区别: 互斥锁是一个二元的同步对象,它只有两种状态:锁定和解锁。一个互斥锁只能被一个任务拥有,当一个任务获取互斥锁后,其他任务就不能再获取该互斥锁,直到拥有者释放它。互斥锁通常用于保护临界区的访问,避免数据的不一致。 信号量是一个计数的同步对象,它有一个初始值,表示可用的资源数量。一个信号量可以被多个任务共享,当一个任务获取信号量后,信号量的值减一,表示资源被占用。当信号量的值为零时,表示没有可用的资源,其他任务就要等待,直到有任务释放信号量,信号量的值加一,表示资源被释放。信号量通常用于实现生产者-消费者模型,控制资源的分配和回收。 17、什么是死锁?死锁产生的原因?如何避免? 死锁是指多个任务因为争夺有限的资源而相互等待,导致无法继续执行的现象。死锁产生的原因一般有以下四个必要条件: 互斥条件,指每个资源只能被一个任务拥有,其他任务不能访问。 占有且等待条件,指一个任务已经占有了至少一个资源,但是又申请了其他已经被占有的资源,同时不释放自己已经占有的资源。 不可抢占条件,指一个任务占有的资源不能被其他任务强行剥夺,只能由占有者主动释放。 循环等待条件,指多个任务形成一个环路,每个任务都在等待下一个任务占有的资源。 避免死锁的方法有以下几种: 破坏互斥条件,使用非互斥的资源,如可复制的资源,或者使用软件技术,如事务,来实现对资源的虚拟访问。 破坏占有且等待条件,要求一个任务在申请资源时,必须一次性申请所有需要的资源,或者在申请新的资源时,必须先释放已经占有的资源。 破坏不可抢占条件,允许一个任务在占有资源时,被其他任务抢占,或者主动释放资源,以满足其他任务的需求。 破坏循环等待条件,给每个资源分配一个优先级,要求一个任务只能申请优先级高于或等于自己已经占有的资源的资源,或者按照一定的顺序申请资源,避免形成环路。 18、什么是内存泄漏? 内存泄漏是指程序在运行过程中,动态分配了一些内存空间,但是没有及时释放,导致这些内存空间无法被其他程序使用,造成内存的浪费和紧张。内存泄漏可能会导致程序的性能下降,甚至崩溃。 19、系统死机了怎么排查原因?逐一看代码?工程量太大了吧? 系统死机是指系统无法响应用户的输入,或者出现异常的错误,导致系统无法正常运行。排查系统死机的原因有以下几种方法: 通过日志文件,查看系统在死机前的运行状态,是否有异常的信息,如错误码,警告,断言等,以及死机的时间,位置,频率等,从而定位可能的问题源。 通过调试工具,如gdb,lldb等,对系统进行调试,查看系统的内存,寄存器,堆栈,断点等,分析系统的运行流程,发现潜在的错误,如内存泄漏,空指针,死锁等。 通过测试工具,如valgrind,asan等,对系统进行测试,检测系统的内存管理,性能,覆盖率等,发现系统的缺陷,如内存错误,资源泄漏,性能瓶颈等。 通过代码审查,对系统的代码进行分析,检查代码的风格,规范,逻辑,注释等,发现代码的不合理,不一致,不完善等,提高代码的质量,可读性,可维护性等。 通过重现问题,对系统的死机现象进行复现,观察系统的表现,输入,输出等,找出问题的触发条件,规律,范围等,缩小问题的范围,提高问题的可解决性。 20、同一类型的结构体定义两个变量能用内存大小来比较判断两者一样吗?(没懂) 同一类型的结构体定义两个变量,不能用内存大小来比较判断两者一样,因为内存大小只能反映结构体的占用空间,而不能反映结构体的内容。例如,以下两个结构体变量的内存大小都是8字节,但是它们的内容是不一样的: struct Point { int x; int y; }; struct Point p1 = {1, 2}; struct Point p2 = {3, 4}; 如果要比较两个结构体变量是否一样,需要逐个比较它们的成员,或者使用memcmp函数比较它们的内存内容。例如: // 逐个比较 if (p1.x == p2.x && p1.y == p2.y) { printf("p1 and p2 are equal\n"); } else { printf("p1 and p2 are not equal\n"); } // 使用memcmp比较 if (memcmp(&p1, &p2, sizeof(struct Point)) == 0) { printf("p1 and p2 are equal\n"); } else { printf("p1 and p2 are not equal\n"); }21、freertos中EventBits_t是干啥的? EventBits_t是一个数据类型,它用于表示事件标志组(event group)中的每个位的状态,每个位可以表示一个事件的发生或者一个条件的满足。EventBits_t通常是一个无符号整数,它可以使用位运算来设置,清除,读取或等待事件标志。 22、freertos使任务切换的方式有哪些? freertos使任务切换的方式有以下几种: 时间片轮转法,按照任务的优先级和时间片的长度,依次轮流执行每个就绪任务,当一个任务的时间片用完或者主动放弃时,切换到下一个任务。 优先级抢占法,按照任务的优先级,总是执行优先级最高的就绪任务,当有更高优先级的任务就绪时,立即抢占当前任务,切换到更高优先级的任务。 混合法,结合时间片轮转法和优先级抢占法,对于同一优先级的任务,使用时间片轮转法,对于不同优先级的任务,使用优先级抢占法,实现任务的公平性和效率。 23、项目中用到网络了吗? 这个问题的答案取决于你的项目的具体情况,如果你的项目需要与其他设备或服务器进行通信,或者需要访问互联网上的资源,那么你的项目就用到了网络。如果你的项目只是在本地运行,不需要与外界交互,那么你的项目就没有用到网络。 24、了解Socket吗? Socket是一种通信机制,它可以实现不同进程或不同设备之间的数据交换。Socket通常基于TCP/IP协议,提供了可靠的,双向的,面向连接的通信服务。Socket的基本操作包括创建,绑定,监听,连接,发送,接收,关闭等。Socket的编程接口通常是一组函数或类,不同的编程语言或平台可能有不同的实现,如C语言的socket.h,Java语言的java.net.Socket等。 25、c++中set是什么? set是C++标准模板库(STL)中的一个容器,它可以存储一组不重复的元素,并且按照一定的顺序排列。set的元素可以是任意类型,但是必须支持比较操作,如<,==等。set的底层实现通常是红黑树,所以它的插入,删除,查找等操作的时间复杂度都是O(logn) ,其中n是元素的个数。set的优点是可以快速地检查一个元素是否存在,以及保持元素的有序性。set的缺点是不能存储重复的元素,以及不能直接访问元素,只能通过迭代器遍历。 26、有没有用到C++模板? C++模板是一种泛型编程的技术,它可以让程序员定义一种通用的模式,然后根据不同的类型或参数,生成不同的代码,从而实现代码的复用和抽象。C++模板有两种,一种是函数模板,用于定义通用的函数,另一种是类模板,用于定义通用的类。例如,以下是一个函数模板,用于比较两个值的大小: template <typename T> T max(T x, T y) { return (x > y) ? x : y; } 我有用过C++模板,它们可以让我的代码更简洁,更灵活,更高效。我用过STL中的一些类模板,如vector,map,set等,也用过自己定义的一些函数模板和类模板,来实现一些通用的算法和数据结构。 27、有没有对代码裁剪的经验 代码裁剪是指对代码进行优化,删除不必要的或冗余的代码,减少代码的体积和复杂度,提高代码的可读性和可维护性。代码裁剪的目的是为了提高程序的性能,节省内存空间,降低编译时间,避免错误和漏洞等。 我有对代码裁剪的经验,我用过一些工具和方法来进行代码裁剪,如: 使用编译器的优化选项,如-Os,-O3等,让编译器自动进行一些代码裁剪,如常量折叠,死代码删除,循环展开等。 使用代码分析工具,如lint,coverity等,检查代码的质量,发现代码的缺陷,如未使用的变量,函数,参数等,以及代码的风格,规范,注释等,然后根据工具的建议,修改或删除代码。 使用代码重构工具,如refactor,eclipse等,对代码进行重构,改善代码的结构,设计,逻辑等,消除代码的冗余,重复,复杂等,提高代码的可读性,可维护性,可扩展性等。 使用代码压缩工具,如upx,gzip等,对代码进行压缩,减少代码的体积,提高代码的传输速度,节省存储空间等。 28、freertos系统是买模块时人家配置好的?还是移植的? freertos系统是一个开源的,可移植的,实时的操作系统,它可以运行在多种嵌入式平台上,如ARM,MIPS,AVR等。freertos系统不是买模块时人家配置好的,而是需要根据不同的硬件和需求进行移植和定制的。移植freertos系统的步骤一般如下: 下载freertos的源码,选择合适的移植层,如portable/GCC/ARM_CM3等,根据目标平台的特性,修改一些配置参数,如configCPU_CLOCK_HZ,configTICK_RATE_HZ等。 编写启动代码,如设置时钟,中断,堆栈等,调用vPortStartFirstTask ()函数,启动第一个任务。 编写应用代码,如创建任务,队列,信号量,定时器等,调用vTaskStartScheduler ()函数,启动调度器。 编译,链接,下载,调试代码,检查系统的运行情况,如任务切换,中断响应,内存管理等。 29、任务里有两把锁的时候该怎么处理 任务里有两把锁的时候,可能会出现死锁的问题,即两个或多个任务因为互相等待对方占有的锁而无法继续执行。处理任务里有两把锁的时候,有以下几种方法: 避免使用两把锁,如果可能的话,尽量使用一把锁来保护临界区,或者使用其他同步机制,如信号量,事件标志等,来实现任务之间的协作。 按照一定的顺序获取和释放锁,如果必须使用两把锁,那么要求所有的任务都按照相同的顺序获取和释放锁,避免形成循环等待的条件。 使用超时机制,如果一个任务在获取锁时,发现锁已经被占用,那么不要无限期地等待,而是设置一个超时时间,如果超时时间到了,还没有获取到锁,那么就放弃获取,释放已经占有的锁,然后重新尝试或者执行其他操作。 使用优先级继承机制,如果一个任务在获取锁时,发现锁已经被占用,那么就把自己的优先级赋给占有锁的任务,让占有锁的任务尽快执行完毕,释放锁,然后恢复原来的优先级,这样可以避免优先级反转的问题。 30、熟悉Shell脚本吗?$和#啥意思? Shell脚本是一种用于控制Unix或Linux系统的命令行解释器,它可以实现一些自动化的任务,如文件操作,文本处理,程序运行等。Shell脚本的语法和结构类似于C语言,但是更加简洁和灵活。Shell脚本的文件名通常以.sh为后缀,例如test.sh。 $和#是Shell脚本中的两个特殊符号,它们有以下含义: $表示变量的引用,可以用来获取或设置变量的值,例如x=10,echo $x,表示将10赋值给变量x,然后打印x的值。 表示注释的开始,可以用来对代码进行说明,不会被执行,例如#echo hello,#这是一个注释,表示打印hello,后面的内容是一个注释。 31、知道#error吗? 、#error是一个预处理指令,它可以用来在编译时产生一个错误信息,中断编译过程。#error通常用来检查一些条件,如宏定义,平台,版本等,如果不满足条件,就提示错误,防止编译出错的代码。例如: #ifdef __linux__ #error This code is not compatible with Linux #endif 这段代码表示如果定义了__linux__宏,就产生一个错误信息,表示这段代码不兼容Linux系统。 32、freertos消息队列的的具体实现? freertos消息队列是一种用于实现任务之间或任务与中断之间的异步通信的机制,它可以存储一组有序的消息,每个消息可以是任意类型的数据。freertos消息队列的具体实现如下: 消息队列是一个结构体,它包含了一些成员,如队列的头指针,尾指针,长度,容量,锁,信号量等,用来管理队列的状态和操作。 消息队列的存储空间是一个数组,它可以是静态分配的或动态分配的,它的大小要能够容纳队列的最大容量乘以每个消息的大小。 消息队列的操作有以下几种,如创建,删除,发送,接收等,它们都是通过调用一些API函数来实现的,如xQueueCreate,vQueueDelete,xQueueSend,xQueueReceive等。 消息队列的操作都是原子的,即在操作过程中,不会被其他任务或中断打断,这是通过使用临界区或中断屏蔽来实现的,以保证队列的一致性和完整性。 消息队列的操作都是阻塞的,即如果队列满了,就不能发送消息,如果队列空了,就不能接收消息,这是通过使用信号量来实现的,以实现任务的同步和等待。 33、堆栈区别? 堆(heap)和栈(stack)都是程序运行时使用的内存空间,但是它们有以下区别: 堆是动态分配的,程序员可以自由地申请和释放堆上的内存空间,堆的大小受到物理内存的限制,堆上的内存空间的地址是不连续的。 栈是静态分配的,编译器会自动地分配和回收栈上的内存空间,栈的大小受到操作系统的限制,栈上的内存空间的地址是连续的。 堆是全局共享的,堆上的内存空间可以被任何函数或模块访问,堆上的内存空间的生命周期是由程序员控制的,如果不及时释放,可能会导致内存泄漏。 栈是局部私有的,栈上的内存空间只能被当前函数或模块访问,栈上的内存空间的生命周期是由编译器控制的,当函数调用结束时,栈上的内存空间就会被自动释放。 34、程序存放状态和区别 程序存放状态是指程序在运行过程中的不同阶段,它有以下几种: 新建状态,指程序刚刚被创建,还没有被加载到内存中,等待调度器的调度。 就绪状态,指程序已经被加载到内存中,已经分配了必要的资源,等待处理器的分配。 运行状态,指程序已经被分配了处理器,正在执行程序的指令。 阻塞状态,指程序在执行过程中,因为等待某些事件的发生,如输入输出,信号量,中断等,而暂时停止执行,释放处理器,等待事件的完成。 终止状态,指程序已经执行完毕,或者因为某些原因,如错误,异常,中断等,而被终止,释放内存和资源,从系统中消失。
嵌入式&系统
# 嵌入式
刘航宇
2年前
0
774
4
2023-12-26
AI: 机器学习必须懂的几个术语:Label、Feature、Model...
摘要本文介绍了机器学习中关键术语,包括标签、特征、样本、模型、回归和分类,并简要说明了它们在机器学习中的应用和重要性。关键词:AI, 机器学习, 术语, Label, Feature1.标签 Label 2.特征 Feature 3.样本 Example3.1有标签样本(labeled): 3.2无标签样本(unlabeled): 4.模型 Model 5.回归 Regression 6.分类 Classification 7.机器学习算法地图 1.标签 Label 标签:所预测的东东实际是什么(可理解为结论),如线性回归中的 y 变量,如分类问题中图片中是猫是狗(或图片中狗的种类)、房子未来的价格、音频中的单词等等任何事物,都属于Label。 (如一组图片,已经表明了哪些是狗,哪些是猫,这里Label就是分类问题中每一个类) 图片 2.特征 Feature 特征是事物固有属性,可理解为做出某个判断的依据,如人的特征有长相、衣服、行为动作等等,一个事物可以有N多特征,这些组成了事物的特性,作为机器学习中识别、学习的基本依据。 图片 特征是机器学习模型的输入变量。如线性回归中的 x 变量。 图片 例如在垃圾邮件分类问题中,特征可能包括: 电子邮件中是否包含 “ 广告、贷款、交易” 等短语 电子邮件文本中的字词 发件人的地址 发送电子邮件的时段 其中机器学习重要步骤:特征提取就是通过多种方式,对数据的特征数据进行提取。一般,特征数据越多,训练的机器学习模型就会越精确,但处理难度也越大。 3.样本 Example 样本是指一组或几组数据,样本一般作为训练数据来训练模型 样本分为以下两类: 有标签样本 无标签样本 3.1有标签样本(labeled): 同时包含特征和标签 图片 在监督学习中利用数据做训练时,有标签数据/样本(Labeled data)或叫有/无标记数据,就是指有没有将数据归为要预测的类别。 例如以下房价数据集: 图片 其中包含特征:卧室数量等,最右边一列是标签:房价中间值 (注,因为该问题要预测未来房价走势,所以Label就是某条房屋数据中的房价) 3.2无标签样本(unlabeled): 包含特征,但不包含标签 如以下数据集: 去掉了Label,但是一样有用(如用在测试训练后的模型,即训练好模型后,输入该数据,那到预测后的房价与原标签进行比较,得到模型误差) 图片 4.模型 Model 模型定义了特征与标签之间的关系,就是我们机器学习的一组数据关系表示,也是我们学习机器学习的核心 例如,垃圾邮件检测模型可能会将某些特征与“垃圾邮件”紧密联系起来。 模型生命周期的两个重要阶段: 训练 Training是指创建或学习模型。也就是说,向模型展示有标签样本,让模型逐渐学习特征与标签之间的关系。 训练模型表示通过有标签样本来学习(确定)所有权重和偏差的理想值 推断 Inference是指将训练后的模型应用于无标签样本。也就是说,使用经过训练的模型做出有用的预测 (y’)。 例如,模型训练好后,就可以使用模型进行Inference ,可以针对新的无标签样本预测房价medianHouseValue。 图片 5.回归 Regression 回归就是我们数学学习的线性方程,是一种经典函数逼近算法。 在机器学习中,就是根据数据集,建立一个线性方程组,能够无线逼近数据集中的数据点,是一种基于已有数据关系实现预测的算法。 回归模型可预测连续值(线性) 例如,回归模型做出的预测可回答如下问题: 某小区房价的趋势? 用户点击此广告的概率是多少? 图片 当机器学习模型最终目标(模型输出)是求一个具体数值时,例如房价的模型输出为25000,则大多数可以通过回归问题来解决。 线性回归的好处在与模型简单,计算速度快,方便应用在分布式系统对大数据进行处理。 线性回归还有个姐妹:逻辑回归(Logistic Regression),主要应用在分类领域 6.分类 Classification 顾名思义,分类模型可用来预测离散值 例如,分类模型做出的预测可回答如下问题: 是/否问题,某个指定电子邮件是垃圾邮件还是非垃圾邮件? 图片是动物还是人? 垃圾分类 图片 当机器学习模型最终目标(模型输出)是布尔或一定范围的数时,例如判断一张图片是不是人,模型输出0/1:0不是,1是;又例如垃圾分类,模型输出1-10之间的整数,1代表生活垃圾,2代表厨余垃圾。。等等,这类需求则大多数可以通过分类问题来解决。 7.机器学习算法地图 机器学习算法多种多样,许多情况下,建模和算法设计是Designer所选择的,具体采用哪种算法也没有一定要求,根据实际具体问题具体分析。 图片
机器学习
# 机器学习
刘航宇
3年前
0
1,300
2
2023-12-11
华为C++算法-识别有效的IP地址和掩码并进行分类统计
摘要本文介绍了华为C++算法,用于识别和分类IP地址及掩码。算法可识别A/B/C/D/E类地址,统计不合法地址和掩码、私有IP数量。通过字符分割、合法性判断和类别归类实现。关键词:华为,C++,IP地址分类,子网掩码,算法问题 注意: 输入描述: 输出描述: 示例 需要注意的细节 思路 具体实现 代码 问题 请解析IP地址和对应的掩码,进行分类识别。要求按照A/B/C/D/E类地址归类,不合法的地址和掩码单独归类。 所有的IP地址划分为 A,B,C,D,E五类 A类地址从1.0.0.0到126.255.255.255; B类地址从128.0.0.0到191.255.255.255; C类地址从192.0.0.0到223.255.255.255; D类地址从224.0.0.0到239.255.255.255; E类地址从240.0.0.0到255.255.255.255 私网IP范围是: 从10.0.0.0到10.255.255.255 从172.16.0.0到172.31.255.255 从192.168.0.0到192.168.255.255 子网掩码为二进制下前面是连续的1,然后全是0。(例如:255.255.255.32就是一个非法的掩码) (注意二进制下全是1或者全是0均为非法子网掩码) 注意: 类似于【0...】和【127...】的IP地址不属于上述输入的任意一类,也不属于不合法ip地址,计数时请忽略 私有IP地址和A,B,C,D,E类地址是不冲突的 输入描述: 多行字符串。每行一个IP地址和掩码,用~隔开。 输出描述: 统计A、B、C、D、E、错误IP地址或错误掩码、私有IP的个数,之间以空格隔开。 示例 输入: 10.70.44.68~255.254.255.0 1.0.0.1~255.0.0.0 192.168.0.2~255.255.255.0 19..0.~255.255.255.0 输出: 1 0 1 0 0 2 1 说明: 10.70.44.68~255.254.255.0的子网掩码非法,19..0.~255.255.255.0的IP地址非法,所以错误IP地址或错误掩码的计数为2; 1.0.0.1~255.0.0.0是无误的A类地址; 192.168.0.2~255.255.255.0是无误的C类地址且是私有IP; 所以最终的结果为1 0 1 0 0 2 1 示例2 输入: 0.201.56.50~255.255.111.255 127.201.56.50~255.255.111.255 输出: 0 0 0 0 0 0 0 说明: 类似于【0...】和【127...】的IP地址不属于上述输入的任意一类,也不属于不合法ip地址,计数时请忽略 需要注意的细节 类似于【0...】和【127...】的IP地址不属于上述输入的任意一类,也不属于不合法ip地址,计数时可以忽略 私有IP地址和A,B,C,D,E类地址是不冲突的,也就是说需要同时+1 如果子网掩码是非法的,则不再需要查看IP地址 全零【0.0.0.0】或者全一【255.255.255.255】的子网掩码也是非法的 思路 按行读取输入,根据字符‘~’ 将IP地址与子网掩码分开 查看子网掩码是否合法。 合法,则继续检查IP地址 非法,则相应统计项+1,继续下一行的读入 查看IP地址是否合法 合法,查看IP地址属于哪一类,是否是私有ip地址;相应统计项+1 非法,相应统计项+1 具体实现 判断IP地址是否合法,如果满足下列条件之一即为非法地址 数字段数不为4 存在空段,即【192..1.0】这种 某个段的数字大于255 判断子网掩码是否合法,如果满足下列条件之一即为非法掩码 不是一个合格的IP地址 在二进制下,不满足前面连续是1,然后全是0 在二进制下,全为0或全为1 如何判断一个掩码地址是不是满足前面连续是1,然后全是0? 将掩码地址转换为32位无符号整型,假设这个数为b。如果此时b为0,则为非法掩码 将b按位取反后+1。如果此时b为1,则b原来是二进制全1,非法掩码 如果b和b-1做按位与运算后为0,则说明是合法掩码,否则为非法掩码 代码 注意getline函数可以指定分割字符串的字符 // 引入输入输出流、字符串、字符串流和向量等头文件 #include<iostream> #include<string> #include<sstream> #include<vector> // 使用标准命名空间 using namespace std; // 定义一个函数,判断一个字符串是否是合法的IP地址 bool judge_ip(string ip){ // 定义一个整数变量,记录IP地址的段数 int j = 0; // 定义一个字符串流对象,用于分割IP地址 istringstream iss(ip); // 定义一个字符串变量,用于存储IP地址的每一段 string seg; // 使用循环,以'.'为分隔符,获取IP地址的每一段 while(getline(iss,seg,'.')) // 如果段数加一大于4,或者该段为空,或者该段的数值大于255,说明不是合法的IP地址,返回false if(++j > 4 || seg.empty() || stoi(seg) > 255) return false; // 如果循环结束后,段数等于4,说明是合法的IP地址,返回true return j == 4; } // 定义一个函数,判断一个字符串是否是私有的IP地址 bool is_private(string ip){ // 定义一个字符串流对象,用于分割IP地址 istringstream iss(ip); // 定义一个字符串变量,用于存储IP地址的每一段 string seg; // 定义一个整数向量,用于存储IP地址的每一段的数值 vector<int> v; // 使用循环,以'.'为分隔符,获取IP地址的每一段,并将其转换为整数,存入向量中 while(getline(iss,seg,'.')) v.push_back(stoi(seg)); // 如果IP地址的第一段等于10,说明是私有的IP地址,返回true if(v[0] == 10) return true; // 如果IP地址的第一段等于172,并且第二段在16到31之间,说明是私有的IP地址,返回true if(v[0] == 172 && (v[1] >= 16 && v[1] <= 31)) return true; // 如果IP地址的第一段等于192,并且第二段等于168,说明是私有的IP地址,返回true if(v[0] == 192 && v[1] == 168) return true; // 如果以上条件都不满足,说明不是私有的IP地址,返回false return false; } // 定义一个函数,判断一个字符串是否是合法的子网掩码 bool is_mask(string ip){ // 定义一个字符串流对象,用于分割IP地址 istringstream iss(ip); // 定义一个字符串变量,用于存储IP地址的每一段 string seg; // 定义一个无符号整数变量,用于存储IP地址的二进制表示 unsigned b = 0; // 使用循环,以'.'为分隔符,获取IP地址的每一段,并将其转换为整数,左移8位后与b进行按位或运算,得到IP地址的二进制表示 while(getline(iss,seg,'.')) b = (b << 8) + stoi(seg); // 如果b等于0,说明不是合法的子网掩码,返回false if(!b) return false; // 将b按位取反后加一,得到b的补码 b = ~b + 1; // 如果b等于1,说明不是合法的子网掩码,返回false if(b == 1) return false; // 如果b与b减一进行按位与运算,结果等于0,说明b只有一个1,说明是合法的子网掩码,返回true if((b & (b-1)) == 0) return true; // 如果以上条件都不满足,说明不是合法的子网掩码,返回false return false; } // 定义主函数 int main(){ // 定义一个字符串变量,用于存储输入的IP地址和子网掩码 string input; // 定义七个整数变量,用于统计A、B、C、D、E类地址、错误地址和私有地址的个数 int a = 0,b = 0,c = 0,d = 0,e = 0,err = 0,p = 0; // 使用循环,读取输入的IP地址和子网掩码,直到输入结束 while(cin >> input){ // 定义一个字符串流对象,用于分割IP地址和子网掩码 istringstream is(input); // 定义一个字符串变量,用于存储IP地址或子网掩码 string add; // 定义一个字符串向量,用于存储IP地址和子网掩码 vector<string> v; // 使用循环,以'~'为分隔符,获取IP地址和子网掩码,并存入向量中 while(getline(is,add,'~')) v.push_back(add); // 如果IP地址或子网掩码不合法,错误地址的个数加一 if(!judge_ip(v[1]) || !is_mask(v[1])) err++; else{ // 如果IP地址不合法,错误地址的个数加一 if(!judge_ip(v[0])) err++; else{ // 获取IP地址的第一段的数值 int first = stoi(v[0].substr(0,v[0].find_first_of('.'))); // 如果IP地址是私有的,私有地址的个数加一 if(is_private(v[0])) p++; // 根据IP地址的第一段的数值,判断IP地址的类别,并相应的类别的个数加一 if(first > 0 && first <127) a++; else if(first > 127 && first <192) b++; else if(first > 191 && first <224) c++; else if(first > 223 && first <240) d++; else if(first > 239 && first <256) e++; } } } // 输出A、B、C、D、E类地址、错误地址和私有地址的个数 cout << a << " " << b << " " << c << " " << d << " " << e << " " << err << " " << p << endl; // 返回0,表示程序正常结束 return 0; }
嵌入式&系统
编程&脚本笔记
软硬件算法
# 嵌入式
# 笔试面试
# C/C++
刘航宇
3年前
0
640
1
RFID编码简介
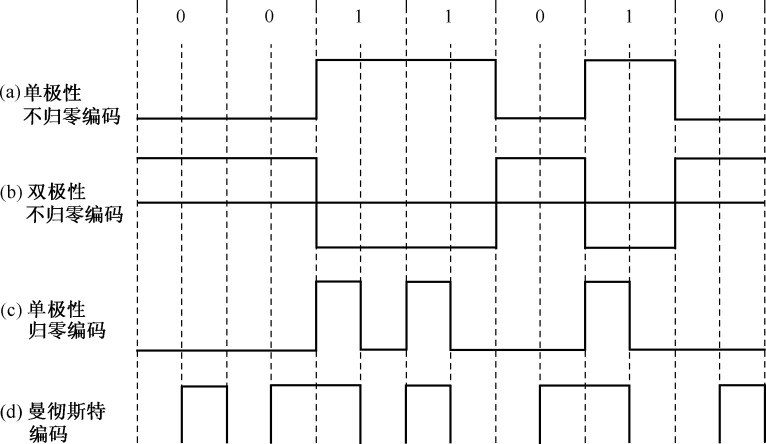
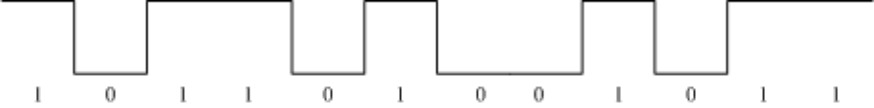
摘要本文介绍了RFID信号编码系统,包括信源编码和信道编码,并详细阐述了多种编码方法,如NRZ、Manchester、RZ、DBP、Miller等,以及选择编码方法时需考虑的因素,如能量来源、检错能力和时钟提取等。关键词:RFID编码, 信号编码系统, 编码方法, NRZ编码, 曼彻斯特编码信号编码系统包括信源编码和信道编码两大类,器作用是把要传输的信息尽可能的与传输信道相匹配,并提供对信息的某种保护以防止信息受到干扰。信源编码与信源译码的目的是提高信息传输的有效性以及完成模数转换等;信道编码与信道译码的目的是增强信号的抗干扰能力,提高传输的可靠性。 常见的编码方法如下图: 图片 RFID系统常用编码方法: 反向不归零(NRZ)编码 曼彻斯特(Manchester)编码 单极性归零(RZ)编码 差动双相(DBP)编码 密勒(Miller)编码和差动编码 图片 1、反向不归零编码(NRZ,Non Return Zero) 反向不归零编码用高电平表示二进制“1”,低电平表示二进制“0”,如下图所示: 图片 此码型不宜传输,有以下原因 有直流,一般信道难于传输零频附近的频率分量; 接收端判决门限与信号功率有关,不方便使用; 不能直接用来提取位同步信号,因为NRZ中不含有位同步信号频率成分; 要求传输线有一根接地。 注:ISO14443 TYPE B协议中电子标签和阅读器传递数据时均采用NRZ 2、曼彻斯特编码(Manchester) 曼彻斯特编码也被称为分相编码(Split-Phase Coding)。 某比特位的值是由该比特长度内半个比特周期时电平的变化(上升或下降)来表示的,在半个比特周期时的负跳变表示二进制“1”,半个比特周期时的正跳变表示二进制“0”,如下图所示: 图片 曼彻斯特编码的特点 曼彻斯特编码在采用负载波的负载调制或者反向散射调制时,通常用于从电子标签到读写器的数据传输,因为这有利于发现数据传输的错误。这是因为在比特长度内,“没有变化”的状态是不允许的。 当多个标签同时发送的数据位有不同值时,则接收的上升边和下降边互相抵消,导致在整个比特长度内是不间断的负载波信号,由于该状态不允许,所以读写器利用该错误就可以判定碰撞发生的具体位置。 曼彻斯特编码由于跳变都发生在每一个码元中间,接收端可以方便地利用它作为同步时钟。 注: ISO14443 TYPE A协议中电子标签向阅读器传递数据时采用曼彻斯特编码。 ISO18000-6 TYPE B 读写器向电子标签传递数据时采用的是曼彻斯特编码 3、单极性归零编码(Unipolar RZ) 当发码1时发出正电流,但正电流持续的时间短于一个码元的时间宽度,即发出一个窄脉冲 当发码0时,完全不发送电流 单极性归零编码可用来提取位同步信号。 pPbm28I.png图片 4、差动双相编码(DBP) 差动双相编码在半个比特周期中的任意的边沿表示二进制“0”,而没有边沿就是二进制“1”,如下图所示。此外在每个比特周期开始时,电平都要反相。因此,对于接收器来说,位节拍比较容易重建。 pPbmR2t.png图片 5、密勒编码(Miller) 密勒编码在半个比特周期内的任意边沿表示二进制“1”,而经过下一个比特周期中不变的电平表示二进制“0”。一连串的比特周期开始时产生电平交变,如下图所示,因此,对于接收器来说,位节拍也比较容易重建。 pPbmhKf.png图片 pPbm5qS.png图片 6、修正密勒码编码 7、脉冲-间歇编码 对于脉冲—间歇编码来说,在下一脉冲前的暂停持续时间t表示二进制“1”,而下一脉冲前的暂停持续时间2t则表示二进制“0”,如下图所示。 pPbnUoQ.png图片 这种编码方法在电感耦合的射频系统中用于从读写器到电子标签的数据传输,由于脉冲转换时间很短,所以就可以在数据传输过程中保证从读写器的高频场中连续给射频标签供给能量。 8、脉冲位置编码(PPM,Pulse Position Modulation) 脉冲位置编码与上述的脉冲间歇编码类似,不同的是,在脉冲位置编码中,每个数据比特的宽度是一致的。 其中,脉冲在第一个时间段表示“00”,第二个时间段表示“01”, 第三个时间段表示“10”, 第四个时间段表示“11”, 如图所示 pPbnwJs.png图片 注:ISO15693协议中,数据编码采用PPM 9、FM0编码 FM0(即Bi-Phase Space)编码的全称为双相间隔码编码、 工作原理是在一个位窗内采用电平变化来表示逻辑。如果电平从位窗的起始处翻转,则表示逻辑“1”。如果电平除了在位窗的起始处翻转,还在位窗中间翻转则表示逻辑“0”。 pPbn0Wn.png图片 注:ISO18000-6 typeA 由标签向阅读器的数据发送采用FM0编码 10、PIE编码 PIE(Pulse interval encoding)编码的全称为脉冲宽度编码,原理是通过定义脉冲下降沿之间的不同时间宽度来表示数据。 在该标准的规定中,由阅读器发往标签的数据帧由SOF(帧开始信号)、EOF(帧结束信号)、数据0和1组成。在标准中定义了一个名称为“Tari”的时间间隔,也称为基准时间间隔,该时间段为相邻两个脉冲下降沿的时间宽度,持续为25μs。 pPbnBzq.png图片 注:ISO18000-6 typeA 由阅读器向标签的数据发送采用PIE编码 ============================================= 注:选择编码方法的考虑因素 编码方式的选择要考虑电子标签能量的来源 在REID系统中使用的电子标签常常是无源的,而无源标签需要在读写器的通信过程中获得自身的能量供应。为了保证系统的正常工作,信道编码方式必须保证不能中断读写器对电子标签的能量供应。 在RFID系统中,当电子标签是无源标签时,经常要求基带编码在每两个相邻数据位元间具有跳变的特点,这种相邻数据间有跳变的码,不仅可以保证在连续出现“0”时对电子标签的能量供应,而且便于电子标签从接收到的码中提取时钟信息。 编码方式的选择要考虑电子标签的检错的能力 出于保障系统可靠工作的需要,还必须在编码中提供数据一级的校验保护,编码方式应该提供这种功能。可以根据码型的变化来判断是否发生误码或有电子标签冲突发生。 在实际的数据传输中,由于信道中干扰的存在,数据必然会在传输过程中发生错误,这时要求信道编码能够提供一定程度的检测错误的能力。 曼彻斯特编码、差动双向编码、单极性归零编码具有较强的编码检错能力。 编码方式的选择要考虑电子标签时钟的提取 在电子标签芯片中,一般不会有时钟电路,电子标签芯片一般需要在读写器发来的码流中提取时钟。 曼彻斯特编码、密勒编码、差动双向编码容易使电子标签提取时钟。
通信&信息处理
# 通信&射频
# 软件算法
刘航宇
3年前
0
2,637
0
2023-07-21
嵌入式软件-无需排序找数字
摘要文章介绍了在不允许排序的情况下,如何快速找到一组随机排列的1000个整数中,从小到大排序后第450小的数字。通过使用哈希表或频率表的方法,可以统计每个数字出现的次数,然后累加直到达到或超过450次,从而找到目标数字。关键词:嵌入式软件, 数字查找, 无需排序, 哈希表, 频率统计题目 示例 解答code1 code2 题目 有1000个整数,每个数字都在1~200之间,数字随机排布。假设不允许你使用任何排序方法将这些整数有序化,你能快速找到从0开始的第450小的数字吗?(从小到大第450位) 示例 输入 - [184, 87, 178, 116, 194, 136, 187, 93, 50, 22, 163, 28, 91, 60, 164, 127, 141, 27, 173, 137, 12, 169, 168, 30, 183, 131, 63, 124, 68, 136, 130, 3, 23, 59, 70, 168, 194, 57, 12, 43, 30, 174, 22, 120, 185, 138, 199, 125, 116, 171, 14, 127, 92, 181, 157, 74, 63, 171, 197, 82, 106, 126, 85, 128, 137, 106, 47, 130, 114, 58, 125, 96, 183, 146, 15, 168, 35, 165, 44, 151, 88, 9, 77, 179, 189, 185, 4, 52, 155, 200, 133, 61, 77, 169, 140, 13, 27, 187, 95, 140, 196, 171, 35, 179, 68, 2, 98, 103, 118, 93, 53, 157, 102, 81, 87, 42, 66, 90, 45, 20, 41, 130, 32, 118, 98, 172, 82, 76, 110, 128, 168, 57, 98, 154, 187, 166, 107, 84, 20, 25, 129, 72, 133, 30, 104, 20, 71, 169, 109, 116, 141, 150, 197, 124, 19, 46, 47, 52, 122, 156, 180, 89, 165, 29, 42, 151, 194, 101, 35, 165, 125, 115, 188, 57, 144, 92, 28, 166, 60, 137, 33, 152, 38, 29, 76, 8, 75, 122, 59, 196, 30, 38, 36, 194, 19, 29, 144, 12, 129, 130, 177, 5, 44, 164, 14, 139, 7, 41, 105, 19, 129, 89, 170, 118, 118, 197, 125, 144, 71, 184, 91, 100, 173, 126, 45, 191, 106, 140, 155, 187, 70, 83, 143, 65, 198, 108, 156, 5, 149, 12, 23, 29, 100, 144, 147, 169, 141, 23, 112, 11, 6, 2, 62, 131, 79, 106, 121, 137, 45, 27, 123, 66, 109, 17, 83, 59, 125, 38, 63, 25, 1, 37, 53, 100, 180, 151, 69, 72, 174, 132, 82, 131, 134, 95, 61, 164, 200, 182, 100, 197, 160, 174, 14, 69, 191, 96, 127, 67, 85, 141, 91, 85, 177, 143, 137, 108, 46, 157, 180, 19, 88, 13, 149, 173, 60, 10, 137, 11, 143, 188, 7, 102, 114, 173, 122, 56, 20, 200, 122, 105, 140, 12, 141, 68, 106, 29, 128, 151, 185, 59, 121, 25, 23, 70, 197, 82, 31, 85, 93, 173, 73, 51, 26, 186, 23, 100, 41, 43, 99, 114, 99, 191, 125, 191, 10, 182, 20, 137, 133, 156, 195, 5, 180, 170, 74, 177, 51, 56, 61, 143, 180, 85, 194, 6, 22, 168, 105, 14, 162, 155, 127, 60, 145, 3, 3, 107, 185, 22, 43, 69, 129, 190, 73, 109, 159, 99, 37, 9, 154, 49, 104, 134, 134, 49, 91, 155, 168, 147, 169, 130, 101, 47, 189, 198, 50, 191, 104, 34, 164, 98, 54, 93, 87, 126, 153, 197, 176, 189, 158, 130, 37, 61, 15, 122, 61, 105, 29, 28, 51, 149, 157, 103, 195, 98, 100, 44, 40, 3, 29, 4, 101, 82, 48, 139, 160, 152, 136, 135, 140, 93, 16, 128, 105, 30, 50, 165, 86, 30, 144, 136, 178, 101, 39, 172, 150, 90, 168, 189, 93, 196, 144, 145, 30, 191, 83, 141, 142, 170, 27, 33, 62, 43, 161, 118, 24, 162, 82, 110, 191, 26, 197, 168, 78, 35, 91, 27, 125, 58, 15, 169, 6, 159, 113, 187, 101, 147, 127, 195, 117, 153, 179, 130, 147, 91, 48, 171, 52, 81, 32, 194, 58, 28, 113, 87, 15, 156, 113, 91, 13, 80, 11, 170, 190, 75, 156, 42, 21, 34, 188, 89, 139, 167, 171, 85, 57, 18, 7, 61, 50, 38, 6, 60, 18, 119, 146, 184, 74, 59, 74, 38, 90, 84, 8, 79, 158, 115, 72, 130, 101, 60, 19, 39, 26, 189, 75, 34, 158, 82, 94, 159, 71, 100, 18, 40, 170, 164, 23, 195, 174, 48, 32, 63, 83, 191, 93, 192, 58, 116, 122, 158, 175, 92, 148, 152, 32, 22, 138, 141, 55, 31, 99, 126, 82, 117, 117, 3, 32, 140, 197, 5, 139, 181, 19, 22, 171, 63, 13, 180, 178, 86, 137, 105, 177, 84, 8, 160, 58, 145, 100, 112, 128, 151, 37, 161, 19, 106, 164, 50, 45, 112, 6, 135, 92, 176, 156, 15, 190, 169, 194, 119, 6, 83, 23, 183, 118, 31, 94, 175, 127, 194, 87, 54, 144, 75, 15, 114, 180, 178, 163, 176, 89, 120, 111, 133, 95, 18, 147, 36, 138, 92, 154, 144, 174, 129, 126, 92, 111, 19, 18, 37, 164, 56, 91, 59, 131, 105, 172, 62, 34, 86, 190, 74, 5, 52, 6, 51, 69, 104, 86, 7, 196, 40, 150, 121, 168, 27, 164, 78, 197, 182, 66, 161, 37, 156, 171, 119, 12, 143, 133, 197, 180, 122, 71, 185, 173, 28, 35, 41, 84, 73, 199, 31, 64, 148, 151, 31, 174, 115, 60, 123, 48, 125, 83, 36, 33, 5, 155, 44, 99, 87, 41, 79, 160, 63, 63, 84, 42, 49, 124, 125, 73, 123, 155, 136, 22, 58, 166, 148, 172, 177, 70, 19, 102, 104, 54, 134, 108, 160, 129, 7, 198, 121, 85, 109, 135, 99, 192, 177, 99, 116, 53, 172, 190, 160, 107, 11, 17, 25, 110, 140, 1, 179, 110, 54, 82, 115, 139, 190, 27, 68, 148, 24, 188, 32, 133, 123, 82, 76, 51, 180, 191, 55, 151, 132, 14, 58, 95, 182, 82, 4, 121, 34, 183, 182, 88, 16, 97, 26, 5, 123, 93, 152, 98, 33, 135, 182, 107, 16, 58, 109, 196, 200, 163, 98, 84, 177, 155, 178, 110, 188, 133, 183, 22, 67, 164, 61, 83, 12, 86, 87, 86, 131, 191, 184, 115, 77, 117, 21, 93, 126, 129, 40, 126, 91, 137, 161, 19, 44, 138, 129, 183, 22, 111, 156, 89, 26, 16, 171, 38, 54, 9, 123, 184, 151, 58, 98, 28, 127, 70, 72, 52, 150, 111, 129, 40, 199, 89, 11, 194, 178, 91, 177, 200, 153, 132, 88, 178, 100, 58, 167, 153, 18, 42, 136, 169, 99, 185, 196, 177, 6, 67, 29, 155, 129, 109, 194, 79, 198, 156, 73, 175, 46, 1, 126, 198, 84, 13, 128, 183, 22] 输出 - 94 解答 解法一:1、不能排序 2、找从0开始的第450位小的数,注意的“从0开始”这句话。[0-450]这个区间总共有451个数,因此我们需要找的是第451位小的数 开始做题---------------------------------------------------------- 可以利用hash表的特性,使用一个201大小的数组,数组的下标为数据的值,数组的值为数据出现的次数。 可以这么理解 key->代表数据,同时也是数组下标 value->代表数据出现的次数 首先给数组元素初始化为0,也就是每个数据出现的次数都是0。 接着使用循环将每个数据出现的次数添加到数组中 再利用循环将出现的次数累加,如果次数累加到450,就说明找到了第450大的数 code1 /* 1、定义一个大小为201的整型数组arr,用来存储每个数在数组numbers中出现的次数。使用memset函数将所有元素初始化为0。 2、定义一个整型变量i,用来作为循环的计数器。初始化为0。 3、使用while循环遍历数组numbers,对于每个数,将其作为arr的下标,将arr对应的元素加一,表示该数出现了一次。同时将i加一,表示下一个数。 4、重新将i赋值为1,表示从第一个数开始计算出现次数之和。 5、定义一个整型变量sum,用来累计前面的数出现的次数之和。初始化为0。 6、使用while循环遍历arr,从下标1开始,对于每个元素,将其加到sum上,然后判断sum是否大于或等于451。如果是,则跳出循环,表示找到了满足条件的数。如果不是,则继续遍历。 7、返回i,表示找到的数。 */ int find(int* numbers, int numbersLen ) { // write code here int arr[201], i=0, sum=0; //定义一个大小为201的整型数组arr,用来存储每个数在数组numbers中出现的次数。定义一个整型变量i,用来作为循环的计数器。定义一个整型变量sum,用来累计前面的数出现的次数之和。 //初始化数组元素 memset(arr,0,sizeof(arr)); //使用memset函数将所有元素初始化为0。 //循环添加每个数据出现的次数 while(i < numbersLen){ //使用while循环遍历数组numbers arr[numbers[i]]++; //对于每个数,将其作为arr的下标,将arr对应的元素加一,表示该数出现了一次。 i++; //同时将i加一,表示下一个数。 } //循环计算次数,当次数超过451次,那就是找到了 i=1; //重新将i赋值为1,表示从第一个数开始计算出现次数之和。 while((sum=sum+arr[i]) < 451){ //使用while循环遍历arr,从下标1开始 i++; //对于每个元素,将其加到sum上,并将i加一。 } return i; //返回i,表示找到的数。 } code2 解法二:因为知道每个数字的大小:1~200,所以无论序列有多少个数字,可以根据一个200行的表,然后统计所有数字出现的频率。 这个思路在硬件设计上常见,即用数字的值代表查表的地址。 /* 1、定义一个大小为201的整型数组table,用来存储每个数在数组numbers中出现的次数。初始化为0。 2、遍历数组numbers,对于每个数,将其作为table的下标,将table对应的元素加一,表示该数出现了一次。 3、定义一个整型变量acc,用来累计前面的数出现的次数之和。初始化为0。 4、遍历table,从下标1开始,对于每个元素,将其加到acc上,然后判断acc是否大于或等于451。如果是,则返回当前的下标,表示找到了满足条件的数。如果不是,则继续遍历。 5、如果遍历完table都没有找到满足条件的数,则返回0。 */ /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param numbers int整型一维数组 * @param numbersLen int numbers数组长度 * @return int整型 */ int find(int* numbers, int numbersLen ) { // write code here int table[201] = {0}; //定义一个大小为201的整型数组table,用来存储每个数在数组numbers中出现的次数。初始化为0。 for (int i = 0; i < numbersLen; i++) { table[numbers[i]]++; //遍历数组numbers,对于每个数,将其作为table的下标,将table对应的元素加一,表示该数出现了一次。 } int acc = 0; //定义一个整型变量acc,用来累计前面的数出现的次数之和。初始化为0。 for (int i = 1; i < 201; i++) { acc += table[i]; //遍历table,从下标1开始,对于每个元素,将其加到acc上。 if (acc >= 451) return i; //判断acc是否大于或等于451。如果是,则返回当前的下标,表示找到了满足条件的数。 } return 0; //如果遍历完table都没有找到满足条件的数,则返回0。 }
嵌入式&系统
编程&脚本笔记
# 嵌入式
# C/C++
刘航宇
3年前
0
449
0
2023-07-19
嵌入式软件-基于C语言小端转大端
摘要本文介绍了嵌入式系统中大端小端转换的意义,并提供了四种基于C语言的实现方法,包括使用char指针、union联合体、按位操作和宏函数,以将小端模式的整数转换为大端模式。关键词:嵌入式软件,C语言,字节序转换,大端小端,网络通信意义 题目 示例 解答1.char指针,按字节替换 2.利用union联合体共用内存空间特性,使用char数组来改变 3. 使用按位与运算保留以获取每个字节,然后按位左移到正确位置并拼接 4. 使用预定义好的宏函数 意义 大端小端转化对嵌入式系统有意义,因为不同的处理器或者通信协议可能采用不同的字节序来存储或者传输数据。字节序是指一个多字节数据在内存中的存放顺序,它有两种主要的形式: 大端:最高有效位(MSB)存放在最低的内存地址,最低有效位(LSB)存放在最高的内存地址。 小端:最低有效位(LSB)存放在最低的内存地址,最高有效位(MSB)存放在最高的内存地址。 例如,一个32位的整数0x12345678,在大端系统中,它的内存布局是: pC703EF.png图片 而在小端系统中,它的内存布局是: pC70G4J.png图片 如果一个嵌入式系统需要和不同字节序的设备或者网络进行交互,就需要进行字节序的转换,否则会导致数据错误或者通信失败。例如,TCP/IP协议族中的所有层都采用大端字节序来表示数据包头中的16位或32位的值,如IP地址、包长、校验和等。如果一个嵌入式系统使用小端字节序的处理器,并且想要建立一个TCP连接,就需要将IP地址等信息从小端转换为大端再发送出去,否则对方无法正确解析。 题目 输入一个数字n,假设它是以小端模式保存在机器的,请将其转换为大端方式保存时的值。 示例 输入:1 返回值:16777216 解答 1.char指针,按字节替换 /* * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here int tmp = 0x00000000; //开辟新的int空间用于接收转化结果 unsigned char *p = &tmp, *q = &n; p[0] = q[3]; p[1] = q[2]; p[2] = q[1]; p[3] = q[0]; return tmp; }2.利用union联合体共用内存空间特性,使用char数组来改变 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ typedef union { int i; unsigned char c[4] } inc_u; int convert(int n ) { // write code here inc_u x; //这里也可以用新开辟空间进行置换 x.i = n; //利用按位异或运算可叠加、可还原性 x.c[0] ^= x.c[3], x.c[3] ^= x.c[0], x.c[0] ^= x.c[3]; //首尾两字节对调 x.c[1] ^= x.c[2], x.c[2] ^= x.c[1], x.c[1] ^= x.c[2]; //中间两字节对调 return x.i; /* 按位<<到正确位置,并用|拼装 return (x.c[0]<<24)|(x.c[1]<<16)|(x.c[2]<<8)|x.c[3]; */ }3. 使用按位与运算保留以获取每个字节,然后按位左移到正确位置并拼接 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here return (((n & 0xff000000)>>24) | ((n & 0x00ff0000)>>8 ) | ((n & 0x0000ff00)<<8 ) | ((n & 0x000000ff)<<24); //按位与时,遇0清零,遇1保留 ); }4. 使用预定义好的宏函数 本条方法参考 https://www.codeproject.com/Articles/4804/Basic-concepts-on-Endianness 文中提到网络上常用的套接字接口(socket API)指定了一种称为网络字节顺序的标准字节顺序,这个顺序其实就是大端模式;而当时,同时代的 x86 系列主机反而是小端模式。所以就促使产生了如: ntohs() convert Network order TO Host order in Short (16 bit 大转小); ntohl() convert Network order TO Host order in Long (32 bit 大转小); htons() convert Host order TO Network order in Short (16 bit 小转大); htonl() convert Host order TO Network order in Long (32 bit 小转大). 所以我们这里使用 32 bit 小转大的 htonl() 宏函数来解决这个问题。 /** * 代码中的类名、方法名、参数名已经指定,请勿修改,直接返回方法规定的值即可 * * * @param n int整型 * @return int整型 */ int convert(int n ) { // write code here return htonl(n); ); }
嵌入式&系统
编程&脚本笔记
# 嵌入式
# C/C++
刘航宇
3年前
0
673
1
农历4月28日,我的生日,总结2022~2023年!
摘要2022-2023年,作者在生活、专业和社交方面均有成长,包括兼职经历和与朋友的互动,同时表达了对母亲的感激和对朋友的感谢。关键词:生日总结, 2022-2023, 生活感悟, 兼职经历, 社交圈子Happy birthday to me! 23岁了。 2022.06-2023.06总结 我亲爱的妈妈 我的好朋友的礼物 祝福 2022.06-2023.06总结 IMG_20230614_233652_edit_641361165565675.jpg图片 IMG_20230614_234108_edit_641284446926624.jpg图片 生活本来挺苦的? ,但这一年吃到不少糕点巧克力与饼干?看起来生活也甜甜的? ? ? 。这一年我变得更沉稳了,专业方面软件编程和硬件电路设计都有了一定的进步。这一年做了很多兼职,当过专业课老师、搞过图像处理和单片机程序设计、当过嵌入式助教也去食堂做过志愿者等等。社交方面我没有太大的变化,我的圈子小而纯粹,现有的朋友都很值得很可爱?,常联系呀!23岁,继续加油 !继续向前走(•̀ᴗ•́)و ̑̑ 我亲爱的妈妈 Screenshot_20230615_094843_com.tencent.mm_edit_69.jpg图片 Screenshot_20230615_094852_com.tencent.mm_edit_69.jpg图片 Screenshot_20230615_094859_com.tencent.mm_edit_69.jpg图片 我的好朋友的礼物 IMG_20230614_160941.jpg图片 IMG_20230614_195059.jpg图片 IMG_20230615_223215.jpg图片 祝福 这里就太多了,哈哈哈谢谢大家啦!
我的随笔
# 随笔
刘航宇
3年前
0
165
2
Microsemi Libero SOC使用示例—建立点灯工程
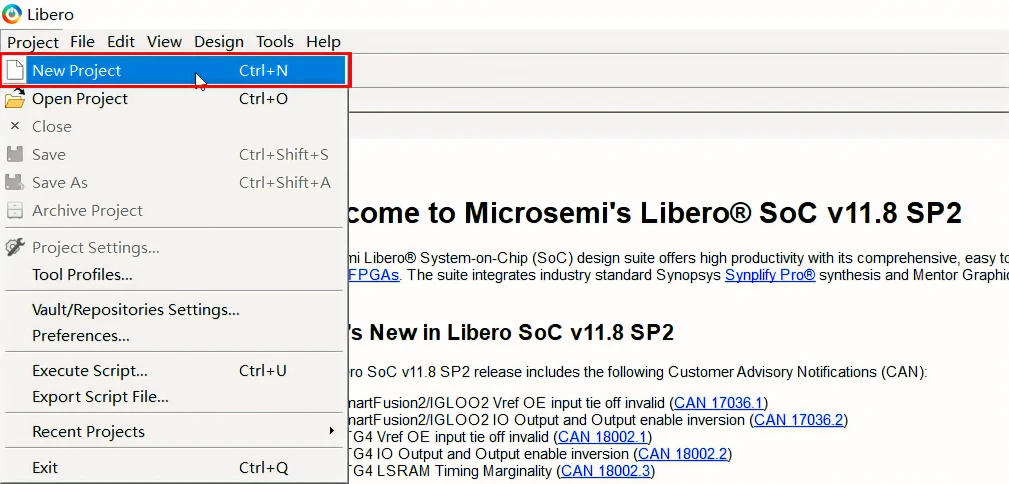
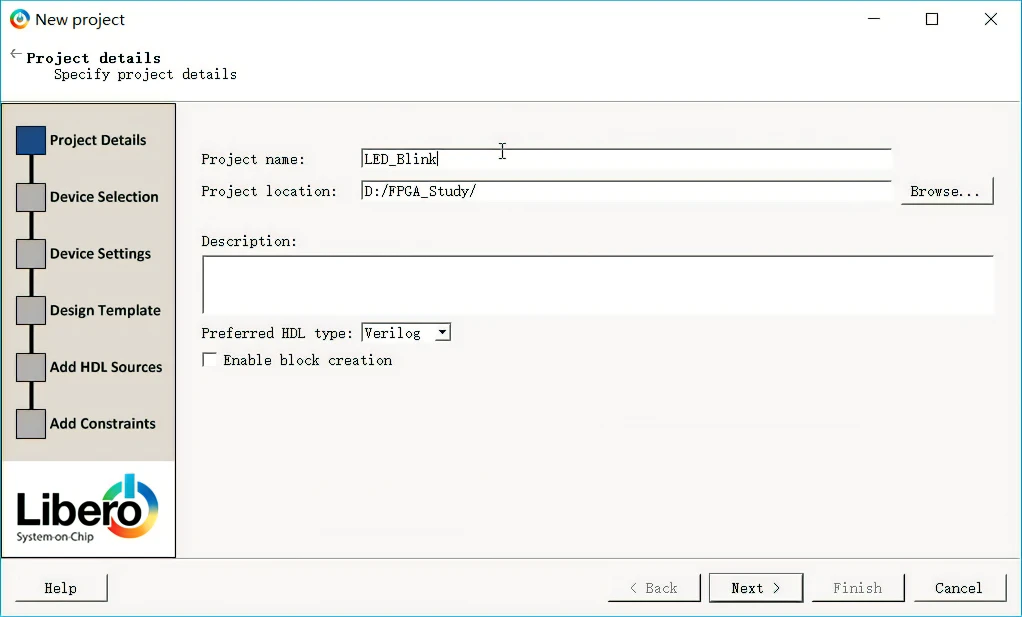
摘要本文介绍了如何使用Microsemi Libero集成开发环境建立点灯工程,通过Verilog编写点灯模块,进行仿真验证,管脚分配,最后下载程序到FPGA芯片,实现LED闪烁。关键词:Microsemi, Libero SoC, FPGA开发, 点灯实验, Verilog嵌入式开发中的Hello World,点灯是再也基础不过的实验了,通过点灯实验,可以了解芯片GPIO的控制和开发环境IDE新建工程的流程,对于FPGA来说,每个IO口几乎一样,所以本篇文章主要学习一下如何基于Microsemi Libero集成开发环境建立一个示例工程,让一个LED以500ms的频率闪烁,以Microsemi SmartFusion系列FPGA——A2F200M3F为例,Microsemi其他系列FPGA芯片过程类似。 准备工作软件准备: 硬件准备: 新建工程的主要步骤1.新建工程 2.添加设计文件 3.仿真验证 4.管脚分配 5.程序下载 Microsemi FPGA的Flash结构 准备工作 工欲利其事,必先利其器,充分的准备工作很有必要。 软件准备: Microsemi Libero SoC集成开发环境,并已经成功注册,软件版本推荐V11.8或更高版本。 硬件准备: Microsemi FPGA开发板,主控芯片A2F200M3F-PQ208,其他型号芯片类似。 Flash Pro 4或Flash Pro5下载器,用于给FPGA芯片下载程序和调试。 新建工程的主要步骤 新建工程,选择芯片型号等 新建设计,使用Verilog编写点灯模块。 仿真验证,对编写的点灯模块进行时序仿真,来验证是否满足设计需求。 综合、管脚分配、布局、布线。 生成程序文件,连接开发板,使用FlashPro下载程序到芯片内,观察现象是否和设计的一致。 1.新建工程 和大多数IDE一样,选择Project -> New Project,新建一个工程。 image.png图片 输入工程名称LED_Blink,选择工程存放的路径,工程名称和路径不要有中文字符和空格,选择源文件的类型Verilog或者VHDL。 image.png图片 选择芯片型号,这里选择Microsemi SmartFusion系列下的A2F200M3F芯片,PQ208封装,把鼠标放在所选芯片上,可以查看芯片的详细参数:封装、速度等级、温度范围,内核电压、Flash ROM大小、用户IO数目、RAM大小、Flash ROM大小,ARM Cortex-M3 SoC的外设配置等详细的参数。 图片 选择IO的电平标准,不同的电平标准,高低电平的电压范围是不同的,这里选择默认的LVTTL。 图片 是否创建MSS模块,MSS里有PLL和ARM Cortex-M3的使用,以后用到PLL和ARM核时再添加,这里先不选择,以后需要也可以再创建。 图片 是否导入已经存在的HDL文件,如果已经有一些写好的模块,可以在这里直接导入。 图片 是否导入已经存在的管脚约束文件,这里选择不添加,我们会在后面通过图形化工具来指定管脚。 图片 到这里,工程就创建完成了,然后会在存储路径下生成一个和工程名称一样的文件夹,工程相关的所以文件都存放在这里。主要包括以下几个文件夹: 图片 具体每个文件夹存放的是什么文件,我们在以后的文章再详细介绍。以上的工程配置在创建完工程之后,也可以再次更改,可以通过Project->Project Setting查看或更改配置: 图片 或者通过点击如下图标来进入配置界面: 图片 弹出如下窗口,和新建工程是一样的,可以更改FPGA的型号,但只限于同一个系列内。 2.添加设计文件 Microsemi Libero开发环境支持HDL方式和SmarDesign方式来创建设计,HDL方式支持VerilogHDL和VHDL两种硬件描述语言,而SmartDesign方式和Xilinx的Schematic原理图方式是一样的,是通过图形化的方式来对各个模块之间的连接方式进行编辑,两种方式都可以完成设计。由于本实验功能简单,所以以使用Verilog文件为例。 创建Verilog文件 创建Verilog文件有多种方式,可以直接双击左侧菜单中的Create Design->Create HDL 图片 或者点击File->New->HDL,这两种方式都可以创建一个Verilog设计文件,这里选择Verilog文件。 图片 输入模块名称:led_driver,不用添加.v后缀名,Libero软件会自动添加。 源代码: module led_driver( //input input clk, //clk=2MHz input rst_n, //0=reset //output output reg led ); parameter T_500MS = 999999; //1M reg [31:0] cnt; always @ (posedge clk) begin if(!rst_n) cnt <= 32'b0; else if(cnt >= T_500MS) cnt <= 32'b0; else //cnt < T_500MS cnt <= cnt + 32'b1; end always @ (posedge clk) begin if(!rst_n) led <= 1'b1; else if(cnt >= T_500MS) led <= ~led; end endmodule可以看到,代码非常的简单,定义一个计数器,系统时钟为2MHz=500ns,500ms=1M个时钟周期,当计数到500ms时,LED翻转闪烁。 3.仿真验证 编写完成,之后,点击对号进行语法检查,如果没有语法错误就可以进行时序仿真了。 新建Testbench文件 底部切换到Design Hierarchy选项卡,在led模块上右键选择Create Testbechch创建仿真文件,选择HDL格式。 图片 给创建的testbench文件名一般为模块名后加_tb,这里为:led_driver_tb,因为我们的板子外部晶体为2M,所以这里系统时钟周期为500ns,这个也可以在文件中更改。 图片 点击OK之后,可以看到,Libero软件已经为我们生成了一些基本代码,包括输入端口的定义,系统时钟的产生,输入信号的初始化等等。我们只需要再增加几行即可。 `timescale 1ns/100ps module led_driver_tb; parameter SYSCLK_PERIOD = 500;// 2MHZ reg SYSCLK; reg NSYSRESET; wire led; //add output reg initial begin SYSCLK = 1'b0; NSYSRESET = 1'b0; end initial begin #(SYSCLK_PERIOD * 10 ) NSYSRESET = 1'b0; //add system reset #(SYSCLK_PERIOD * 100 ) NSYSRESET = 1'b1; //add system set end always @(SYSCLK) //generate system clock #(SYSCLK_PERIOD / 2.0) SYSCLK <= !SYSCLK; led_driver led_driver_0 ( // Inputs .clk(SYSCLK), .rst_n(NSYSRESET), // Outputs .led(led ) //add port // Inouts ); endmodule仿真代码也非常简单,输入信号初始化,NSYSRESET在10个时钟周期之后拉低,100个时钟周期之后拉高。 使用ModelSim进行时序仿真 仿真代码语法检查无误后,可以进行ModelSim自动仿真,在安装Libero时,已经默认安装了ModelSim仿真软件,并和Libero进行了关联。直接双击Simulate,Libero会自动打开ModelSim。 图片 可以看到输入输出信号,已经为我们添加好了: 图片 先点击复位按钮,复位系统,然后设置要运行的时间,由于设计的是500ms闪烁一次,这里我们先运行2s,即2000ms,在ModelSim中2秒已经算是很长的时间了,然后点击时间右边的运行按钮,耐心等待,停止之后就会看到led按500ms变化一次的波形了,如下图所示,可以再添加一个cnt信号到波形观察窗口,可以看到cnt周期性的变化。 图片 使用2个光标的精确测量,可以看出,led每隔500ms翻转一次,说明程序功能是正确的。 4.管脚分配 与STM32等MCU不同,FPGA的引脚配置非常灵活,如STM32只有固定的几个引脚才能作为定时器PWM输出,而FPGA通过管脚分配可以设置任意一个IO口输出PWM,而且使用起来非常灵活,这也是FPGA和MCU的一个区别,当然其他的功能,如串口外设,SPI外设等等,都可以根据需要自己用HDL代码来实现,非常方便。 时序仿真正常之后,就可以进行管脚分配了,即把模块的输入输出端口,真正的分配到芯片实际的引脚上,毕竟我们的代码是要运行在真正的芯片上的。 打开引脚配置图形化界面 双击Create/Edit I/O Attributes,打开图形化配置界面,在打开之前,Libero会先进行综合(Synthesize)、编译(Complie),当都运行通过时,才会打开配置界面。 图片 分配管脚 管脚可视化配置工具使用起来非常简单:引脚号指定、IO的电平标准,内部上下拉等等,非常直观。把时钟、复位、LED这些管脚分配到开发板原理图中对应的引脚,在分配完成之后,可以点击左上角的commit and check进行检查。 图片 在分配完成之后,为了以后方便查看已经分配的引脚,可以导出一个pdc引脚约束文件,选择Designer窗口下的File->Export->Constraint File,会导出一个led_driver.pdc文件,保存在工程目录下的constraint文件夹。 图片 一些特殊管脚的处理 SmartFusion系列的FPGA芯片,在分配个别引脚,如35-39、43-47这些引脚时,直接不能分配,这些引脚属于MSS_FIO特殊引脚,具体怎么配置为通用IO,可以查看下一篇文章。而新一代的SmartFusion 2系列的FPGA芯片则没有这种情况。 5.程序下载 管脚分配完成之后,连接FlashPro下载器和开发板的JTAG接口,关闭Designer窗口,选择Program Device,耐心等待几分钟,如果连接正常,会在右侧输出编程信息:擦除、验证、编程等操作,下载完成之后,就会看到板子上的LED闪烁起来了。 Microsemi FPGA的Flash结构 和Altera、Xilinx不同,Microsemi FPGA在下载程序时,并不是下载程序到SPI Flash,而是直接下载到FPGA内部的。目前,FPGA 市场占有率最高的两大公司Xilinx和Altera 生产的 FPGA 都是基于 SRAM 工艺的,需要在使用时外接一个片外存储器以保存程序。上电时,FPGA 将外部存储器中的数据读入片内 RAM,完成配置后,进入工作状态;掉电后 FPGA 恢复为白片,内部逻辑消失。这样 FPGA 不仅能反复使用,还无需专门的 FPGA编程器,只需通用的 EPROM、PROM 编程器即可。而Microsemi的SmartFusion、SmartFusion2、ProASICS3、ProASIC3E系列基于Flash结构,具备反复擦写和掉电后内容非易失性, 因此基于Flash结构的FPGA同时具备了SRAM结构的灵活性和反熔丝结构的可靠性,这种技术是最近几年发展起来的新型FPGA实现工艺,目前实现的成本还偏高,没有得到大规模的应用。 示例工程下载 基于Libero V11.8.2.4的工程下载: LED_Blink.rar 下载地址:https://wcc-blog.oss-cn-beijing.aliyuncs.com/Libero/Libero-2/LED_Blink.rar 提取码:
嵌入式&系统
FPGA&ASIC
IP&SOC设计
# ASIC/FPGA
# 嵌入式
# SOC设计
刘航宇
3年前
0
2,033
2
2023-04-17
MIMO波束赋形技术简介
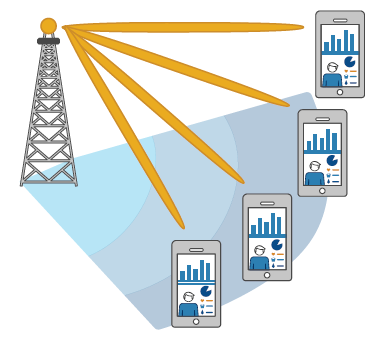
摘要MIMO波束赋形技术通过调整信号加权,使天线波束指向特定方向,分为模拟和数字波束赋形。阵列天线包括线阵和面阵,混合波束赋形结合两者优点,适用于大规模MIMO系统。关键词:MIMO, 波束赋形技术, 阵列天线, 数字波束赋形, 模拟波束赋形目录 前言 波束赋形分类 阵列天线 混合波束赋形 总结 参考文献: 前言 在MIMO系统中,波束赋形技术通过调整每个天线阵元上的信号进行加权求和,使天线波束指向某个特定的方向,即将天线能量集中指向某个特定的用户。 d6fb0a3cc8e32c0af0b75df51c853948.png图片 波束赋形分类 根据波束赋形发生位置的不同,波束赋形技术分为模拟波束赋形(AnalogBeamforming, ABF)技术和数字波束赋形(Digital Beamforming, DBF)技术。 4a28f76d72a4df8e47e74e783c80ae1f.png图片 在数字基带之前即时域范围内形成波束,称作数字波束赋形; 在模拟基带之前即频域范围内形成波束,称作模拟波束赋形。 数字波束赋形结构中,每根天线对应的一条射频(RF)链路,产生波束时多条RF链路共同参与,因此可以实现多个数据流共同传输。数字波束赋形使用复杂的硬件结构,可以灵活的调整相位和幅度,产生准确的波束。对于天线数量众多时,导致整个结构的硬件实现非常复杂,成本很高。 模拟波束赋形技术使用成本比较低的模拟移相器,只能调整相位而不能调整幅度,产生波束不一定准确。模拟波束赋形,具有简单的硬件结构,实现成本低,没有多条RF链路,只能传输单数据流 阵列天线 阵列天线实现功能是对多列电磁波进行叠加,不同天线位置会产生不同的电磁波辐射,因此,波束赋形技术与天线位置和摆放有密切关系。 阵列天线包括线阵天线和面阵天线两种 afef214955805f1abe5b1b4a20eee39f.png图片 线阵天线是指所有天线阵元分布在一条直线上,或者所有天线阵元分布在一个圆周上,阵元与阵元的间隔可以是等距的或不等距的; 面阵天线是指所有天线阵元以某个点为中心分布在一个矩形面上,或者所有天线阵元分布在一个圆面上,同样,阵元与阵元的间隔可以是等距的或不等距的。 对于F大线数量较多的情况,天线阵列可能会扩展到三维空间,也是未米人线架构设计的一个方向。 混合波束赋形 数字波束赋形可以产生精确的波束,但是每根天线映射一条RF链路,从硬件实现和成本考虑,该技术适用于天线数量较少的系统。 对于天线数量较多的系统,可以使用实现成本较低的模拟波束赋形,可能导致波束不准确,增益效果不是很好。 7970fc6d2b411b56dab8bc2ab3ff71e9.png图片 因此,对于大规模MIMO系统,结合两者优点,提出了一种混合波束赋形技术,希望在满足硬件条件下,使其增益尽可能达到全数字波束赋形的效果。 在较小的面积内拥有大量天线单元使实现高波束成形增益变得切实可行。具有高度方向性的波束有助于抵消较高工作频率下增加的路径损耗,因为波束将功率控制在特定方向上。 2e760e3d1161bacec0599f6b4fe0d4d9.png图片 总结 Simulink和Matlab联合仿真,能够设计并且仿真单个天线,天线阵列,MIMO波束成型系统。对于雷达、5G等方向,有着重要意义。当然,工具不仅仅只有这一个,ADS也能设计从射频波束混合系统,到天线阵列的仿真。 参考文献: [1]使用Matlab进行5G开发
通信&信息处理
# 通信&射频
刘航宇
3年前
0
1,690
3
【电路基础】ASIC角度练习JK触发器&RS触发器
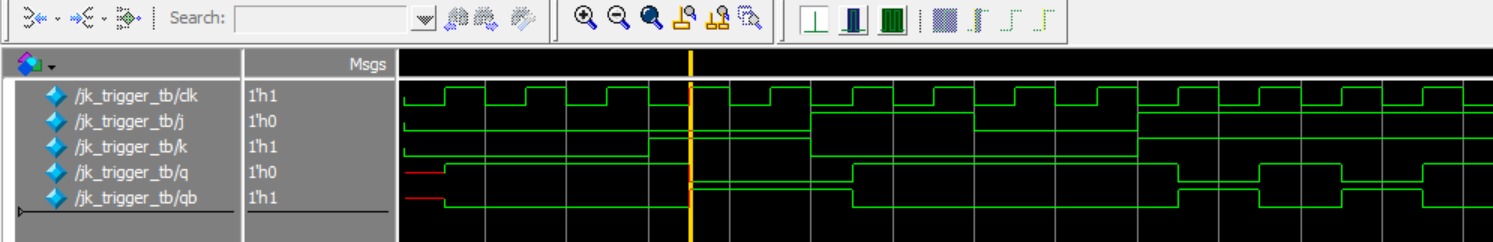
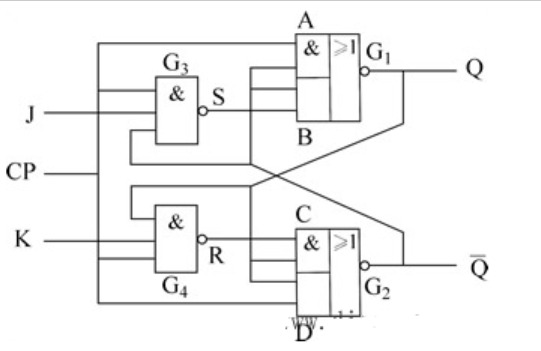
摘要本文介绍了JK触发器和RS触发器的原理、硬件描述语言实现、时序图、电路图以及性能分析。通过Verilog语言实现了JK和RS触发器,并进行了仿真测试,验证了其功能正确性。关键词:ASIC, JK触发器, RS触发器, 硬件描述语言, Verilog由于本电路极其简单,原理不做解释 目录 JK触发器真值表 硬件描述语言 JK触发器时序 JK触发器电路图 JK触发器性能--SMIC180nm工艺 RS触发器真值表 RS硬件描述语言 RS触发器时序 RS触发器电路图 RS触发器性能--SMIC180nm工艺 JK触发器 真值表 图片 硬件描述语言 代码 //边沿JK触发器-时序逻辑 //作者:刘航宇 2023/4/15 //Email:hyliu@ee.ac.cn module jk_trigger(clk,j,k,q,qb); input clk,j,k; output q,qb; reg q; wire qb; always @(posedge clk) begin case ({j,k}) 2'b00: q<=1; //jk=00,保持 2'b01: q<=1'b0; //jk=01,则触发器置0 2'b10: q<=1'b1; //jk=10,则触发器置1 2'b11: q<=~q; //11,翻转 //组合逻辑中,为避免生成锁存器,好的代码风格是if语句都加上else,case语句都加上default。 //时序逻辑中,“若无必要,尽量不加else和default”——以减小数据翻转机会,低功耗。 //故此处不写default endcase end assign qb = ~q; endmodule测试文件 //jk触发器测试文件 `timescale 1ns/1ps module jk_trigger_tb; reg j,k,clk;//输入reg是因为要initial wire q,qb; always begin #5 clk = ~clk; end //初始化 //下面这个产生fsdb是Synopsys VCS&Makefile脚本会用到,如果你用Medelsim仿真请删掉这个initial语句以免报错 initial begin $fsdbDumpfile("tb.fsdb");//这个是产生名为tb.fsdb的文件 $fsdbDumpvars; end initial begin clk = 0; j = 1'b0; k = 1'b0;//保持 #30 begin j=1'b0;k=1'b1; end //置0 #20 begin j=1'b1;k=1'b0; end //置1 #20 begin j=1'b0;k=1'b0; end //保持 #20 begin j=1'b1;k=1'b1; end //翻转 #200 $finish; end jk_trigger u1(.j(j),.k(k),.clk(clk),.q(q),.qb(qb)); endmoduleJK触发器时序 上升沿触发,可以看到时序完全正确 图片 JK触发器电路图 图片 之所以这样综合电路综合出一个D触发器,是考虑标准单元库的面积与时序的折中,标准单元相当于基本晶体管搭建而成,比如反相器占用2个晶体管,与非门占用4个晶体管,具体不在赘叙。 图片 图片 JK触发器性能--SMIC180nm工艺 图片 RS触发器 真值表 图片 RS硬件描述语言 代码 //边沿JK触发器-时序逻辑 //作者:刘航宇 2023/4/15 //Email:hyliu@ee.ac.cn module rs_trigger( input wire clk,r,s, output reg q, output wire qb ); always @(posedge clk) begin case ({r,s}) 2'b00: q<=q; //r,s同时为低电平,触发器保持状态不变 2'b01: q<=1'b1; //触发器置1 2'b10: q<=1'b0; //触发器置0 2'b11: q<=1'bx; //不定态 endcase end assign qb = ~q; endmodule测试代码 `timescale 1ns/1ps module rs_trigger_tb(); reg clk,r,s; wire q,qb; always begin #5 clk = ~clk; end //初始化 initial begin clk = 0; r = 1'b0; s = 1'b0;//保持 #30 r=1'b0;s=1'b1; //置1 #20 r=1'b1;s=1'b0; //置0 #20 r=1'b0;s=1'b0; //保持 #20 r=1'b1;s=1'b1; //禁止 #200 $stop; end rs_trigger u2(.clk(clk),.r(r),.s(s),.q(q),.qb(qb)); endmoduleRS触发器时序 上升沿触发,可以看到时序完全正确 图片 RS触发器电路图 image.png图片 image.png图片 image.png图片 RS触发器性能--SMIC180nm工艺 image.png图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
3年前
0
1,552
2
【硬件算法进阶】Verilog实现802.3 CRC-32校验运算电路
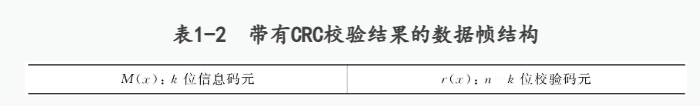
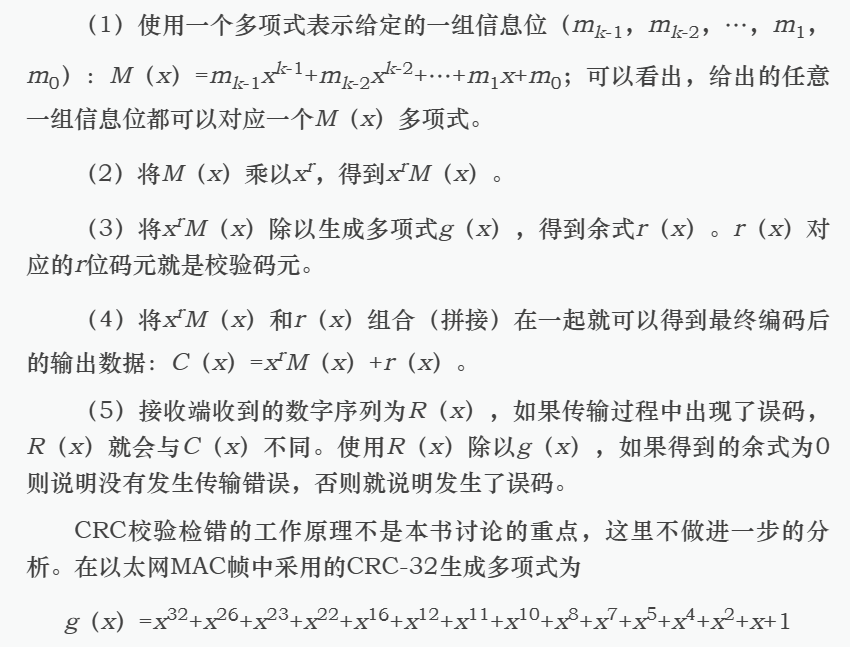
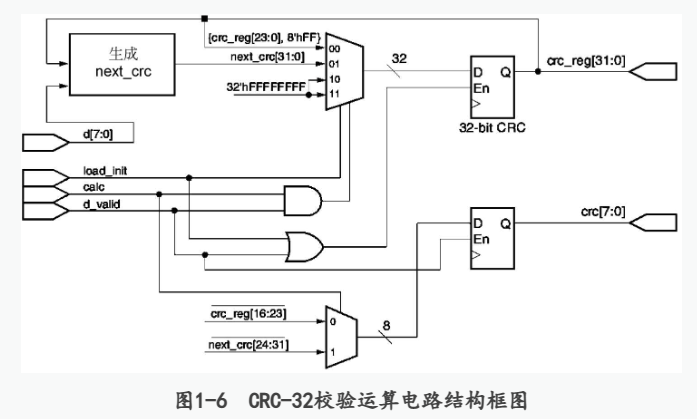
摘要本文介绍了使用Verilog实现802.3 CRC-32校验运算电路的设计,包括CRC校验原理、电路结构、Verilog代码实现以及测试方法。关键词:CRC-32校验, Verilog, 硬件算法, 循环冗余校验, 802.3循环冗余校验(Cyclic Redundancy Check,CRC)是通信中常用的差错检测编码方式,其基本工作原理是根据输入的信息位(信息码元),按照给定的生成多项式产生校验位(校验码元),并一起传送到接收端。在接收端,接收电路按照相同的规则对接收数据进行计算并生成本地的校验位,然后与收到的校验位进行对比,如果二者不同,则说明传输过程中发生了错误,否则说明传输是正确的。带有CRC校验结果的数据帧结构如表1-2所示。 image.png图片 CRC检验位生成与检测工作包括以下基本步骤。 image.png图片 图1-6是一个并行CRC-32校验运算电路。图中的d[7:0]是输入的用户数据,它是按照字节的方式输入的。load_ini是在对一个新的数据包开始校验计算之前对电路进行初始化的控制信号,经过初始化后,电路内部32比特寄存器的值改变为全1。calc是电路运算指示信号,在整个数据帧输入和CRC校验结果输出的过程中其都应该保持有效(高电平有效)。d_valid为1时表示当前输入的是需要进行校验运算的有效数据。crc[7:0]是电路输出的CRC校验运算结果,它是按照字节方式,在有效数据输入完成后开始输出的,一共有4个有效字节。crc_reg[31:0]是内部寄存器的值,具体使用时不需要该输出。 image.png图片 并行计算的思想,输入数据S要并行输入到G(x)系数为1的支路中,输入数据从输入端按高到低逐bit输入,就可以实现。 假如被除数是2位的数据S[1:0]=01,多项式是10011,x4 +x+1。在CRC校验里面,习惯省略最高位的1,多项式用0011表示。那么S除以0011的模二运算数字电路结构为: image.png图片 其中d1~ d4是寄存器输入;q1~q4是寄存器输出。寄存器需要赋初值,一般赋全1或全0。 d1=S[1]^q4; d2= S[1]^ q1^q4; d3=q2; d4=q3。 经过一次移位后: q1=d1= S[1]^q4; q2= d2= S[1]^ q1^q4; q3= d3=q2; q4= d4=q3。 此时有: d1=S[0]^q3; d2= S[0]^ S[1]^ q4^q3; d3= S[1]^ q1^q4; d4= q2。 令c[3:0]={q4,q3,q2,q1},d[3:0]={d4,d3,d2,d1},那么d就是最终的运算结果表达式,如下 d[3]=c[1]; d[2]= S[1]^ c[0]^c[3]; d[1]= S[0]^ S[1]^ c[3]^ c[2]; d[0]= S[0]^ c[2]。 令c的初值为0,则01对0011的模二除法的余数为0011。 再比如多项式为x5 +x3 +x+1,简记式为01011,其数字电路结构为: image.png图片 输入数据S要全部输入完,寄存器得到的结果才是最后的结果。同理可推导出其他多项式和输入数据的情况。 对于循环检验,这里举个例子,如果数据是10bit*100个包,则每次输入10bit得到校验码后,该检验码为下次数据计算时寄存器D的初值,如此反复计算得到最后的检验码添加到整个数据后面即可,而不需要每个数据包后面都添加检验码。 下面是以太网循环冗余校验电路的设计代码: module crc32_8023( clk, reset, d, load_init, calc, d_valid, crc_reg, crc ); input clk; input reset; input [7:0] d; input load_init; input calc; input d_valid; output reg [31:0] crc_reg; output reg [7:0] crc; wire [2:0] ctl; wire [31:0] next_crc; wire [31:0] i; assign i = crc_reg; assign ctl = {load_init,calc,d_valid}; always @(posedge clk or posedge reset) begin if(reset) crc_reg <= 32'hffffffff; else begin case (ctl) //{load_init,calc,d_vaild} 3'b000,3'b010: begin crc_reg <= crc_reg; crc <= crc;end 3'b001: begin crc_reg <= {crc_reg[23:0],8'hff}; crc <= ~{crc_reg[16],crc_reg[17],crc_reg[18],crc_reg[19],crc_reg[20],crc_reg[21],crc_reg[22],crc_reg[23]}; //crc <= ~ crc_reg[16:23]; end 3'b011: begin crc_reg <= next_crc[31:0]; crc <= ~{next_crc[24],next_crc[25],next_crc[26],next_crc[27],next_crc[28],next_crc[29],next_crc[30],next_crc[31]}; //crc <= ~ next_crc[24:31]; end 3'b100,3'b110: begin crc_reg <= 32'hffffffff; crc <= crc; end 3'b101: begin crc_reg <= 32'hffffffff; crc <= ~{crc_reg[16],crc_reg[17],crc_reg[18],crc_reg[19],crc_reg[20],crc_reg[21],crc_reg[22],crc_reg[23]}; //crc <= ~ crc_reg[16:23]; end 3'b111: begin crc_reg <= 32'hffffffff; crc <= ~{next_crc[24],next_crc[25],next_crc[26],next_crc[27],next_crc[28],next_crc[29],next_crc[30],next_crc[31]}; //crc <= ~ next_crc[24:31]; end endcase end end assign next_crc[0] = d[7]^i[24]^d[1]^i[30]; //d+i=31 assign next_crc[1] = d[6]^d[0]^d[7]^d[1]^i[24]^i[25]^i[30]^i[31]; assign next_crc[2] = d[5]^d[6]^d[0]^d[7]^d[1]^i[24]^i[25]^i[26]^i[30]^i[31]; assign next_crc[3] = d[4]^d[5]^d[6]^d[0]^i[25]^i[26]^i[27]^i[31]; assign next_crc[4] = d[3]^d[4]^d[5]^d[7]^d[1]^i[24]^i[26]^i[27]^i[28]^i[30]; assign next_crc[5] = d[0]^d[1]^d[2]^d[3]^d[4]^d[6]^d[7]^i[24]^i[25]^i[27]^i[28]^i[29]^i[30]^i[31]; assign next_crc[6] = d[0]^d[1]^d[2]^d[3]^d[5]^d[6]^i[25]^i[26]^i[28]^i[29]^i[30]^i[31]; assign next_crc[7] = d[0]^d[2]^d[4]^d[5]^d[7]^i[24]^i[26]^i[27]^i[29]^i[31]; assign next_crc[8] = d[3]^d[4]^d[6]^d[7]^i[24]^i[25]^i[27]^i[28]^i[0]; //每项多出i[i],i=0、1、2...23 assign next_crc[9] = d[2]^d[3]^d[5]^d[6]^i[1]^i[25]^i[26]^i[28]^i[29]; assign next_crc[10] =d[2]^d[4]^d[5]^d[7]^i[2]^i[24]^i[26]^ i[27]^i[29]; assign next_crc[11] =i[3]^d[3]^i[28]^d[4]^i[27]^d[6]^i[25]^d[7]^i[24]; assign next_crc[12] =d[1]^d[2]^d[3]^d[5]^d[6]^d[7]^i[4]^i[24]^i[25]^i[26]^i[28]^i[29]^i[30]; assign next_crc[13] =d[0]^d[1]^d[2]^d[4]^d[5]^d[6]^i[5]^i[25]^i[26]^i[27]^i[29]^i[30]^i[31]; assign next_crc[14] =d[0]^d[1]^d[3]^d[4]^d[5]^i[6]^i[26]^i[27]^i[28]^i[30]^i[31]; assign next_crc[15] =d[0]^d[2]^d[3]^d[4]^i[7]^i[27]^i[28]^i[29]^i[31]; assign next_crc[16] =d[2]^d[3]^d[7]^i[8]^i[24]^i[28]^i[29]; assign next_crc[17] =d[1]^d[2]^d[6]^i[9]^i[25]^i[29]^i[30]; assign next_crc[18] =d[0]^d[1]^d[5]^i[10]^i[26]^i[30]^i[31]; assign next_crc[19] =d[0]^d[4]^i[11]^i[27]^i[31]; assign next_crc[20] =d[3]^i[12]^i[28]; assign next_crc[21] =d[2]^i[13]^i[29]; assign next_crc[22] =d[7]^i[14]^i[24]; assign next_crc[23] =d[1]^d[6]^d[7]^i[15]^i[24]^i[25]^i[30]; assign next_crc[24] =d[0]^d[5]^d[6]^i[16]^i[25]^i[26]^i[31]; assign next_crc[25] =d[4]^d[5]^i[17]^i[26]^i[27]; assign next_crc[26] =d[1]^d[3]^d[4]^d[7]^i[18]^i[28]^i[27]^i[24]^i[30]; assign next_crc[27] =d[0]^d[2]^d[3]^d[6]^i[19]^i[29]^i[28]^i[25]^i[31]; assign next_crc[28] =d[1]^d[2]^d[5]^i[20]^i[30]^i[29]^i[26]; assign next_crc[29] =d[0]^d[1]^d[4]^i[21]^i[31]^i[30]^i[27]; assign next_crc[30] =d[0]^d[3]^i[22]^i[31]^i[28]; assign next_crc[31] =d[2]^i[23]^i[29]; endmodule测试代码 `timescale 1ns/1ns module crc_test(); reg clk, reset; reg [7:0] d; reg load_init; reg calc; reg data_valid; wire [31:0] crc_reg; wire [7:0] crc; initial begin clk=0; reset=0; load_init=0; calc=0; data_valid=0; d=0; end always begin #10 clk=1; #10 clk=0; end always begin crc_reset; crc_cal; end task crc_reset; begin reset=1; repeat(2)@(posedge clk); #5; reset=0; repeat(2)@(posedge clk); end endtask task crc_cal; begin repeat(5) @ (posedge clk); //通过losd_init=1 对CRC计算电路进行初始化 #5; load_init= 1; repeat(1)@ (posedge clk); //设置1oad_init=0,data_valid= 1,calc=1 //开始对输人数据进行CRC校验运算 #5; load_init= 0; data_valid=1; calc=1; d=8'haa; repeat(1)@ (posedge clk); #5; data_valid=1; calc=1; d=8'hbb; repeat(1)@ (posedge clk); #5; data_valid=1; calc=1; d=8'hcc; repeat(1)@ (posedge clk); #5; data_valid=1; calc=1; d=8'hdd; repeat(1)@ (posedge clk); //设置load_init=0,data_valid=1,calc=0 //停止对数据进行CRC校验运算,开始输出 //计算结果 #5; data_valid=1; calc=0; d=8'haa; repeat(1)@ (posedge clk); #5; data_valid=1; calc=0; d=8'hbb; repeat(1)@ (posedge clk); #5; data_valid=1; calc=0; d=8'hee; repeat(1)@ (posedge clk); #5; data_valid=1; calc=0; d=8'hdd; repeat(1)@ (posedge clk); #5; data_valid=0; repeat(10)@ (posedge clk); end endtask crc32_8023 my_crc_test(.clk(clk),.reset(reset),.d(d),.load_init(load_init),.calc(calc),.d_valid(data_valid),.crc_reg(crc_reg),.crc(crc)); endmodule图1-7是电路的仿真结果。图中①是电路进行CRC校验计算之前对电路进行初始化操作的过程,经过初始化之后,crc_reg内部数值为全1。②是对输入数据aa-> bb-> cc-> dd进行运算操作的过程,此时calc和data_valid均为1。③是输出计算结果的过程,CRC校验运算结果a7、01、b4和55先后被输出。 图片 图片 在接收方向上,可以采用相同的电路进行校验检查,判断是否在传输过程中发生了差错。具体工作时,可以边接收用户数据边进行校验运算,当一个完整的MAC帧接收完成后(此时接收数据帧中的校验结果也参加了校验运算),如果当前校验电路的crc_reg值为0xC704DD7B(对于以太网中使用的CRC-32校验,无论原始数据是什么,正确接收时校验和都是此固定数值),说明没有发生错误,否则说明MAC帧有错。 CRC-32校验值的作用是用于检测数据传输或存储中的错误。发送数据时,会根据数据内容生成简短的校验和,并将其与数据一起发送。接收数据时,将再次生成校验和并将其与发送的校验和进行比较。如果两者相等,则没有数据损坏。如果两者不相等,则说明数据在传输或存储过程中发生了改变,可能是由于噪声、干扰、故障或恶意篡改等原因造成的。 CRC-32校验值可以有效地检测出数据中的随机错误,但是不能保证检测出所有的错误。例如,如果数据中有偶数个比特发生了翻转,那么CRC-32校验值可能不会改变,从而无法发现错误。因此,CRC-32校验值只能作为一种辅助的错误检测手段,不能完全依赖它来保证数据的正确性和完整性。 相关工具 如果不理解推导过程的话,可以由相关工具帮忙计算出结果和得到Verilog代码: CRC校验Verilog代码生成链接:http://outputlogic.com/?page_id=321 CRC校验计算工具链接:http://www.ip33.com/crc.html,这个工具只能计算16bit为一个数据包的数据,如果数据包为10bit等之类的就不太适用 在线计算器使用举例 报文 : 1011001 (0x59) 生成多项式 : g(x) = x^4 + x^3 + 1 CRC : 1010 ( 0xa) CRC计算结果截图: image.png图片 参考文献 Verilog HDL算法与电路设计-乔庐峰
FPGA&ASIC
软硬件算法
# ASIC/FPGA
# 硬件算法
刘航宇
3年前
0
2,374
5
上一页
1
2
3
...
7
下一页