🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,232 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,764 阅读
3
【高数】形心计算公式讲解大全
9,123 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,174 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,900 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
242(共16篇)
找到
16
篇与
242
相关的结果
在FPGA上部署轻量BP神经网络-Python与Verilog:信号检测实战
摘要本文介绍了在FPGA上部署轻量BP神经网络进行信号检测的实战,包括系统架构、神经网络模型设计、FPGA硬件实现详解以及关键优化技巧,实验结果表明该方案功耗低、性能好。关键词:FPGA, BP神经网络, 信号检测, 低功耗, 实时处理目录 储备知识: 一、背景:为什么要在FPGA上跑神经网络? 二、系统整体架构 三、神经网络模型设计:极致轻量 四、FPGA硬件实现详解4.1 串并转换模块(Serial-to-Parallel 4.2 数据归一化模块 4.3 隐藏层神经元模块(核心计算单元) 4.4 ReLU激活函数模块 4.5 输出层神经元模块 4.6 阈值判断模块 五、关键优化技巧5.1 归一化的"逆向"处理 5.2 权值二值化(BWN)降低功耗 5.3 亚稳态消除 六、实验结果:功耗与性能 七、总结与思考 python和verilog源程序下载 储备知识: 我们在前文讲了BP神经网络算法和激活函数 BP神经网络算法 https://ee.ac.cn/index.php/archives/612.html 激活函数讲解 https://ee.ac.cn/index.php/archives/617.html 一、背景:为什么要在FPGA上跑神经网络? 在无源物联网(Battery-free IoT)和反向散射通信(Backscatter)场景中,传统的信号检测方法(如能量检测)虽然电路简单,但无法区分同频段的多种信号,且受噪声影响大;而基于PC或GPU的深度学习方案虽然精度高,但功耗动辄数十瓦,显然无法部署在依赖能量采集的微瓦级标签上。 核心矛盾在于:缺乏一种检测精度高、功耗极低(毫瓦级)、且能实时处理的解决方案。 答案是将轻量级的BP神经网络部署到低功耗FPGA上,在边缘端完成信号推理。 二、系统整体架构 整个检测系统的链路如下: graph LR subgraph 射频前端 A[目标信号] --> B[天线] B --> C[阻抗匹配] C --> D[LNA放大] end subgraph 信号处理 D --> E["包络检波(ENV)"] E --> F["ADC采样<br>1MSPS, 12bit"] end subgraph 智能决策 F --> G["FPGA<br>BP神经网络推理"] G --> H[调制控制信号] end在FPGA内部,BP神经网络负责识别当前输入的512点采样数据是否为目标信号的前导码(Preamble)。一旦识别成功,输出控制信号,开启后端的Backscatter调制模块。 FPGA选型:Actel IGLOO/e系列 AGLE600V5-FG484。选择它的原因是: Flash架构:上电即运行,无需外部配置芯片,适合无源系统; 超低功耗:静态功耗仅0.046mW,适合能量采集场景; 资源适中:13824个逻辑单元,足以容纳轻量级网络。 三、神经网络模型设计:极致轻量 为了在FPGA上高效部署,网络结构必须足够"轻"。本文设计的网络结构如下: pasted_1785558315326_lc6zyp.png图片 层级神经元数说明输入层512对应ADC采集的一条信号的512个采样点隐藏层2仅2个神经元,大幅降低计算量输出层1二分类:是目标信号(1) / 非目标信号(0)激活函数:隐藏层和输出层均采用 ReLU。 $$f(x) = \max(0, x)$$ 选择ReLU的原因不仅是训练效果好,更重要的是硬件实现极其简单——只需一个比较器判断正负,无需计算指数或乘法,这对FPGA非常友好。 pasted_1785561816152_bsny25.png图片 训练环境:TensorFlow/Keras,使用Adam优化器和MSE损失函数。在真实环境数据集上训练后,测试集识别准确率可达 95.76%。 pasted_1785561967835_yy5zgm.png图片 四、FPGA硬件实现详解 FPGA内部的神经网络是一个纯推理引擎。本节按数据流方向,逐个拆解每个模块的设计思路和Verilog实现要点。 pasted_1785562098406_gf64mu.png图片 整体RTL结构如下: pasted_1785563631508_f74j4w.png图片 4.1 串并转换模块(Serial-to-Parallel pasted_1785563649652_chqrj8.png图片 ADC(ADS7042)在片选信号CS拉低后,先输出2个前导0,再输出12位有效数据(D11→D0),每个数据位占用一个CLK周期。 设计要点: CS和CLK由FPGA内部产生,CS每16个CLK周期拉低一次; 在CS下降沿开始,用计数器对串行数据移位寄存; 凑齐12位有效数据后,输出一组并行数据 adc_data[11:0]。 波形图 pmhbofe.png图片 module serial_p(input data0_in,input cs,input clk,output[12:0] data0_out,input rst); reg[11:0] temp; reg[12:0] save; integer count; integer cnt; always @(negedge clk or negedge rst) begin if(!rst) begin//reset temp<=12'b000000000000; count<=-1; save<=12'b111111111111; cnt<=-1; end else if(cs&&count%16==0) begin save<={1'b0,temp}; count<=1; cnt<=cnt+1; if(cnt==512) begin cnt<=1; end end else if(cs) begin temp<=12'b0; count<=1; end else if(count<3) count<=count+1; else begin temp<={temp,data0_in}; count<=count+1; end end assign data0_out=save; endmodule 4.2 数据归一化模块 问题:训练时,输入数据被归一化到 [0, 1.8](对应ADC参考电压1.8V)。如果在FPGA中直接用除法做 Vin = adc_data / 4095 * 1.8,会消耗大量逻辑资源(FPGA做除法器代价极高)。 解决方案:在软件端完成归一化,FPGA端只做整数运算。 具体做法: 在Python/Keras训练时,将输入数据 x 归一化为 x_norm = x / 4095 * 1.8; 在提取权值时,将第一层权值 w 除以 1.8 并放大 1024 倍取整; 这样FPGA输入的原始ADC值 adc_data(范围0~4095)直接与预处理后的权值相乘,等效于完成了归一化+加权。 # 创建一个自定义的回调对象 cb = MyCallback() # 以只读方式打开训练数据文件 with open('/content/work/data/data.txt') as traindata: # 读取文件内容 data = traindata.read() # 将文件内容转换为numpy数组,并将数据类型转换为float,并将数组形状调整为(47100, 2) data = np.array(list(data.split()), dtype=float).reshape((47100, 2)) # 创建一个最大最小归一化对象 min_max_scaler = preprocessing.MinMaxScaler() # 归一化 data = data * (1/65535) # 以只读方式打开训练标签文件 with open('/content/work/data/label.txt') as labda: # 读取文件内容 labels = labda.read() # 将文件内容转换为numpy数组,并将数据类型转换为float,并将数组形状调整为(47100, 2) labels = np.array(list(labels.split()), dtype=float).reshape((47100, 2)) # 对data和labels进行乱序,保持它们的对应关系 # 为了保持对应关系,需要先将data和labels沿着第二个维度拼接起来,形成一个(100, 4)的数组 # 然后对这个数组进行乱序,再将它们沿着第二个维度分开,还原成data和labels data_labels = np.concatenate((data, labels), axis=1) np.random.shuffle(data_labels) data = data_labels[:, :2] labels = data_labels[:, 2:]FPGA端实现: 实际上,归一化模块在FPGA中被合并到了权值预处理阶段,硬件上不需要额外的归一化电路。但为了模块化清晰,也可以显式设计一个"电压映射"模块,将12bit ADC码值转换为定点数格式: 工程建议:永远不要在FPGA里做除法。所有线性变换(归一化、缩放)都应在软件端合并到权值中,FPGA只做整数乘加。 4.3 隐藏层神经元模块(核心计算单元) 隐藏层的数学表达式: $$y = \text{ReLU}\left( \sum_{i=1}^{512} x_i \cdot w_i + b \right)$$ , i = 1..512 工程难点: 512次乘累加如果在一个时钟周期完成,需要512个乘法器,资源爆炸; 如果纯串行完成,需要512个时钟周期,一条chirp要512×512=262144个周期,太慢。 解决方案:采用 串行MAC流水线 + 双缓冲FIFO 架构。 设计思路: 权值存储:512个权值和1个偏置在编译时以 reg [31:0] w[0:511] 形式固化在FPGA中; FIFO缓存:ADC每输出一个采样点,立即写入FIFO。FIFO深度设为16即可(只要保证不溢出),因为读出速度(MAC运算)和写入速度(ADC采样)基本匹配; 串行MAC:每个时钟周期从FIFO读出一个数据 xi,与对应的 wi 相乘,累加到累加器 acc; 512个周期后:累加器结果加上偏置 b,送入ReLU模块。 pasted_1785563798085_32317i.png图片 FIFO波形图 pmhqDBt.png图片 关键设计细节: 位宽设计:输入22bit × 权值32bit = 乘法结果54bit,累加512次需要额外9bit,因此累加器至少需要 63bit。如果位宽不够,累加会溢出,导致结果完全错误。 时序约束:乘法器和加法器要满足16MHz时钟的建立保持时间。如果组合逻辑延迟太大,需要插入流水线寄存器(将乘法器和加法器分两级完成)。 双神经元并行:隐藏层有2个神经元,需要例化两个上述模块,各自独立的权值存储和累加器,但共享同一个FIFO输入。 4.4 ReLU激活函数模块 ReLU的硬件实现是整个网络中最简单的部分: pmhqWcj.png图片 module relu ( input wire clk, input wire rst_n, input wire [31:0] x_in, // MAC+bias结果 input wire x_valid, output reg [31:0] y_out, output reg y_valid ); always @(posedge clk or negedge rst_n) begin if (!rst_n) begin y_out <= 32'd0; y_valid <= 1'b0; end else begin y_valid <= x_valid; if ($signed(x_in) >= 0) y_out <= x_in; else y_out <= 32'd0; end end endmodule4.5 输出层神经元模块 输出层只有1个神经元,输入是隐藏层2个神经元的输出: $$\text{output} = \text{ReLU}\left( h_1 \cdot w'_1 + h_2 \cdot w'_2 + b' \right)$$ 这个模块与隐藏层类似,但逻辑资源消耗极小。 pmhq7NT.png图片 module nerual_out( clk, rst,x1,x2,data_out ); input clk, rst; input signed[0:49] x1,x2; output signed[79:0] data_out; //<statements> //reg signed[0:28] weight[0:1]; reg signed[0:7] save,save1,save2; localparam bais=-50'd214979034352654; //localparam bais = -26'd6406874; localparam weight0 = 29'd22506522; localparam weight1 =-29'd341584992; //integer bais; integer count; always @(negedge clk or negedge rst) begin if(!rst) //reset,set values and bias begin // bais<=-50'd214979034352654; // weight[0]<=29'd22506522; // weight[1]<=-29'd341584992; save<=0; save1<=0; save2<=0; count<=0; end else begin save1<=x1*weight0; save2<=x2*weight1; count<=count+1; if(count>518) save<=save1+save2+bais;//Multiply the input by the weights and add up the results end end assign data_out=save; endmodule4.6 阈值判断模块 为什么需要阈值判断? 前面提到,我们在保存权值时将所有参数扩大了 1024 倍(即 $2^{10}$)。这意味着: 隐藏层的输出值也被放大了约1024倍; 输出层的计算结果同样被放大; 原本训练时,输出层ReLU后大于0即判定为目标信号; 现在由于数值被放大,不能简单以0为界,需要设定一个等效的阈值。 阈值推导: 原始判定边界:输出 > 0.5(二分类常用阈值); 放大后等效边界:threshold = 0.5 × 1024 × 1024 = 524288; 实际上,由于隐藏层和输出层都放大了1024倍,总放大倍数为 $1024^2 = 1048576$,因此: threshold = 0.5 × 1048576 = 524288。 波形图 pmhqXv9.png图片 五、关键优化技巧 5.1 归一化的"逆向"处理 再次强调这个最重要的优化: 处理方式FPGA资源消耗推荐度FPGA内做除法(adc/4095)极高,需除法器IP❌FPGA内用移位近似除法中等,精度损失大△权值预处理(本文方法)零额外消耗✅具体做法: 训练时归一化:$V_{\text{in}} = \frac{\text{adc_data}}{4095} \times 1.8$; 提取权值时:$w' = \frac{w}{1.8} \times 1024$,取整; FPGA输入:直接使用原始ADC值 $x$(0~4095); 等效运算。 5.2 权值二值化(BWN)降低功耗 为了进一步压缩模型、降低功耗,本文采用了 Binary-Weight-Networks (BWN) 对权值进行二值化: 权值只取 +1 或 -1; 引入缩放因子 α 保证量化后的权值尽可能接近原始浮点权值。 二值化后,乘法运算退化为加减法或符号位判断,FPGA资源占用和动态功耗大幅下降。虽然精度略有损失,但在本场景中仍能保持97%以上的识别率。 二值化乘法器的Verilog实现: // 二值化权值乘法:只需判断符号 wire signed [31:0] product; assign product = bin_weight ? x_in : -x_in; // bin_weight=1为正,0为负相比32bit×32bit的硬件乘法器,这个逻辑几乎不消耗DSP资源。 5.3 亚稳态消除 ADC数据输入和CS信号是异步信号(相对于16MHz系统时钟),必须做双级触发器同步,防止亚稳态传播: reg adc_dat_d1, adc_dat_d2; always @(posedge clk) begin adc_dat_d1 <= adc_dat; // 第一级 adc_dat_d2 <= adc_dat_d1; // 第二级(稳定后使用) end wire adc_dat_sync = adc_dat_d2;六、实验结果:功耗与性能 通过 Actel Libero SOC 对FPGA各模块进行功耗仿真,结果如下: 工作模式静态功耗动态功耗总功耗空闲态0.046 mW00.046 mW正常工作0.046 mW2.79 mW2.835 mWFlash*Freeze模式0.115 mW00.115 mW2.835 mW 的总功耗,对于低功耗设备来说是完全可以接受的。 各子模块动态功耗分解: 串并转换:0.01 mW 隐藏层神经元(含FIFO):0.083 mW ReLU激活:0.067 mW 输出层神经元:0.067 mW 七、总结与思考 本文介绍了一套完整的从算法到硬件的轻量化神经网络部署方案: 算法层:针对低功耗约束,设计了512-2-1极简BP网络,避免使用CNN/RNN等重算力模型; 数据层:在真实环境中采集目标信号,建立含噪样本库,并通过数据增强提升泛化能力; 硬件层:基于Actel低功耗FPGA,用FIFO流水、整数运算、ReLU硬判决、权值二值化等手段,实现了毫瓦级推理; 系统层:与射频前端(LNA、包络检波、ADC)紧密配合,形成完整的标签信号检测链路。 可扩展性:该FPGA神经网络框架不仅可用于目标信号检测,只需更换训练数据集和权值参数,即可用于FMCW、RFID等其他射频信号的识别,具备良好的通用性。 python和verilog源程序下载
FPGA&ASIC
通信&信息处理
机器学习
软硬件算法
# 信号处理
# ASIC/FPGA
# 机器学习
# 软件算法
# 物联网
# Python
刘航宇
8月1日
0
104
8
2023-11-01
机器学习/深度学习-10个激活函数详解
摘要本文详细介绍了深度学习中常见的十种激活函数,包括Sigmoid、Tanh、ReLU、Leaky ReLU、ELU、PReLU、Softmax、Swish、Maxout和Softplus,并分析了它们的优缺点。关键词:机器学习, 深度学习, 激活函数, Sigmoid, ReLU图片 综述 1. Sigmoid 激活函数 2. Tanh / 双曲正切激活函数 3. ReLU 激活函数 4. Leaky ReLU 5. ELU 6. PReLU(Parametric ReLU) 7. Softmax 8. Swish 9. Maxout 10. Softplus 综述 激活函数(Activation Function)是一种添加到人工神经网络中的函数,旨在帮助网络学习数据中的复杂模式。类似于人类大脑中基于神经元的模型,激活函数最终决定了要发射给下一个神经元的内容。 在人工神经网络中,一个节点的激活函数定义了该节点在给定的输入或输入集合下的输出。标准的计算机芯片电路可以看作是根据输入得到开(1)或关(0)输出的数字电路激活函数。因此,激活函数是确定神经网络输出的数学方程式,本文概述了深度学习中常见的十种激活函数及其优缺点。 首先我们来了解一下人工神经元的工作原理,大致如下: 图片 上述过程的数学可视化过程如下图所示: 图片 1. Sigmoid 激活函数 lofj8ajx.png图片 Sigmoid 函数的图像看起来像一个 S 形曲线。 函数表达式如下: $$\[\mathrm{f(z)=1/(1+e^{\wedge}-z)}\]$$ 在什么情况下适合使用 Sigmoid 激活函数呢? Sigmoid 函数的输出范围是 0 到 1。由于输出值限定在 0 到 1,因此它对每个神经元的输出进行了归一化; 用于将预测概率作为输出的模型。由于概率的取值范围是 0 到 1,因此 Sigmoid 函数非常合适; 梯度平滑,避免「跳跃」的输出值; 函数是可微的。这意味着可以找到任意两个点的 sigmoid 曲线的斜率; 明确的预测,即非常接近 1 或 0。 Sigmoid 激活函数有哪些缺点? 倾向于梯度消失; 函数输出不是以 0 为中心的,这会降低权重更新的效率; Sigmoid 函数执行指数运算,计算机运行得较慢。 2. Tanh / 双曲正切激活函数 图片 tanh 激活函数的图像也是 S 形,表达式如下: $$f(x)=tanh(x)=\frac{2}{1+e^{-2x}}-1$$ tanh 是一个双曲正切函数。tanh 函数和 sigmoid 函数的曲线相对相似。但是它比 sigmoid 函数更有一些优势。 图片 首先,当输入较大或较小时,输出几乎是平滑的并且梯度较小,这不利于权重更新。二者的区别在于输出间隔,tanh 的输出间隔为 1,并且整个函数以 0 为中心,比 sigmoid 函数更好; 在 tanh 图中,负输入将被强映射为负,而零输入被映射为接近零。 注意:在一般的二元分类问题中,tanh 函数用于隐藏层,而 sigmoid 函数用于输出层,但这并不是固定的,需要根据特定问题进行调整。 3. ReLU 激活函数 图片 ReLU 激活函数图像如上图所示,函数表达式如下: 图片 ReLU 函数是深度学习中较为流行的一种激活函数,相比于 sigmoid 函数和 tanh 函数,它具有如下优点: 当输入为正时,不存在梯度饱和问题。 计算速度快得多。ReLU 函数中只存在线性关系,因此它的计算速度比 sigmoid 和 tanh 更快 当然,它也有缺点: Dead ReLU 问题。当输入为负时,ReLU 完全失效,在正向传播过程中,这不是问题。有些区域很敏感,有些则不敏感。但是在反向传播过程中,如果输入负数,则梯度将完全为零,sigmoid 函数和 tanh 函数也具有相同的问题; 我们发现 ReLU 函数的输出为 0 或正数,这意味着 ReLU 函数不是以 0 为中心的函数。 4. Leaky ReLU 它是一种专门设计用于解决 Dead ReLU 问题的激活函数: 图片 ReLU vs Leaky ReLU 为什么 Leaky ReLU 比 ReLU 更好? $$f(y_i)=\begin{cases}y_i,&\text{if }y_i>0\\a_iy_i,&\text{if }y_i\leq0\end{cases}.$$ 1、Leaky ReLU 通过把 x 的非常小的线性分量给予负输入(0.01x)来调整负值的零梯度(zero gradients)问题; 2、leak 有助于扩大 ReLU 函数的范围,通常 a 的值为 0.01 左右; 3、Leaky ReLU 的函数范围是(负无穷到正无穷)。 注意:从理论上讲,Leaky ReLU 具有 ReLU 的所有优点,而且 Dead ReLU 不会有任何问题,但在实际操作中,尚未完全证明 Leaky ReLU 总是比 ReLU 更好。 5. ELU 图片 ELU vs Leaky ReLU vs ReLU ELU 的提出也解决了 ReLU 的问题。与 ReLU 相比,ELU 有负值,这会使激活的平均值接近零。均值激活接近于零可以使学习更快,因为它们使梯度更接近自然梯度。 图片 显然,ELU 具有 ReLU 的所有优点,并且: 没有 Dead ReLU 问题,输出的平均值接近 0,以 0 为中心; ELU 通过减少偏置偏移的影响,使正常梯度更接近于单位自然梯度,从而使均值向零加速学习; ELU 在较小的输入下会饱和至负值,从而减少前向传播的变异和信息。 一个小问题是它的计算强度更高。与 Leaky ReLU 类似,尽管理论上比 ReLU 要好,但目前在实践中没有充分的证据表明 ELU 总是比 ReLU 好。 6. PReLU(Parametric ReLU) 图片 PReLU 也是 ReLU 的改进版本: $$f(y_i)=\begin{cases}y_i,&\text{if }y_i>0\\a_iy_i,&\text{if }y_i\leq0\end{cases}.$$ 看一下 PReLU 的公式:参数α通常为 0 到 1 之间的数字,并且通常相对较小。 如果 a_i= 0,则 f 变为 ReLU 如果 a_i> 0,则 f 变为 leaky ReLU 如果 a_i 是可学习的参数,则 f 变为 PReLU PReLU 的优点如下: 在负值域,PReLU 的斜率较小,这也可以避免 Dead ReLU 问题。 与 ELU 相比,PReLU 在负值域是线性运算。尽管斜率很小,但不会趋于 0。 7. Softmax 图片 Softmax 是用于多类分类问题的激活函数,在多类分类问题中,超过两个类标签则需要类成员关系。对于长度为 K 的任意实向量,Softmax 可以将其压缩为长度为 K,值在(0,1)范围内,并且向量中元素的总和为 1 的实向量。 图片 Softmax 与正常的 max 函数不同:max 函数仅输出最大值,但 Softmax 确保较小的值具有较小的概率,并且不会直接丢弃。我们可以认为它是 argmax 函数的概率版本或「soft」版本。 Softmax 函数的分母结合了原始输出值的所有因子,这意味着 Softmax 函数获得的各种概率彼此相关。 Softmax 激活函数的主要缺点是: 在零点不可微; 负输入的梯度为零,这意味着对于该区域的激活,权重不会在反向传播期间更新,因此会产生永不激活的死亡神经元。 8. Swish 图片 函数表达式:y = x * sigmoid (x) Swish 的设计受到了 LSTM 和高速网络中 gating 的 sigmoid 函数使用的启发。我们使用相同的 gating 值来简化 gating 机制,这称为 self-gating。 self-gating 的优点在于它只需要简单的标量输入,而普通的 gating 则需要多个标量输入。这使得诸如 Swish 之类的 self-gated 激活函数能够轻松替换以单个标量为输入的激活函数(例如 ReLU),而无需更改隐藏容量或参数数量。 Swish 激活函数的主要优点如下: 「无界性」有助于防止慢速训练期间,梯度逐渐接近 0 并导致饱和;(同时,有界性也是有优势的,因为有界激活函数可以具有很强的正则化,并且较大的负输入问题也能解决); 导数恒 > 0; 平滑度在优化和泛化中起了重要作用。 9. Maxout 图片 在 Maxout 层,激活函数是输入的最大值,因此只有 2 个 maxout 节点的多层感知机就可以拟合任意的凸函数。 单个 Maxout 节点可以解释为对一个实值函数进行分段线性近似 (PWL) ,其中函数图上任意两点之间的线段位于图(凸函数)的上方。 $ReLU=\max\bigl(0,x\bigr),\mathrm{abs}\bigl(x\bigr)=\max\bigl(x,-x\bigr)$ Maxout 也可以对 d 维向量(V)实现: 图片 假设两个凸函数 h_1(x) 和 h_2(x),由两个 Maxout 节点近似化,函数 g(x) 是连续的 PWL 函数。 $$g\bigl(x\bigr)=h_1\bigl(x\bigr)-h_2\bigl(x\bigr)$$ 因此,由两个 Maxout 节点组成的 Maxout 层可以很好地近似任何连续函数。 图片 10. Softplus 图片 Softplus 函数:f(x)= ln(1 + exp x) Softplus 的导数为 f ′(x)=exp(x) / ( 1+exp x ) = 1/ (1 +exp(−x )) ,也称为 logistic / sigmoid 函数。 Softplus 函数类似于 ReLU 函数,但是相对较平滑,像 ReLU 一样是单侧抑制。它的接受范围很广:(0, + inf)。
机器学习
# 机器学习
# 软件算法
# DL/ML
刘航宇
3年前
0
711
0
数字锁相环(DPLL)研究与设计-面向FPGA/数字IC
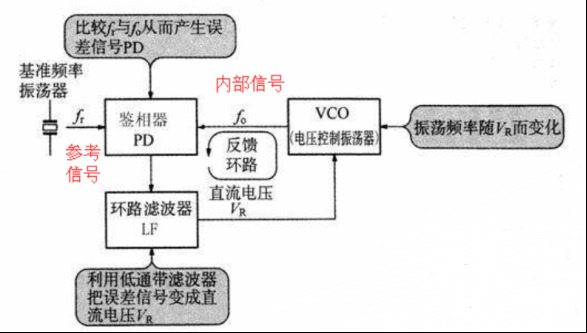
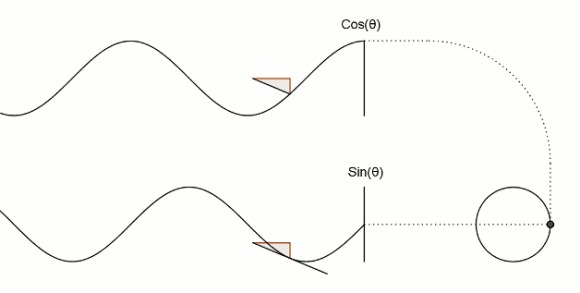
摘要本文介绍了数字锁相环(DPLL)的研究与设计,包括其原理、组成、实现方法以及性能评估。文章详细阐述了数字锁相环在数字电路中的应用,并重点介绍了数字鉴相器、数字振荡器和数字缓冲器的设计与实现。关键词:数字锁相环, DPLL, FPGA, 数字IC, 频率合成前言 锁相环的原理和组成 数字锁相环的原理和组成 数字鉴相器设计DPD 数字振荡器(DCO) 数字缓冲器(DB) 数字锁相环(DPLL)的实现 电路硬件与性能评估 工程代码下载 前言 随着数字电路技术的发展,数字锁相环在调制解调、频率合成、FM 立体声解码、彩色副载波同步、图象处理等各个方面得到了广泛的应用。数字锁相环不仅吸收了数字电路可靠性高、体积小、价格低等优点,还解决了模拟锁相环的直流零点漂移、器件饱和及易受电源和环境温度变化等缺点,此外还具有对离散样值的实时处理能力,已成为锁相技术发展的方向。 所谓数字PLL,就是指应用于数字系统的PLL,也就是说数字PLL中的各个模块都是以数字器件来实现的,是一个数字的电路。 数字锁相环的优点是电路最简单有效,可采用没有压控的晶振,降低了成本,提高了晶振的稳定性。但缺点是和模拟锁相环一样,一旦失去基准频率,输出频率立刻跳回振荡器本身的频率;另外还有一个缺点,就是当进行频率调整的时候,输出频率会产生抖动,频差越大,抖动会越大于密,不利于某些场合的应用。随着大规模、超高速的数字集成电路的发展,为数字锁相环路的研究与应用提供了广阔空间。由于晶体振荡器和数字调整技术的加盟,可以在不降低振荡器的频率稳定度的情况下,加大频率的跟踪范围,从而提高整个环路工作的稳定性与可靠性。 简单的说有两个不同来源的信号:一个信号是参考信号,这个信号一般是由芯片的晶振得到的信号,它具有信号的稳定性较好等优点,但是其频率是固定不变的。另一个信号是由芯片或者模块内部的压控振荡器得到的。这种由压控振荡器得到的信号可以是某范围内的任意频率的信号,但是这种信号的稳定型较差,容易受到外界干扰。 那么在实际使用过程中,我们需要一种频率能够变化的,同时质量较好的信号;或者对于一块芯片,我们需要不同的模块的内部时钟(这种时钟可以是压控振荡器产生)都能参考一个总的时钟来进行同步,从而避免两个模块内部时钟的差异而产生的数据传输的漂移等问题。因此,如何将压控振荡器得到的信号能够具有晶振信号的信号质量呢? 那就是通过PLL锁相环来实现,如图1所示。只要压控振荡器产生的时钟(下称输入信号)是参考信号的整数倍(或者整除倍),那么就能将输入信号先进行分频,后得到与参考信号频率相同的时钟,将分频后的信号和参考信号进行比较,从而使分频后的信号和参考信号保持相同的稳定的频率和相位。被分频后的信号稳定,也就是间接的表示输入信号的稳定。从而我们得到了一个频率在一定范围内可变的稳定的信号。 有上述可以看出,锁相环具有以下功能: (1)能够将一个信号和另一参考信号同步; (2)当这个信号是输出信号分频后得到的信号,PLL就能够得到参考信号的倍频信号(实际上倍频器很多都是利用了这个功能); (3)当输入信号频率可变、分频系数可变时,PLL就能够得到在频率一定范围内稳定信号。 图片 锁相环的原理和组成 锁相环(PLL)的作用我们已经大概了解了,其最主要功能的实现,是在于如何将两个频率不同、相位差始终在变化的信号,变成两个相同频率、相同相位的信号。 这里引入一个概念,首先我们都知道,对于三角函数,只有两个同频率的三角函数才能比较其相位差。但这里的相位差是指两个正弦函数的初始相位差。而实际上根据三角函数的欧拉定义的理解来看,我们可以把三角函数看做是在某个圆上逆时针运动的点到x轴的距离。那么频率就是点在圆上运动的角速度,频率越大,其运动的角速度越大。相位就是点在圆上的位置,而初始相位就是点在圆上开始运动时的位置。当两个点的运动角速度相同时,我们可以得到两个点的初始位置差,就是两个正弦函数频率相同时,得到初始相位差。这个差值在运动过程中一直是不变的。但是当两个点运动角速度不同时,我们去看它的初始位置差是没有意义的,因为两个点的位置差是一直在变的,而初始位置差只是一个开始的位置差,是个不变的量,所以说对于频率不同的三角函数,我们讨论起初始相位差是没有意义的。但是不代表不能比较某一时刻两个点的位置。也就是相位差,相位是存在的。 图片 现在我们假设两个点在圆上赛跑,如图3所示,我们想让这两个点角速度相等。那么有一个办法就是以一个点为参考,参考点角速度不变,另一个点是速度可变点。每过一段时间,观察另一个点到参考点的位置,是在前,还是在后。如果在前,就让另一个点速度慢一点;如果在后,就让另一个点速度快一点。就这样不断调整另一个点的角速度,直到每次观察两个点都处于相同的位置。这样我们就可以认为这两个点达到了相同的速度。这种方法就是利用反馈调节来实现两个信号的同频同相。也就是锁相环(PLL)的实现原理。 首先通过一个鉴相器来得到两个信号之间的相位差。并根据相位差输出电压信号。然后通过滤波器稳压后得到稳定的电压信号,该信号驱动压控振荡器得到新的频率的信号。当两个信号存在相位差时,电压信号就会改变,从而使受控信号不断变化。直到当两个信号没有相位差时,电压信号不再改变,从而使受控信号保持当前频率,这时,受控信号不再变化了,就叫做受控信号被锁定了。 由上所述,一个锁相环由鉴相器、滤波器、振荡器三部分组成。外部输入是参考信号,内部输入和总的输出是受控信号。 数字锁相环的原理和组成 在数字电路中,原来模拟信号正弦波、余弦波的频率和相位变成了0和1的脉冲信号,那么我们如何理解数字信号中的频率和相位呢?对于脉冲信号来说,我们可以把频率理解为在某固定时间内脉冲出现的个数,为了方便表示,我们把上升沿的出现视为脉冲的出现,把相邻两个脉冲出现的时间t求倒数,就得到了该信号在这个时刻处的信号频率。而对于相位,相位差就是指,存在两个脉冲信号,以一个脉冲信号为参考,在其出现脉冲后,到另一个信号出现脉冲之间的时间差就是相位差,当另一个信号脉冲晚于参考信号脉冲出现的时间,称之为另一个信号的相位滞后于参考信号。当另一个信号的脉冲出现在参考信号之前,称之为另一个信号的相位提前于参考信号。 上述是一种较为简单的描述方式,适合初识脉冲信号的读者理解。而实际上,对于脉冲信号的频率、相位等问题,严格来说这样理解有一点点问题,但是对于我们来搭建数字锁相环DPLL来说足够了。其实这种三角函数和信号之间的转化,其根本的原理来源于傅里叶变换,从而我们对一个时间域上的信号(例如脉冲信号)可以进行频率域(其代表的三角函数的合成)上的分析。 我们知道了在数字电路中,脉冲信号也有了频率和相位的属性。那么我们的参考信号是以来时钟源的固定频率的信号,因为信号的质量比较好,所以该信号两个脉冲之间的时间差均是相同的,误差很小。我们在参考信号出现上升沿时,观察受控信号此时的状态。如果受控信号为高电平,我们就认为此时受控信号超前于参考信号;反之,如果受控信号是低电平,则认为此时的受控信号滞后于参考信号。当出现超前状态时,鉴相器会输出一个超前信号,超前信号会作用于振荡器,使得振荡器发出的受控信号频率降低。而滞后信号会使振荡器发出的受控信号频率升高,从而实现受控信号频率的反馈调节。 如图4所示,当参考信号出现上升沿时,受控信号为低电平,此时输出一个滞后信号。(由于模块只在时钟为上升沿时触发,所以超前信号的触发延迟了半个时钟周期) 图片 由此我们能够大概了解了数字锁相环中如何看待脉冲信号的频率和相位,如何处理得到相位差以及相位差如何在锁相环中起作用来实现信号频率的反馈控制。同模拟的锁相环(PLL)类似,数字锁相环(DPLL)也是由:数字鉴相器(Digital Phase Detector)、数字缓冲器(Digital Buffer)、数字振荡器(Digital Controlled Oscillator)三个模块构成,其外部输入为参考信号,内部输入和输出为受控信号。下面我们就来具体讨论如何用verilog实现各个模块。 数字鉴相器设计DPD 实现一个数字锁相环(DPLL),最重要的部分就是实现数字鉴相器(DPD)和数字振荡器(DF)。并且,这两个模块并不是独立存在的,而是说,数字振荡器的实现方式和数字振荡器的实现方式相互影响。所以只有两个模块共同设计,才能较好的实现一个数字锁相环的功能。 首先我们来具体讨论一下一个数字鉴相器应该具有那些功能和特性: 顾名思义,数字鉴相器就是能够鉴别两个数字信号相位的差别,并通过信号将这种差别表示出来。由上文我们已经知道了,对于两个矩形方波信号,其相位差可以看做是两个信号先后出现上升沿(或下降沿)之间的时间差。为了方便表示,假设以其中一个信号作为参考信号,另一个信号为受控信号,当参考信号出现上升沿(或下降沿)时,观察另一个信号是否已经出现了上升沿(或下降沿)。 如果还未出现上升沿(或下降沿),则叫做“受控信号滞后于参考信号”,或者简称“滞后”;如果已经出现了上升沿(或下降沿),则叫做“受控信号提前于参考信号”,或者简称“提前”。 而判断上升沿(或下降沿)是否已经出现,方法就是看当参考信号出现上升沿时,受控信号是1还是0:当受控信号为0,表示上升沿还没出现,所以是“滞后”;当受控信号为1,表示上升沿已经出现,所以是“提前”。对于下降沿也是按照同样的方法考虑。 图片 目前为止,我们已经有两个输入,参考信号和受控信号;两个输出,滞后信号和提前信号。如何通过verilog实现上述的输入输出关系呢?首先先讲异或与门,通过图4的描述,我们可以很容易看出来:滞后信号是参考信号与受控信号先异或,异或的结果和受控信号相与得到;提前信号是参考信号与受控信号先异或,异或的结果和参考信号相与得到。再加上一个RST的复位信号,我们可以得到如下图5电路: 图片 根据这个关系,来调节受控信号的频率,从而使受控信号的频率和参考信号最终相同。 再考虑,如果按照上述方法调节,当受控信号和参考信号频率相差很大时,就会出现刚开始有一段时间,受控信号的频率是不断变化,不可预知的。这样的调节效果实时性并不好,需要时间来稳定。因此读者想到,如果能够在参考信号出现上升沿时,就让受控信号也出现上升沿,相当于两个人在赛跑时,当一个人从起点出发时,无论另一个人在哪,强制让另一个人也回到原点,两个人一起从原点出发。这样就能使受控信号和参考信号强制达到相同的频率,只是此时受控信号的占空比不是50%。然后再根据滞后和提前信号,调节受控信号的占空比,从而最终达到50%的占空比。 按照这种方法,鉴相器就需要一个信号输出来表示上升沿的出现。再考虑到电路中的总的时钟源,我们这里采用触发的方法来实现。同时将上述的异或与门加入到代码中可以得到数字鉴相器的代码。但是在实际运用过程中发现,可能存在着受控信号先出现上升沿,从而过早的出现了提前或者滞后信号,导致数字振荡器的计数器上限呈现一个周期变化的不可控的数值的情况。为了避免这种情况,需要仔细考虑参考信号和受控信号如何生成提前和滞后信号这个问题,而不是简单的用异或来实现。如图6表示这种关系。 图片 按照上述代码写出来的数字鉴相器,具有更好的性能。根据这个表格,通过类似状态机的方法,来实现提前信号和滞后信号的输出。 此外异或门配合D触发器方式也可以实现鉴相器效果仍可应用于本设计中。示例代码如下: module DPD_2 ( input reference_signal, // 参考时钟输入(来自外部晶振或基准源) input controlled_signal, // 反馈时钟输入(来自VCO分频后的时钟) input rst, // 异步复位信号,高电平有效 input clk, output reg lead_signal_wire, // 相位超前指示信号(输出到电荷泵) output reg lag_signal_wire, // 相位滞后指示信号(输出到电荷泵) output bothEdge ); // 延迟寄存器:用于检测两个时钟的到达顺序 reg ref_flag, fb_flag; reg ref_nflag, fb_nflag; reg lead_signal,lead_signal_n; reg lag_signal,lag_signal_n; reg reference_signal_d1,reference_signal_d2; reg controlled_signal_d1,controlled_signal_d2; wire bothEdge_fb; reg fb_flag_d1,fb_flag_d2,fb_nflag_d1,fb_nflag_d2; reg ref_flag_d1,ref_flag_d2,ref_nflag_d1,ref_nflag_d2; always @(posedge clk or negedge rst) begin if(!rst) begin reference_signal_d1 <= 'd0; controlled_signal_d1 <= 'd0; fb_flag_d1 <= 'd0; fb_flag_d2 <= 'd0; fb_nflag_d1 <= 'd0; fb_nflag_d2 <= 'd0; ref_flag_d1 <= 'd0; ref_flag_d2 <= 'd0; ref_nflag_d1 <= 'd0; ref_nflag_d2 <= 'd0; end else begin reference_signal_d1 <= reference_signal; reference_signal_d2 <= reference_signal_d1; controlled_signal_d1 <= controlled_signal; controlled_signal_d2 <= controlled_signal_d1; fb_flag_d1 <= fb_flag; fb_flag_d2 <= fb_flag_d1; fb_nflag_d1 <= fb_nflag; fb_nflag_d2 <= fb_nflag_d1; ref_flag_d1 <= fb_flag; ref_flag_d2 <= ref_flag_d1; ref_nflag_d1 <= ref_nflag; ref_nflag_d2 <= ref_nflag_d1; end end assign bothEdge = reference_signal & (~reference_signal_d1); wire bothEdge_n; assign bothEdge_n = (~reference_signal) & reference_signal_d1; // assign bothEdge_fb = controlled_signal & (~controlled_signal_d1); wire bothEdge_fb_n; //控制下降沿 assign bothEdge_fb_n = (~controlled_signal) & controlled_signal_d1; // // 参考时钟延迟寄存器:在reference_signal上升沿采样 // 功能:标记参考时钟是否到来 always @(posedge reference_signal or negedge rst) begin if (!rst) begin ref_flag <= 1'b0; // 复位时清零 ref_nflag <= 1'b0; end else begin ref_flag <= 1'b1; // 参考时钟到来后置1 ref_nflag <= 1'b0; end end // 反馈时钟延迟寄存器:在controlled_signal上升沿采样 // 功能:标记反馈时钟是否到来 always @(posedge controlled_signal or negedge rst) begin if (!rst) begin fb_flag <= 1'b0; // 复位时清零 fb_nflag <= 1'b0; end else begin fb_flag <= 1'b1; // 反馈时钟到来后置1 fb_nflag <= 1'b0; end end // 主逻辑:检测相位关系 - 谁先来谁占优 // 在参考时钟上升沿判断:如果反馈时钟还没来,说明参考超前 always @(posedge reference_signal_d2) begin if (!fb_flag_d2) lag_signal <= 1'b1; // fb_dly为0表示controlled_signal尚未到达,reference_signal超前 else lag_signal <= 1'b0; // fb_dly为1表示controlled_signal已到,两者已对齐或参考滞后 end // 在反馈时钟上升沿判断:如果参考时钟还没来,说明反馈超前(即参考滞后) always @(posedge controlled_signal_d2) begin if (!ref_flag_d2) lead_signal <= 1'b1; // ref_dly为0表示reference_signal尚未到达,controlled_signal超前 else lead_signal <= 1'b0; // ref_dly为1表示reference_signal已到,两者已对齐或反馈滞后 end //下降沿 always @(negedge reference_signal or negedge rst) begin if (!rst) begin ref_nflag <= 1'b0; // 复位时清零 ref_flag <= 1'b0; end else begin ref_nflag <= 1'b1; // 参考时钟到来后置1 ref_flag <= 1'b0; end end always @(negedge controlled_signal or negedge rst) begin if (!rst) begin fb_nflag <= 1'b0; // 复位时清零 fb_flag <= 1'b0; end else begin fb_nflag <= 1'b1; // 反馈时钟到来后置1 fb_flag <= 1'b0; end end always @(negedge reference_signal_d2) begin if (!fb_nflag_d2) lag_signal_n <= 1'b1; // fb_dly为0表示controlled_signal尚未到达,reference_signal超前 else lag_signal_n <= 1'b0; // fb_dly为1表示controlled_signal已到,两者已对齐或参考滞后 end // 在反馈时钟上升沿判断:如果参考时钟还没来,说明反馈超前(即参考滞后) always @(negedge controlled_signal_d2) begin if (!ref_nflag_d2) lead_signal_n <= 1'b1; // ref_dly为0表示reference_signal尚未到达,controlled_signal超前 else lead_signal_n <= 1'b0; // ref_dly为1表示reference_signal已到,两者已对齐或反馈滞后 end // 消毛刺逻辑:在任一时钟下降沿清零lead_signal_wire/lag_signal_wire信号 // 防止多脉冲叠加,确保每个周期只产生一个有效脉冲 /* always @(negedge reference_signal or negedge controlled_signal) begin {lead_signal_wire, lag_signal_wire} <= 2'b00; // 在时钟下降沿同时复位两个输出 end */ always @(posedge clk or negedge rst) begin if (!rst) begin lead_signal_wire <= 'b0; lag_signal_wire <= 'b0; end //else if(bothEdge & bothEdge_fb) begin else if((bothEdge & bothEdge_fb) | (bothEdge_n & bothEdge_fb_n)) begin lead_signal_wire <= 'b0; lag_signal_wire <= 'b0; end else begin lead_signal_wire <= lead_signal | lead_signal_n; lag_signal_wire <= lag_signal | lag_signal_n; end end endmodule数字振荡器(DCO) 现在我们已经构造出来了一个数字鉴相器,接下来我们将继续探讨如何实现一个数字振荡器(DCO)。 实现一个固定脉冲频率的信号,我们可以通过已知的时钟源,分频得到一定频率范围内的脉冲。具体实现方法就是通过计数器的方式,当出现时钟脉冲时,计数器+1,计数器上限就是分频系数,当计数器的数小于上限的1/2时,输出1,当计数器的数大于上限的1/2时,输出0,当计数器的数超过上限时,计数器归零。这样就能实现对时钟源的分频。 根据上述方法,只要改变计数器的上下限,就能改变分频系数,从而改变输出信号的频率。再参考上文受控信号和滞后提前信号的关系,我们就能通过根据滞后提前信号,改变计数器上下限,来实现对受控信号频率的控制。当计数器上限增加时,分频系数增加,频率减小;当计数器上限减小时,分频系数减小,频率增加;因此有: 滞后信号——>受控信号的频率小——>增加受控信号的频率——>计数器上限减小 提前信号——>受控信号的频率大——>减小受控信号的频率——>计数器上限增加 此外根据上述对上升沿触发同步的说法,当出现上升沿触发信号时,受控信号应强制产生上升沿,即受控信号强制从该脉冲周期的开始处开始,即计数器的数回到0从新开始计数。 综上所述,再加上复位信号,一个数字振荡器的所有构成就有了。到这里,一个数字锁相环(DPLL)其实就已经能够实现了,因为数字滤波器(DB)只是让受控信号的抗干扰能力更强,如图所示是仿真后的结果: 图片 数字缓冲器(DB) 下面再介绍一下数字缓冲器,来使受控信号的抗干扰能力更强。前面我们知道了,持续一个时钟周期的提前信号或者滞后信号能够使数字振荡器的计数器上限加一或者减一。当我的预设的数字振荡器的计数器上限与实际的参考信号的频率对应的计数器上限两个数值相差很大时,就有可能出现锁相环调节时间过长等现象。为了解决这种情况,如果能够让原来持续一个周期的提前信号或滞后信号成倍数的增加,变成持续n个周期的提前信号或者滞后信号,就能够使数字振荡器的计数器上限修改更快,从而更快的到达参考频率附近。但是相应的,受控信号的频率精度就会降低。也就是说,牺牲精度,追求速度。 同时考虑另外一种情况,如果我对速度要求不高,但是对于精度要求较高,同时在信号传输过程中可能存在干扰,导致接收到的提前信号或滞后信号不是完全真实的信号,此时就可以通过一个累加器,只有接受到n个周期的提前信号,或者滞后信号,才对数字振荡器输出一个进位信号或者借位信号,此时数字振荡器的计数器上限才只加减1,这样就能有效的提高精度,减少信号干扰带来的影响。但是这种做法牺牲了数字锁相换锁定的时间。 综上所述,一个时钟周期的提前或滞后信号,对应n个时钟周期的借位或进位信号,是提高锁定速度,降低锁定精度。想法,n个时钟周期的提前或滞后信号,对应一个时钟周期的借位或进位信号,是提高锁定精度,降低锁定速度。因此在实际运用中,应该按照自己的工程需要,合理选择比值。 上述过程的实现方法,是通过一个计数器,当接收到一个提前或滞后信号时,计数器加a,当输出一个进位或借位信号时,计数器减b,调节a和b的比值,就能实现上述过程。 数字缓冲器的仿真效果: 1、分时效果 图片 2、倍时效果 图片 数字锁相环(DPLL)的实现 所有的子模块都已经实现了,剩下的数字锁相环的实现,根据实际的要求,将上述几个模块进行例化就行。例化后的测试结果如图9所示,可以看到受控信号逐渐与参考信号对齐达到锁相环效果。 图片 为了方便起见,对输出信号进行2分频,再次观察输出结果,输出相当于2倍频了,成功完成PD、DCO、Divider等模块正确设计。 图片 电路硬件与性能评估 图11为电路硬件图从图中可以看出各模块的连接关系,每个模块由基本门电路构成。通过性能优化后的的电路如图12所示。 图片 利用SMIC180nm工艺进行电路综合, 时序报告:周期2ns 图片 面积报告:2119um2 图片 功耗报告:uw级别 图片 工程代码下载
FPGA&ASIC
# ASIC/FPGA
刘航宇
3年前
1
4,104
5
Microsemi Libero SOC使用示例—建立点灯工程
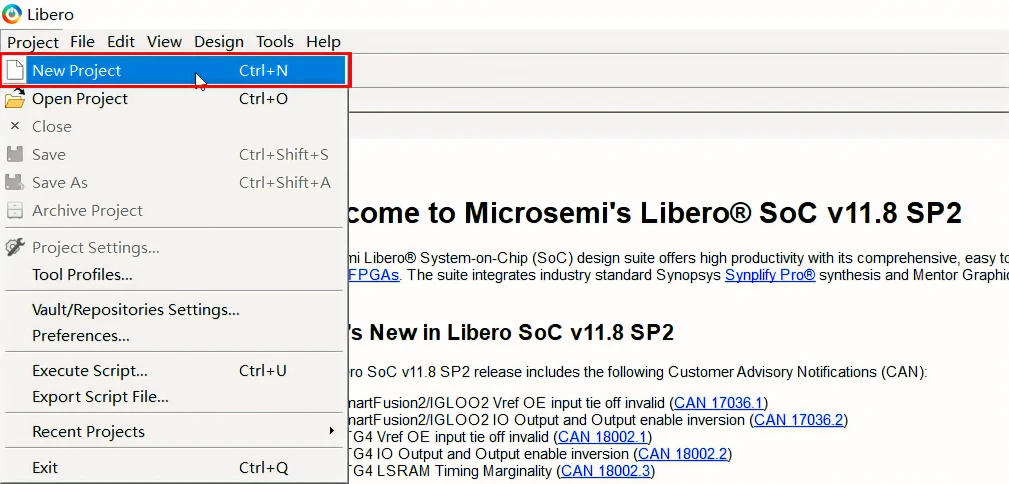
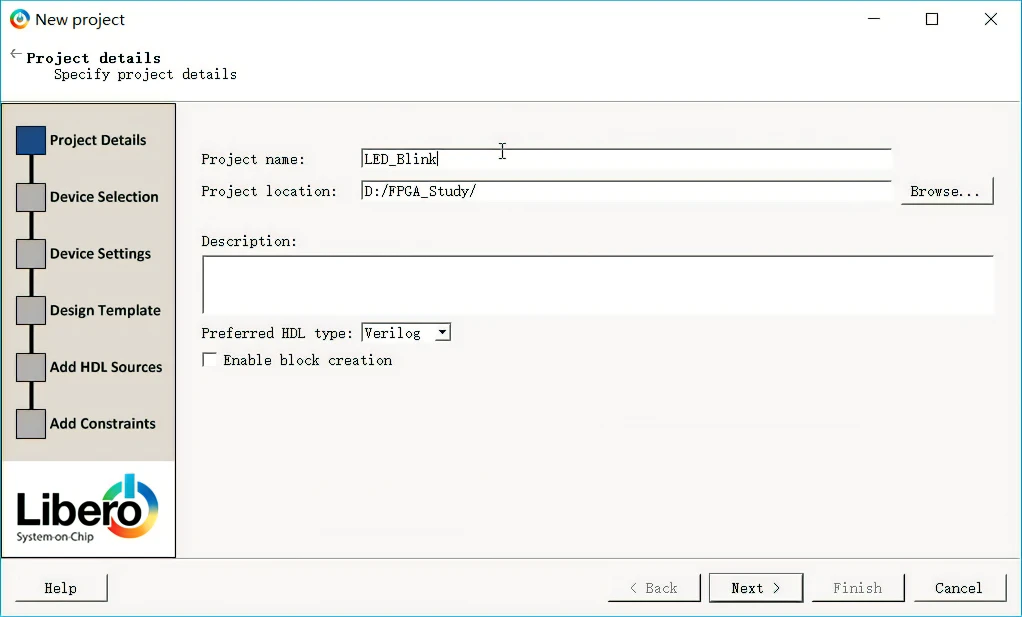
摘要本文介绍了如何使用Microsemi Libero集成开发环境建立点灯工程,通过Verilog编写点灯模块,进行仿真验证,管脚分配,最后下载程序到FPGA芯片,实现LED闪烁。关键词:Microsemi, Libero SoC, FPGA开发, 点灯实验, Verilog嵌入式开发中的Hello World,点灯是再也基础不过的实验了,通过点灯实验,可以了解芯片GPIO的控制和开发环境IDE新建工程的流程,对于FPGA来说,每个IO口几乎一样,所以本篇文章主要学习一下如何基于Microsemi Libero集成开发环境建立一个示例工程,让一个LED以500ms的频率闪烁,以Microsemi SmartFusion系列FPGA——A2F200M3F为例,Microsemi其他系列FPGA芯片过程类似。 准备工作软件准备: 硬件准备: 新建工程的主要步骤1.新建工程 2.添加设计文件 3.仿真验证 4.管脚分配 5.程序下载 Microsemi FPGA的Flash结构 准备工作 工欲利其事,必先利其器,充分的准备工作很有必要。 软件准备: Microsemi Libero SoC集成开发环境,并已经成功注册,软件版本推荐V11.8或更高版本。 硬件准备: Microsemi FPGA开发板,主控芯片A2F200M3F-PQ208,其他型号芯片类似。 Flash Pro 4或Flash Pro5下载器,用于给FPGA芯片下载程序和调试。 新建工程的主要步骤 新建工程,选择芯片型号等 新建设计,使用Verilog编写点灯模块。 仿真验证,对编写的点灯模块进行时序仿真,来验证是否满足设计需求。 综合、管脚分配、布局、布线。 生成程序文件,连接开发板,使用FlashPro下载程序到芯片内,观察现象是否和设计的一致。 1.新建工程 和大多数IDE一样,选择Project -> New Project,新建一个工程。 image.png图片 输入工程名称LED_Blink,选择工程存放的路径,工程名称和路径不要有中文字符和空格,选择源文件的类型Verilog或者VHDL。 image.png图片 选择芯片型号,这里选择Microsemi SmartFusion系列下的A2F200M3F芯片,PQ208封装,把鼠标放在所选芯片上,可以查看芯片的详细参数:封装、速度等级、温度范围,内核电压、Flash ROM大小、用户IO数目、RAM大小、Flash ROM大小,ARM Cortex-M3 SoC的外设配置等详细的参数。 图片 选择IO的电平标准,不同的电平标准,高低电平的电压范围是不同的,这里选择默认的LVTTL。 图片 是否创建MSS模块,MSS里有PLL和ARM Cortex-M3的使用,以后用到PLL和ARM核时再添加,这里先不选择,以后需要也可以再创建。 图片 是否导入已经存在的HDL文件,如果已经有一些写好的模块,可以在这里直接导入。 图片 是否导入已经存在的管脚约束文件,这里选择不添加,我们会在后面通过图形化工具来指定管脚。 图片 到这里,工程就创建完成了,然后会在存储路径下生成一个和工程名称一样的文件夹,工程相关的所以文件都存放在这里。主要包括以下几个文件夹: 图片 具体每个文件夹存放的是什么文件,我们在以后的文章再详细介绍。以上的工程配置在创建完工程之后,也可以再次更改,可以通过Project->Project Setting查看或更改配置: 图片 或者通过点击如下图标来进入配置界面: 图片 弹出如下窗口,和新建工程是一样的,可以更改FPGA的型号,但只限于同一个系列内。 2.添加设计文件 Microsemi Libero开发环境支持HDL方式和SmarDesign方式来创建设计,HDL方式支持VerilogHDL和VHDL两种硬件描述语言,而SmartDesign方式和Xilinx的Schematic原理图方式是一样的,是通过图形化的方式来对各个模块之间的连接方式进行编辑,两种方式都可以完成设计。由于本实验功能简单,所以以使用Verilog文件为例。 创建Verilog文件 创建Verilog文件有多种方式,可以直接双击左侧菜单中的Create Design->Create HDL 图片 或者点击File->New->HDL,这两种方式都可以创建一个Verilog设计文件,这里选择Verilog文件。 图片 输入模块名称:led_driver,不用添加.v后缀名,Libero软件会自动添加。 源代码: module led_driver( //input input clk, //clk=2MHz input rst_n, //0=reset //output output reg led ); parameter T_500MS = 999999; //1M reg [31:0] cnt; always @ (posedge clk) begin if(!rst_n) cnt <= 32'b0; else if(cnt >= T_500MS) cnt <= 32'b0; else //cnt < T_500MS cnt <= cnt + 32'b1; end always @ (posedge clk) begin if(!rst_n) led <= 1'b1; else if(cnt >= T_500MS) led <= ~led; end endmodule可以看到,代码非常的简单,定义一个计数器,系统时钟为2MHz=500ns,500ms=1M个时钟周期,当计数到500ms时,LED翻转闪烁。 3.仿真验证 编写完成,之后,点击对号进行语法检查,如果没有语法错误就可以进行时序仿真了。 新建Testbench文件 底部切换到Design Hierarchy选项卡,在led模块上右键选择Create Testbechch创建仿真文件,选择HDL格式。 图片 给创建的testbench文件名一般为模块名后加_tb,这里为:led_driver_tb,因为我们的板子外部晶体为2M,所以这里系统时钟周期为500ns,这个也可以在文件中更改。 图片 点击OK之后,可以看到,Libero软件已经为我们生成了一些基本代码,包括输入端口的定义,系统时钟的产生,输入信号的初始化等等。我们只需要再增加几行即可。 `timescale 1ns/100ps module led_driver_tb; parameter SYSCLK_PERIOD = 500;// 2MHZ reg SYSCLK; reg NSYSRESET; wire led; //add output reg initial begin SYSCLK = 1'b0; NSYSRESET = 1'b0; end initial begin #(SYSCLK_PERIOD * 10 ) NSYSRESET = 1'b0; //add system reset #(SYSCLK_PERIOD * 100 ) NSYSRESET = 1'b1; //add system set end always @(SYSCLK) //generate system clock #(SYSCLK_PERIOD / 2.0) SYSCLK <= !SYSCLK; led_driver led_driver_0 ( // Inputs .clk(SYSCLK), .rst_n(NSYSRESET), // Outputs .led(led ) //add port // Inouts ); endmodule仿真代码也非常简单,输入信号初始化,NSYSRESET在10个时钟周期之后拉低,100个时钟周期之后拉高。 使用ModelSim进行时序仿真 仿真代码语法检查无误后,可以进行ModelSim自动仿真,在安装Libero时,已经默认安装了ModelSim仿真软件,并和Libero进行了关联。直接双击Simulate,Libero会自动打开ModelSim。 图片 可以看到输入输出信号,已经为我们添加好了: 图片 先点击复位按钮,复位系统,然后设置要运行的时间,由于设计的是500ms闪烁一次,这里我们先运行2s,即2000ms,在ModelSim中2秒已经算是很长的时间了,然后点击时间右边的运行按钮,耐心等待,停止之后就会看到led按500ms变化一次的波形了,如下图所示,可以再添加一个cnt信号到波形观察窗口,可以看到cnt周期性的变化。 图片 使用2个光标的精确测量,可以看出,led每隔500ms翻转一次,说明程序功能是正确的。 4.管脚分配 与STM32等MCU不同,FPGA的引脚配置非常灵活,如STM32只有固定的几个引脚才能作为定时器PWM输出,而FPGA通过管脚分配可以设置任意一个IO口输出PWM,而且使用起来非常灵活,这也是FPGA和MCU的一个区别,当然其他的功能,如串口外设,SPI外设等等,都可以根据需要自己用HDL代码来实现,非常方便。 时序仿真正常之后,就可以进行管脚分配了,即把模块的输入输出端口,真正的分配到芯片实际的引脚上,毕竟我们的代码是要运行在真正的芯片上的。 打开引脚配置图形化界面 双击Create/Edit I/O Attributes,打开图形化配置界面,在打开之前,Libero会先进行综合(Synthesize)、编译(Complie),当都运行通过时,才会打开配置界面。 图片 分配管脚 管脚可视化配置工具使用起来非常简单:引脚号指定、IO的电平标准,内部上下拉等等,非常直观。把时钟、复位、LED这些管脚分配到开发板原理图中对应的引脚,在分配完成之后,可以点击左上角的commit and check进行检查。 图片 在分配完成之后,为了以后方便查看已经分配的引脚,可以导出一个pdc引脚约束文件,选择Designer窗口下的File->Export->Constraint File,会导出一个led_driver.pdc文件,保存在工程目录下的constraint文件夹。 图片 一些特殊管脚的处理 SmartFusion系列的FPGA芯片,在分配个别引脚,如35-39、43-47这些引脚时,直接不能分配,这些引脚属于MSS_FIO特殊引脚,具体怎么配置为通用IO,可以查看下一篇文章。而新一代的SmartFusion 2系列的FPGA芯片则没有这种情况。 5.程序下载 管脚分配完成之后,连接FlashPro下载器和开发板的JTAG接口,关闭Designer窗口,选择Program Device,耐心等待几分钟,如果连接正常,会在右侧输出编程信息:擦除、验证、编程等操作,下载完成之后,就会看到板子上的LED闪烁起来了。 Microsemi FPGA的Flash结构 和Altera、Xilinx不同,Microsemi FPGA在下载程序时,并不是下载程序到SPI Flash,而是直接下载到FPGA内部的。目前,FPGA 市场占有率最高的两大公司Xilinx和Altera 生产的 FPGA 都是基于 SRAM 工艺的,需要在使用时外接一个片外存储器以保存程序。上电时,FPGA 将外部存储器中的数据读入片内 RAM,完成配置后,进入工作状态;掉电后 FPGA 恢复为白片,内部逻辑消失。这样 FPGA 不仅能反复使用,还无需专门的 FPGA编程器,只需通用的 EPROM、PROM 编程器即可。而Microsemi的SmartFusion、SmartFusion2、ProASICS3、ProASIC3E系列基于Flash结构,具备反复擦写和掉电后内容非易失性, 因此基于Flash结构的FPGA同时具备了SRAM结构的灵活性和反熔丝结构的可靠性,这种技术是最近几年发展起来的新型FPGA实现工艺,目前实现的成本还偏高,没有得到大规模的应用。 示例工程下载 基于Libero V11.8.2.4的工程下载: LED_Blink.rar 下载地址:https://wcc-blog.oss-cn-beijing.aliyuncs.com/Libero/Libero-2/LED_Blink.rar 提取码:
嵌入式&系统
FPGA&ASIC
IP&SOC设计
# ASIC/FPGA
# 嵌入式
# SOC设计
刘航宇
3年前
0
2,025
2
2023-02-27
VLSI设计基础11-运算模块之加法器
摘要本文介绍了VLSI设计中运算模块中的加法器,包括一位全加器、逐位加法器、互补静态CMOS结构FA、传输门型加法器、旁路进位加法器、线性进位选择加法器、平方根进位加法器以及超前进位加法器等,并探讨了优化加法器性能、面积和功耗的方法。关键词:VLSI设计, 加法器, 组合电路, 逻辑运算, 算数运算参考书:数字集成电路-电路、系统与设计,本文栏目对其重点进行精简化 目录 1. 总论 2. 加法器1. 一位全加器(FA) 2. 【结构】设计全加器FA 3. 传输门型加法器——传统型 4. 传输门型加法器——曼切斯特FA 4. 【重要】超前进位加法器 1. 总论 在时序电路中,时序电路=组合电路+存储电路 在(9)~(11)中,已经详细介绍了存储电路(寄存器) 在本文中,将介绍组合电路中比较重要的数据通路上的电路,可以认为是在时序电路中提到的 ,即用于逻辑运算和算数运算。 在数集中,常用的数据通路组合电路有 加法器 乘法器 移位器 我们的目的,是追求以下几个方面的优化 性能 面积 功耗 如何优化: 逻辑层次优化:利用状态机、真值表等,优化布尔方程得到一个速度更快、面积更小的电路 电路层次优化:改变管子的尺寸;改变电路的拓扑连接(互补CMOS、动态CMOS等) 2. 加法器 加法器在数据通路电路中的地位类似于反相器在与或等简单逻辑电路的位置 数据通路的电路的基础是加法器 乘法器也是加法器扩展而来的 加法器是限制数据通路运算速度的元件。 1. 一位全加器(FA) 传统表达方式 定义:根据输入的二值数据、进位信号,计算得到结果和进位。 图片 图片 【注】: 异或,常见结构有: 图片 同或,结构如下(即“异或门结构2”的“非”): 图片 P、G、D函数表达 真值表如下: 图片 图片 逐位(行波)加法器 所谓逐位(行波)加法器,指的是将N个一位全加器(FN)串联在一起构成加法器。如下图 图片 图片 2. 【结构】设计全加器FA 互补静态CMOS结构FA 图片 图片 镜像加法器 该加法器是根据互补静态CMOS结构FA改进得到的,镜像加法器的下拉网络和互补CMOS结构FA完全相同。 电路图如图所示, 图片 图片 3. 传输门型加法器——传统型 图片 图片 4. 传输门型加法器——曼切斯特FA 静态电路 图片 图片 动态电路 图片 动态电路简单 动态电路单向工作,传输门使用NMOS管实现 该电路不需要D 曼切斯特进位链加法器 图片 图片 【逻辑】设计全加器FA 旁路进位加法器 图片 图片 延时 图片 $t_{\text {adder }}=t_{\text {setup }}+M t_{\text {carry }}+\left(\frac{N}{M}-1\right) t_{\text {bypass }}+(M-1) t_{\text {carry }}+t_{\text {sum }}$ 线性进位选择加法器 图片 图片 图片 图片 平方根进位加法器 图片 图片 图片 4. 【重要】超前进位加法器 原理 图片 图片 图片 图片 块运算 图片 图片 图片 点操作 步骤如下: 图片 图片 图片 Kogge-Stone 16位超前进位加法器 图片 图片 Brent-Kung 16位超前进位加法器 图片 图片
VLSI&IC验证
# VLSI
刘航宇
3年前
0
1,840
5
I2C协议及verilog实现-串口读写 EEPROM
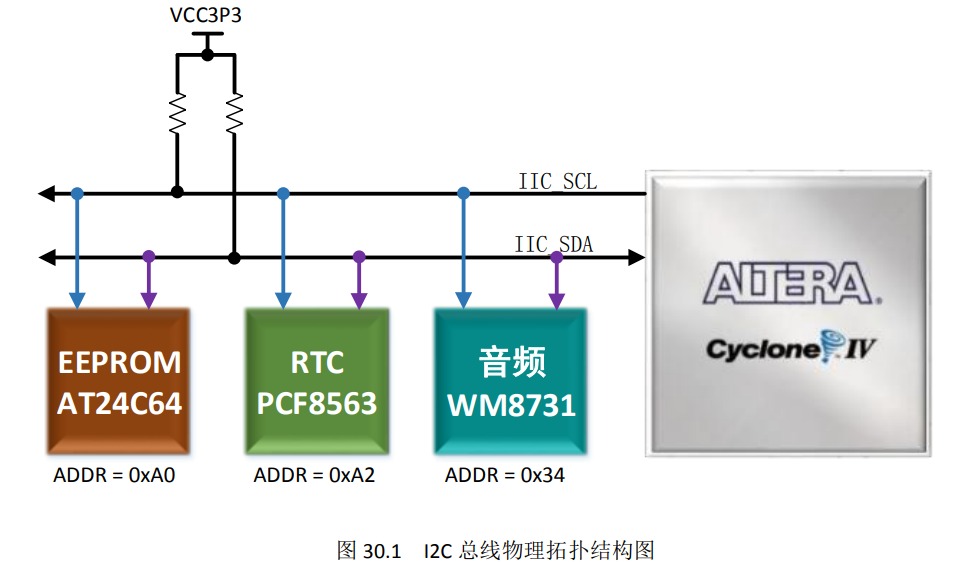
摘要本文介绍了I2C协议的基本概念、时序、器件地址和存储器地址,并详细阐述了I2C读写操作的时序和Verilog实现,最后通过仿真和板级验证验证了设计的正确性。关键词:I2C协议, Verilog实现, 串口读写, EEPROM, FPGAI2C 基本概念 I2C 总线(I2C bus,Inter-IC bus)是一个双向的两线连续总线,提供集成电路(ICs)之间的通信线路。I2C 总线是一种串行扩展技术,最早由 Philips 公司推出,广泛应用于电视,录像机和音频设备。I2C 总线的意思是“完成集成电路或功能单元之间信息交换的规范或协议”。Philips 公司推出的 I2C 总线采用一条数据线(SDA),加一条时钟线(SCL)来完成数据的传输及外围器件的扩展。I2C 总线物理拓扑结构如图 30.1 所示。 图片 I2C 总线在物理连接上比较简单,分别由 SDA(串行数据线)和 SCL(串行时钟线)两条总线及上拉电阻组成。通信的原理是通过控制 SCL 和 SDA 的时序,使其满足 I2C 的总线协议从而进行数据的传输。 I2C 总线上的每一个设备都可以作为主设备或者从设备,而且每一个设备都会对应一个唯一的地址(可以从 I2C 器件数据手册得知),主从设备之间就是通过这个地址来确定与哪个器件进行通信。本次实验我们把 FPGA 作为主设备,把挂载在总线上的其他设备(如 EEPROM、PFC8563 等 I2C 器件)作为从设备。 I2C 总线数据传输速率在标准模式下可达 100kbit/s,快速模式下可达 400kbit/s,高速模式下可达 3.4Mbit/s。I2C 总线上的主设备与从设备之间以字节(8 位)为单位进行双向的数据传输。 目录 I2C 基本概念 I2C 协议时序介绍 inout信号原理 I2C 器件地址 I2C 存储器地址 I2C 单字节写时序 I2C 连续写时序(页写时序) I2C 单字节读时序 I2C 连续读时序(页读取) I2C 读写器件控制程序 本节小结 I2C 协议时序介绍 I2C 协议整体时序图如图 30.2 所示 图片 I2C 协议整体时序说明如下: (1) 总线空闲状态:SDA 为高电平,SCL 为高电平; (2) I2C 协议起始位:SCL 为高电平时,SDA 出现下降沿,产生一个起始位; (3) I2C 协议结束位:SCL 为高电平时,SDA 出现上升沿,产生一个结束位; (4) I2C 读写数据状态:主要包括数据的串行输出输入和数据接收方对数据发送方的响应信号。具体时序如图 30.3 所示。 图片 当 I2C 主机(后面简称主机)向 I2C 从机(后面简称从机)写入数据时,SDA 上的每一位数据在 SCL 的高电平期间被写入从机中。从主机角度来看,需要在 SCL 低电平期间改变要写入的数据。而当主机读取从机中数据时,从机在 SCL 低电平期间将数据输出到 SDA 总线上,在 SCL 的高电平期间保持数据稳定,从主机角度来看,需要在 SCL 的高电平期间将 SDA 线上的数据读取并存储。 每当一个字节的数据或命令传输完成时,数据接收方都会向发送方响应一位应答位。在响应应答位时,数据发出方将 SDA 总线设置为三态输入,由于 I2C 总线上都有上拉电阻,因此此时总线默认为高电平,若数据接收方正确接收到数据,则数据接收方将 SDA 总线拉低,以示正确应答。例如当主机向从机写入数据或命令时,每个字节都需要从机产生应答信号以告诉主机此次的数据或命令是否成功被写入。所以,当主机将一字节的数据或命令传出后,会将 SDA 信号设置为三态输入,等待从机应答(等待 SDA 被从机拉低为低电平),若从机正确应答,表明当前数据或命令传输成功,可以结束或开始下一个数据或命令的传输,否则表明数据或命令写入失败,主机就可以决定是否放弃写入或者重新发起写入。 inout信号原理 图片 图片 I2C 器件地址 每个 I2C 器件都有一个器件地址,有的器件地址在出厂时地址就设置好了,用户不可以更改(例如 OV7670 器件地址为固定的 0x42),有的确定了几位,剩下几位由硬件确定(比如常见的 I2C 接口的 EEPROM 存储器,留有 3 个控制地址的引脚,由用户自己在硬件设计时确定)。严格讲,主机不是直接向从机发送地址,而是主机往总线上发送地址,所有的从机都能接收到主机发出的地址,然后每个从机都将主机发出的地址与自己的地址比较,如 果匹配上了,这个从机就会向主机发出一个响应信号。主机收到响应信号后,开始向总线上发送数据,与这个从机的通讯就建立起来了。如果主机没有收到响应信号,则表示寻址失败。 通常情况下,主从器件的角色是确定的,也就是说从机一直工作在从机模式。不同器件定义地址的方式是不同的,有的是软件定义,有的是硬件定义。例如某些单片机的I2C 接口作为从机时,其器件地址是可以通过软件修改从机地址寄存器确定的。而对于一些其他器件,如 CMOS 图像传感器、EEPROM 存储器,其器件地址在出厂时就已经设定好了,具体值可以在对应的数据手册中查到。 对于 AT24C64 这样一颗 EEPROM 器件,其器件地址为 1010 加 3 位的片选信号。3位片选信号由硬件连接决定。例如 SOIC 封装的该芯片 PIN1、PIN2、PIN3 为片选地址。当硬件电路上分别将这三个 pin 连接到 GND 或 VCC 时,就可以设置不同的片选地址。I2C 协议在进行数据传输时,主机需要首先向总线上发出控制命令,其中,控制命令就包含了从机地址/片选信号+读写控制。然后等待从机响应。如图 30.4 所示为 I2C 控制命令传输的数据格式。 图片 I2C 传输时,按照从高到低的位序进行传输。控制字节的最低位为读写控制位,当该位为 0 时表示主机对从机进行写操作,当该位为 1 时表示主机对从机进行读操作。例如,当需要对片选地址为 100 的 AT24LC64 发起写操作,则控制字节应该为 1010_100_0。若进行读操作,则控制字节应该为 1010_100_1。 I2C 存储器地址 每个支持 I2C 协议的器件,内部总会有一些可供读写的寄存器或存储器,例如,对于我们用到的 EEPROM 存储器,内部就是顺序编址的一系列存储单元。对于我们常接触的 CMOS 摄像头如 OV7670(OV7670 的该接口叫 SCCB 接口,其实质也是一种特殊的 I2C协议,可以直接兼容 I2C 协议),其内部就是一系列编址的可供读写的寄存器。因此,我们要对一个器件中的存储单元(寄存器和存储器以下简称存储单元)进行读写,就必须要能够指定存储单元的地址。I2C 协议设计了有从机存储单元寻址地址段,该地址段为一个字或两个字节长度,在主机确认收到从机返回的控制字节响应后由主机发出。地址段长度视不同的器件类型,长度不同,例如同是 EEPROM 存储器,AT24C04 的址段长度为一个字节,而 AT24C64 的地址段长度为两个字节。具体是一个字节还是两个字节,与器件的存储单元数量有关。如图 30.5 和图 30.6 分别为 1 字节地址和 2 字节地址器件的地址分布图,其中 1 字节地址的器件是以内存为 1kbit 的 EEPROM 存储器 AT24C01 举例,2 字节地址的器件是以内存为 64kbit 的 EEPROM 存储器 AT24C64 举例的。 图片 I2C 单字节写时序 根据前面讲的,不同器件,I2C 器件地址字节不同,这样对于 I2C 单字节写时序就会有所差别,图 30.7 和图 30.8 分别为 1 字节地址段器件和 2 字节地址段器件单字节写时序图。 图片 图片 根据时序图,从主机角度来描述一次写入单字节数据过程如下: a. 主机设置 SDA 为输出; b. 主机发起起始信号; c. 主机传输器件地址字节,其中最低位为 0,表明为写操作; d. 主机设置 SDA 为三态门输入,读取从机应答信号; e. 读取应答信号成功,主机设置 SDA 为输出,传输 1 字节地址数据; f. 主机设置 SDA 为三态门输入,读取从机应答信号; g. 读取应答信号成功,对于两字节地址段器件,传输地址数据低字节,对于 1 字节地址段器件,主机设置 SDA 为输出,传输待写入的数据; h. 设置 SDA 为三态门输入,读取从机应答信号,对于两字节地址段器件,接着步骤 i;对于 1 字节地址段器件,直接跳转到步骤 k; i. 读取应答信号成功,主机设置 SDA 为输出,传输待写入的数据(对于两字节地址段器件); j. 设置 SDA 为三态门输入,读取从机应答信号(两字节地址段器件); k. 读取应答信号成功,主机产生 STOP 位,终止传输。 I2C 连续写时序(页写时序) 注:I2C 连续写时序仅部分器件支持。 连续写是主机连续写多个字节数据到从机,这个和单字节写操作类似,连续多字节写操作也是分为 1 字节地址段器件和 2 字节地址段器件的写操作,图 30.9 和图 30.10 分别为 1 字节地址段器件和 2 字节地址段器件连续多字节写时序图。 图片 根据时序图,从主机角度来描述一次写入多字节数据过程如下: a. 主机设置 SDA 为输出; b. 主机发起起始信号; c. 主机传输器件地址字节,其中最低位为 0,表明为写操作; d. 主机设置 SDA 为三态门输入,读取从机应答信号; e. 读取应答信号成功,主机设置 SDA 为输出,传输 1 字节地址数据; f. 主机设置 SDA 为三态门输入,读取从机应答信号; g. 读取应答信号成功后,主机设置 SDA 为输出,对于两字节地址段器件,传输低字节地址数据,对于 1 字节地址段器件,传输待写入的第 1 个数据 h. 设置 SDA 为三态门输入,读取从机应答信号,对于两字节地址段器件,接着步骤 i;对于 1 字节地址段器件,直接跳转到步骤 k; i. 读取应答信号成功后,主机设置 SDA 为输出,传输待写入的第 1 个数据(两字节地址段器件); j. 设置 SDA 为三态门输入,读取从机应答信号(两字节地址段器件); k. 读取应答信号成功后,主机设置 SDA 为输出,传输待写入的下一个数据; l. 设置 SDA 为三态门输入,读取从机应答信号;n 个数据被写完,转到步骤 m,若数据未被写完,转到步骤 k; m. 读取应答信号成功后,主机产生 STOP 位,终止传输。 注:对于 AT24Cxx 系列的 EEPROM 存储器,一次可写入的最大长度为 32 字节。 I2C 单字节读时序 同样的,I2C 读操作时序根据不同 I2C 器件具有不同的器件地址字节数,单字节读操作分为 1 字节地址段器件单节数据读操作和 2 字节地址段器件单节数据读操作。图30.11 和图 30.12 分别为 不同情况的时序图。 图片 根据时序图,从主机角度描述一次读数据过程,如下: a. 主机设置 SDA 为输出; b. 主机发起起始信号; c. 主机传输器件地址字节,其中最低位为 0,表明为写操作; d. 主机设置 SDA 为三态门输入,读取从机应答信号; e. 读取应答信号成功,主机设置 SDA 输出,传输 1 字节地址数据; f. 主机设置 SDA 为三态门输入,读取从机应答信号; g. 读取应答信号成功,主机设置 SDA 输出,对于两字节地址段器件,传输低字节地址数据;对于 1 字节地址段器件,无此步骤,直接跳转到步骤 h; h. 主机发起起始信号; i. 主机传输器件地址字节,其中最低位为 1,表明为读操作; j. 设置 SDA 为三态门输入,读取从机应答信号; k. 读取应答信号成功,主机设置 SDA 为三态门输入,读取 SDA 总线上的一个字节的数据; l. 产生无应答信号(高电平)(无需设置为输出高电平,因为总线会被自动拉高);m. 主机产生 STOP 位,终止传输。 I2C 连续读时序(页读取) 连续读是主机连续从从机读取多个字节数据,这个和单字节读操作类似,连续多字节读操作也是分为 1 字节地址段器件和 2 字节地址段器件的读操作,图 30.13 和图 30.14 分别为 1 字节地址段器件和 2 字节地址段器件连续多字节读时序图。 图片 根据时序图,从主机角度描述多字节数据读取过程如下: a. 主机设置 SDA 为输出 b. 主机发起起始信号 c. 主机传输器件地址字节,其中最低位为 0,表明为写操作。 d. 主机设置 SDA 为三态门输入,读取从机应答信号。 e. 读取应答信号成功,主机设置 SDA 输出,传输 1 字节地址数据 f. 主机设置 SDA 为三态门输入,读取从机应答信号。 g. 读取应答信号成功,主机设置 SDA 输出,对于两字节地址段器件,传输低字节地址数据;对于 1 字节地址段器件,无此步骤;直接跳转到步骤h; h. 主机发起起始信号; i. 主机传输器件地址字节,其中最低位为 1,表明为读操作; j. 设置 SDA 为三态门输入,读取从机应答信号; k. 设置 SDA 为三态门输入,读取 SDA 总线上的第 1 个字节的数据; l. 主机设置 SDA 输出,发送一位应答信号; m. 设置 SDA 为三态门输入,读取 SDA 总线上的下一个字节的数据;若 n 个字节数据读完成,跳转到步骤 n,若数据未读完,跳转到步骤 l;(对于 AT24Cxx,一次读取长度最大为 32 字节,即 n 不大于 32) n. 主机设置 SDA 输出,产生无应答信号(高电平)(无需设置为输出高电平,因为总线会被自动拉高); o. 主机产生 STOP 位,终止传输。 I2C 读写器件控制程序 通过上述的讲述,对 I2C 读写器件数据时序有了一定的了解,下面将开始进行控制程序的设计。根据上面 I2C 的基本概念中有关读写时 SDA 与 SCL 时序,不管对于从机还是主机,SDA 上的每一位数据在 SCL 的高电平期间保持不变,而数据的改变总是在 SCL的低电平期间发生。因此,我们可以选用 2 个标志位对时钟 SCL 的高电平和低电平进行标记,如下图所示:scl_high 对 SCL 高电平期间进行标志,scl_low 对 SCL 低电平期间进行标志。这样就可以在 scl_high 有效时读 SDA 数据,在 scl_low 有效时改变数据。scl_high和 scl_low 产生的时序图如图 30.15 所示。 图片 在本实验中,时钟信号 SCL 采用计数器方法产生,计数器最大计数值为系统时钟频率除以 SCL 时钟频率,即:SCL_CNT_M = SYS_CLOCK/SCL_CLOCK。对于 scl_high 和 scl_low则只需要分别在计数到四分之一的最大值和四分之三的最大值时产生标志位即可,具体的时钟信号 SCL 和标志信号 scl_high、scl_low 产生实现代码如下: //系统时钟采用 50MHz parameter SYS_CLOCK = 50_000_000; //SCL 总线时钟采用 400kHz parameter SCL_CLOCK = 400_000; //产生时钟 SCL 计数器最大值 localparam SCL_CNT_M = SYS_CLOCK/SCL_CLOCK; reg [15:0]scl_cnt; //SCL 时钟计数器 reg scl_vaild; //I2C 非空闲时期 reg scl_high; //SCL 时钟高电平中部标志位 reg scl_low; //SCL 时钟低电平中部标志位 //I2C 非空闲时期 scl_vaild 的产生 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_vaild <= 1'b0; else if(Wr | Rd) scl_vaild <= 1'b1; else if(Done) scl_vaild <= 1'b0; else scl_vaild <= scl_vaild; end //scl 时钟计数器 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_cnt <= 16'd0; else if(scl_vaild)begin if(scl_cnt == SCL_CNT_M - 1) scl_cnt <= 16'd0; else scl_cnt <= scl_cnt + 16'd1; end else scl_cnt <= 16'd0; end //scl 时钟,在计数器值到达最大值一半和 0 时翻转 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Scl <= 1'b1; else if(scl_cnt == SCL_CNT_M >>1) Scl <= 1'b0; else if(scl_cnt == 16'd0) Scl <= 1'b1; else Scl <= Scl; end //scl 时钟高低电平中部标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_high <= 1'b0; else if(scl_cnt == (SCL_CNT_M>>2)) scl_high <= 1'b1; else scl_high <= 1'b0; end //scl 时钟低电平中部标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_low <= 1'b0; else if(scl_cnt == (SCL_CNT_M>>1)+(SCL_CNT_M>>2)) scl_low <= 1'b1; else scl_low <= 1'b0; end上述代码中 Wr 和 Rd 信号为 I2C 进行一次写和读操作的门控使能信号,Done 信号为一次I2C写和读操作完成标志位。(SCL_CNT_M>>2)和(SCL_CNT_M>>1)+(SCL_CNT_M>>2)分别为 1/2 的 SCL_CNT_M 和 3/4 的 SCL_CNT_M 的计数值。 在 SCL 时钟总线以及其高低电平标志位产生完成后,接下来的事情就是 SDA 数据线的产生,这个需要根据具体的读写操作时序完成。本实验主要采用状态机实现,根据上面讲述的读写数据的时序关系,设计了如图 30.16 所示的状态转移图,其状态机状态编码采用独热编码,若需要改变状态编码形式,只需改变程序中的 parameter 定义即可。 图片 根据上面 I2C 基本概念可知,不同的器件其寄存器地址字节数分为 1 字节或和 2 字节地址段,并且有些 I2C 器件是支持多字节的数据读写,所以在设计时考虑到该 I2C 控制器的通用性,我们将设计寄存器地址字节和读取数据个数均可自行设置的 I2C 控制器,用户可根据自己的实际应用情况设置选择与器件对应的寄存器地址字节数或是读写数据的字节数。寄存器地址字节数的可变主要是通过一个计数器对字节数进行计数,当计数值达到指定值后跳转到下一状态,具体的可参见代码。 在状态机中,从主机角度来看,SDA 数据线上在写控制、写数据、读控制状态过程是需要串行输出数据,而在读数据状态过程是需要串行输入数据。根据数据在时钟高电平期间保持不变,改变数据在低电平时期的规则,本设计对时钟信号的高低电平进行计数,从而在指定的计数值进行输出或读取数据实现数据的串行输出和串行输入。串行输出和串行输入数据采用任务的形式进行表示,便于在主状态机中多次的调用。图 30.17为计数的过程以及特定状态变化的时序图,这里的特定状态主要是指读/写控制、读/写地址和读/写数据状态。 图片 图 30.17 中计数器 halfbit_cnt 和数据接收方对发送的响应检测标志位 ack 以及串行输出、输入数据任务的具体代码如下: //sda 串行接收与发送时 scl 高低电平计数器 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) halfbit_cnt <= 8'd0; else if((main_state == WR_CTRL)|| (main_state == WR_WADDR)|| (main_state == WR_DATA)|| (main_state == RD_CTRL)|| (main_state == RD_DATA))begin if(scl_low | scl_high)begin if(halfbit_cnt == 8'd17) halfbit_cnt <= 8'd0; else halfbit_cnt <= halfbit_cnt + 8'd1; end else halfbit_cnt <= halfbit_cnt; end else halfbit_cnt <= 8'd0; end //数据接收方对发送的响应检测标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) ack <= 1'b0; else if((halfbit_cnt == 8'd16)&&scl_high&&(Sda==1'b0)) ack <= 1'b1; else if((halfbit_cnt == 8'd17)&&scl_low) ack <= 1'b0; else ack <= ack; end //输出串行数据任务 task send_8bit_data; if(scl_high && (halfbit_cnt == 8'd16)) FF <= 1; else if(halfbit_cnt < 8'd17)begin sda_reg <= sda_data_out[7]; if(scl_low) sda_data_out <= {sda_data_out[6:0],1'b0}; else sda_data_out <= sda_data_out; end else ; endtask //串行数据输入任务 task receive_8bit_data; if(scl_low && (halfbit_cnt == 8'd15)) FF <= 1; else if((halfbit_cnt < 8'd15))begin if(scl_high) sda_data_in <= {sda_data_in[6:0],Sda}; else begin sda_data_in <= sda_data_in; end end else ; endtask对于计数器 halfbit_cnt 只在写控制、写数据、读控制、读数据状态下才进行计数,其他状态为零。代码中 FF 是进行串行输出或输入任务的标志位,当 FF 为 1 时表示退出任务,FF 为 0 时表示进入任务。这样便于在状态机中对任务的调用,以及在指定的时间退出任务。 接下来就是主状态机的设计,主状态机的状态转移图上面已经给出,具体转移过程是依据 I2C 读写时序进行的,代码如下: //主状态机 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n)begin main_state <= IDLE; sda_reg <= 1'b1; W_flag <= 1'b0; R_flag <= 1'b0; Done <= 1'b0; waddr_cnt <= 2'd1; wdata_cnt <= 8'd1; rdata_cnt <= 8'd1; end else begin case(main_state) IDLE:begin sda_reg <= 1'b1; W_flag <= 1'b0; R_flag <= 1'b0; Done <= 1'b0; waddr_cnt <= 2'd1; wdata_cnt <= 8'd1; rdata_cnt <= 8'd1; if(Wr)begin main_state <= WR_START; W_flag <= 1'b1; end else if(Rd)begin main_state <= WR_START; R_flag <= 1'b1; end else main_state <= IDLE; end WR_START:begin if(scl_low)begin main_state <= WR_CTRL; sda_data_out <= wr_ctrl_word; FF <= 1'b0; end else if(scl_high)begin sda_reg <= 1'b0; main_state <= WR_START; end else main_state <= WR_START; end WR_CTRL:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(scl_low)begin main_state <= WR_WADDR; FF <= 1'b0; if(Wdaddr_num == 2'b1) sda_data_out <= Word_addr[7:0]; else sda_data_out <= Word_addr[15:8]; end else main_state <= WR_CTRL; end else//未收到响应 main_state <= IDLE; end end WR_WADDR:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(waddr_cnt == Wdaddr_num)begin if(W_flag && scl_low)begin main_state <= WR_DATA; sda_data_out <= Wr_data; waddr_cnt <= 2'd1; FF <= 1'b0; end else if(R_flag && scl_low)begin main_state <= RD_START; sda_reg <= 1'b1; end else main_state <= WR_WADDR; end else begin if(scl_low)begin waddr_cnt <= waddr_cnt + 2'd1; main_state <= WR_WADDR; sda_data_out <= Word_addr[7:0]; FF <= 1'b0; end else main_state <= WR_WADDR; end end else//未收到响应 main_state <= IDLE; end end WR_DATA:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(wdata_cnt == Wrdata_num)begin if(scl_low)begin main_state <= STOP; sda_reg <= 1'b0; wdata_cnt <= 8'd1; end else main_state <= WR_DATA; end else begin if(scl_low)begin wdata_cnt <= wdata_cnt + 8'd1; main_state <= WR_DATA; sda_data_out <= Wr_data; FF <= 1'b0; end else main_state <= WR_DATA; end end else//未收到响应 main_state <= IDLE; end end RD_START:begin if(scl_low)begin main_state <= RD_CTRL; sda_data_out <= rd_ctrl_word; FF <= 1'b0; end else if(scl_high)begin main_state <= RD_START; sda_reg <= 1'b0; end else main_state <= RD_START; end RD_CTRL:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(scl_low)begin main_state <= RD_DATA; FF <= 1'b0; end else main_state <= RD_CTRL; end else//未收到响应 main_state <= IDLE; end end RD_DATA:begin if(FF == 1'b0) receive_8bit_data; else begin if(rdata_cnt == Rddata_num)begin sda_reg <= 1'b1; if(scl_low)begin main_state <= STOP; sda_reg <= 1'b0; end else main_state <= RD_DATA; end else begin sda_reg <= 1'b0; if(scl_low)begin rdata_cnt <= rdata_cnt + 8'd1; main_state <= RD_DATA; FF <= 1'b0; end else main_state <= RD_DATA; end end end STOP:begin//结束操作 if(scl_high)begin sda_reg <= 1'b1; main_state <= IDLE; Done <= 1'b1; end else main_state <= STOP; end default: main_state <= IDLE; endcase end end主状态机完成后,I2C 控制器设计的大块就解决了,剩下的就是 SDA 数据线的输出了,该数据线采用三态使能输出,具体代码如下: assign Sda = sda_en ? sda_reg : 1'bz;对于使能信号 sda_en 按照上面的时序关系图可知,该信号在不同的状态,其高低电平变化的时刻是有差别的,比如在开始和结束状态,它是一直为高电平的,在写控制、写数据、读控制状态,它是在串行输出一字节数据期间(即 halfbit_cnt < 16 时)为高电平,之外的一个数据为位低电平,而在读数据状态时串行输入一字节数据期间(即halfbit_cnt < 16 时)为低电平电平,之外的一个数据位为高电平。具体代码如下: //SDA 三态使能信号 sda_en always@(*) begin case(main_state) IDLE: sda_en = 1'b0; WR_START,RD_START,STOP: sda_en = 1'b1; WR_CTRL,WR_WADDR,WR_DATA,RD_CTRL: if(halfbit_cnt < 16) sda_en = 1'b1; else sda_en = 1'b0; RD_DATA: if(halfbit_cnt < 16) sda_en = 1'b0; else sda_en = 1'b1; default: sda_en = 1'b0; endcase end本实验设计考虑到了多字节数据的读取情况,所以增加了数据读取和数据写入时的 有效标志位信号。主要是标志读取数据时数据有效时刻和写数据时提供待写入数据时刻。 具体代码如下: //写数据有效标志位 assign Wr_data_vaild = ((main_state==WR_WADDR)&& (waddr_cnt==Wdaddr_num)&& (W_flag && scl_low)&& (ack == 1'b1))|| ((main_state == WR_DATA)&& (ack == 1'b1)&&(scl_low)&& (wdata_cnt != Wrdata_num)); //读数据有效标志位前寄存器 assign rdata_vaild_r = (main_state == RD_DATA) &&(halfbit_cnt == 8'd15)&&scl_low; //读出数据有效标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Rd_data_vaild <= 1'b0; else if(rdata_vaild_r) Rd_data_vaild <= 1'b1; else Rd_data_vaild <= 1'b0; end //读出的有效数据 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Rd_data <= 8'd0; else if(rdata_vaild_r) Rd_data <= sda_data_in; else Rd_data <= Rd_data; end到目前为止,整个 I2C 控制器的设计就完成了,接下来就进入仿真环节,我们需要EEPROM 的仿真模型进行仿真,这样能更好的检验 I2C 控制器设计的是否存在问题,以便后面进行优化改进。本实验采用的是镁光官网提供的 EEPROM 仿真模型,具体下载网 址 为 http://www.microchip.com/zh/design-centers/memory/serial-eeprom/verilog-ibis-models,我们选择两个具有代表性的模型进行仿真,分别为 1 字节寄存器地址段的 24LC04B 和 2 字节寄存器地址段的 24LC64 仿真模型,利用这两个模型对我们设计的 I2C 控制器进行仿真。如图 30.18 为仿真验证的结构框图。 图片 这里我们对 1 字节寄存器地址段的 24LC04B 和 2 字节寄存器地址段的 24LC64 仿真模型的器件地址{A3,A2,A1}分别设置为 3’b001 和 3’b000,仿真时为了能分别对不同型号的模型进行仿真,在编写的 testbench 文件中采用了申明方法去选择当前使用哪个模型进行仿真,具体代码如下: `timescale 1ns/1ns `define CLK_PERIOD 20 //仿真模型选择 //`define TEST_M24LC64 //24LC64 `define TEST_M24LC04 //24LC04 module I2C_tb; reg Clk; //系统时钟 reg Rst_n; //系统复位信号 reg [15:0] Word_addr; //I2C 器件寄存器地址 reg Wr; //I2C 器件写使能 reg [7:0] Wr_data; //I2C 器件写数据 wire Wr_data_vaild;//I2C 器件写数据有效标志位 reg Rd; //I2C 器件读使能 wire[7:0] Rd_data; //I2C 器件读数据 wire Rd_data_vaild;//I2C 器件读数据有效标志位 wire Scl; //I2C 时钟线 wire Sda; //I2C 数据线 wire Done; //对 I2C 器件读写完成标识位 localparam NUM = 6'd4; //单次读写数据字节数 `ifdef TEST_M24LC64 localparam DevAddr = 3'b000; //I2C 器件的器件地址 localparam WdAr_NUM= 2; //I2C 器件的存储器地址字节数 `elsif TEST_M24LC04 localparam DevAddr = 3'b001; //I2C 器件的器件地址 localparam WdAr_NUM= 1; //I2C 器件的存储器地址字节数 `endif I2C I2C( .Clk(Clk), .Rst_n(Rst_n), .Rddata_num(NUM), .Wrdata_num(NUM), .Wdaddr_num(WdAr_NUM), .Device_addr(DevAddr), .Word_addr(Word_addr), .Wr(Wr), .Wr_data(Wr_data), .Wr_data_vaild(Wr_data_vaild), .Rd(Rd), .Rd_data(Rd_data), .Rd_data_vaild(Rd_data_vaild), .Scl(Scl), .Sda(Sda), .Done(Done) ); `ifdef TEST_M24LC64 M24LC64 M24LC64( .A0(1'b0), .A1(1'b0), .A2(1'b0), .WP(1'b0), .SDA(Sda), .SCL(Scl), .RESET(!Rst_n) ); `elsif TEST_M24LC04 M24LC04B M24LC04( .A0(1'b1), .A1(1'b0), .A2(1'b0), .WP(1'b0), .SDA(Sda), .SCL(Scl), .RESET(!Rst_n) ); `endif //系统时钟产生 initial Clk = 1'b1; always #(`CLK_PERIOD/2)Clk = ~Clk; initial begin Rst_n = 0; Word_addr = 0; Wr = 0; Wr_data = 0; Rd = 0; #(`CLK_PERIOD*200 + 1) Rst_n = 1; #200; `ifdef TEST_M24LC64 //仿真验证 24LC64 模型 //写入 20 组数据 Word_addr = 0; Wr_data = 0; repeat(20)begin Wr = 1'b1; #(`CLK_PERIOD); Wr = 1'b0; repeat(NUM)begin //在写数据有效前给待写入数据 @(posedge Wr_data_vaild) Wr_data = Wr_data + 1; end @(posedge Done); #2000; Word_addr = Word_addr + NUM; end #2000; //读出刚写入的 20 组数据 Word_addr = 0; repeat(20)begin Rd = 1'b1; #(`CLK_PERIOD); Rd = 1'b0; @(posedge Done); #2000; Word_addr = Word_addr + NUM; end `elsif TEST_M24LC04 //仿真验证 24LC04 模型 //写入 20 组数据 Word_addr = 100; Wr_data = 100; repeat(20)begin Wr = 1'b1; #(`CLK_PERIOD); Wr = 1'b0; repeat(NUM)begin //在写数据有效前给待写入数据 @(posedge Wr_data_vaild) Wr_data = Wr_data + 1; end @(posedge Done); #2000; Word_addr = Word_addr + NUM; end #2000; //读出刚写入的 20 组数据 Word_addr = 100; repeat(20)begin Rd = 1'b1; #(`CLK_PERIOD); Rd = 1'b0; @(posedge Done); #2000; Word_addr = Word_addr + NUM; end `endif #5000; $stop; end endmodule在 testbench 文件中,通过对 EEPROM 模型进行 20 写操作,每次写字节数为NUM,然后对 EEPROM 模型在刚写入数据的地址段进行读操作,通过比较读出和写入的数据验证 I2C 控制器设计是否正确。这里分别通过申明选择 TEST_M24LC64 或TEST_M24LC04 来作为当前的仿真模型。如图 30.19 所示为 2 字节地址的 EEPROM模型 24LC64 仿真结果。图 30.20 和图 30.21 分别为型号 24LC64 仿真模型写操作时序和读操作时序放大后的波形图。 图片 图片 同样的方式选择 24LC04 型号 EEPROM 模型进行仿真,如图 30.22 所示为 1 字节地址的 EEPROM 模型 24LC604 仿真结果。图 30.23 和图 30.24 分别为型号24LC604 仿真模型写操作时序和读操作时序放大后的波形图。 图片 通过观察图 30.21 和图 30.24 的时序波形发现,在读操作时序结果中,读出的数据中某些位是高阻态,仔细观察波形可知,高阻态的位置正好是需要输出高电平的位置,这个的原因是 EEPROM 的仿真模型是完全与实际的器件是一样的,对于器件来说,只在输出 0 时将数据线拉低,而在高阻态或本应该为高电平的时刻都是设置为高阻态的,这个在仿真模型的代码中也有体现,具体体现这一点的代码如下: bufif1 (SDA, 1'b0, SDA_DriveEnableDlyd);图片 其中,器件地址包括器件的地址字节数和 3 位的器件地址,具体分配如下: 图片 功能码主要是区分是写数据操作还是读数据操作,为了方便,我们直接规定,功能码为 0xf1 表示写数据操作,0xf2 表示读数据操作;起始地址是我们要读写数据的第一个地址;数据字节数表示要写入或读取的数据的字节个数,后面的数据 1 到数据n 表示要写入的 n 个数据,对于读操作没有这部分。如图 30.25 为该实验整体的设计框图。 图片 有关串口发送和接收以及 fifo 模块在前面章节都已经进行了讲解,这里就不重复讲解了,这里重点讲解命令解析模块的设计,命令解析模块的主要作用是对串口接收的数据进行解析,通过对接收的数据进行解析分析判断出是进行何种操作。根据我们自己规定的数据协议,进行如下的设计,首先我们将串口发送的数据的前 4 个数据存入一个缓冲区数据内,通过对功能码识别判断是写操作还是读操作,如果是写操作,就将后面待写入的数据存入 fifo 中;同时将器件地址、地址字节数、起始地址、数据字节数赋值给 I2C 对应的信号线;如果是读操作,就在前 4 个字节接收完成后将器件地址、地址字节数、起始 地址、数据字节数赋值给 I2C 对应的信号线,同时给 I2C 控制器模块的读使能给一个时钟周期的门控信号,使能 I2C 的读操作。读出的数据同样也是先存放在另外一个 fifo 中,然后送给串口发送模块发出。具体实现代码如下: module cmd_analysis( Clk, Rst_n, Rx_done, Rx_data, Wfifo_req, Wfifo_data, Rddata_num, Wrdata_num, Wdaddr_num, Device_addr, Word_addr, Rd ); input Clk; //系统时钟 input Rst_n; //系统复位 input Rx_done; //串口接收一字节数据完成 input[7:0] Rx_data; //串口接收一字节数据 output reg Wfifo_req; //写 fifo 请求信号 output reg[7:0] Wfifo_data; //写 fifo 数据 output reg[5:0] Rddata_num; //I2C 总线连续读取数据字节数 output reg[5:0] Wrdata_num; //I2C 总线连续读取数据字节数 output reg[1:0] Wdaddr_num; //I2C 器件数据地址字节数 output reg[2:0] Device_addr; //EEPROM 器件地址 output reg[15:0] Word_addr; //EEPROM 寄存器地址 output reg Rd; //EEPROM 读请求信号 reg [7:0] buff_data[4:0];//串口接收数据缓存器 //串口接收数据计数器 reg [7:0]byte_cnt; always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) byte_cnt <= 8'd0; else if(Rx_done && byte_cnt==8'd4)begin if(buff_data[1]==8'hf2) //读数据指令 byte_cnt <= 8'd0; else if(buff_data[1]==8'hf1) //写数据指令 byte_cnt <= byte_cnt + 8'd1; else byte_cnt <= 8'd0; //错误指令 end else if(Rx_done)begin if(byte_cnt == 8'd4 + buff_data[4]) byte_cnt <= 8'd0; else byte_cnt <= byte_cnt + 8'd1; end else byte_cnt <= byte_cnt; end //串口接收数据缓存器 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n)begin buff_data[0] <= 8'h00; buff_data[1] <= 8'h00; buff_data[2] <= 8'h00; buff_data[3] <= 8'h00; buff_data[4] <= 8'h00; end else if(Rx_done && byte_cnt<5) buff_data[byte_cnt] <= Rx_data; else ; end //写 fifo 请求信号 Wfifo_req always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Wfifo_req <= 1'b0; else if(byte_cnt >8'd4 && Rx_done) Wfifo_req <= 1'b1; else Wfifo_req <= 1'b0; end //写 fifo 数据 Wfifo_data always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Wfifo_data <= 8'd0; else if(byte_cnt > 8'd4 && Rx_done) Wfifo_data <= Rx_data; else Wfifo_data <= Wfifo_data; end //EEPROM 读请求信号 Rd always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Rd <= 1'b0; else if(byte_cnt == 8'd4 && Rx_done && buff_data[1]==8'hf2) Rd <= 1'b1; else Rd <= 1'b0; end //指令完成标志位 reg cmd_flag; always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) cmd_flag <= 1'b0; else if((byte_cnt == 8'd4)&& Rx_done) cmd_flag <= 1'b1; else cmd_flag <= 1'b0; end //EEPROM 读写数据、寄存器地址字节数,器件地址,寄存器地址 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n)begin Rddata_num <= 6'd0; Wrdata_num <= 6'd0; Wdaddr_num <= 2'd0; Device_addr <= 3'd0; Word_addr <= 16'd0; end else if(cmd_flag == 1'b1)begin Rddata_num <= buff_data[4][5:0]; Wrdata_num <= buff_data[4][5:0]; Wdaddr_num <= buff_data[0][5:4]; Device_addr <= buff_data[0][2:0]; Word_addr <= {buff_data[2],buff_data[3]}; end else ; end endmodule下面编写 testbench 测试文件对设计的命令解析模块进行仿真验证,该仿真主要是分别模拟发送写数据操作和读数据操作指令,来观察相应的输出时序波形结果。通过仿真时序结果可以对该模块进行优化改进,具体的 testbench 文件如下: `timescale 1ns/1ns `define CLK_PERIOD 20 module cmd_analysis_tb; reg Clk; reg Rst_n; reg Rx_done; reg [7:0] Rx_data; wire Wfifo_req; wire[7:0] Wfifo_data; wire[5:0] Rddata_num; wire[5:0] Wrdata_num; wire[1:0] Wdaddr_num; wire[2:0] Device_addr; wire[15:0] Word_addr; wire Rd; reg [15:0] addr; reg [7:0] data_num; reg [7:0] wr_data; reg [39:0] wdata_cmd; reg [39:0] rdata_cmd; cmd_analysis cmd_analysis( .Clk(Clk), .Rst_n(Rst_n), .Rx_done(Rx_done), .Rx_data(Rx_data), .Wfifo_req(Wfifo_req), .Wfifo_data(Wfifo_data), .Rddata_num(Rddata_num), .Wrdata_num(Wrdata_num), .Wdaddr_num(Wdaddr_num), .Device_addr(Device_addr), .Word_addr(Word_addr), .Rd(Rd) ); //写 FIFO 模块例化 fifo_wr wr( .clock(Clk), .data(Wfifo_data), .rdreq(), .wrreq(Wfifo_req), .empty(), .full(), .q(), .usedw() ); //系统时钟产生 initial Clk = 1'b1; always #(`CLK_PERIOD/2)Clk = ~Clk; initial begin Rst_n = 0; Rx_done = 0; Rx_data = 0; addr = 0; data_num = 0; wr_data = 0; wdata_cmd = 0; rdata_cmd = 0; #(`CLK_PERIOD*200 + 1) Rst_n = 1; #200; addr = 0; data_num = 4; wr_data = 0; send_uart_data_wr; //写数据 #500; send_uart_data_rd; //读数据 #500; addr = 4; data_num = 8; wr_data = 20; send_uart_data_wr; //写数据 #500; send_uart_data_rd; //读数据 #500; $stop; end //串口发送写数据命令和待写入数据任务 task send_uart_data_wr; begin //写数据指令 wdata_cmd = {8'h21,8'hf1,addr[15:8],addr[7:0],data_num}; //发送写数据指令 repeat(5)begin Rx_done = 1; Rx_data = wdata_cmd[39:32]; #(`CLK_PERIOD) Rx_done = 0; #500; wdata_cmd = {wdata_cmd[31:0],8'h00}; end //待写入数据 Rx_data = wr_data; repeat(data_num)begin Rx_done = 1; Rx_data = Rx_data + 1; #(`CLK_PERIOD) Rx_done = 0; #500; end end endtask //串口发送读数据命令任务 task send_uart_data_rd; begin //读数据指令 rdata_cmd = {8'h21,8'hf2,addr[15:8],addr[7:0],data_num}; //发送读数据指令 repeat(5)begin Rx_done = 1; Rx_data = rdata_cmd[39:32]; #(`CLK_PERIOD) Rx_done = 0; #500; rdata_cmd = {rdata_cmd[31:0],8'h00}; end end endtask endmodule仿真过程主要是模拟命令解析模块接收到写或读 EEPROM 操作指令后的操作是否和我们设计想要达到的目标是否一致。这里的写或读数据指令均采用任务的形式,写数据指令下待写入的数据是采用给定一个值的基础上递增进行赋值的。命令解析模块仿真的结果如图 30.26 所示。 图片 根据波形时序图,在模拟发送写操作命令 0x21,0xf1,0x00,0x00,0x04,0x06,0x07,0x08,0x09 时,在接收完数据字节数这个数据后,后面收到的数据就存入到 fifo 中去了,与我们设计的是一致的,同理可以分析读数据操作命令,也是没有问题的,这样命令解析模块就设计完成了。 下面就是整个系统的设计,如图 30.25 整体设计框图中,在 I2C 写数据操作之前和读数据后分别加入了 fifo 模块,因为串口读写速度和 I2C 读写速度不一样,在这之间加入的 fifo 模块具有读写时钟不一致的特点,可以对数据进行一个缓存,这样就能解决前后速度不一样的问题,这里的两个 fifo 均设置的是读取数据在读请求前有效,这样设计的目的是为了与其他模块待输入数据与使能信号相匹配,里面的 fifo模块都是通过 QuartusII 软件生成的 IP 核,fifo 输入输出数据位宽均设置为 8位,深度设置为 64(多字节读取最多支持 32 字节,稍大于这个数就可以了)。在各模块均设计完成后,整个系统的顶层电路设计就显得比较简单了,根据设计的系统框图进行整合就可以了。整个系统设计的代码如下: module uart_eeprom( Clk, Rst_n, Uart_rx, Uart_tx, Sda, Scl ); parameter Baud_set = 3'd4;//波特率设置,这里设置为 115200 input Clk; //系统时钟 input Rst_n; //系统复位 input Uart_rx; //串口接收 output Uart_tx; //串口发送 inout Sda; //I2C 时钟线 output Scl; //I2C 数据线 wire [7:0] Rx_data; //串口接收一字节数据 wire Rx_done; //串口接收一字节数据完成 wire wfifo_req; //写 FIFO 模块写请求 wire [7:0] wfifo_data; //写 FIFO 模块写数据 wire [5:0] wfifo_usedw; //写 FIFO 模块已写数据量 wire [5:0] rfifo_usedw; //读 FIFO 模块可读数据量 wire rfifo_rdreq; //读 FIFO 模块读请求 wire [5:0] Rddata_num; //I2C 总线连续读取数据字节数 wire [5:0] Wrdata_num; //I2C 总线连续写取数据字节数 wire [1:0] Wdaddr_num; //EEPROM 数据地址字节数 wire [2:0] Device_addr; //EEPROM 地址 wire [15:0] Word_addr; //EEPROM 寄存器地址 wire Wr; //EEPROM 写使能 wire [7:0] Wr_data; //EEPROM 写数据 wire Wr_data_vaild;//EEPROM 写数据有效标志位 wire Rd; //EEPROM 读使能 wire [7:0] Rd_data; //EEPROM 读数据 wire Rd_data_vaild;//EEPROM 读数据有效标志位 wire Done; //EEPRO 读写完成标识位 wire tx_en; //串口发送使能 wire [7:0] tx_data; //串口待发送数据 wire tx_done ; //一次串口发送完成标志位 //串口接收模块例化 uart_byte_rx uart_rx( .Clk(Clk), .Rst_n(Rst_n), .Rs232_rx(Uart_rx), .baud_set(Baud_set), .Data_Byte(Rx_data), .Rx_Done(Rx_done) ); //指令解析模块例化 cmd_analysis cmd_analysis( .Clk(Clk), .Rst_n(Rst_n), .Rx_done(Rx_done), .Rx_data(Rx_data), .Wfifo_req(wfifo_req), .Wfifo_data(wfifo_data), .Rddata_num(Rddata_num), .Wrdata_num(Wrdata_num), .Wdaddr_num(Wdaddr_num), .Device_addr(Device_addr), .Word_addr(Word_addr), .Rd(Rd) ); //写缓存 fifo 模块例化 fifo_wr fifo_wr( .clock(Clk), .data(wfifo_data), .rdreq(Wr_data_vaild), .wrreq(wfifo_req), .empty(), .full(), .q(Wr_data), .usedw(wfifo_usedw) ); //EEPROM 写使能 assign Wr = (wfifo_usedw == Wrdata_num)&& (wfifo_usedw != 6'd0); //I2C 控制模块例化 I2C I2C( .Clk(Clk), .Rst_n(Rst_n), .Rddata_num(Rddata_num), .Wrdata_num(Wrdata_num), .Wdaddr_num(Wdaddr_num), .Device_addr(Device_addr), .Word_addr(Word_addr), .Wr(Wr), .Wr_data(Wr_data), .Wr_data_vaild(Wr_data_vaild), .Rd(Rd), .Rd_data(Rd_data), .Rd_data_vaild(Rd_data_vaild), .Scl(Scl), .Sda(Sda), .Done(Done) ); //读缓存 fifo 模块例化 fifo_rd fifo_rd( .clock(Clk), .data(Rd_data), .rdreq(rfifo_rdreq), .wrreq(Rd_data_vaild), .empty(), .full(), .q(tx_data), .usedw(rfifo_usedw) ); //串口发送使能 assign tx_en = ((rfifo_usedw == Rddata_num)&&Done)|| ((rfifo_usedw < Rddata_num)&& (rfifo_usedw >0)&&tx_done); //读 FIFO 模块读请求 assign rfifo_rdreq = tx_en; //串口发送模块例化 uart_byte_tx uart_tx( .Clk(Clk), .Rst_n(Rst_n), .send_en(tx_en), .baud_set(Baud_set), .Data_Byte(tx_data), .Rs232_Tx(Uart_tx), .Tx_Done(tx_done), .uart_state() ); endmodule下面对设计的整个系统进行编写 testbench 文件来仿真验证,整个仿真主要是通过串口发送模块模拟对该系统发送指令进行仿真验证,这里就只选用 M24LC64 这个仿真模型进行仿真,M24LC04 的仿真模型类似(读者可尝试对该模型进行仿真),编写的 testbench 文件具体代码如下: `timescale 1ns/1ns `define CLK_PERIOD 20 module uart_eeprom_tb; reg Clk; reg Rst_n; reg tx_en; reg [7:0] tx_data; wire tx_done; wire Uart_rx; wire Uart_tx; wire Sda; wire Scl; reg [15:0] addr; reg [7:0] data_num; reg [7:0] wr_data; reg [39:0] wdata_cmd; reg [39:0] rdata_cmd; localparam Baud_set = 3'd4; //波特率设置,这里设置为 115200 localparam DevAddr = 3'b000;//I2C 器件的器件地址 localparam WdAr_NUM = 2'd2; //I2C 器件的存储器地址字节数 //串口发送模块例化 uart_byte_tx uart_tx( .Clk(Clk), .Rst_n(Rst_n), .send_en(tx_en), .baud_set(Baud_set), .Data_Byte(tx_data), .Rs232_Tx(Uart_rx), .Tx_Done(tx_done), .uart_state() ); //串口读写 EEPROM 模块例化 uart_eeprom #(.Baud_set(Baud_set)) uart_eeprom( .Clk(Clk), .Rst_n(Rst_n), .Uart_rx(Uart_rx), .Uart_tx(Uart_tx), .Sda(Sda), .Scl(Scl) ); //EEPROM 模型例化 M24LC64 M24LC64( .A0(1'b0), .A1(1'b0), .A2(1'b0), .WP(1'b0), .SDA(Sda), .SCL(Scl), .RESET(!Rst_n) ); //系统时钟产生 initial Clk = 1'b1; always #(`CLK_PERIOD/2)Clk = ~Clk; initial begin Rst_n = 0; tx_data = 0; tx_en = 0; addr = 0; data_num = 0; wr_data = 0; wdata_cmd = 0; rdata_cmd = 0; #(`CLK_PERIOD*200 + 1) Rst_n = 1; #200; addr = 0; data_num = 4; wr_data = 0; send_uart_data_wr;//写数据 @(posedge uart_eeprom.I2C.Done); #500; send_uart_data_rd;//读数据 @(posedge uart_eeprom.I2C.Done); #500; addr = 4; data_num = 8; wr_data = 20; send_uart_data_wr;//写数据 @(posedge uart_eeprom.I2C.Done); #500; send_uart_data_rd;//读数据 @(posedge uart_eeprom.I2C.Done); //从 EEPROM 读出的数据串口发送出去,等待发送完成 repeat(data_num)begin @(posedge uart_eeprom.tx_done); end #5000; $stop; end //串口发送写数据命令和待写入数据任务 task send_uart_data_wr; begin //写数据指令 wdata_cmd = {{2'b00,WdAr_NUM,1'b0,DevAddr},8'hf1, addr[15:8],addr[7:0],data_num}; //发送写数据指令 repeat(5)begin tx_en = 1; tx_data = wdata_cmd[39:32]; #(`CLK_PERIOD) tx_en = 0; @(posedge tx_done) #100; wdata_cmd = {wdata_cmd[31:0],8'h00}; end //待写入数据 tx_data = wr_data; repeat(data_num)begin tx_en = 1; tx_data = tx_data + 1; #(`CLK_PERIOD) tx_en = 0; @(posedge tx_done) #100; end end endtask //串口发送读数据命令任务 task send_uart_data_rd; begin //读数据指令 rdata_cmd = {{2'b00,WdAr_NUM,1'b0,DevAddr},8'hf2, addr[15:8],addr[7:0],data_num}; //发送读数据指令 repeat(5)begin tx_en = 1; tx_data = rdata_cmd[39:32]; #(`CLK_PERIOD) tx_en = 0; @(posedge tx_done) #100; rdata_cmd = {rdata_cmd[31:0],8'h00}; end end endtask endmodule仿真过程主要是通过串口发送模块模拟对该系统发送读写指令进行仿真验证,分别进行了 2 次写和读指令的发送,读指令主要是对刚写入地址的数据进行读出,我们可以通过观察时序波形图,比较写入数据与读出数据是否一致来验证系统设计的正确性。如图 30.27 为系统仿真波形时序图。 图片 分别对一次写数据指令和一次读数据指令的波形进行放大后观察分析,如图 30.28 和图30.29 分别为一次对 EEPROM 写数据过程和读数据过程的波形时序图。 图片 这次写数据过程的仿真是通过串口发送模块模拟发送指令数据 0x21,0xf1,0x00,0x00,0x04,0x05,0x06,0x07,0x08,向 EEPROM 中起始地址为 0 开始写入 0x05,0x06,0x07,0x08 四个数据,可以通过观察图 30.28 的中 SDA 和 SCL 波形图分析得知,写入的数据确实是这四个数据,说明系统中串口写 EEPROM 部分是没有问题的。 读数据过程的仿真是通过串口发送模块模拟发送指令数据 0x21,0xf2,0x00,0x00,0x04,向 EEPROM 中起始地址为 0 开始读出四个数据,通过观察图 30.29 的中 SDA和 SCL 波形图分析得知,读出的四个数据为 0x05,0x06,0x07,0x08,与之前在这些地址写入的数据是一致的,说明这次的读数据时没有问题的,同样的方式经过多次的验证,串口读写 EEPROM 系统是可以正常工作的。仿真验证进行完成后,接下来就是进行板级验证,先是引脚的分配,本实验板级验证平台是 AC620 开发板,根据开发板的引脚分配表对本实验所用引脚进行分配。如图 30.30 是 AC620 开发板上 EEPROM 部分的硬件原理图,在引脚分配之前,是需要对这一块硬件电路有所了解的。 图片 细心的读者会发现,I2C 时钟线 SCL 和 I2C 数据线没有进行硬件上拉处理,与前面讲解的需要上拉处理不一样,可能会猜想是硬件设计的问题。这里我说明一下,硬件设计是没有问题的,因为对于 FPGA 是可以通过软件对引脚进行上拉处理的,这个也是本实验包含的一个知识点。通过 Quartus II 软件将管脚设置为上拉电阻(弱上拉)的方法,具体的步骤如下: 1.在菜单 Assignments 中选择 Pin Planner,也可以直接点击面板上引脚分配的图标 图片 2.这样进入引脚分配的界面,在弹出的 Pin Planner 界面的 All Pins 区域里点击鼠标右键,找到 Customize Columns。 图片 在弹出的 Customize Columns 对 话 框的 左 列表 框 选 择 Weak Pull-Up Resistor,再点击,把 Weak Pull-Up Resistor 添加到右列表框,这样在 Pin Planner 的 All Pins 区域里就有一列 Weak Pull-Up Resistor 的设置项。 图片 再把需要上拉的 SDA 和 SCL 在其对应的 Weak Pull-Up Resistor 列的位置双极鼠标左键,就会弹出一个 Off/On 的选项,选上 On 就可以了。最后完成后的设置如下: 图片 引脚分配和上拉设置完成后,对我们设计的系统顶层文件进行综合布局布线生成 sof 下载文件,然后下载到 AC620 实验平台进行板级验证。板级验证需要用到串口软件工具, 这里使用的是名叫格西烽火的串口工具,选择对应的开发板的串口号和波特率,系统设计的波特率在顶层文件 uart_eeprom 中可进行设置,这里我们设置的波特率为115200bps。 板级验证时,我们先往 EEPROM 里写入一些数据,也就是在串口发送 6 组数据,每组数据写入四个数据;写完后发送读数据命令,读出写入的数据,分两次读,一次读 20个数据,一次读 4 个数据,具体的发送读写指令操作和串口接收的数据如下图: 图片 从串口发送和接受的数据分析可得,从 EEPROM 读出的 20 个数据和写入的 20 个数据是一样的,这就说明,设计的整个系统是工作正常的,读者可以多次进行多组测试来验证设计的完整性,整个的测试还可以利用 Quartus II 软件中的 SignalTap II Logic Analyzer 工具对 SDA 和 SCL 的波形进行抓取分析系统设计的正确性,这里就不详细的说明了,读者可以自己进行尝试。整个串口读写 EEPROM 的系统设计就算完成了,里面还有很多需要完善的地方,读者可以在学习完成后,对本实验进行改进和拓展。 本节小结 本节主要从二线制 I2C 协议的基本知识和概念、 I2C 器件之间数据通信过程,比较全面的了解了 I2C 协议,并以此设计一个可进行读写操作的 I2C 控制器,结合前面设计的串口收发模块和 FIFO 模块设计了一个简易应用,实现了串口对 EEPROM 存储器的读写功能,并进行相应的板级验证。读者可以在此基础上进行一定的优化和拓展,AC620实验开发板上还有音频模块和时钟模块挂在在 I2C 总线上,读者可以利用这些模块实现更丰富的应用
FPGA&ASIC
# ASIC/FPGA
# 小实验
刘航宇
3年前
0
1,975
6
2022-12-18
【FPGA】深度理解串口发送模块设计与验证
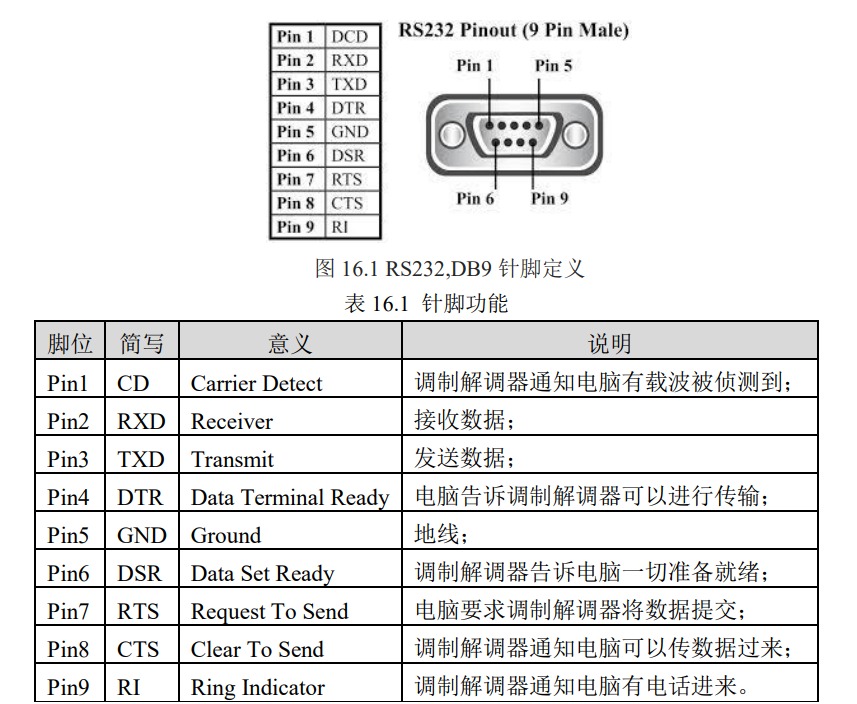
摘要本文介绍了UART通信原理及电路设计,使用FPGA实现UART通信中的数据发送部分设计,并通过仿真和板级验证确保其功能正确性。关键词:FPGA, UART通信, 串口发送模块, 串口发送设计, 异步串行通信本章导读 在当今的电子系统中,经常需要板内、板间或者下位机与上位机之间进行数据的发送与接收,这就需要双方共同遵循一定的通信协议来保证数据传输的正确性。常见的协议有UART(通用异步收发传输器)、IIC(双向两线总线)、SPI(串行外围总线)、USB2.0/3.0(通用串行总线)以及 Ethernet(以太网)等。在这些协议当中,最为基础的就是 UART,因其电路结构简单、成本较低,所以在注重性价比的情况下,使用非常广泛。 本章将学习 UART 通信的原理及其硬件电路设计,并使用 FPGA 来实现 UART 通信中的数据发送部分设计。在仿真验证时除进行正常的功能仿真以外,还将在 Quartus Prime 中使用 In system sources and probes editor(ISSP)工具进行板级验证,具体方法是:输入需要通过串口发送出去的数据,然后通过按下 AC620 开发板上的按键来控制 FPGA 将待发送的数据发送出去,并在串口助手中查看 PC 端接收到的数据。 目录 本章导读 异步串行通信原理及电路设计RS232 通信接口标准 UART 关键参数及时序图 RS232 通信电路设计 UART 异步串行通信发送模块设计与实现串口发送模块接口设计 波特率时钟生成模块设计 数据输出模块设计 数据传输状态控制模块设计 激励创建及仿真测试 按键控制串口发送设计 代码工程 异步串行通信原理及电路设计 RS232 通信接口标准 通用异步收发传输器(Universal Asynchronous Receiver/Transmitter,UART)是一种异步收发传输器,其在数据发送时将并行数据转换成串行数据来传输,在数据接收时将接收到的串行数据转换成并行数据,可以实现全双工传输和接收。它包括了 RS232、RS449、RS423、RS422 和 RS485 等接口标准规范和总线标准规范。换句话说,UART 是异步串行通信的总称。而 RS232、RS449、RS423、RS422 和 RS485 等,是对应各种异步串行通信口的接口标准和总线标准,它们规定了通信口的电气特性、传输速率、连接特性和接口的机械特性等内容。 本章要重点学习的 RS-232 是美国电子工业联盟(EIA)制定的串行数据通信的接口标准,原始编号全称是 EIA-RS-232(简称 232,RS232),被广泛用于计算机串行接口外设连接。其 DB9 接口的针脚定义如图 16.1 所示,引脚功能如表 16.1 所示。若系统存在多个 UART接口,则可分别称为 COM1、COM2 等。 图片 UART 关键参数及时序图 UART 通信在使用前需要做多项设置,最常见的设置包括数据位数、波特率大小、奇偶校验类型和停止位数。 数据位(Data bits):该参数定义单个 UART 数据传输在开始到停止期间发送的数据位数。可选择为:5、6、7 或者 8(默认)。 波特率(Baud):是指从一设备发到另一设备的波特率,即每秒钟可以通信的数据比特个数。典型的波特率有 300, 1200, 2400, 9600, 19200, 115200 等。一般通信两端设备都要设为相同的波特率,但有些设备也可设置为自动检测波特率。 奇偶校验类型(Parity Type):是用来验证数据的正确性。奇偶校验一般不使用,如果使用,则既可以做奇校验(Odd)也可以做偶校验(Even)。在偶校验中,因为奇偶校验位会被相应的置 1 或 0(一般是最高位或最低位),所以数据会被改变以使得所有传送的数位(含字符的各数位和校验位)中“1”的个数为偶数;在奇校验中,所有传送的数位(含字符的各数位和校验位)中“1”的个数为奇数。奇偶校验可以用于接受方检查传输是否发送生错 误,如果某一字节中“1”的个数发生了错误,那么这个字节在传输中一定有错误发生。如果奇偶校验是正确的,那么要么没有发生错误,要么发生了偶数个的错误。如果用户选择数据长度为 8 位,则因为没有多余的比特可被用来作为奇偶校验位,因此就叫做“无奇偶校验(Non)”。 停止位(Stop bits):在每个字节的数据位发送完成之后,发送停止位,来标志着一次数据传输完成,同时用来帮助接受信号方硬件重同步。可选择为:1(默认)、1.5 或者 2 位。 在 RS-232 标准中,最常用的配置是 8N1(即八个数据位、无奇偶校验、一个停止位),其发送一个字节时序图如图 16.2 所示。 按照一个完整的字节包括一位起始位、8 位数据位、一位停止位即总共十位数据来算,要想完整的实现这十位数据的发送,就需要 11 个波特率时钟脉冲,第 1 个脉冲标记一次传输的起始,第 11 个脉冲标记一次传输的结束,如下所示: 图片 RS232 通信电路设计 RS232 通信协议需要一定的硬件支持,早期大多使用的方案是 RS232 转 TTL,这时需要 MAX232 或者 SP3232 等电平转换芯片来做数据转换。其外围电路简单,最少只需要 4 个电容即可正常工作,其典型电路图如 16.3 所示。在这里只使用了两路通信中的一路,且通过加入的 D7、D8 两个发光二极管可以更好的观察数据状态。 图片 现在系统集成度越来越高,DB9 的 RS232 接口占用 PCB 面积过大,多数系统已经转用USB 转 TTL,其电路图如图 16.4 所示。 图片 CH340G 是一个支持 5V 或 3.3V 供电的 USB 总线的转接芯片,实现 USB 转串口、USB 转 IrDA 红外或者 USB 转打印口。支持硬件全双工串口、内置收发缓冲区,支持通讯波特率 50bps~2Mbps 并支持常用的 MODEM 联络信号 RTS、DTR、DCD、RI、DSR、CTS。 并可通过外加电平转换器件,可以提供 RS232、RS485、RS422 等接口。在 Windows 操作系统下,CH340 的驱动程序能够仿真标准串口,所以与绝大部分原串口应用程序完全兼容,不需要作任何修改。 UART 异步串行通信发送模块设计与实现 串口发送模块接口设计 基于上述原理,本章要实现的串口发送模块整体框图,如图 16.9 所示,其接口列表如表 16.2 所示。 图片 根据功能需求,串口发送模块可进一步细化为如图 16.10 所示详细结构图,其中每一子模块的作用如表 16.3 所示。其中绿色的框代表单一结构的寄存器,来实现数据的稳定输入以及输出。 图片 图片 波特率时钟生成模块设计 从原理部分可知,波特率是 UART 通信中需要设置的参数之一。在波特率时钟生成模块中,计数器需要的计数值与波特率之间的关系如表 16.4 所示,其中系统时钟周期为System_clk_period,这里为 20ns。如果接入到该模块的时钟频率为其他值,需要根据具体的频率值修改该参数。 图片 本模块的设计是为了保证模块的复用性。当需要不同的波特率时,只需设置不同的波特率时钟计数器的计数值。使用查找表即可实现,下面的设计代码中只包含了针对 5 个波特率的设置,如需要其他波特率可根据实际使用情况具体修改。 reg [15:0]bps_DR;//分频计数最大值 always@(posedge Clk or negedge Rst_n) if(!Rst_n) bps_DR <= 16'd5207; else begin case(baud_set) 0:bps_DR <= 16'd5207; //9600bps 1:bps_DR <= 16'd2603; //19200bps 2:bps_DR <= 16'd1301; //38400bps 3:bps_DR <= 16'd867; //57600bps 4:bps_DR <= 16'd433; //115200bps default:bps_DR <= 16'd5207; endcase end利用计数器来生成波特率时钟。 reg bps_clk; //波特率时钟 reg [15:0]div_cnt;//分频计数器 always@(posedge Clk or negedge Rst_n) if(!Rst_n) div_cnt <= 16'd0; else if(uart_state)begin if(div_cnt == bps_DR) div_cnt <= 16'd0; else div_cnt <= div_cnt + 1'b1; end else div_cnt <= 16'd0; always@(posedge Clk or negedge Rst_n) if(!Rst_n) bps_clk <= 1'b0; else if(div_cnt == 16'd1) bps_clk <= 1'b1; else bps_clk <= 1'b0;所谓波特率生成,就是用一个定时器来定时,产生频率与对应波特率时钟频率相同的时钟信号。例如,我们使用波特率为 115200bps,则我们需要产生一个频率为 115200Hz 的时钟信号。那么如何产生这样一个 115200Hz 的时钟信号呢?这里,我们首先将 115200Hz 时钟信号的周期计算出来,1 秒钟为 1000_000_000ns,因此波特率时钟的周期 Tb= 1000000000/115200 =8680.6ns,即115200信号的一个周期为8680.6ns,那么,我们只需要设定我们的定时器定时时间为8680.6ns,每当定时时间到,产生一个系统时钟周期长度的高脉冲信号即可。系统时钟频率为 50MHz,即周期为 20ns,那么,我们只需要计数 8680/20 个系统时钟,就可获得 8680ns 的定时,bps115200=Tb/Tclk - 1=Tb*fclk - 1=fclk/115200-1。相应的,其它波特率定时值的计算与此相同为了能够通过外部控制波特率,设计中使用了一个 3 位的波特率选择端口:Baud_Set。通过给此端口不同的值,就能选择不同的波特率,此端口控制不同波特率的原理很简单,就是一个多路选择器,多路选择器通过选择不同的定时器计数最大值来设置不同的比特率时钟频率。 Baud_Set 的值与各波特率的对应关系如下: 000 : 9600bps; 001 : 19200bps; 010 :38400bps; 011 :57600bps; 100 :115200bps; 数据输出模块设计 通过对波特率时钟进行计数,来确定数据发送的循环状态。 reg [3:0]bps_cnt;//波特率时钟计数器 always@(posedge Clk or negedge Rst_n) if(!Rst_n) bps_cnt <= 4'd0; else if(bps_cnt == 4'd11) bps_cnt <= 4'd0; else if(bps_clk) bps_cnt <= bps_cnt + 1'b1; else bps_cnt <= bps_cnt;同样为了使得模块可以对其他模块进行控制或者调用,这里产生一个 byte 传送结束的信号。一个数据位传输结束后 Tx_done 信号输出一个时钟的高电平。 always@(posedge Clk or negedge Rst_n) if(!Rst_n) Tx_Done <= 1'b0; else if(bps_cnt == 4'd11) Tx_Done <= 1'b1; else Tx_Done <= 1'b0;产生数据传输状态信号,即当在正常传输的时候 uart_state 信号为高电平,其他情况均为低电平。这里实现的电路结构同样是具有优先级顺序的,但与 C 语言本质是不同的。在图16.10 中的 MUX2_1 与 MUX2_2 就是下面的设计实现的 if—else if—else 的电路结构。 always@(posedge Clk or negedge Rst_n) if(!Rst_n) uart_state <= 1'b0; else if(send_en) uart_state <= 1'b1; else if(bps_cnt == 4'd11) uart_state <= 1'b0; else uart_state <= uart_state;由于 RS232 是一个异步的收发器,因此为了保证发送的数据在时钟到来的时候是稳定的,这里也需要对输入数据进行寄存。 reg [7:0]r_data_byte; always@(posedge Clk or negedge Rst_n) if(!Rst_n) r_data_byte <= 8'd0; else if(send_en) r_data_byte <= data_byte; else r_data_byte <= r_data_byte;数据传输状态控制模块设计 在模块结构图 16.10 中还有一个十选一多路器 ,作用是根据 bps_cnt 的值来确定数据传输的状态。如时序图 16.2 所示,在不同的波特率时钟计数值时,有对应的传输数据。 localparam START_BIT = 1'b0; localparam STOP_BIT = 1'b1; always@(posedge Clk or negedge Rst_n) if(!Rst_n) Rs232_Tx <= 1'b1; else begin case(bps_cnt) 0:Rs232_Tx <= 1'b1; 1:Rs232_Tx <= START_BIT; 2:Rs232_Tx <= r_data_byte[0]; 3:Rs232_Tx <= r_data_byte[1]; 4:Rs232_Tx <= r_data_byte[2]; 5:Rs232_Tx <= r_data_byte[3]; 6:Rs232_Tx <= r_data_byte[4]; 7:Rs232_Tx <= r_data_byte[5]; 8:Rs232_Tx <= r_data_byte[6]; 9:Rs232_Tx <= r_data_byte[7]; 10:Rs232_Tx <= STOP_BIT; default:Rs232_Tx <= 1'b1; endcase end激励创建及仿真测试 完成设计之后,需要对其进行功能仿真。在下面的 testbench 文件中,生成了复位信号以及使能信号、待传输数据。这里将所有数据变化与系统时钟错开 1ns,是为了能更清楚看到输入输出数据与时钟的时序关系。 initial begin Rst_n = 1'b0; data_byte = 8'd0; send_en = 1'd0; baud_set = 3'd4; #(`clk_period*20 + 1 ) Rst_n = 1'b1; #(`clk_period*50); data_byte = 8'haa; send_en = 1'd1; #`clk_period; send_en = 1'd0; @(posedge Tx_Done) #(`clk_period*5000); data_byte = 8'h55; send_en = 1'd1; #`clk_period; send_en = 1'd0; @(posedge Tx_Done) #(`clk_period*5000); $stop; end设置好仿真脚本后进行功能仿真,得到如图 16.11 所示的波形文件,可以看出在复位信号置高以及使能信号有效之前输出信号 Rs232_Tx 均为 0,在复位结束以及使能后输出信号才开始正常,且当输入数据为 10101010b(MSB)后,输出信号依次为 1、0(起始位)、01010101b(LSB)、1(停止位);当输入数据为 01010101b(MSB)后,输出信号依次为 1、0(起始位)、10101010b(LSB)、1(停止位)。同时 uart_state 处于发送状态时为 1,即仿真通过。 图片 按键控制串口发送设计 为了实现导读中所设定的目标,将以前编写好的按键消抖模块添加到工程当中,并再次使用 ISSP,其主要参数配置如图 16.12 所示,并加入到工程中。 图片 然后,新建一个顶层文件,并将按键消抖、串口发送以及 ISSP 例化,并将按键状态与串口发送使能端连接即可。部分设计如下所示,并将串口发送状态连接到 LED 上,以更好的观察数据发送状态。 assign send_en = key_flag0 & !key_state0; uart_byte_tx uart_byte_tx( .Clk(Clk), .Rst_n(Rst_n), .data_byte(data_byte), .send_en(send_en), .baud_set(3'd0), .Rs232_Tx(Rs232_Tx), .Tx_Done(), .uart_state(led) );编译无误后,点击 RTL_viewer 可以看到如图 16.13 的各模块连接图。 图片 分配引脚并全编译无误后下载工程到 AC620 开发板中。然后,在 Quartus Prime 中点击Tools→In-System Source and Probes Editor 启动 ISSP,手动选择下载器后,并将数据格式改为设计中的 hex 格式。打开电脑上的串口助手,将主要参数设置为:波特率为 9600、无校验位、8 位数据位以及 1bit 停止位。 在 Quartus Prime 中,使用 In system sources and probes editor 工具,输入需要通过串口发送出去的数据,然后按下学习板上的按键 0,FPGA 自动将所需要发送的数据发送出去,即可在串口助手中看到相关数据。且板载的 LED_RX 每接收一 byte 数据均会亮一下,这里由于时钟较快,数据传输过程很快,因此代表传输状态的 led0 看着“常亮”。 图片 至此,完成了基于 FPGA 的串口通信发送部分实现。 在本章中学习了 UART 的分类以及原理,介绍了 RS232 协议的数据格式以及相关参数所代表的含义,并设计了串口的硬件电路,且在板级调试中再次使用了 ISSP 中的源功能(source)。 代码工程 代码下载 下载地址:https://wwek.lanzoub.com/ijx1z0izahvc 提取码:
FPGA&ASIC
# 小实验
刘航宇
4年前
0
1,142
1
2022-07-14
[Verilog]ASIC/FPGA实现边沿检测电路(上升/下降沿)
摘要本文介绍了边沿检测电路的设计方法,包括使用1级和2级触发器实现边沿检测,并详细阐述了Verilog代码实现和仿真结果。关键词:Verilog, ASIC/FPGA, 边沿检测, 上升沿, 下降沿目录 1、什么是边沿检测 2、采用1级触发器的边沿检测电路设计(以下降沿为例)2.1、设计方法 2.2、Verilog实现 2.3、RTL电路 2.4、Testbench 2.5、仿真结果 3、采用2级触发器的边沿检测电路(以下降沿为例)3.1、设计方法 3.2、Verilog实现 3.3、RTL电路 3.4、Testbench 3.5、仿真结果 4、参考文献 1、什么是边沿检测 边沿检测用于检测信号的上升沿或下降沿,通常用于使能信号的捕捉等场景。 2、采用1级触发器的边沿检测电路设计(以下降沿为例) 2.1、设计方法 设计波形图如下所示: 图片 各信号说明如下: sys_clk:基准时钟信号(这里设定为50MHz,周期20ns) sys_rst_n:低电平有效的复位信号 in:输入信号,需要对其进行下降沿检测 ~in:输入信号的反相信号 in_d1:对输入信号寄存一拍 in_neg:得到的下降沿指示信号,该信号为 ind1 && ~in 对上图进行分析: 信号in是我们需要对其进行下降沿检测的信号 信号~in是将信号in反向 信号in_d1是使用寄存器寄存in信号,即对其进行打拍,或者说是同步到系统时钟域下 输入信号开始为高电平,在L2处变为低电平,产生第1个下降沿,在L5出产生第2个下降沿 A处为产生的第1个下降沿指示信号,B处为产生的第2个下降沿指示信号 由此我们可以推导出边沿检测信号产生的一般方法: 将需要检测的信号寄存一拍,同步到系统时钟域下,得到信号 in_d1 将需要检测的信号反向,得到信号 ~in 将信号 in_d1 反向,得到信号 ~in_d1 通过组合逻辑电路可以得到下降沿信号 in_neg:assign in_neg = ~in && in_d1 同样通过组合逻辑电路可以得到上升沿信号 in_pos:assign in_pos = in && ~in_d1 双边沿检测就是将上两条加(或运算)起来就可以了,化简后有:双边沿信号 in_both = in ^ ind1 2.2、Verilog实现 根据上文分析不难编写Verilog代码如下: //使用1级寄存器的下降沿检测电路 module detect_1 ( input sys_clk, //时钟(设定为 50MHz) input sys_rst_n, //复位信号(n 表示低电平有效) input in, //需要进行下降沿检测的输入信号 output in_neg //输出的下降沿指示信号 ); //reg 定义 reg in_d1; //寄存一拍的信号 assign in_neg = ~in && in_d1; //组合逻辑得到下降沿 //上升沿: assign in_pos = in && ~in_d1; //双边沿: assign in_pos = in ^ in_d1; //寄存模块,将输入信号打一拍 always@(posedge sys_clk or negedge sys_rst_n)begin if(!sys_rst_n) in_d1 <= 1'b0; //复位清零 else in_d1 <= in; //寄存一拍 end endmodule2.3、RTL电路 图片 上图为生成的RTL电路:该电路由一级D触发器+与逻辑门构成。 2.4、Testbench Testbench文件需要例化刚刚设计好的模块,并设置好激励。 `timescale 1ns/1ns //时间刻度:单位1ns,精度1ns module tb_detect_1(); //仿真模块 //输入reg 定义 reg sys_clk; reg sys_rst_n; reg in; //输出wire定义 wire in_neg; //设置初始化条件和输入激励 initial begin sys_clk = 1'b0; //初始时钟为0 sys_rst_n <= 1'b0; //初始复位 in <= 1'b0; //初始化输入信号 /*****以下部分为设置的激励,以产生2个下降沿*******/ #10 //10个时间单位后 sys_rst_n <= 1'b1; //拉高复位(此时复位无效) in <= 1'b1; //拉高输入 #20 //20个时间单位后 in <= 1'b0; //拉低输入,制造第1个下降沿 #80 //80个时间单位后 in <= 1'b1; //拉高输入 #60 //60个时间单位后 in <= 1'b0; //拉低输入,制造第2个下降沿 end //always代表重复进行,#10代表每10个时间单位 //每10个时间单位反转时钟,即时钟周期为20个时间单位(20ns) always #10 sys_clk = ~sys_clk; //例化被测试模块 detect_1 detect_1_inst ( .sys_clk (sys_clk ), .sys_rst_n (sys_rst_n ), .in (in), .in_neg (in_neg) ); endmodule 2.5、仿真结果 使用ModelSim执行仿真,仿真出来的波形如所示: 图片 从波形图可以看到: 10ns后停止复位 在第1条参考线处输入信号 in 产生了第1个下降沿信号 在第3条参考线处输入信号 in 产生了第2个下降沿信号 在第1条参考线和第2条参考线之间的产生了一个周期的下降沿指示信号 in_neg 在第3条参考线和第4条参考线之间的产生了一个周期的下降沿指示信号 in_neg 3、采用2级触发器的边沿检测电路(以下降沿为例) 3.1、设计方法 设计波形图如下所示: 图片 各信号说明如下: sys_clk:基准时钟信号(这里设定为50MHz,周期20ns) sys_rst_n:低电平有效的复位信号 in:输入信号,需要对其进行下降沿检测 in_d1:对输入信号寄存1拍 in_d2:对输入信号寄存2拍 ~in_d1:in_d1信号的反相信号 in_neg:得到的下降沿指示信号,该信号为 ~ind1 && ind2 对上图进行分析: 信号in是我们需要对其进行下降沿检测的信号 信号in_d1是使用寄存器寄存in信号,即对其打1拍 信号in_d2是使用寄存器寄存in_d1信号,即对其打1拍 信号~in_d1是将信号in_d1反向 输入信号开始为高电平,在L2处变为低电平,产生第1个下降沿,在L5出产生第2个下降沿 A处为产生的第1个下降沿指示信号,B处为产生的第2个下降沿指示信号 输出的下降沿指示信号落后下降沿一个时钟周期,这是因为对输入信号进行了寄存以消除亚稳态 由此我们可以推导出边沿检测信号产生的一般方法: 将需要检测的信号分别寄存1拍、2拍,同步到系统时钟域下,得到信号 in_d1、in_d2 将in_d1信号反向,得到信号 ~in_d1 将in_d2信号反向,得到信号 ~in_d2 通过组合逻辑电路可以得到下降沿信号 in_neg:assign in_neg = ~in_d1 && in_d2 同样通过组合逻辑电路可以得到上升沿信号 in_pos:assign in_pos = in_d1 && ~in_d2 双边沿检测就是将上两条加(或运算)起来就可以了,化简后有:双边沿信号 in_both = in_d1 ^ in_d2 3.2、Verilog实现 根据上文分析不难编写Verilog代码如下: //使用1级寄存器的下降沿检测电路 module detect_2 ( input sys_clk, //时钟(设定为 50MHz) input sys_rst_n, //复位信号(n 表示低电平有效) input in, //需要进行下降沿检测的输入信号 output in_neg //输出的下降沿指示信号 ); //reg 定义 reg in_d1; //寄存1拍的信号 reg in_d2; //寄存2拍的信号 assign in_neg = ~in_d1 && in_d2;//组合逻辑得到下降沿 //上升沿: assign in_pos = in && ~in_d1; //双边沿: assign in_pos = in ^ in_d1; //寄存模块,将输入信号打1拍、打2拍 always@(posedge sys_clk or negedge sys_rst_n)begin if(!sys_rst_n)begin in_d1 <= 1'b0; //复位清零 in_d2 <= 1'b0; end else begin in_d1 <= in; //寄存1拍 in_d2 <= in_d1; //寄存2拍 end end endmodule3.3、RTL电路 图片 上图为生成的RTL电路:该电路由2级D触发器+与逻辑门构成。 3.4、Testbench Testbench文件同2.4章。 3.5、仿真结果 使用ModelSim执行仿真,仿真出来的波形如所示: 图片 从波形图可以看到: 10ns后停止复位 在第1条参考线处输入信号 in 产生了第1个下降沿信号 在第4条参考线处输入信号 in 产生了第2个下降沿信号 在第2条参考线和第3条参考线之间的产生了一个周期的下降沿指示信号 in_neg 在第5条参考线和第6条参考线之间的产生了一个周期的下降沿指示信号 in_neg 两级寄存器构成的边沿检测电路可以有效的防止亚稳态的产生,产生的使能信号会落后一个时钟周期。 4、参考文献 【从零开始走进FPGA】你想干嘛——边沿检测技术 FPGA的边沿检测 FPGA基础入门篇(四) 边沿检测电路
FPGA&ASIC
刘航宇
4年前
0
2,695
1
【1】Verilog-初识、简介与环境搭建
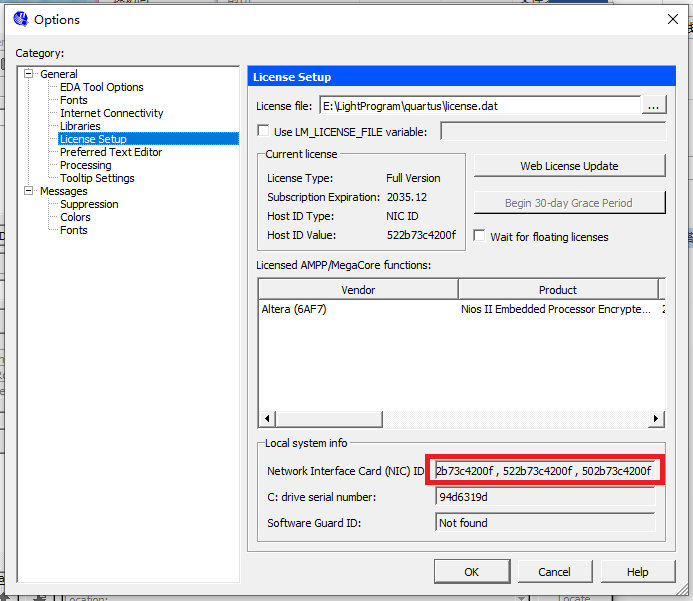
摘要Verilog是一种强大的硬件描述语言,用于数字系统描述和建模,广泛应用于ASIC设计。本文介绍了Verilog的发展历史、主要特性、应用领域以及环境搭建过程,包括Quartus II和Modelsim的使用。关键词:Verilog, 硬件描述语言, FPGA, Quartus II, Modelsim目录 发展历史 主要特性 主要应用 Verilog 环境搭建Quartus II 安装 Modelsim 安装 建立 Quartus II 工程建立工程 新建 Verilog 源文件 Quartus II 调用 Modelsim 仿真 总结 Verilog 具有很强的电路描述与建模能力,能从多个层次对数字系统进行描述和建模。因此,在简化硬件设计任务、提高设计效率与可靠性、语言易读性、层次化和结构化设计等方面展现了强大的生命力与潜力。 发展历史 1983 年,Verilog 最初由 Gateway Design Automation 公司(GDA)的 Phil Moorby 创建,作为内部仿真器的语言,主要用于逻辑建模和仿真验证,被广泛使用。 1989 年,GDA 公司被 Cadence 公司收购,Verilog 语言成为 Cadence 公司的私有财产。 1990 年,Cadence 公司成立 OVI(Open Verilog International)组织,公开 Verilog 语言,促进 Verilog 向公众领域发展。 1992 年,OVI 决定致力于将 Verilog OVI 标准推广为 IEEE(The Institute of Electrical and Electronics Engineers)标准。 1995 年,OVI 的努力获得成功,IEEE 制定了 Verilog HDL 的第一个国际标准,即 IEEE Std 1364-1995,也称之为 Verilog 1.0。 2001 年,IEEE 发布 Verilog 第二个标准(Verilog 2.0),即 IEEE Std 1364-2001, 简称为 Verilog-2001 标准。由于 Cadence 在集成电路设计领域的影响力及 Verilog 语言的简洁易用性,Verilog 成为电路设计中最流行的硬件描述语言。 主要特性 下面是 Verilog 的主要特性: 可采用 3 种不同的方式进行设计建模:行为级描述——使用过程化结构建模;数据流描述——使用连续赋值语句建模;结构化方式——使用门和模块例化语句描述。 两类数据类型:线网(wire)数据类型与寄存器(reg)数据类型,线网表示物理元件之间的连线,寄存器表示抽象的数据存储元件。 能够描述层次设计,可使用模块实例化描述任何层次。 用户定义原语(UDP)创建十分灵活。原语既可以是组合逻辑,也可以是时序逻辑。 可提供显示语言结构指定设计中的指定端口到端口的时延,以及路径时延和时序检查。 Verilog 支持其他编程语言接口(PLI)进行进一步扩展。PLI 允许外部函数访问 Verilog 模块内部信息,为仿真提供了更加丰富的测试方法。 同一语言可用于生成模拟激励和指定测试的约束条件。 设计逻辑功能时,设计者可不用关心不影响逻辑功能的因素,例如工艺、温度等。 主要应用 专用集成电路(ASIC),就是具有专门用途和特殊功能的独立集成电路器件。 Verilog 作为硬件描述语言,主要用来生成专用集成电路。 主要通过 3 个途径来完成: 1、可编程逻辑器件 FPGA 和 CPLD 是实现这一途径的主流器件。他们直接面向用户,具有极大的灵活性和通用性,实现快捷,测试方便,开发效率高而成本较低。 2、半定制或全定制 ASIC 通俗来讲,就是利用 Verilog 来设计具有某种特殊功能的专用芯片。根据基本单元工艺的差异,又可分为门阵列 ASIC,标准单元 ASIC,全定制 ASIC。 3、混合 ASIC 主要指既具有面向用户的 FPGA 可编程逻辑功能和逻辑资源,同时也含有可方便调用和配置的硬件标准单元模块,如CPU,RAM,锁相环,乘法器等。 Verilog 环境搭建 学习 Verilog 做仿真时,可选择不同仿真环境。FPGA 开发环境有 Xilinx 公司的 ISE(目前已停止更新),VIVADO;因特尔公司的 Quartus II;ASIC 开发环境有 Synopsys 公司的 VCS ;很多人也在用 Icarus Verilog 和 GTKwave 的方法,更加的轻便。 虽然 ISE 或者 Quartus II 都会自带仿真器,但功能还是有欠缺。所以,这里介绍下 Quartus II + Modelsim 联合仿真的测试方法,运行环境为 64bit-win10 系统。 Quartus II 安装 本次介绍使用的 Quartus 版本为 10.1。 目前 Quartus II 官网已经没有 13.1 以下版本的安装包,大家可以安装 13.1 以上版本的软件。功能都是大同小异,下载地址:https://fpgasoftware.intel.com/13.1/?edition=subscription&platform=windows 下载 13.1 以上的 quartus II 时,官网也会推荐相应版本的 Modelsim,一起下载即可。 开始安装,修改安装路径,其他按照默认设置一步步操作即可。 下图是成功安装的截图。 图片 如果提示需要 License file,如下图所示,则需要指定购买该软件时的 license 文件。 图片 如果 license 文件需要替换 Host-ID,只需要 license 文件中的 HOSTID 替换为 NIC 选项中随便一个 ID 即可,如下图红色框所示: l35kw97h.png图片 Quartus II 10.1 安装完还需要安装 Device,即安装支持各种可编程逻辑器件型号的库文件,否则 Quartus II 不能正常建立工程。 安装路径需要选择 Quartus II 的安装路径,此时 Device 安装可自动识别 Quartus II。 最新 Quartus II(例如 2016 版本)已经支持一套化安装了。 Modelsim 安装 Modelsim 选择 modelsim-win64-10.1c-se 版本。 也需要修改下安装路径,然后按照默认设置进行操作即可。 安装完毕后可能提示需要重启电脑,重启即可。 l35kwto3.png图片 建立 Quartus II 工程 建立工程 File->New project Wizard 设置工作路径与工程名字、top module名字。 注意,路径与名字设置时,不能包含中文。 l35kymsh.png图片 选择器件型号 我们只进行简单的仿真,不进行下载、烧录等,所以我们不用关心具体信号,随便选一种即可。 然后一直点击 Next,直到 Finish。 l35kz8mf.png图片 新建 Verilog 源文件 下面就对 4 位宽 10 进制计数器进行简单的仿真。 点击:File->New->Verilog HDL File->OK 点击:File->Save As 输入 module 名字为:counter10.v 需要注意的是,top module 名字一定要和 project 名字一致,否则会报错(如图中所示)。 把 Verilog 代码复制到文件 counter10.v 中,进行一键编译(实际包含了编译、综合、布局布线等)。 代码: module counter10( //端口定义 input rstn, //复位端,低有效 input clk, //输入时钟 output [3:0] cnt, //计数输出 output cout); //溢出位 reg [3:0] cnt_temp ; //计数器寄存器 always@(posedge clk or negedge rstn) begin if(! rstn)begin //复位时,计时归0 cnt_temp <= 4'b0 ; end else if (cnt_temp==4'd9) begin //计时10个cycle时,计时归0 cnt_temp <=4'b000; end else begin //计时加1 cnt_temp <= cnt_temp + 1'b1 ; end end assign cout = (cnt_temp==4'd9) ; //输出周期位 assign cnt = cnt_temp ; //输出实时计时器 endmodule报错时,可通过点击 Error log 来定位错误,进行修改,直至没有 Error。 l35kzvy2.png图片 Quartus II 调用 Modelsim 仿真 仿真设置为 Modelsim-altera 点击:Tool->Options->EDA Tool Options 将 Modelsim 后面的地址改为 Modelsim 启动程序的路径。 l35l1p4j.png图片 选择仿真器 点击:Assignments -> Simulation Tool name 选择 ModelSim,并设置 Format、Time scale 等,如图 l35l22b6.png图片 写 testbench 文件 点击:Processing->start->Start TestBench Template Writer 如果设置正确,会在工程路径 simulation/modelsim 下产生 .vt 文件。 .vt 文件模板已经给出了端口部分的代码、接口变量的声明和例化语句映射等。我们要做的就是将测试代码填入到 testbench 合适的位置。 这里简单的写一下时钟、复位驱动代码,如下图所示。 l35l2is4.png图片 将 testbench 添加到工程中 点击:Assignments -> Settings -> Simulation 在 Compile test bench 选项中,选择 new,设置 Test bench name,并通过 File name 查找的方式,将上一步生成的 .vt 文件添加到工程中。 需要注意的是,testbench 文件名字需要和 testbench 里的 top module 名字保持一致,否则后续启动 Modelsim 时会报错,不能进行正常的仿真。 l35l2w7o.png图片 重新一键编译 此时,你会发现,Tasks 栏编译的状态变成了问号,需要重新进行一键编译。 l35l3k7f.png图片 调用 Modelsim 仿真 点击:Tools->Run simulation Tool->RTL Simulation 这时就会自动启动 Modelsim 软件。 Modelsim 操作这里不做具体介绍。 由仿真图可知,我们的设计完成了 10 进制计数的基本功能。 l35l42j9.png图片 总结 记忆中,Quartus II + Modelsim 的联合仿真功能既强大,又安装方便。几年后重新进行此过程,发现步骤也有些许繁琐,花费了我一晚上的时间来搞定。很多细节也在上面提出,多多注意就好。不过,大家以后有机会进行大型的数字模块仿真时,就会发现此方法的有效性。 在接下来的教程里,有些简单的仿真可能用其他软件进行,截图界面可能与 Modelsim 不一致。大家看到后不用怀疑仿真的准确性,这里特别说明。 设计模块与 testbench 源码也会全部给出,大家完全可以自己仿真、验证。
FPGA&ASIC
刘航宇
4年前
0
974
2
【夜读】“别熬夜了,好吗”
摘要文章指出,许多年轻人存在熬夜现象,尽管熬夜有害健康,但克服熬夜习惯不易。文章建议通过减少睡前电子设备使用、养成良好作息、提高白天工作效率等方法来改善睡眠质量。关键词:熬夜, 睡眠习惯, 生物钟, 睡前手机, 睡眠质量这里是深夜治愈所,我和你的治愈星球 看过有句话说:“别说你一无所长,熬夜玩手机你是一把好手。”诙谐又戳心。 前段时间,有个面向年轻人的睡眠调查,结果显示,只有10.3%的人能在23点前入睡,超过80%的人会熬到凌晨才入睡。 不知道正在看文章的你,是不是也有熬夜的习惯呢? 当然会有人说,自己熬夜是因为工作加班。 也确实看到过有数据显示:近90%的职场人都难以逃脱加班的命运。 甚至其中有四分之一的人,加班的频率是每天。 我们都知道,熬夜有害健康,但很少有人能做到不熬夜。 越来越多的年轻人白天开始保温杯泡枸杞,各种养生,花很多钱买面膜和护肤品,却因为熬夜,把前面的所有努力一键归零。 今天就要来和你说说,怎样克服熬夜的习惯。 网络上有个问题是:“坚持每天早睡,你发生了什么变化?” 有个网友的回答获得了很多点赞,他说:“我发现早睡后必然早起,然后生活里没有游戏、没有夜宵。 黑眼圈少了,时间多了,不会迟到了,每天都有时间好好吃早餐。” 图片 一年前,我在准备一个资格考试的时候,就尝到过早睡甜头。 当时,因为每天白天都有满满当当的工作,所以晚上下班回家已经非常疲惫,一看书就会想打瞌睡,勉强能挤得出时间学习,但精力却跟不上。 一开始挺发愁的,很担心自己的状态通过不了考试。 有一天晚上,实在太累了,就像要不先睡,明天早两个小时起来学习好了。 结果第二天起来竟然精神异常充沛,而且一大早特别安静,学习效率异常的高。 就这样我每天早睡早起,学习的时候状态都很好,没请假,不耽误工作的情况下也通过了考试。 最近有个话题#睡前玩手机8分钟 兴奋超1小时#就冲上过热搜。 有医学专家研究发现,眼睛只要受到手机等屏幕发出的蓝光刺激8分钟,就会导致身体持续兴奋超过1小时,造成生物钟紊乱。 睡觉前过度使用手机,不但损伤视力,还会使人入睡困难。 特别是睡觉前还在追剧、刷短视频或者打游戏的,越玩越停不下来,然后越难入睡,最后变成了恶性循环。 图片 年初很火的电视剧《人世间》里周蓉的扮演者宋佳,就曾在一次节目中透露,自己保持良好的身体和工作状态,都得益于好的睡眠习惯。 她睡觉时从不把手机带进卧室,睡前不看手机、不玩游戏、不看资讯,正是因为这些好习惯保证了好的睡眠质量。 所以有人说: 不透支睡眠,科学制定属于自己的起床和睡觉时间,好好睡觉,是善待自己的开始,也是热爱生活的体现。 最后,给大家推荐几个戒掉熬夜的小妙招: 1.睡前少玩手机和电脑、平板等电子设备,避免蓝光刺激大脑兴奋而难以入眠。 2.睡前洗个热水澡或者泡个脚,能使人心态放松。喝杯热牛奶也是不错的选择,牛奶中含有的色氨酸可以让人产生疲倦欲睡感。但别通过酒精催眠,酒精伤肝,而且代谢很容易让人在后半夜醒来,影响睡眠质量。 3.养成良好作息,形成生物钟,到点了就有困意,该起床时就别赖床。 4.白天提高工作效率,别把太多工作留到晚上。晚上工作反而容易让大脑更兴奋,特别是熬夜工作,越熬越兴奋,后来想睡都睡不着。所以如果能提早规划,尽量白天就科学高效地把工作完成。 图片 5.晚餐前适量运动,或者晚餐后散散步,可以让身体保持微疲劳状态,让人容易产生困意。当然避免睡前大量运动。 6.除了该睡觉时,不要长时间待在床上,也尽量不要在床上做其它事情,比如躺床上看电视、听音乐、看书等。 这样可以建立身体和床之间的条件反射,即身体沾到床就出现困意,需要我们把床当成唯一睡觉的地方。 当然,很多听众跟我说,睡前收听我们的《深夜治愈所》节目,也可以催眠哦。睡不着的夜晚欢迎来找我。 从今晚开始,早点睡觉,别熬夜了,好吗。
励志美文
刘航宇
4年前
0
645
6
嵌入式视频流知识点及代码解析-精简版
摘要本文介绍了嵌入式视频流处理相关知识,包括Live555、FFmpeg、SDL等库的使用,以及RTSP、YUV、TCP/UDP等概念。通过代码解析,展示了如何实现视频流的接收、解码和显示。关键词:嵌入式视频流, Live555, FFmpeg, SDL, RTSP目录 背景和意义 框架 代码及相关知识点 一、知识点篇 二、问答篇 三、代码篇RTSP程序要不要等待播放器器程序请求? 请你找出上述代码所在位置 live555(了解) SDL 背景和意义 (1)视频的带宽很大,存储,传输不便,故要压缩、解压 、播放。 (2)应用领域很广 ,交通,在线教育,播放器,自动驾驶。 框架 图片 下面这个图及其重要以及3个ip关系 abcde代表先后实现顺序注意观看!!! TO67M8.png图片 代码及相关知识点 一、知识点篇 Live 555: 是一个为流媒体提供解决方案的跨平台的C++开源项目,它实现了标准流媒体传输,对标准流媒体传输协议如RTP/RTCP、RTSP、SIP等的支持。Live555实现了对多种音视频编码格式的音视频数据的流化、接收和处理等支持,包括MPEG、H.263+、DV、JPEG视频和多种音频编码。同时由于良好的设计,Live555非常容易扩展对其他格式的支持。Live555已经被用于多款播放器的流媒体播放功能的实现,如VLC(VideoLan)、MPlayer。 在本次开发实践中主要用于接收海康威视摄像头的RTP数据包 并通过UDP网络进行转发给PC机。 FFmpeg: Fmpeg是一套可以用来记录、转换数字音频、视频,并能将其转化为流的开源计算机程序。采用LGPL或GPL许可证。它提供了录制、转换以及流化音视频的完整解决方案。它包含了非常先进的音频/视频编解码库libavcodec,为了保证高可移植性和编解码质量,libavcodec里很多code都是从头开发的。 FFmpeg在Linux平台下开发,但它同样也可以在其它操作系统环境中编译运行,包括Windows、Mac OS X等。项目的名称来自MPEG视频编码标准,前面的"FF"代表"Fast Forward"。 在本次开发实践中主要用于H264数据解码。 SDL: SDL(Simple DirectMedia Layer)是一套开放源代码的跨平台多媒体开发库,使用C语言写成。SDL提供了数种控制图像、声音、输出入的函数,让开发者只要用相同或是相似的代码就可以开发出跨多个平台(Linux、Windows、Mac OS X等)的应用软件。目前SDL多用于开发游戏、模拟器、媒体播放器等多媒体应用领域。在本次开发实践中主要用于YUV数据的显示。 二、问答篇 1.什么是YUV?与RGB有什么不同? YUV 是一种颜色编码方法,FFmpeg 解码后的数据格式。Y 表示明亮度 U 表示色 度 V 表示浓度。因为通过研究发现,人类对于图像的感知中对明亮最侧重,色彩和 浓度就相对不那么重要,所以在保存图片时,让明亮度占较多的比重,有效的在不影 响观看的情况下节约了空间。视频播放器解码出来的格式为 YUV420P,其中明亮度 占整个数据的 2/3,色度和浓度占 1/3。 2.RTSP在什么层?答:应用层 3.你关于IP问题你用到了那些命令?答:ipconfig,ifconfig,ping等 4.本次课程设计你用到了那些去年学的知识?答:网络通信,文件开关与读写,第一章shell操作命令 下面部分自行百度: 5.TCP与UDP特点(TCP的可靠,UDP 的不可靠,UDP快) 6.简述TCP与UDP 7.了解HTTP/https 8.三次握手和四次挥手过程 三、代码篇 RTSP程序要不要等待播放器器程序请求? 答:要 请你找出上述代码所在位置 答:如图所示 图片 live555(了解) BasicTaskScheduler 的父类是BasicTaskScheduler0 BasicTaskScheduler0是一个用作传递的类,它继承自TaskScheduler,又派生出BasicTaskScheduler。其定义在live555sourcecontrol\UsageEnvironment\include\BasicUsageEnvironment0.hh文件中。 BasicTaskScheduler0中有 BasicTaskScheduler 这个类主要实现事件的处理 BasicUsageEnvironment 涉及调试语句,输出语句 ourRTSPClient 主要是涉及的数据的发送相关的功能函数,主要的功能继承于父类RTSPClient RequestRecord 创建一个请求记录对象,并将回调函数与之关联 sendRequest 第一次进入调用:openConnection解析URL,并调用setupStreamSocket和connectToServer,然后 envir().taskScheduler().setBackgroundHandling(fInputSocketNum, SOCKET_READABLE|SOCKET_EXCEPTION, (TaskScheduler::BackgroundHandlerProc*)&incomingDataHandler, this); 若不是第一次调用,则打包 RTSP 包协议,并调用 Send函数发送到服务器。 重点 RequestRecord入队列 等候读取数据。 setupStreamSocket调用createSocket ,createSocket调用: sock = socket(AF_INET, type, 0); connectToServer调用 connect(socketNum, (struct sockaddr*) &remoteName, sizeof remoteName) setBackgroundHandling 主要初始化select 函数的 文件描述符集合 incomingDataHandler 中包含函数 readSocket 调用 int bytesRead = recvfrom(socket, (char*)buffer, bufferSize, 0, (struct sockaddr*)&fromAddress, &addressSize);到此发送描述命令结束 ,等待响应服务器发送过来的数据。 incomingDataHandler1读取服务器的数据 incomingDataHandler1先调用readSocket调用,然后调用 handleResponseBytes 解析RTSP服务器数据 调用(*foundRequest->handler())(this, resultCode, resultString); 这个函数就是continueAfterDESCRIBE continueAfterDESCRIBE 调用下一步 setup 功能 SDL 抓1,2,3,4....等每段的关键句,可能考流程 rb为只读,对于不需要进行更新的文件,可以防止用户的错误的写回操作,防止损毁原有数据。具有较高的安全性。 rb+为更新二进制文件,可以读取,同时也可以写入,需要用到fseek之类的函数进行配合,以免出错,对于需要不时更新的文件,比如信息管理系统中的数据,可以这样打开。 初始化SDL 使用SDL_Init()初始化SDL。该函数可以确定希望激活的子系统。 int SDLCALL SDL_Init(Uint32 flags) SDL_INIT_VIDEO:视频 创建窗口(Window) 使用SDL_CreateWindow()创建一个用于视频播放的窗口。 SDL_Window SDLCALL SDL_CreateWindow(const char title,int x, int y, int w,int h, Uint32 flags); SDL_CreatWindow:第一个参数是窗口名字,第二三是窗口的坐标(SDL_winpos_undefined 为采用系统默认) title :窗口标题 x :窗口位置x坐标。也可以设置为SDL_WINDOWPOS_CENTERED或SDL_WINDOWPOS_UNDEFINED。 y :窗口位置y坐标。同上。 w :窗口的宽 h :窗口的高 flags :支持下列标识。包括了窗口的是否最大化、最小化,能否调整边界等等属性。 flags:SDL_WINDOW_RESIZABLE 自动调整窗口 基于窗口创建渲染器(Render) 使用SDL_CreateRenderer()基于窗口创建渲染器 SDL_Renderer SDLCALL SDL_CreateRenderer(SDL_Window window,int index, Uint32 flags); window: 渲染的目标窗口。 index:打算初始化的渲染设备的索引。设置“-1”则初始化默认的渲染设备。 SDL_RENDERER_PRESENTVSYNC:和显示器的刷新率同步 创建纹理(Texture) 使用SDL_CreateTexture()基于渲染器创建一个纹理 SDL_Texture SDLCALL SDL_CreateTexture(SDL_Renderer renderer,Uint32 format,int access, int w,int h); renderer:目标渲染器。 format:纹理的格式。 access:定义位于SDL_TextureAccess中 access:SDL_TEXTUREACCESS_STREAMING :变化频繁 w:纹理的宽 h:纹理的高 SDL_Thread *refresh_thread = SDL_CreateThread(RefreshVideo,NULL,NULL); //创建线程 SDL_Event event; //设置触发事件 6.在SDL中,当事件等待函数监听到事件后,判断事件类型,如果event.type == SDL_KEYDOWN,表明用户按下键盘,保存在event.key.keysym.sym是相应的键值。而根据键值,调用函数SDL_GetKeyName(event.key.keysym.sym)),即可得到按下的按键键名。 SDLK_RETURN == 13 回车! 7.读文件fread size_t fread(void buffer,size_t size,size_t count,FILE stream) buffer 是读取的数据存放的内存的指针(可以是数组,也可以是新开辟的空间,buffer就是一个索引) size 是每次读取的字节数 count 是读取次数 stream 是要读取的文件的指针 8.循环显示画面 (1)设置纹理的数据 使用SDL_UpdateTexture()设置纹理的像素数据 int SDLCALL SDL_UpdateTexture(SDL_Texture texture,const SDL_Rect rect,const void *pixels, int pitch); texture:目标纹理。 rect:更新像素的矩形区域。设置为NULL的时候更新整个区域。 pixels:像素数据。 pitch:一行像素数据的字节数。 (2)纹理复制给渲染目标 使用SDL_RenderCopy()将纹理数据复制给渲染目标。在使用SDL_RenderCopy()之前,可以使用SDL_RenderClear()先使用清空渲染目标。实际上视频播放的时候不使用SDL_RenderClear()也是可以的,因为视频的后一帧会完全覆盖前一帧 int SDLCALL SDL_RenderCopy(SDL_Renderer renderer,SDL_Texture texture,const SDL_Rect srcrect,const SDL_Rect dstrect); renderer:渲染目标。 texture:输入纹理。 srcrect:选择输入纹理的一块矩形区域作为输入。设置为NULL的时候整个纹理作为输入。 dstrect:选择渲染目标的一块矩形区域作为输出。设置为NULL的时候整个渲染目标作为输出。 (3) 显示 使用SDL_RenderPresent()显示画面 void SDLCALL SDL_RenderPresent(SDL_Renderer * renderer); 参数renderer用于指定渲染目标 9.退出 event.type==SDL_QUIT fclose(fp); //关闭文件! 防止遗留无用进程 SDL_DestroyTexture(texture); //关闭纹理 SDL_DestroyRenderer(renderer); //关闭渲染 SDL_DestroyWindow(window); //关闭窗口 SDL_Quit(); //退出线程 FFMPEG解码deco fun_deco_display.c 从void * deco_thread开始 play_ubuntu内 功能函数于主函数同时编译 多个c编译! gcc -o demo main.c fun_deco_display.c fun_others.c fun_recv_control.c -I /monchickey/ffmpeg/include -L /monchickey/ffmpeg/lib -lavformat -lavcodec -lavutil -lSDL2 -lpthread AVCodec codec; / 解码CODEC*/ AVCodecContext *cctx; AVFrame frame; / 解码后的图像*/ int byte_buffer_size; //解码器码流长度 uint8_t *byte_buffer = NULL; //h.264码流 AVPacket *pkt; //保存媒体流信息 AVPacket主要保存一些媒体流的基本信息,例如PTS、DTS时间。最重要的当然就是媒体数据的buffer地址了。 比较重要的有: pts:控制显示的pts时间 dts:控制解码的dts时间 *data:媒体数据buffer的指针 duration:AVStream-> time_base单位中此数据包的持续时间,如果未知则为0。 在演示顺序中等于next_pts - this_pts。 AVFormatContext主要存储视音频封装格式中包含的信息 解码前数据:AVPacket 解码后数据:AVFrame 1.AVFormatContext avformat_alloc_context(void)函数用来申请AVFormatContext类型变量并初始化默认参数。申请的空间通过void avformat_free_context(AVFormatContext s)函数释放。 2.avformat_find_stream_info()主要用于给每个媒体流(音频/视频)的AVStream结构体赋值,已经实现了解码器的查找,解码器的打开,视音频帧的读取,视音频帧的解码等工作 3.av_find_best_stream()函数就是要获取音视频对应的stream_index 获取流的索引 4.解码模块第一步:获取解码器 avcodec_find_decoder()FFmpeg的解码器编码器都存在avcodec的结构体中 5.avcodec_alloc_context3,avcodec_parameters_to_context,解码器初始化 6.avcodec_open2打开解码器 7.av_frame_alloc()首先调用av_mallocz()为AVFrame结构体分配内存 8.int av_image_get_buffer_size(enum AVPixelFormat pix_fmt, int width, int height, int align);函数的作用是通过指定像素格式、图像宽、图像高来计算所需的内存大小,av_malloc 按需分配空间 9.av_packet_alloc实际是分配AVPacket以后,调用av_init_packet对AVPacket的成员变量进行初始化赋值 10.av_read_frame()的作用是读取码流中的音频若干帧或者视频一帧 11.avcodec_send_packet()以在AVPacket中给出解码器原始的压缩数据 avcodec_receive_frame()。 成功后,它将返回一个包含未压缩音频或视频数据的 AVFrame 12. void av_image_copy_uc_from ( uint8_t * dst_data[4], const ptrdiff_t dst_linesizes[4], const uint8_t * src_data[4], const ptrdiff_t src_linesizes[4], enum AVPixelFormat pix_fmt, int width, int height ) 数据拷贝 13.av_packet_free(&pkt); //释放数据 关闭进程 av_frame_free(&frame); avformat_close_input(&fctx); avcodec_free_context(&cctx); avformat_free_context(fctx); Client && Server(了解) //Client_Upd 1.int socket(int domain, int type, int protocol); 函数socket()的参数domain用于设置网络通信的域,函数socket()根据这个参数选择通信协议的族 SOCK_DGRAM udp连接 socket()函数的原型如下,这个函数建立一个协议族为domain、协议类型为type、协议编号为protocol的套接字文件描述符。 2.memset可以方便的清空一个结构类型的变量或数组。初始化 3.family 通信协议的族 AF_INET,PF_INET IPv4 Internet协议 4.sockaddr_in在头文件#include<netinet/in.h>或#include <arpa/inet.h>中定义,该结构体解决了sockaddr的缺陷,把port和addr 分开储存在两个变量中。 htons()作用是将端口号由主机字节序转换为网络字节序的整数值。(host to net) inet_addr()作用是将一个IP字符串转化为一个网络字节序的整数值,用于sockaddr_in.sin_addr.s_addr。 5.在无连接的数据报socket方式下,由于本地socket并没有与远端机器建立连接,所以在发送数据时应指明目的地址,sendto()函数原型为: int sendto(int sockfd, const void msg,int len unsigned int flags, const struct sockaddr to, int tolen); 该函数比send()函数多了两个参数,to表示目地机的IP地址和端口号信息,而tolen常常被赋值为sizeof (struct sockaddr)。 int PASCAL FAR sendto( SOCKET s, const char FAR* buf, int len, int flags, const struct sockaddr FAR* to, int tolen); s:一个标识套接口的描述字。 buf:包含待发送数据的缓冲区。 len:buf缓冲区中数据的长度。 flags:调用方式标志位。 to:(可选)指针,指向目的套接口的地址。 tolen:to所指地址的长度 6.recvfrom()函数原型为: int recvfrom(int sockfd,void buf,int len,unsigned int lags,struct sockaddr from,int *fromlen); from是一个struct sockaddr类型的变量,该变量保存源机的IP地址及端口号。fromlen常置为sizeof (struct sockaddr)。当recvfrom()返回时,fromlen包含实际存入from中的数据字节数 接收一个数据报并保存源地址。 int PASCAL FAR recvfrom( SOCKET s, char FAR* buf, int len, int flags, struct sockaddr FAR from, int FAR fromlen); s:标识一个已连接套接口的描述字。 buf:接收数据缓冲区。 len:缓冲区长度。 flags:调用操作方式。 from:(可选)指针,指向装有源地址的缓冲区。 fromlen:(可选)指针,指向from缓冲区长度值。 https://blog.csdn.net/qq_26399665/article/details/52426529 //sendto/recvfrom 7.fwrite(const voidbuffer,size_t size,size_t count,FILEstream); (1)buffer:是一个指针,对fwrite来说,是要输出数据的地址。 (2)size:要写入的字节数; (3)count:要进行写入size字节的数据项的个数; (4)stream:目标文件指针。 //Server_Udp(了解) 1.FILE fopen(char path, char * mode); path为包含了路径的文件名,mode为文件打开方式 2.bind()函数把一个地址族中的特定地址赋给socket。例如对应AF_INET、AF_INET6就是把一个ipv4或ipv6地址和端口号组合赋给socket。 int bind(int sockfd, const struct sockaddr *addr, socklen_t addrlen); 第二个参数是一个指向特定协议的地址结构的指针,第三个参数是该地址结构的长度。 3.size_t fread(void buffer,size_t size,size_t count,FILE stream) buffer 是读取的数据存放的内存的指针(可以是数组,也可以是新开辟的空间,buffer就是一个索引) size 是每次读取的字节数 count 是读取次数 ,k stream 是要读取的文件的指针
嵌入式&系统
# 嵌入式
刘航宇
4年前
0
1,110
5
2021-08-22
【线代】利用克拉默法则解决抽象线性方程组解
摘要克拉默法则适用于解决范德蒙形式矩阵的抽象线性方程组,通过行列式计算确定方程组的解。关键词:线性方程组, 克拉默法则, 抽象线性方程, 范德蒙形式矩阵, 解法克拉默法则可以解决含参的范德蒙形式矩阵 那么克拉默法则如下: 图片 图片 图片 图片
我的随笔
刘航宇
5年前
0
941
0
1
2
下一页