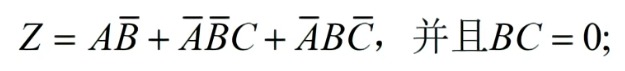🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,378 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,874 阅读
3
【高数】形心计算公式讲解大全
9,201 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,300 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,979 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
Rs(共100篇)
找到
100
篇与
Rs
相关的结果
- 第 3 页
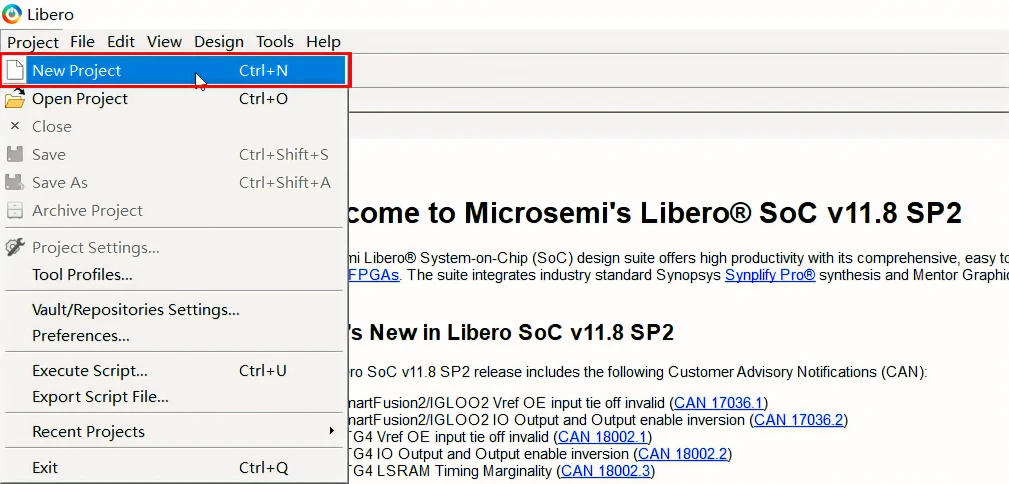
Microsemi Libero SOC使用示例—建立点灯工程
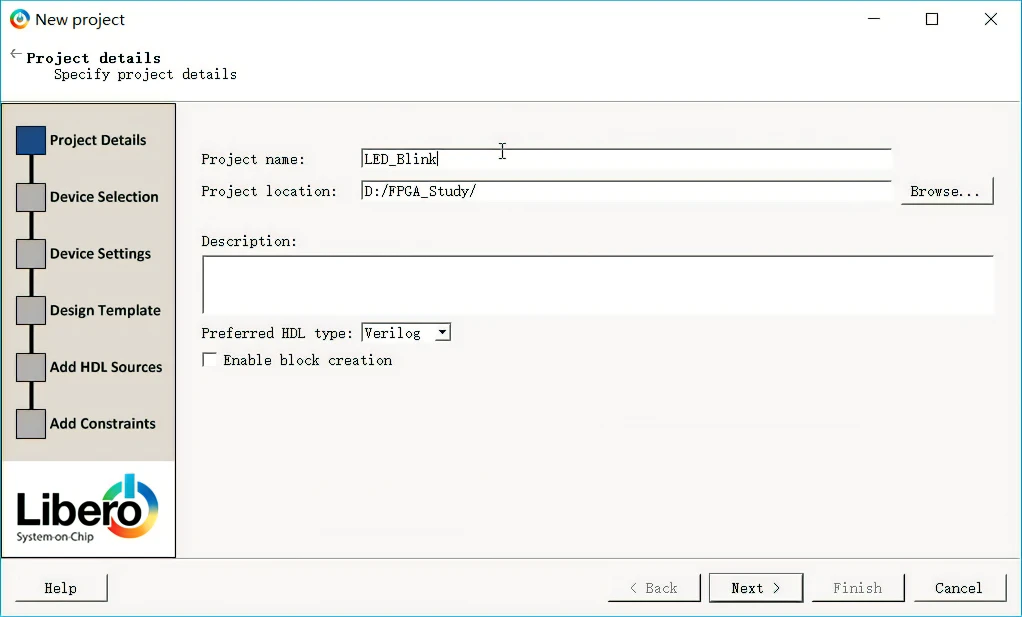
摘要本文介绍了如何使用Microsemi Libero集成开发环境建立点灯工程,通过Verilog编写点灯模块,进行仿真验证,管脚分配,最后下载程序到FPGA芯片,实现LED闪烁。关键词:Microsemi, Libero SoC, FPGA开发, 点灯实验, Verilog嵌入式开发中的Hello World,点灯是再也基础不过的实验了,通过点灯实验,可以了解芯片GPIO的控制和开发环境IDE新建工程的流程,对于FPGA来说,每个IO口几乎一样,所以本篇文章主要学习一下如何基于Microsemi Libero集成开发环境建立一个示例工程,让一个LED以500ms的频率闪烁,以Microsemi SmartFusion系列FPGA——A2F200M3F为例,Microsemi其他系列FPGA芯片过程类似。 准备工作软件准备: 硬件准备: 新建工程的主要步骤1.新建工程 2.添加设计文件 3.仿真验证 4.管脚分配 5.程序下载 Microsemi FPGA的Flash结构 准备工作 工欲利其事,必先利其器,充分的准备工作很有必要。 软件准备: Microsemi Libero SoC集成开发环境,并已经成功注册,软件版本推荐V11.8或更高版本。 硬件准备: Microsemi FPGA开发板,主控芯片A2F200M3F-PQ208,其他型号芯片类似。 Flash Pro 4或Flash Pro5下载器,用于给FPGA芯片下载程序和调试。 新建工程的主要步骤 新建工程,选择芯片型号等 新建设计,使用Verilog编写点灯模块。 仿真验证,对编写的点灯模块进行时序仿真,来验证是否满足设计需求。 综合、管脚分配、布局、布线。 生成程序文件,连接开发板,使用FlashPro下载程序到芯片内,观察现象是否和设计的一致。 1.新建工程 和大多数IDE一样,选择Project -> New Project,新建一个工程。 image.png图片 输入工程名称LED_Blink,选择工程存放的路径,工程名称和路径不要有中文字符和空格,选择源文件的类型Verilog或者VHDL。 image.png图片 选择芯片型号,这里选择Microsemi SmartFusion系列下的A2F200M3F芯片,PQ208封装,把鼠标放在所选芯片上,可以查看芯片的详细参数:封装、速度等级、温度范围,内核电压、Flash ROM大小、用户IO数目、RAM大小、Flash ROM大小,ARM Cortex-M3 SoC的外设配置等详细的参数。 图片 选择IO的电平标准,不同的电平标准,高低电平的电压范围是不同的,这里选择默认的LVTTL。 图片 是否创建MSS模块,MSS里有PLL和ARM Cortex-M3的使用,以后用到PLL和ARM核时再添加,这里先不选择,以后需要也可以再创建。 图片 是否导入已经存在的HDL文件,如果已经有一些写好的模块,可以在这里直接导入。 图片 是否导入已经存在的管脚约束文件,这里选择不添加,我们会在后面通过图形化工具来指定管脚。 图片 到这里,工程就创建完成了,然后会在存储路径下生成一个和工程名称一样的文件夹,工程相关的所以文件都存放在这里。主要包括以下几个文件夹: 图片 具体每个文件夹存放的是什么文件,我们在以后的文章再详细介绍。以上的工程配置在创建完工程之后,也可以再次更改,可以通过Project->Project Setting查看或更改配置: 图片 或者通过点击如下图标来进入配置界面: 图片 弹出如下窗口,和新建工程是一样的,可以更改FPGA的型号,但只限于同一个系列内。 2.添加设计文件 Microsemi Libero开发环境支持HDL方式和SmarDesign方式来创建设计,HDL方式支持VerilogHDL和VHDL两种硬件描述语言,而SmartDesign方式和Xilinx的Schematic原理图方式是一样的,是通过图形化的方式来对各个模块之间的连接方式进行编辑,两种方式都可以完成设计。由于本实验功能简单,所以以使用Verilog文件为例。 创建Verilog文件 创建Verilog文件有多种方式,可以直接双击左侧菜单中的Create Design->Create HDL 图片 或者点击File->New->HDL,这两种方式都可以创建一个Verilog设计文件,这里选择Verilog文件。 图片 输入模块名称:led_driver,不用添加.v后缀名,Libero软件会自动添加。 源代码: module led_driver( //input input clk, //clk=2MHz input rst_n, //0=reset //output output reg led ); parameter T_500MS = 999999; //1M reg [31:0] cnt; always @ (posedge clk) begin if(!rst_n) cnt <= 32'b0; else if(cnt >= T_500MS) cnt <= 32'b0; else //cnt < T_500MS cnt <= cnt + 32'b1; end always @ (posedge clk) begin if(!rst_n) led <= 1'b1; else if(cnt >= T_500MS) led <= ~led; end endmodule可以看到,代码非常的简单,定义一个计数器,系统时钟为2MHz=500ns,500ms=1M个时钟周期,当计数到500ms时,LED翻转闪烁。 3.仿真验证 编写完成,之后,点击对号进行语法检查,如果没有语法错误就可以进行时序仿真了。 新建Testbench文件 底部切换到Design Hierarchy选项卡,在led模块上右键选择Create Testbechch创建仿真文件,选择HDL格式。 图片 给创建的testbench文件名一般为模块名后加_tb,这里为:led_driver_tb,因为我们的板子外部晶体为2M,所以这里系统时钟周期为500ns,这个也可以在文件中更改。 图片 点击OK之后,可以看到,Libero软件已经为我们生成了一些基本代码,包括输入端口的定义,系统时钟的产生,输入信号的初始化等等。我们只需要再增加几行即可。 `timescale 1ns/100ps module led_driver_tb; parameter SYSCLK_PERIOD = 500;// 2MHZ reg SYSCLK; reg NSYSRESET; wire led; //add output reg initial begin SYSCLK = 1'b0; NSYSRESET = 1'b0; end initial begin #(SYSCLK_PERIOD * 10 ) NSYSRESET = 1'b0; //add system reset #(SYSCLK_PERIOD * 100 ) NSYSRESET = 1'b1; //add system set end always @(SYSCLK) //generate system clock #(SYSCLK_PERIOD / 2.0) SYSCLK <= !SYSCLK; led_driver led_driver_0 ( // Inputs .clk(SYSCLK), .rst_n(NSYSRESET), // Outputs .led(led ) //add port // Inouts ); endmodule仿真代码也非常简单,输入信号初始化,NSYSRESET在10个时钟周期之后拉低,100个时钟周期之后拉高。 使用ModelSim进行时序仿真 仿真代码语法检查无误后,可以进行ModelSim自动仿真,在安装Libero时,已经默认安装了ModelSim仿真软件,并和Libero进行了关联。直接双击Simulate,Libero会自动打开ModelSim。 图片 可以看到输入输出信号,已经为我们添加好了: 图片 先点击复位按钮,复位系统,然后设置要运行的时间,由于设计的是500ms闪烁一次,这里我们先运行2s,即2000ms,在ModelSim中2秒已经算是很长的时间了,然后点击时间右边的运行按钮,耐心等待,停止之后就会看到led按500ms变化一次的波形了,如下图所示,可以再添加一个cnt信号到波形观察窗口,可以看到cnt周期性的变化。 图片 使用2个光标的精确测量,可以看出,led每隔500ms翻转一次,说明程序功能是正确的。 4.管脚分配 与STM32等MCU不同,FPGA的引脚配置非常灵活,如STM32只有固定的几个引脚才能作为定时器PWM输出,而FPGA通过管脚分配可以设置任意一个IO口输出PWM,而且使用起来非常灵活,这也是FPGA和MCU的一个区别,当然其他的功能,如串口外设,SPI外设等等,都可以根据需要自己用HDL代码来实现,非常方便。 时序仿真正常之后,就可以进行管脚分配了,即把模块的输入输出端口,真正的分配到芯片实际的引脚上,毕竟我们的代码是要运行在真正的芯片上的。 打开引脚配置图形化界面 双击Create/Edit I/O Attributes,打开图形化配置界面,在打开之前,Libero会先进行综合(Synthesize)、编译(Complie),当都运行通过时,才会打开配置界面。 图片 分配管脚 管脚可视化配置工具使用起来非常简单:引脚号指定、IO的电平标准,内部上下拉等等,非常直观。把时钟、复位、LED这些管脚分配到开发板原理图中对应的引脚,在分配完成之后,可以点击左上角的commit and check进行检查。 图片 在分配完成之后,为了以后方便查看已经分配的引脚,可以导出一个pdc引脚约束文件,选择Designer窗口下的File->Export->Constraint File,会导出一个led_driver.pdc文件,保存在工程目录下的constraint文件夹。 图片 一些特殊管脚的处理 SmartFusion系列的FPGA芯片,在分配个别引脚,如35-39、43-47这些引脚时,直接不能分配,这些引脚属于MSS_FIO特殊引脚,具体怎么配置为通用IO,可以查看下一篇文章。而新一代的SmartFusion 2系列的FPGA芯片则没有这种情况。 5.程序下载 管脚分配完成之后,连接FlashPro下载器和开发板的JTAG接口,关闭Designer窗口,选择Program Device,耐心等待几分钟,如果连接正常,会在右侧输出编程信息:擦除、验证、编程等操作,下载完成之后,就会看到板子上的LED闪烁起来了。 Microsemi FPGA的Flash结构 和Altera、Xilinx不同,Microsemi FPGA在下载程序时,并不是下载程序到SPI Flash,而是直接下载到FPGA内部的。目前,FPGA 市场占有率最高的两大公司Xilinx和Altera 生产的 FPGA 都是基于 SRAM 工艺的,需要在使用时外接一个片外存储器以保存程序。上电时,FPGA 将外部存储器中的数据读入片内 RAM,完成配置后,进入工作状态;掉电后 FPGA 恢复为白片,内部逻辑消失。这样 FPGA 不仅能反复使用,还无需专门的 FPGA编程器,只需通用的 EPROM、PROM 编程器即可。而Microsemi的SmartFusion、SmartFusion2、ProASICS3、ProASIC3E系列基于Flash结构,具备反复擦写和掉电后内容非易失性, 因此基于Flash结构的FPGA同时具备了SRAM结构的灵活性和反熔丝结构的可靠性,这种技术是最近几年发展起来的新型FPGA实现工艺,目前实现的成本还偏高,没有得到大规模的应用。 示例工程下载 基于Libero V11.8.2.4的工程下载: LED_Blink.rar 下载地址:https://wcc-blog.oss-cn-beijing.aliyuncs.com/Libero/Libero-2/LED_Blink.rar 提取码:
嵌入式&系统
FPGA&ASIC
IP&SOC设计
# ASIC/FPGA
# 嵌入式
# SOC设计
刘航宇
3年前
0
2,079
2
2023-05-29
Windows安装Jupyter Notebook及机器学习的库
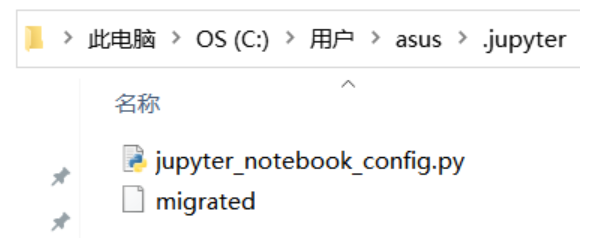
摘要本文介绍了在Windows上安装Jupyter Notebook及配置机器学习库的步骤,包括下载安装Jupyter Notebook、安装所需库、配置工作目录和可选的代码自动补全功能。关键词:Jupyter Notebook, Windows安装, 机器学习库, pip安装, Jupyter配置Jupyter Notebook安装(Windows) 下载Jupyter Notebook (1)打开cmd(如果没有把Python安装目录添加到Path,需要切换到Python安装目录的Scripts目录下); (2)输入pip install jupyter;(推荐在外网环境下安装) 2.库安装 下载下面文件 requirements.txt 下载地址:https://wwek.lanzoub.com/iLI2S0xm6a3a 提取码: 然后执行: pip3 install -r requirements.txt 启动Juypter Notebook (1)命令行窗口输入jupyter notebook;浏览器会打开Jupyter Notebook窗口,说明Jupyter Notebook安装成功。 (2) 配置Jupyter Notebook 1、行窗口输入jupyter notebook --generate-config,会发现C:\Users\用户名\ .jupyter下多出了一个配置文件jupyter_notebook_config.py; image.png图片 2、这个配置文件,找到下面这句#c.NotebookApp.notebook_dir = ''。 可以把它修改成c.NotebookApp.notebook_dir = 'D:\jupyter-notebook',当然具体的目录由自己创建的文件夹决定(需要自己创建)。 配置文件修改完成后,以后在jupyter notebook中写的代码都会保存在该目录下。现在重新启动jupyter notebook,就进入了新的工作目录; 5.添加代码自动补全功能(可选) (1)打开cmd,输入pip install jupyter_contrib_nbextensions,等待安装成功; (2)安装完之后需要配置nbextension(配置前要确保已关闭jupyter notebook),在cmd中输入jupyter contrib nbextension install --user --skip-running-check,等待配置成功; (3)在前两步成功的情况下,启动jupyter notebook,会发现在选项栏中多出了Nbextension的选项,点开该选项,并勾选Hinterland,即可添加代码自动补全功能。 image.png图片
机器学习
# 机器学习
刘航宇
3年前
0
494
1
FPGA&Matlab联合开发之滤波器模块(带通滤波器为例)
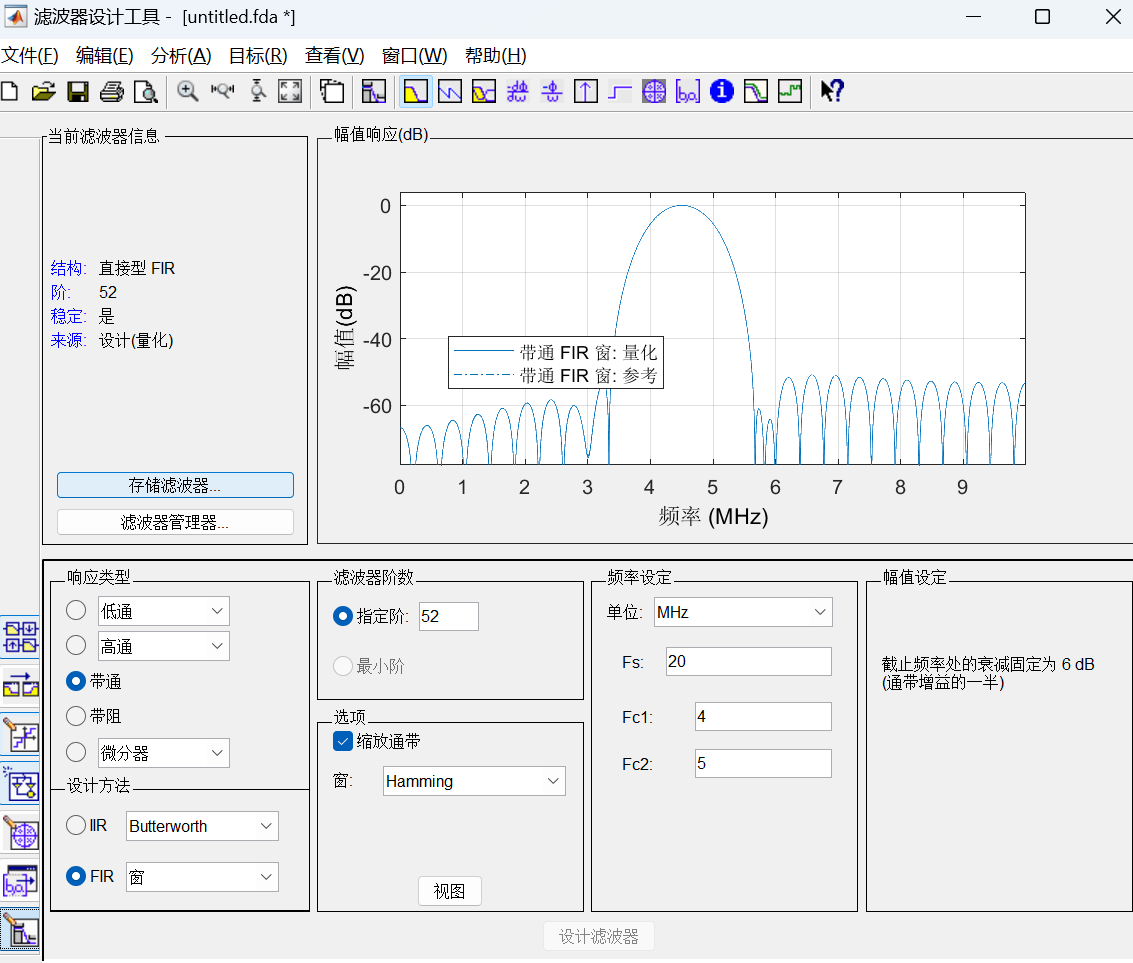
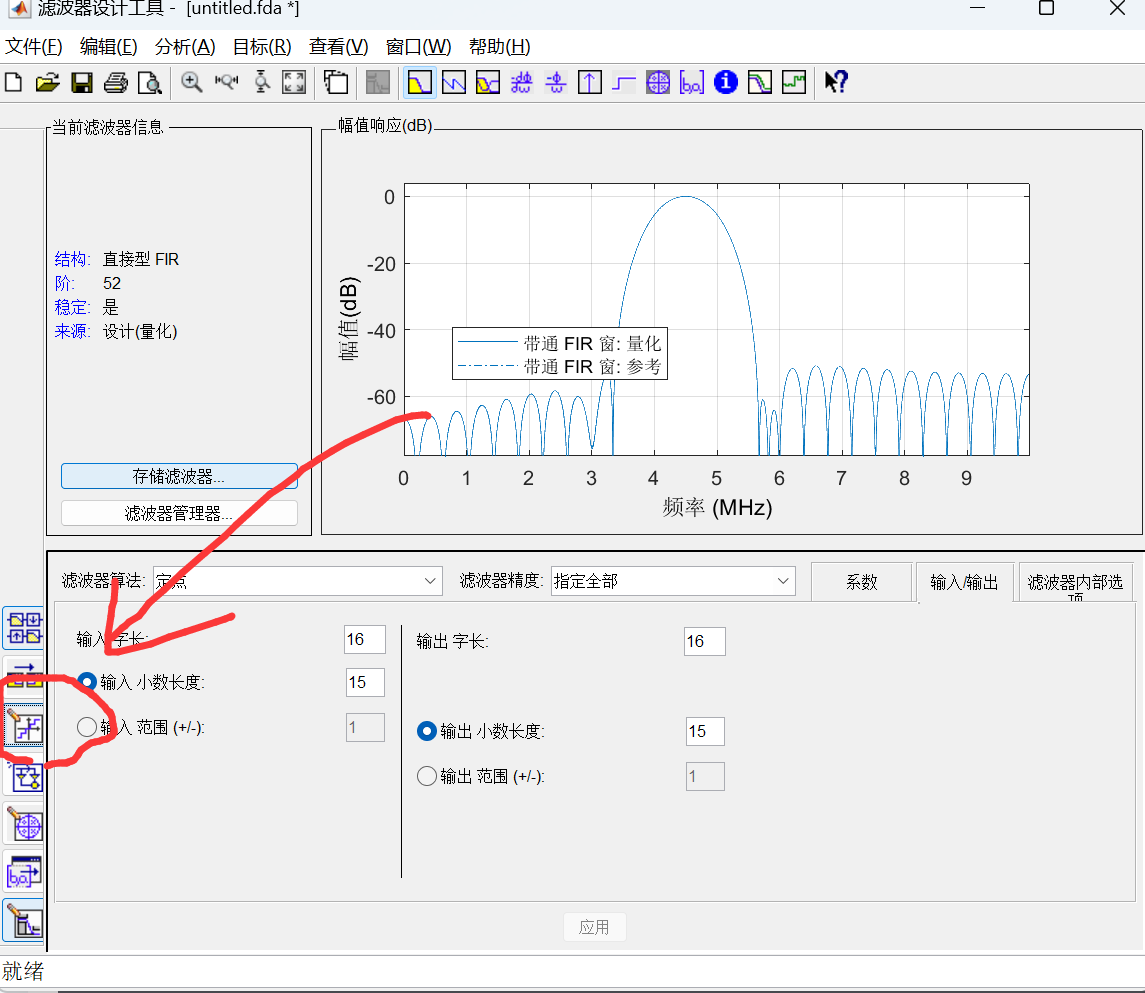
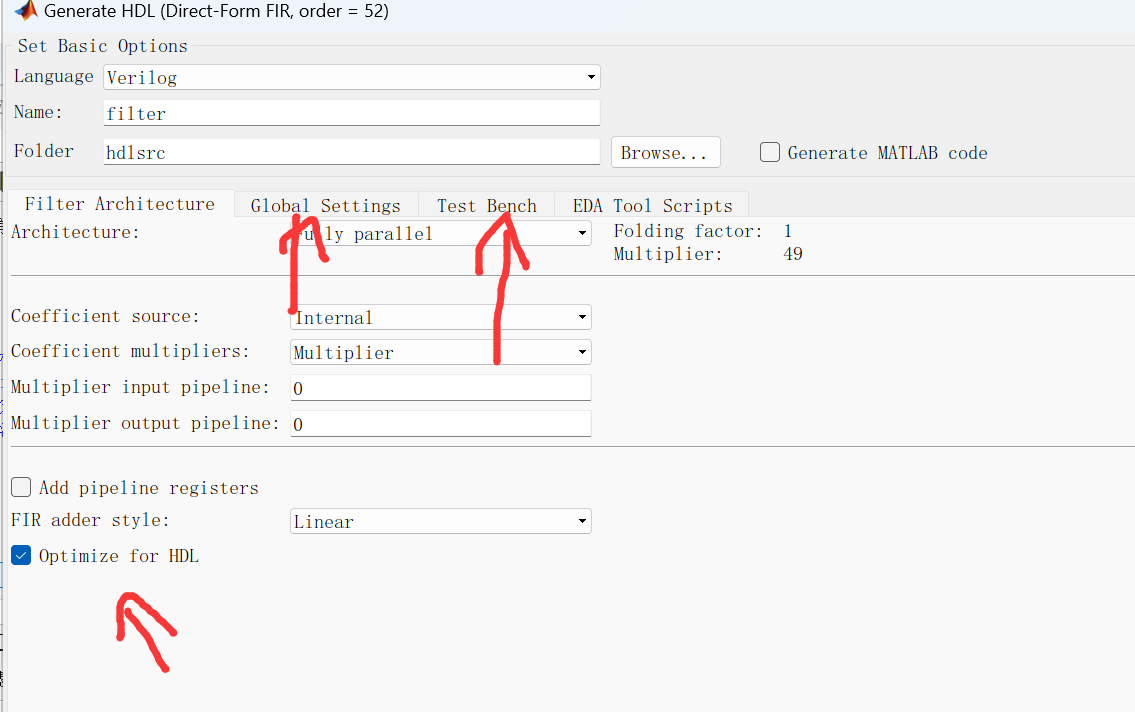
摘要本文介绍了利用Matlab设计带通滤波器的步骤,包括设置滤波器参数、量化输入输出、生成Verilog代码,并通过Modelsim仿真验证设计正确性。关键词:FPGA, Matlab, 带通滤波器, FIR滤波器, Verilog在通信或者信号处理中,数字滤波器是非常重要的模块,前面有关博文中提到FIR滤波器的一步步Verilog设计,如https://ee.ac.cn/index.php/archives/511.html 本文以带通滤波器为例,利用Matlab进行高效开发 目录 MATLAB生成低通滤波器设计步骤: Modelsim仿真上述文件 MATLAB生成低通滤波器设计步骤: (1)在MATLAB命令窗口中输入“filterDesigner”或“fdatool”出现如下对话框 image.png图片 设置FIR滤波器为和需要的阶数滤波器,选择窗函数的类型为海明窗函数,海明窗函数可以得到旁瓣更小的效果,能量更加集中在主瓣中 设置带通滤波器的上下截至频率分别为4MHz 和 5MHz (2)量化输入输出,点击工作栏左边的量化选项,即“set quantization parameters”选项,选择定点,设置输入字长为8,其他选择默认,如下图示: image.png图片 (3)根据自己需求,细化一些配置。这里不难探索 设置完成后,点击Targets中Generate HDL,选择生成Verilog 代码,设置路径,MATLAB即可生成设计好的滤波器Verilog HDL 代码以及测试文件: image.png图片 (4)根据需求,配置输出.v文件的全局信号、测试文件,点击生成,生成后,Matlab主页面会提示.v生成的文件路径 Modelsim仿真上述文件 image.png图片 可以看到输入信号在4MHZ~5MHZ备保留,设计无误。需要注意一点,一般Modelsim仿真输出波形都是离散的01信号,这里需要配置一下,在上图被选中的信号中,在左侧右键鼠标。 右击,format,analog(automatic); 右击,radix,decimal; 这两个步骤完成之后,就出现上图模拟信号的效果
嵌入式&系统
FPGA&ASIC
通信&信息处理
软硬件算法
# ASIC/FPGA
# 信号处理
# 硬件算法
刘航宇
3年前
0
740
2
2023-05-15
机器学习代码实现:线性回归与岭回归
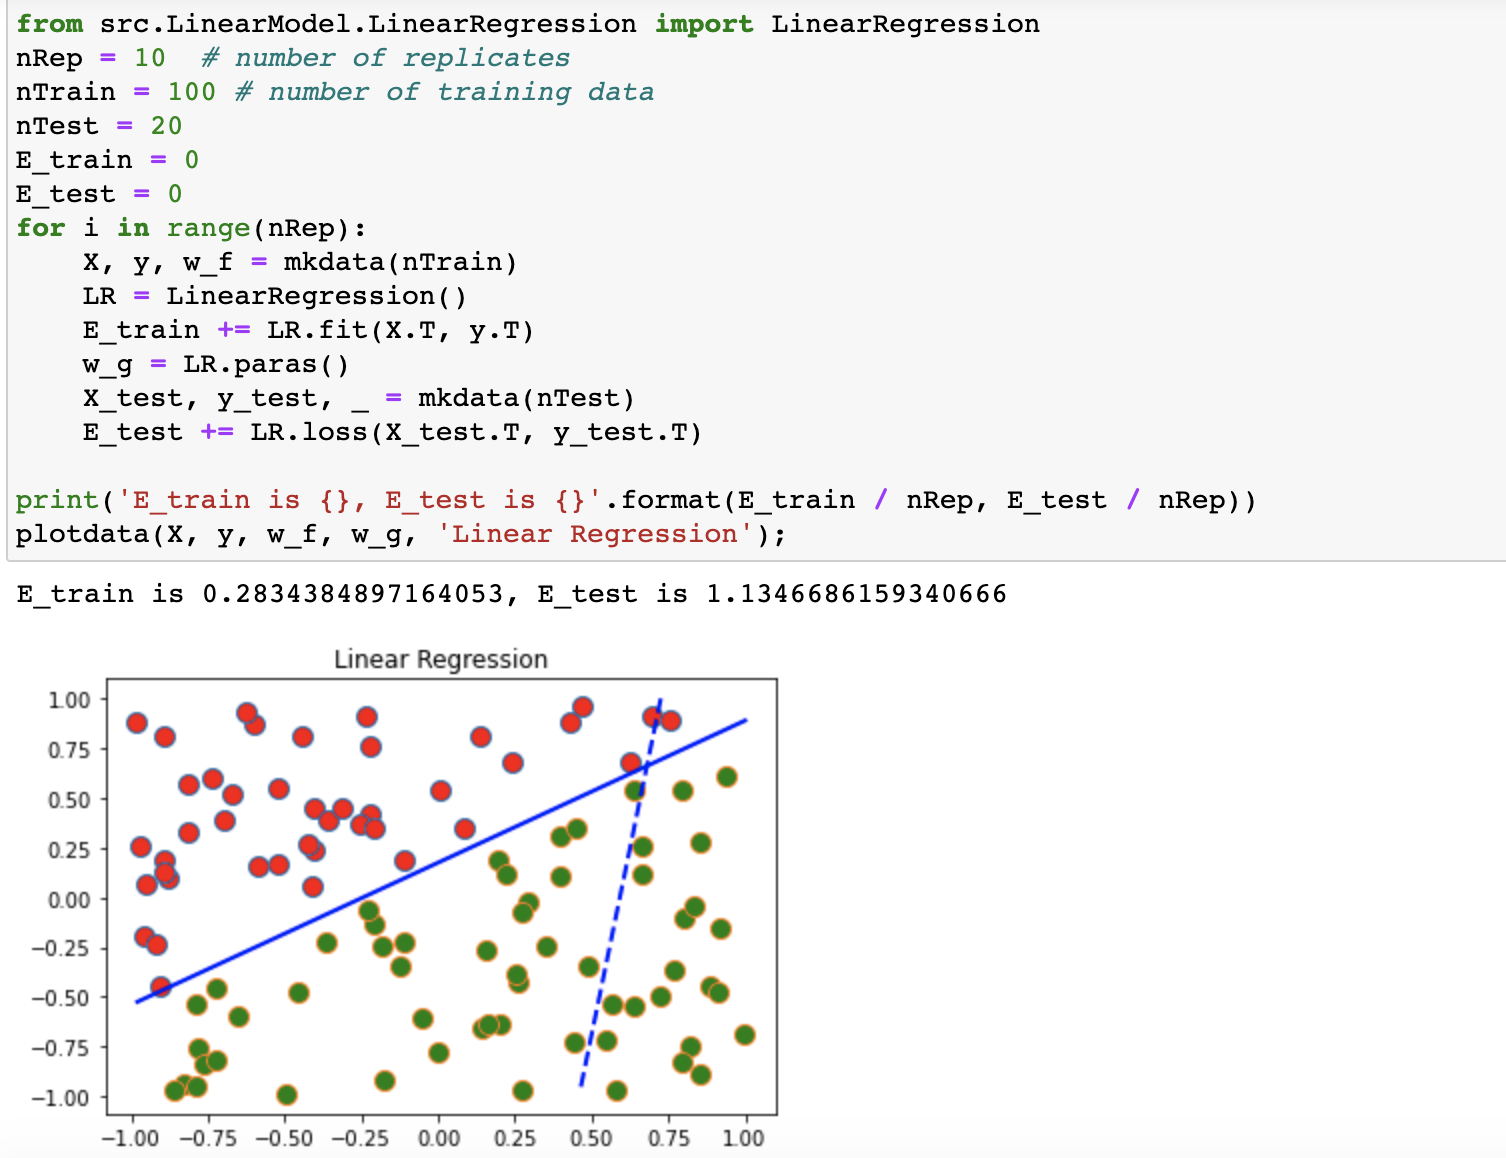
摘要本文介绍了线性回归和岭回归的机器学习模型及其代码实现。首先阐述了线性回归模型的基本原理和损失函数,然后展示了如何通过正规方程直接求解参数。接着,详细介绍了线性回归的Python实现,包括fit、predict和loss方法。最后,介绍了岭回归模型,并展示了如何通过增加正则项来控制参数规模,以及如何通过Python代码实现岭回归。关键词:机器学习, 线性回归, 岭回归, 梯度下降, 正规方程1.线性回归模型 线性回归模型是最简单的一种线性模型,模型的形式就是: $y=W^T x+b$ 我们可以通过对原本的输入向量x扩增一个为1的维度将参数W和b统一成一个参数W,即模型变成了 $y=W^T x$ 这里的W是原本两个参数合并之后的而其损失函数的形式是残差平方损失RSS $L=\frac{1}{2 m} \sum_{i=1}^m\left(W^T x_i-y_i\right)^2=\frac{1}{2 m}\left(W^T X-y\right)^T\left(W^T X-y\right)$ 我们很容易就可以通过求导得到线性回归模型的关于W的梯度 $\nabla_W L=\frac{1}{m} \sum_{i=1}^m\left(W^T x_i-y_i\right) x_i=\frac{1}{m} X^T\left(W^T X-y\right)$ 这样一来我们就可以通过梯度下降的方式来训练参数W,可以用下面的公式表示 $W:=W-\alpha \frac{1}{m} X^T\left(W^T X-y\right)$ 但实际上线性模型的参数W可以直接求解出,即: $W=\left(X^T X\right)^{-1} X^T y$ 2.线性回归的编程实现 具体代码中的参数的形式可能和上面的公式推导略有区别,我们实现了一个LinearRegression的类,包含fit,predict和loss三个主要的方法,fit方法就是求解线性模型的过程,这里我们直接使用了正规方程来解 class LinearRegression: def fit(self, X: np.ndarray, y: np.ndarray) -> float: N, D = X.shape # 将每个样本的特征增加一个维度,用1表示,使得bias和weight可以一起计算 # 这里在输入的样本矩阵X末尾增加一列来给每个样本的特征向量增加一个维度 # 现在X变成了N*(D+1)维的矩阵了 expand_X = np.column_stack((X, np.ones((N, 1)))) self.w = np.matmul(np.matmul(np.linalg.inv(np.matmul(expand_X.T, expand_X)), expand_X.T), y) return self.loss(X, y)predict实际上就是将输入的矩阵X放到模型中进行计算得到对应的结果,loss给出了损失函数的计算方式: def loss(self, X: np.ndarray, y: np.ndarray): """ 线性回归模型使用的是RSS损失函数 :param X:需要预测的特征矩阵X,维度是N*D :param y:标签label :return: """ delta = y - self.predict(X) total_loss = np.sum(delta ** 2) / X.shape[0] return total_loss3.岭回归Ridge Regression与代码实现 岭回归实际上就是一种使用了正则项的线性回归模型,也就是在损失函数上加上了正则项来控制参数的规模,即: $L=\frac{1}{2 m} \sum_{i=1}^m\left(W^T x_i-y_i\right)^2+\lambda\|W\|_2=\frac{1}{2 m}\left(W^T X-y\right)^T\left(W^T X-y\right)+\lambda W^T W$ 因此最终的模型的正规方程就变成了: $W=\left(X^T X+\lambda I\right)^{-1} X^T y$ 这里的\lambda是待定的正则项参数,可以根据情况选定,岭回归模型训练的具体代码如下 class RidgeRegression: def fit(self, X: np.ndarray, y: np.ndarray): N, D = X.shape I = np.identity(D + 1) I[D][D] = 0 expand_X = np.column_stack((X, np.ones((N, 1)))) self.W = np.matmul(np.matmul(np.linalg.inv(np.matmul(expand_X.T, expand_X) + self.reg * I), expand_X.T), y) return self.loss(X, y)4.数据集实验 这里使用了随机生成的二位数据点来对线性模型进行测试,测试结果如下: image.png图片 线性模型测试结果 岭回归也使用同样的代码进行测试。
机器学习
软硬件算法
# 机器学习
# 软件算法
刘航宇
3年前
0
404
1
联发科2024年数字IC设计验证实习生考题解析
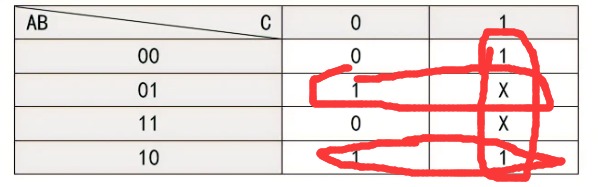
摘要本文解析了联发科2024年数字IC设计验证实习生考题,涵盖逻辑化简、ASIC flow、智力题、项目经验、编程、Verilog设计、DMA寄存器配置和二阶带通滤波器等内容,难度中等偏上。关键词:联发科, 数字IC设计验证, 实习生考题解析, 嵌入式工程师, STM32, FPGA总体而言难度中等偏上,如有错误欢迎指正,考察感觉更像是考察嵌入式工程师(有STM32、FPGA基础就很轻松):有数电、模电、python、verilog、C语言、SOC系统等基础知识,可以看到其实很对口电子信息类专业如电子信息、微电子、通信工程、电子科学、集成电路等专业,没有考察模集如果考模集大部分人要G,数集也没考,可能太底层了与工业界需求有偏差,数集在笔试面试中我认为如果考,可能考时序与功耗部分。这里的Round-Robin算法很值得学习。 目录 1、(20分)逻辑化简: 2、(5分)ASIC flow 中综合工具的作用是什么?综合的时候需要SDC文件进行约束,请列举3条SDC的语法。 3、(10分)智力题 4、(10分)选择参与过的任一个项目,简述项目内容以及流程,讲述您在项目中承担的任务,挑一项你认为难的地方并阐述解决方案。 5、(5分)用python写一个冒泡排序的函数以及测试程序。 6、(15分)用Verilog 写一个 Round Robin 仲裁器。模块端口如下: 7、(15分)关于DMA寄存器配置,DMA寄存器(地址 0x81050010)表: 8、(20分)二阶带通滤波器,利用RC组件搭建,通带范围 1kHz~30kHz ,两个电阻 R 均为10kΩ ,问两个电容容值多少? 1、(20分)逻辑化简: 图片 (1)列出真值表 (2)列出其卡诺图 (3)写出Z的最简表达式 答:卡诺图:卡诺图画完后勾1就完事了 提示:约束项的一般形式为:与或式 = 0 (如果不是此种形式,化为此种形式);如此题的BC = 0;或者AB +CD = 0;ABC + CD = 0;等等。BC=0(即B=1,且C=1)对应的格子画X。 图片 图片 2、(5分)ASIC flow 中综合工具的作用是什么?综合的时候需要SDC文件进行约束,请列举3条SDC的语法。 答:ASIC flow 中综合工具的作用是将RTL级的硬件描述语言转换为与特定工艺库相匹配的门级网表,同时进行优化以满足时序、面积和功耗等约束。 综合的时候需要SDC文件进行约束,SDC文件是一种基于Tcl的格式,用于指定设计的时序约束34。SDC文件中的常用时序约束语法有: create_clock -name <clock_name> -period <clock_period> [get_ports <clock_port>] 用于创建时钟源并指定时钟周期。 set_input_delay -clock <clock_name> <delay_value> [get_ports <input_port>] 用于指定输入端口相对于时钟源的延迟。 set_output_delay -clock <clock_name> <delay_value> [get_ports <output_port>] 用于指定输出端口相对于时钟源的延迟。 set_clock_uncertainty -setup <setup_value> -hold <hold_value> <clock_name> 用于指定时钟源的不确定性,包括建立时间和保持时间。 set_false_path -from [get_ports <source_port>] -to [get_ports <destination_port>] 用于指定不需要进行时序分析的路径。 set_multicycle_path -setup -from [get_clocks <source_clock>] -to [get_clocks <destination_clock>] <cycle_number> 用于指定多周期路径,即源时钟和目标时钟之间有多个周期的时间差。3、(10分)智力题 (1)2 12 1112 3112 132112 ,下一个数?给理由; 答:第一个数是2,第二个数是12,表示前一个数有1个2;第三个数是1112,表示前一个数有1个1和1个2;以此类推。所以,下一个数是1113122112,表示前一个数有1个1,1个3,2个1和2个2 (2)有一个小偷费劲力气进入到了银行的金库里。在金库里他找到了一百个箱子,每一个箱子里都装满了金币。不过,只有一个箱子里装的是真的金币,剩下的99个箱子里都是假的。真假金币的外形和质感完全一样,任何人都无法通过肉眼分辨出来。它们只有一个区别:真金币每一个重量为101克,而假金币的重量是100克。在金库里有一个电子秤,它可以准确地测量出任何物品的重量,精确到克。但很不幸的是,这个电子秤和银行的报警系统相连接,只要被使用一次就会立刻失效。请问,小偷怎么做才能只使用一次电子秤就找到装着真金币的箱子呢? 答:小偷可以这样做:从第一个箱子里拿出1个金币,从第二个箱子里拿出2个金币,从第三个箱子里拿出3个金币,以此类推,直到从第一百个箱子里拿出100个金币。然后,把所有拿出来的金币放在电子秤上,测量它们的总重量。如果所有的金币都是假的,那么总重量应该是5050克(等于1+2+3+…+100)。如果有一个箱子里是真的金币,那么总重量会比5050克多出一些。这个多出来的部分就是真金币的数量乘以1克。例如,如果第十一个箱子里是真的金币,那么总重量会比5050克多出11克,因为从第十一个箱子里拿出了11个真金币。所以,小偷只要看电子秤上显示的数字减去5050,就能知道哪个箱子里是真的金币了。 4、(10分)选择参与过的任一个项目,简述项目内容以及流程,讲述您在项目中承担的任务,挑一项你认为难的地方并阐述解决方案。 答:优先答ASIC的设计与验证项目,其次是FPGA项目(如基于FPGA的图像处理、天线阵、雷达、加速器等等),其它项目不要答。 5、(5分)用python写一个冒泡排序的函数以及测试程序。 # 定义冒泡排序函数 def bubble_sort(lst): # 获取列表长度 n = len(lst) # 遍历列表n-1次 for i in range(n-1): # 设置一个标志,用于判断是否发生交换 swapped = False # 遍历未排序的部分 for j in range(n-1-i): # 如果前一个元素大于后一个元素,交换位置 if lst[j] > lst[j+1]: lst[j], lst[j+1] = lst[j+1], lst[j] # 标志设为True,表示发生了交换 swapped = True # 如果没有发生交换,说明列表已经有序,提前结束循环 if not swapped: break # 返回排序后的列表 return lst # 定义测试程序 # 创建一个乱序的列表 lst = [5, 3, 8, 2, 9, 1, 4, 7, 6] # 打印原始列表 print("Original list:", lst) # 调用冒泡排序函数,对列表进行排序 lst = bubble_sort(lst) # 打印排序后的列表 print("Sorted list:", lst)结果图 image.png图片 6、(15分)用Verilog 写一个 Round Robin 仲裁器。模块端口如下: input clock; input reset_b; input [N-1:0] request; input [N-1] lock; output [N-1] grant; //one-hot此处的 lock 输入信号,表示请求方收到了仲裁许可,在对应的lock拉低之前,仲裁器不可以开启新的仲裁。(可简单理解为仲裁器占用) 该题要求参数化编程,在模块例化时可调整参数。也即是说你不能写一个固定参数,比如N=8的模块。 参考波形图: image.png图片 答: Round-Robin算法:当有多个设备同时想占用同一个资源时,需要仲裁器通过某种调度算法决定不同设备使用资源的先后顺序。 Round Robin算法就是其中一种调度算法,其思路是,当多个仲裁请求(request)送给仲裁器时,仲裁器通过轮询的方式分时给不同的设备返回许可(grant),当一个requestor 得到了grant许可之后,它的优先级在接下来的仲裁中就变成了最低,当同时有多个requestor的时候,grant可以依次给到每个requestor,即使之前高优先级的requestor再次有新的request,也会等前面的requestor都grant之后再轮到它。由此看出,Round Robin算法是一种公平的算法,它避免了当最高优先级的requestor不断有新的request时,具有最高优先级的requestor一直占用资源,导致其他requestor无法占用资源的阻塞现象。 在verilog设计中,如何实现呢?假设request是位宽是6,最高位是第5位,最低位是第0位,默认低比特位具有高优先级。 1.首先需要找到request中优先级最高的比特位,对优先级最高的比特位给出许可信号。这一步可以通过request和它的2的补码按位与。这是因为一个数和它的补码相与,得到的结果是一个独热码,独热码为1的那一位是这个数最低的1。 2.在下一轮仲裁中,已经被仲裁许可的比特位变成了最低优先级,而未被仲裁许可的比特位将会被仲裁。因此对第一步中给出许可的比特位(假设是第2位)以及它的低比特位进行屏蔽,对request中的第5位到第3位进行保持,这个操作可以利用掩码111000和request相与实现得到。 得到掩码的方法是,对第一步的许可信号grant-1,再与grant本身相或,相或的结果再取反。 3.通过第二步得到第2位到第0位被屏蔽的request_new信号,判断request_new是否为全0信号,如果是全0信号,代表此时不存在需要被仲裁的比特位,则返回第一步:找到request中优先级最高的比特位,对优先级最高的比特位给出许可信号,然后进行第二步。如果request_new不是全0信号,代表存在未被仲裁的比特位,则找到request_new中优先级最高的比特位,对优先级最高的比特位给出许可信号,然后进行第二步。 // 功能: // -1- Round Robin 仲裁器 // -2- 仲裁请求个数N可变 // -3- 加入lock机制(类似握手) // -4- 复位时的最高优先级定为 0 ,次优先级:1 -> 2 …… -> N-2 -> N-1 `timescale 1ns / 1ps module RoundRobinArbiter #( parameter N = 4 //仲裁请求个数 )( input clock, input reset_b, input [N-1:0] request, input [N-1:0] lock, output reg [N-1:0] grant//one-hot ); // 模块内部参数 localparam IDLE = 3'b001;// 复位进入空闲状态,接收并处理系统的初次仲裁请求 localparam WAIT_REQ_GRANT = 3'b010;// 等待后续仲裁请求到来,并进行仲裁 localparam WAIT_LOCK = 3'b100;// 等待LOCK拉低 // 模块内部信号 reg [2:0] R_STATUS; //请求状态 reg [N-1:0] R_MASK; //掩码 wire [N-1:0] W_REQ_MASKED; assign W_REQ_MASKED = request & R_MASK; //屏蔽低位 always @ (posedge clock) begin if(~reset_b) begin R_STATUS <= IDLE; R_MASK <= 0; grant <= 0; end else begin case(R_STATUS) IDLE: begin if(|request) //首次仲裁请求,不全为0 begin R_STATUS <= WAIT_LOCK; //首先需要找到request中优先级最高的比特位,对优先级最高的比特位给出许可信号。 //这一步可以通过request和它的2的补码按位与。这是因为一个数和它的补码相与,得到的结果是一个独热码,独热码为1的那一位是这个数最低的1 grant <= request & ((~request)+1); R_MASK <= ~((request & ((~request)+1))-1 | (request & ((~request)+1))); //得到掩码的方法是,对第一步的许可信号grant-1,再与grant本身相或,相或的结果再取反。 end else begin R_STATUS <= IDLE; end end WAIT_REQ_GRANT://处理后续的仲裁请求 begin if(|request) begin R_STATUS <= WAIT_LOCK; //在下一轮仲裁中,已经被仲裁许可的比特位变成了最低优先级,而未被仲裁许可的比特位将会被仲裁。 //因此对第一步中给出许可的比特位(假设是第2位)以及它的低比特位进行屏蔽,对request中的第5位到第3位进行保持 //这个操作可以利用掩码111000和request相与实现得到。 if(|(request & R_MASK))//不全为零 begin grant <= W_REQ_MASKED & ((~W_REQ_MASKED)+1); R_MASK <= ~((W_REQ_MASKED & ((~W_REQ_MASKED)+1))-1 | (W_REQ_MASKED & ((~W_REQ_MASKED)+1))); end else begin grant <= request & ((~request)+1); R_MASK <= ~((request & ((~request)+1))-1 | (request & ((~request)+1))); end end else begin R_STATUS <= WAIT_REQ_GRANT; grant <= 0; R_MASK <= 0; end end //通过第二步得到第2位到第0位被屏蔽的request_new信号, //判断request_new是否为全0信号,如果是全0信号,代表此时不存在需要被仲裁的比特位,则返回第一步:找到request中优先级最高的比特位, //对优先级最高的比特位给出许可信号,然后进行第二步。如果request_new不是全0信号,代表存在未被仲裁的比特位, //则找到request_new中优先级最高的比特位,对优先级最高的比特位给出许可信号,然后进行第二步。 WAIT_LOCK: begin if(|(lock & grant)) //未释放仲裁器 begin R_STATUS <= WAIT_LOCK; end else if(|request) //释放的同时存在仲裁请求 begin R_STATUS <= WAIT_LOCK; if(|(request & R_MASK))//不全为零 begin grant <= W_REQ_MASKED & ((~W_REQ_MASKED)+1); R_MASK <= ~((W_REQ_MASKED & ((~W_REQ_MASKED)+1))-1 | (W_REQ_MASKED & ((~W_REQ_MASKED)+1))); end else begin grant <= request & ((~request)+1); R_MASK <= ~((request & ((~request)+1))-1 | (request & ((~request)+1))); end end else begin R_STATUS <= WAIT_REQ_GRANT; grant <= 0; R_MASK <= 0; end end default: begin R_STATUS <= IDLE; R_MASK <= 0; grant <= 0; end endcase end end endmodule测试代码 `timescale 1ns / 1ps module RoundRobinArbiter_tb; parameter N = 4; // 可以在测试时调整参数 // 定义测试信号 reg clock; reg reset_b; reg [N-1:0] request; reg [N-1:0] lock; wire [N-1:0] grant; // 定义时钟信号 initial clock = 0; always #10 clock = ~clock; // 实例化仲裁器模块 RoundRobinArbiter #( .N(N) ) inst_RoundRobinArbiter ( .clock (clock), .reset_b (reset_b), .request (request), .lock (lock), .grant (grant) ); // 定义时钟周期和初始值 initial begin reset_b <= 1'b0; request <= 0; lock <= 0; end // 定义请求和锁定信号的变化 initial begin #20; reset_b <= 1'b1; @(posedge clock) request <= 2; lock <= 2; @(posedge clock) request <= 0; @(posedge clock) request <= 5; lock <= 7; @(posedge clock) lock <= 5; @(posedge clock) request <= 1; @(posedge clock) lock <= 1; @(posedge clock) request <= 0; @(posedge clock) lock <= 0; #1000 $stop; // 测试结束 end // 显示测试结果和波形图 initial begin $monitor("Time=%t, clock=%b, reset_b=%b, request=%b, lock=%b, grant=%b", $time, clock, reset_b, request, lock, grant); $dumpfile("RoundRobinArbiter_tb.vcd"); $dumpvars(0,RoundRobinArbiter_tb); end endmodule结果: image.png图片 如果对波形图无法理解可以看此博文 https://blog.csdn.net/m0_49540263/article/details/114967443 7、(15分)关于DMA寄存器配置,DMA寄存器(地址 0x81050010)表: image.png图片 image.png图片 Type 表示读写类型。Reset 表示复位值。 写一个C函数 void dma_driver(void),按步骤完成以下需求: 分配DMA所需的源地址(0x30) 分配DMA所需的目的地址(0x300) 设置传输128 Byte 数据 开始DMA传输 等待DMA传输结束 答: // 假设有以下宏定义 #define DMA_REG 0x81050010 // DMA控制寄存器的地址 #define DMA_SRC_ADDR 0x30 // DMA源地址 #define DMA_DST_ADDR 0x300 // DMA目的地址 #define DMA_SIZE 128 // DMA传输大小 #define DMA_START 1 // DMA开始传输的标志位 // 定义C函数 void dma_driver(void) void dma_driver(void) { // 定义一个指向DMA控制寄存器的指针 volatile uint32_t *dma_reg = (volatile uint32_t *)DMA_REG; // 清空DMA控制寄存器的值 *dma_reg = 0; // 设置DMA源地址,目的地址和传输大小 *dma_reg |= (DMA_SRC_ADDR << 2) | (DMA_DST_ADDR << 13) | (DMA_SIZE << 24); // 开始DMA传输 *dma_reg |= DMA_START; // 等待DMA传输结束 while (*dma_reg & DMA_START) { // 可以在这里做一些其他的事情,比如打印日志或者检查错误 // printf("Waiting for DMA to finish...\n"); // check_error(); } }官方一点的表达:DMA,全称为:Direct Memory Access,即直接存储器访问。直接存储器存取( DMA )用来提供在外设和存储器之间或者存储器和存储器之间的高速数据传输。无须 CPU 干预,数据可以通过 DMA 快速地移动,这就节省了 CPU 的资源来做其他操作。典型的例子就是移动一个外部内存的区块到芯片内部更快的内存区。像是这样的操作并没有让处理器工作拖延,反而可以被重新排程去处理其他的工作。DMA 传输对于高效能嵌入式系统算法和网络是很重要的。DMA 传输方式无需 CPU 直接控制传输,也没有中断处理方式那样保留现场和恢复现场的过程,通过硬件为 RAM 与 I/O 设备开辟一条直接传送数据的通路, 能使 CPU 的效率大为提高。 8、(20分)二阶带通滤波器,利用RC组件搭建,通带范围 1kHz~30kHz ,两个电阻 R 均为10kΩ ,问两个电容容值多少? 答:第一步首得知道二阶带通(RC)滤波器的电路长啥样,高、低通组合一下就是带通,自己思考一下高、低通组合:如串联或并联,会得到带通还是带组? 电路图: H___H21L__E34_WC@43F1_8.jpg图片 这个一看就是总传递函数=A1*A2(模电二阶有源或无源滤波器绝对有) _LIYXIHR_08YNK__EV8SXDH.jpg图片 然后化简 X25LO__~TXMGO59LTLV@9S9.jpg图片 根据推导得到的表达式,对于 jwRC2 ,这一项,当 w 趋于无穷大时,uo/ui 趋于零。那么高频的临界点就是 wRC2 = 1+2C2/C1;(此时忽略低频项1/jwRC1) 同理,对于低频项 1 /jwRC1, w 趋于无穷小时,uo/ui 趋于零 ,那么低频的临界点就是 1/wRC1 = 1+2C2/C1;然后解二元一次方程两个电容就被解出来了 这里提供一种更简单方法: 二阶带通滤波器的中心频率 f0 和品质因数 Q 可以用下面的公式计算: image.png图片 已知 R1 = R2 = 10kΩ,f0 = (1kHz + 30kHz) / 2 = 15.5kHz,Q = f0 / (30kHz - 1kHz) = 0.54,代入上面的公式,可以求得: image.png图片 这是一个二元一次方程组,可以用任意方法求解,例如消元法或代入法。为了方便起见,我们假设 C1 和 C2 的值相近,那么可以近似地认为 C1 = C2 = 3.45nF。这样就得到了两个电容的容值。当然,也可以选择其他的电容值,只要满足上面的方程组即可。
FPGA&ASIC
软硬件算法
# 笔试面试
刘航宇
3年前
0
2,280
9
【电路基础】ASIC角度练习JK触发器&RS触发器
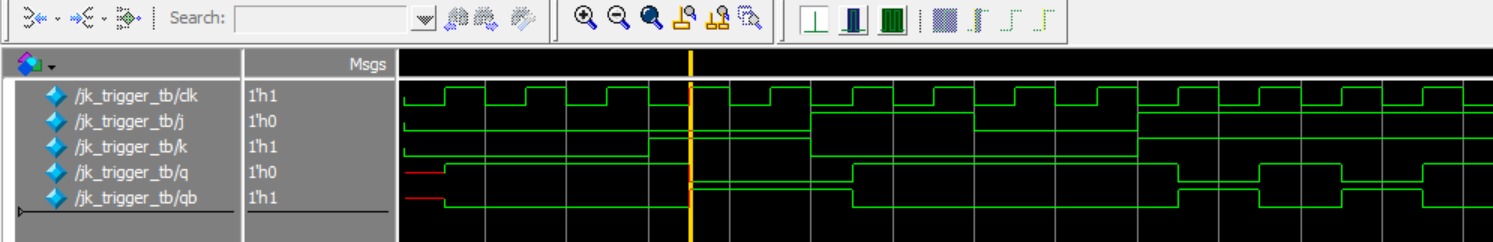
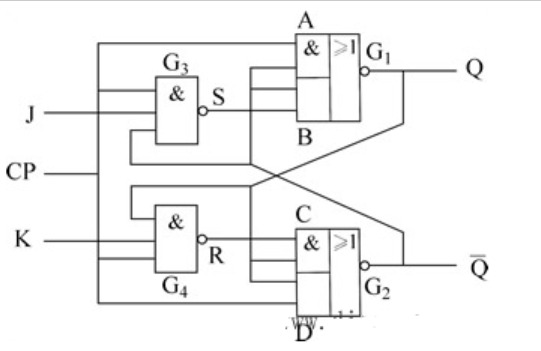
摘要本文介绍了JK触发器和RS触发器的原理、硬件描述语言实现、时序图、电路图以及性能分析。通过Verilog语言实现了JK和RS触发器,并进行了仿真测试,验证了其功能正确性。关键词:ASIC, JK触发器, RS触发器, 硬件描述语言, Verilog由于本电路极其简单,原理不做解释 目录 JK触发器真值表 硬件描述语言 JK触发器时序 JK触发器电路图 JK触发器性能--SMIC180nm工艺 RS触发器真值表 RS硬件描述语言 RS触发器时序 RS触发器电路图 RS触发器性能--SMIC180nm工艺 JK触发器 真值表 图片 硬件描述语言 代码 //边沿JK触发器-时序逻辑 //作者:刘航宇 2023/4/15 //Email:hyliu@ee.ac.cn module jk_trigger(clk,j,k,q,qb); input clk,j,k; output q,qb; reg q; wire qb; always @(posedge clk) begin case ({j,k}) 2'b00: q<=1; //jk=00,保持 2'b01: q<=1'b0; //jk=01,则触发器置0 2'b10: q<=1'b1; //jk=10,则触发器置1 2'b11: q<=~q; //11,翻转 //组合逻辑中,为避免生成锁存器,好的代码风格是if语句都加上else,case语句都加上default。 //时序逻辑中,“若无必要,尽量不加else和default”——以减小数据翻转机会,低功耗。 //故此处不写default endcase end assign qb = ~q; endmodule测试文件 //jk触发器测试文件 `timescale 1ns/1ps module jk_trigger_tb; reg j,k,clk;//输入reg是因为要initial wire q,qb; always begin #5 clk = ~clk; end //初始化 //下面这个产生fsdb是Synopsys VCS&Makefile脚本会用到,如果你用Medelsim仿真请删掉这个initial语句以免报错 initial begin $fsdbDumpfile("tb.fsdb");//这个是产生名为tb.fsdb的文件 $fsdbDumpvars; end initial begin clk = 0; j = 1'b0; k = 1'b0;//保持 #30 begin j=1'b0;k=1'b1; end //置0 #20 begin j=1'b1;k=1'b0; end //置1 #20 begin j=1'b0;k=1'b0; end //保持 #20 begin j=1'b1;k=1'b1; end //翻转 #200 $finish; end jk_trigger u1(.j(j),.k(k),.clk(clk),.q(q),.qb(qb)); endmoduleJK触发器时序 上升沿触发,可以看到时序完全正确 图片 JK触发器电路图 图片 之所以这样综合电路综合出一个D触发器,是考虑标准单元库的面积与时序的折中,标准单元相当于基本晶体管搭建而成,比如反相器占用2个晶体管,与非门占用4个晶体管,具体不在赘叙。 图片 图片 JK触发器性能--SMIC180nm工艺 图片 RS触发器 真值表 图片 RS硬件描述语言 代码 //边沿JK触发器-时序逻辑 //作者:刘航宇 2023/4/15 //Email:hyliu@ee.ac.cn module rs_trigger( input wire clk,r,s, output reg q, output wire qb ); always @(posedge clk) begin case ({r,s}) 2'b00: q<=q; //r,s同时为低电平,触发器保持状态不变 2'b01: q<=1'b1; //触发器置1 2'b10: q<=1'b0; //触发器置0 2'b11: q<=1'bx; //不定态 endcase end assign qb = ~q; endmodule测试代码 `timescale 1ns/1ps module rs_trigger_tb(); reg clk,r,s; wire q,qb; always begin #5 clk = ~clk; end //初始化 initial begin clk = 0; r = 1'b0; s = 1'b0;//保持 #30 r=1'b0;s=1'b1; //置1 #20 r=1'b1;s=1'b0; //置0 #20 r=1'b0;s=1'b0; //保持 #20 r=1'b1;s=1'b1; //禁止 #200 $stop; end rs_trigger u2(.clk(clk),.r(r),.s(s),.q(q),.qb(qb)); endmoduleRS触发器时序 上升沿触发,可以看到时序完全正确 图片 RS触发器电路图 image.png图片 image.png图片 image.png图片 RS触发器性能--SMIC180nm工艺 image.png图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
3年前
0
1,565
2
2023-04-12
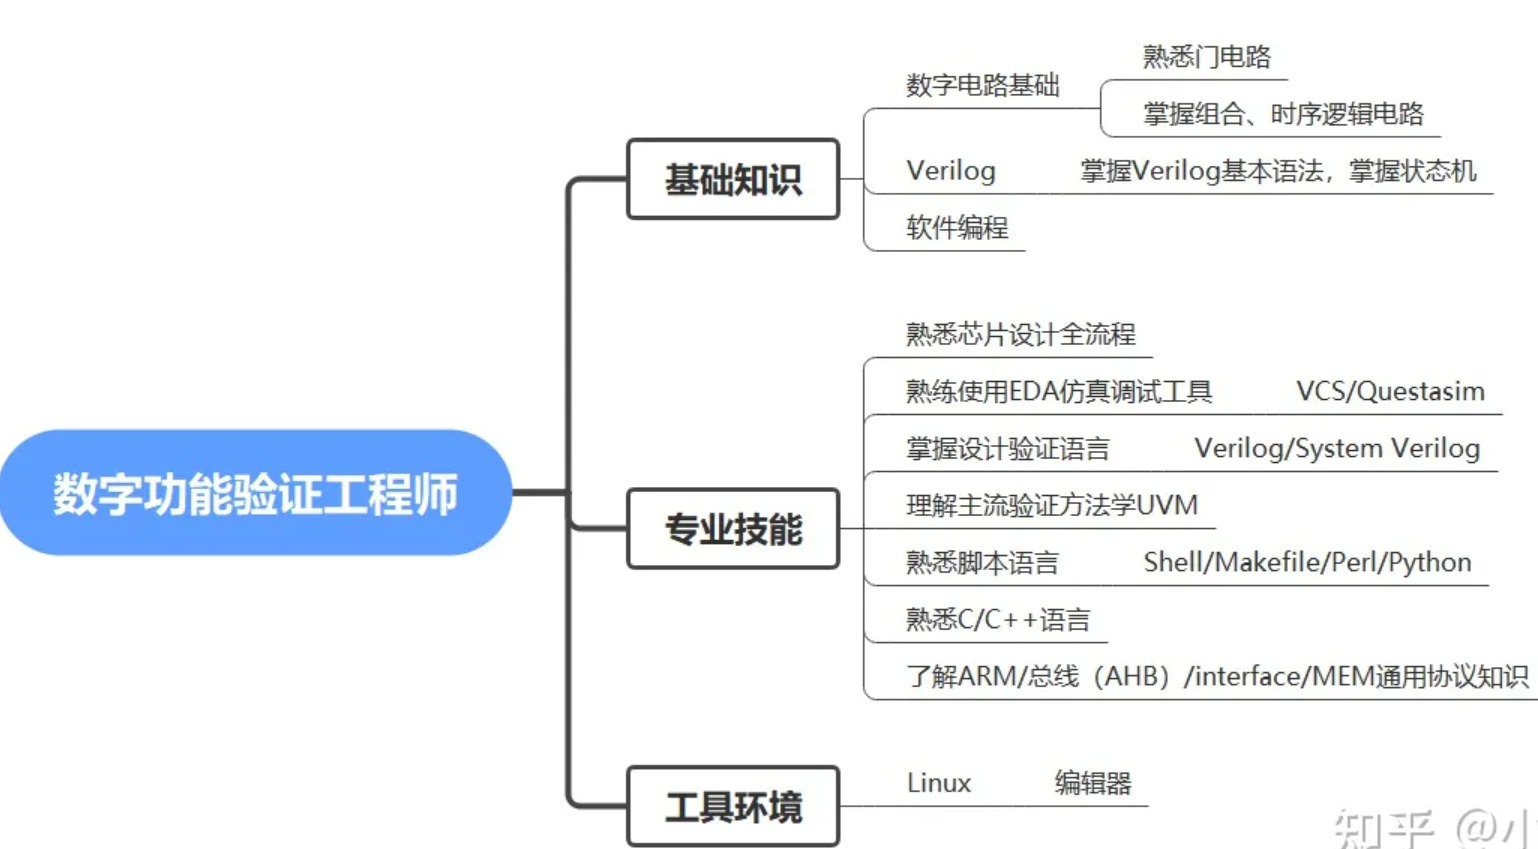
浅谈如何学好IC验证
摘要本文探讨了如何成为一名IC验证工程师,强调了从基础数字电路知识到掌握SystemVerilog、UVM等验证语言和方法的重要性,并介绍了学习UVM的资源和途径。关键词:IC验证, 数字电路, Verilog, SystemVerilog, UVM要成为一名IC验证工程师,一定要懂一些设计,如果都不清楚自己在验什么东西,后面的工作也都无从谈起了。所以在时间足够的情况下,最好从最基础的数字电路知识开始学习,之后是 Verilog → SystemVerilog → UVM 这样一个顺序,需要具备以下一些能力: 掌握数字电路和Verilog的基础知识,了解芯片设计的流程和结构。 学习SystemVerilog和UVM等验证语言和方法学,能够搭建和使用验证环境,构建测试用例和激励场景。 熟悉Linux操作系统和常用的EDA工具,能够使用脚本语言如Perl或Python进行自动化测试。 能够阅读和理解设计规格,分析设计功能和边界条件,设计有效的覆盖率和断言。 能够对设计缺陷进行调试和修改建议,与设计工程师进行沟通和协作。 不断学习新的协议、技术和验证方法,提高验证效率和质量。 图片 学习UVM的方法有很多,但是一般来说,需要具备以下几个方面的知识: SystemVerilog的基础语法和面向对象编程的概念,如类、继承、多态等。 UVM的基本构架和组件,如test、env、agent、driver、monitor、sequencer、sequence等,以及它们之间的连接和通信机制。 UVM的高级功能和技巧,如factory、callback、register model、coverage等,以及如何使用它们来提高验证效率和可重用性。 UVM的实际应用和案例分析,如如何搭建一个完整的UVM验证环境,如何编写不同类型的测试用例,如何处理异常情况等。 为了学习UVM,可以参考以下一些资源: Verification Academy是一个提供免费在线课程和视频的网站,其中有专门针对UVM的基础和进阶课程,以及一些实例代码和演示。 https://verificationacademy.com/courses/uvm-basics UVM实战是一本中文书籍,介绍了UVM的基本概念和方法,以及一些常见的验证场景和技巧。 UVM Cookbook3是一个在线文档,提供了UVM的各种知识点和示例代码,可以作为一个参考手册。 https://www.cnblogs.com/dpc525/p/5047032.html
我的随笔
VLSI&IC验证
刘航宇
3年前
0
912
4
【IC/CPU设计】极简的RISC_CPU设计
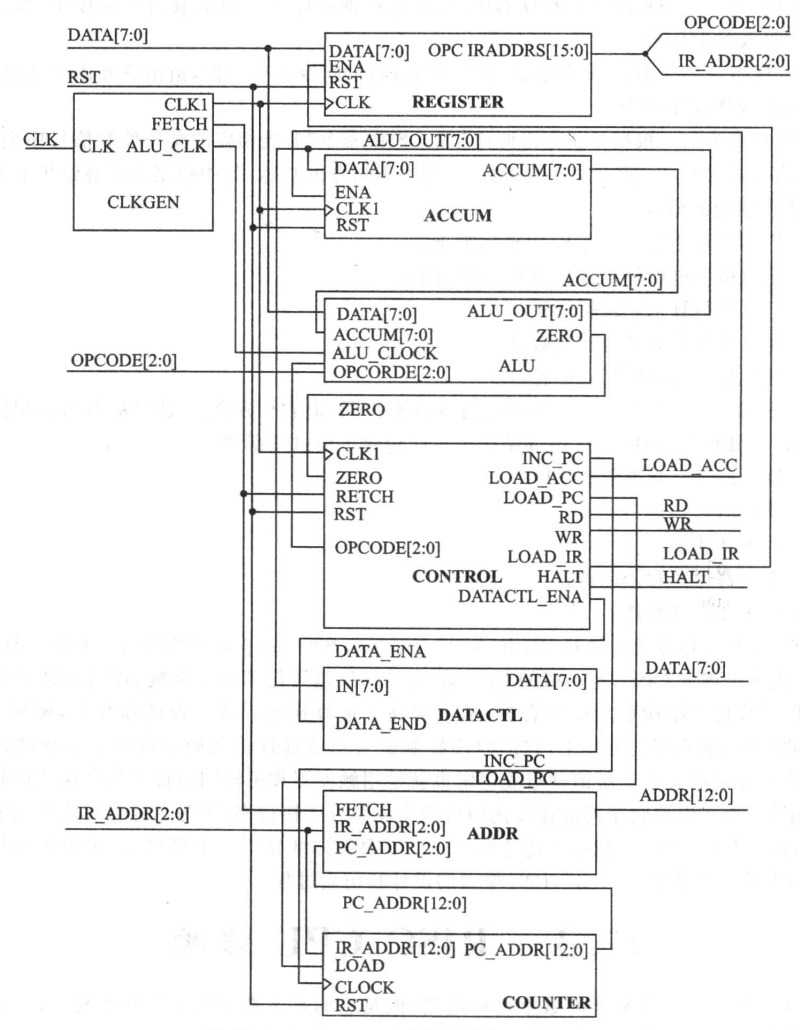
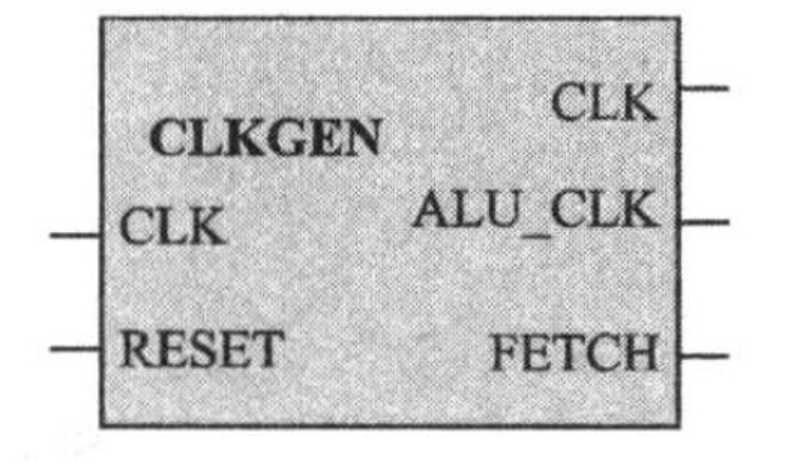
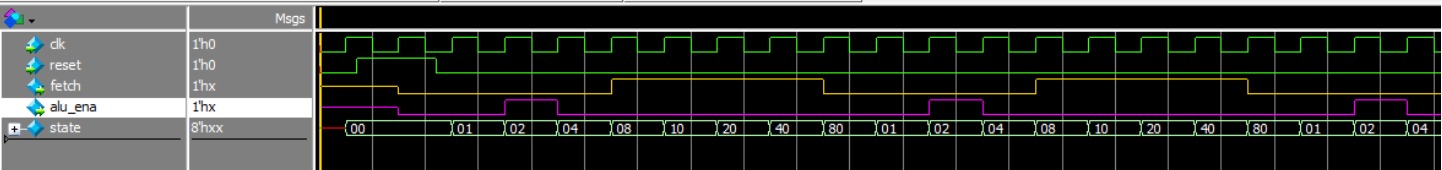
摘要本文介绍了RISC_CPU的设计,包括其内部结构、Verilog实现和测试过程。该项目旨在帮助数字IC工程师入门,并探讨了如何进一步优化和扩展。关键词:RISC_CPU, Verilog, 数字IC设计, CPU架构, 算术逻辑单元CPU为SOC系统的核心环节,该项目来自于夏宇闻老师的经典教材——《Verilog 数字系统设计教程》,通过此练习方便数字ICer更好的入门 本次项目实践环境: 前仿: Modelsim 综合: Design Compile 目录 CPU简介 整体结构时钟发生器 指令寄存器 累加器 算术运算器数据控制器 地址多路器 程序计数器 状态控制器&主状态机 外围模块地址译码器 RAM ROM 顶层模块 TestbenchTest1程序 Test3程序 完整的testbench 源代码&脚本 前仿真结果 DC后仿真 总结 源代码&脚本 CPU简介 CPU(Central Processing Unit),中文全称中央处理器,作为四大U之首(CPU/GPU/TPU/NPU),是计算机系统的运算和控制核心,也是当今数字系统中不可或缺的组成部分。CPU自诞生到如今发展超过50年,借助冯诺依曼体系,CPU掀起一股又一股的科技浪潮。RISC作为精简了指令集的CPU,除了指令更加简洁,还拥有简单合理的内部结构,从而提高了运算速度。 CPU工作的5个阶段: (1)取指(IF,Instruction Fetch),将指令从存储器取出到指令寄存器。每取一条指令,程序计数器自加一。 (2)译指(ID,Instruction Decode),对取出的指令按照规定格式进行拆分和译码。 (3)执行(EX,Execute),执行具体指令操作。 (4)访问存储(MEM,Memory),根据指令访问存储、完成存储和读取。 (5)写回(WB,Write Back),将计算结果写回到存储器。 CPU内部关键结构: (1)算术逻辑运算器(ALU); (2)累加器; (3)程序计数器; (4)指令寄存器和译码器; (5)时序和控制部件。 RISC_CPU内部结构和Verilog实现 本项目中的RISC_CPU一共有9个模块组成,具体如下: (1)时钟发生器; (2)指令寄存器; (3)累加器; (4)算术逻辑运算单元; (5)数据控制器; (6)状态控制器; (7)主状态机; (8)程序计数器; (9)地址多路器。 整体结构 图片 时钟发生器 模块图: image.png图片 端口描述: reset是高电平复位信号; clk是外部时钟信号; fetch是控制信号,是clk的八分频信号;fetch为高电平时,触发执行指令以及地址多路器输出指令地址和数据地址。 alu_ena是算术逻辑运算单元的使能信号。 图片 可以看到alu_ena提前fetch高电平一个clk周期,fetch是clk的8分频信号。 Verilog代码: // Description: RISC——CPU 时钟发生器 // ----------------------------------------------------------------------------- module clk_gen ( input clk , // Clock input reset , // High level reset output reg fetch , // 8 frequency division output reg alu_ena // Arithmetic enable ); reg [7:0] state; //One-piece state machine parameter S1 = 8'b0000_0001, S2 = 8'b0000_0010, S3 = 8'b0000_0100, S4 = 8'b0000_1000, S5 = 8'b0001_0000, S6 = 8'b0010_0000, S7 = 8'b0100_0000, S8 = 8'b1000_0000, idle = 8'b0000_0000; always@(posedge clk)begin if(reset)begin fetch <= 0; alu_ena <= 0; state <= idle; end else begin case(state) S1: begin alu_ena <= 1; state <= S2; end S2: begin alu_ena <= 0; state <= S3; end S3: begin fetch <= 1; state <=S4; end S4: begin state <= S5; end S5: state <= S6; S6: state <= S7; S7: begin fetch <= 0; state <= S8; end S8: begin state <= S1; end idle: state <= S1; default: state <=idle; endcase end end endmodule指令寄存器 模块图: 图片 端口描述: 寄存器是将数据总线送来的指令存入高8位或低8位寄存器中。 ena信号用来控制是否寄存。 每条指令为两个字节,16位,高3位是操作码,低13位是地址(CPU地址总线为13位,寻址空间为8K字节)。 本设计的数据总线为8位,每条指令需要取两次,先取高8位,再取低8位。 Verilog代码: // Description: RISC—CPU 指令寄存器 // ----------------------------------------------------------------------------- module register ( input [7:0] data , input clk , input rst , input ena , output reg [15:0] opc_iraddr ); reg state ; // always@( posedge clk ) begin if( rst ) begin opc_iraddr <= 16'b 0000_0000_0000_0000; state <= 1'b 0; end // if rst // If load_ir from machine actived, load instruction data from rom in 2 clock periods. // Load high 8 bits first, and then low 8 bits. else if( ena ) begin case( state ) 1'b0 : begin opc_iraddr [ 15 : 8 ] <= data; state <= 1; end 1'b1 : begin opc_iraddr [ 7 : 0 ] <= data; state <= 0; end default : begin opc_iraddr [ 15 : 0 ] <= 16'bxxxx_xxxx_xxxx_xxxx; state <= 1'bx; end endcase // state end // else if ena else state <= 1'b0; end endmodule 累加器 模块图: 图片 端口描述: 累加器用于存放当前结果,ena信号有效时,在clk上升沿输出数据总线的数据。 // Description: RISC-CPU 累加器模块 // ----------------------------------------------------------------------------- module accum ( input clk , // Clock input ena , // Enable input rst , // Asynchronous reset active high input [7:0] data , // Data bus output reg [7:0] accum ); always@(posedge clk)begin if(rst) accum <= 8'b0000_0000;//Reset else if(ena) accum <= data; end endmodule 算术运算器 模块图: image.png图片 端口描述: 算术逻辑运算单元可以根据输入的操作码分别实现相应的加、与、异或、跳转等基本操作运算。 本单元支持8种操作运算。 opcode用来选择计算模式 data是数据输入 accum是累加器输出 alu_ena是模块使能信号 clk是系统时钟 Verilog代码: // Description: RISC-CPU 算术运算器 // ----------------------------------------------------------------------------- module alu ( input clk , // Clock input alu_ena , // Enable input [2:0] opcode , // High three bits are used as opcodes input [7:0] data , // data input [7:0] accum , // accum out output reg [7:0] alu_out , output zero ); parameter HLT = 3'b000 , SKZ = 3'b001 , ADD = 3'b010 , ANDD = 3'b011 , XORR = 3'b100 , LDA = 3'b101 , STO = 3'b110 , JMP = 3'b111 ; always @(posedge clk) begin if(alu_ena) begin casex(opcode)//操作码来自指令寄存器的输出 opc_iaddr(15..0)的第三位 HLT: alu_out <= accum ; SKZ: alu_out <= accum ; ADD: alu_out <= data + accum ; ANDD: alu_out <= data & accum ; XORR: alu_out <= data ^ accum ; LDA : alu_out <= data ; STO : alu_out <= accum ; JMP : alu_out <= accum ; default: alu_out <= 8'bxxxx_xxxx ; endcase end end assign zero = !accum; endmodule 数据控制器 模块图: image.png图片 端口描述: 数据控制器的作用是控制累加器的数据输出,数据总线是分时复用的,会根据当前状态传输指令或者数据。 数据只在往RAM区或者端口写时才允许输出,否则呈现高阻态。 in是8bit数据输入 data_ena是使能信号 data是8bit数据输出 Verilog代码: // Description: RISC-CPU 数据控制器 // ----------------------------------------------------------------------------- module datactl ( input [7:0] in , // Data input input data_ena , // Data Enable output wire [7:0] data // Data output ); assign data = (data_ena )? in: 8'bzzzz_zzzz ; endmodule 地址多路器 模块图: image.png图片 端口描述: 用于选择输出地址是PC(程序计数)地址还是数据/端口地址。每个指令周期的前4个时钟周期用于从ROM种读取指令,输出的是PC地址;后四个时钟周期用于对RAM或端口读写。 地址多路器和数据控制器实现的功能十分相似。 fetch信号用来控制地址输出,高电平输出pc_addr ,低电平输出ir_addr ; pc_addr 指令地址; ir_addr ram或端口地址。 Verilog代码: // Description: RISC-CPU 地址多路器 // ----------------------------------------------------------------------------- module adr ( input fetch , // enable input [12:0] ir_addr , // input [12:0] pc_addr , // output wire [12:0] addr ); assign addr = fetch? pc_addr :ir_addr ; endmodule 程序计数器 模块图: image.png图片 端口描述: 程序计数器用来提供指令地址,指令按照地址顺序存放在存储器中。包含两种生成途径: (1)顺序执行的情况 (2)需要改变顺序,例如JMP指令 rst复位信号,高电平时地址清零; clock 时钟信号,系统时钟; ir_addr目标地址,当加载信号有效时输出此地址; pc_addr程序计数器地址 load地址装载信号 Verilog代码: // Description: RISC-CPU 程序计数器 // ----------------------------------------------------------------------------- module counter ( input [12:0] ir_addr , // program address input load , // Load up signal input clock , // CLock input rst , // Reset output reg [12:0] pc_addr // insert program address ); always@(posedge clock or posedge rst) begin if(rst) pc_addr <= 13'b0_0000_0000_0000; else if(load) pc_addr <= ir_addr; else pc_addr <= pc_addr + 1; end endmodule 状态控制器&主状态机 模块图: image.png图片 (图左边)状态机端口描述: 状态控制器接收复位信号rst,rst有效,控制输出ena为0,fetch有效控制ena为1。 // Description: RISC-CPU 状态控制器 // ----------------------------------------------------------------------------- module machinectl ( input clk , // Clock input rst , // Asynchronous reset input fetch , // Asynchronous reset active low output reg ena // Enable ); always@(posedge clk)begin if(rst) ena <= 0; else if(fetch) ena <=1; end endmodule (图右边)主状态端口描述: 主状态机是CPU的控制核心,用于产生一系列控制信号。 指令周期由8个时钟周期组成,每个时钟周期都要完成固定的操作。 (1)第0个时钟,CPU状态控制器的输出rd和load_ir 为高电平,其余为低电平。指令寄存器寄存由ROM送来的高8位指令代码。 (2)第1个时钟,与上一个时钟相比只是inc_pc从0变为1,故PC增1,ROM送来低8位指令代码,指令寄存器寄存该8位指令代码。 (3)第2个时钟,空操作。 (4)第3个时钟,PC增1,指向下一条指令。 操作符为HLT,输出信号HLT为高。 操作符不为HLT,除PC增1外,其余控制线输出为0. (5)第4个时钟,操作。 操作符为AND,ADD,XOR或LDA,读取相应地址的数据; 操作符为JMP,将目的地址送给程序计数器; 操作符为STO,输出累加器数据。 (6)第5个时钟,若操作符为ANDD,ADD或者XORR,算术运算器完成相应的计算; 操作符为LDA,就把数据通过算术运算器送给累加器; 操作符为SKZ,先判断累加器的值是否为0,若为0,PC加1,否则保持原值; 操作符为JMP,锁存目的地址; 操作符为STO,将数据写入地址处。 (7)第6个时钟,空操作。 (8)第7个时钟,若操作符为SKZ且累加器为0,则PC值再加1,跳过一条指令,否则PC无变化。 // Description: RISC-CPU 主状态机 // ----------------------------------------------------------------------------- module machine ( input clk , // Clock input ena , // Clock Enable input zero , // Asynchronous reset active low input [2:0] opcode , // OP code output reg inc_pc , // output reg load_acc , // output reg load_pc , // output reg rd , // output reg wr , // output reg load_ir , // output reg datactl_ena , // output reg halt ); reg [2:0] state ; //parameter parameter HLT = 3'b000 , SKZ = 3'b001 , ADD = 3'b010 , ANDD = 3'b011 , XORR = 3'b100 , LDA = 3'b101 , STO = 3'b110 , JMP = 3'b111 ; always@(negedge clk) begin if(!ena) //收到复位信号rst,进行复位操作 begin state <= 3'b000; {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else ctl_cycle; end //------- task ctl_cycle ------- task ctl_cycle; begin casex(state) 3'b000: //load high 8bits in struction begin {inc_pc,load_acc,load_pc,rd} <= 4'b0001; {wr,load_ir,datactl_ena,halt} <= 4'b0100; state <= 3'b001; end 3'b001://pc increased by one then load low 8bits instruction begin {inc_pc,load_acc,load_pc,rd} <= 4'b1001; {wr,load_ir,datactl_ena,halt} <= 4'b0100; state <= 3'b010; end 3'b010: //idle begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; state <= 3'b011; end 3'b011: //next instruction address setup 分析指令开始点 begin if(opcode == HLT)//指令为暂停HLT begin {inc_pc,load_acc,load_pc,rd} <= 4'b1000; {wr,load_ir,datactl_ena,halt} <= 4'b0001; end else begin {inc_pc,load_acc,load_pc,rd} <= 4'b1000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end state <= 3'b100; end 3'b100: //fetch oprand begin if(opcode == JMP) begin {inc_pc,load_acc,load_pc,rd} <= 4'b0010; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else if(opcode == ADD || opcode == ANDD || opcode == XORR || opcode == LDA) begin {inc_pc,load_acc,load_pc,rd} <= 4'b0001; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else if(opcode == STO) begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0010; end else begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end state <= 3'b101; end 3'b101://operation begin if(opcode == ADD || opcode == ANDD ||opcode ==XORR ||opcode == LDA)//过一个时钟后与累加器的内存进行运算 begin {inc_pc,load_acc,load_pc,rd} <= 4'b0101; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else if(opcode == SKZ && zero == 1)// & and && begin {inc_pc,load_acc,load_pc,rd} <= 4'b1000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else if(opcode == JMP) begin {inc_pc,load_acc,load_pc,rd} <= 4'b1010; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else if(opcode == STO) begin//过一个时钟后吧wr变为1,写到RAM中 {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b1010; end else begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end state <= 3'b110; end 3'b110: begin if(opcode == STO) begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0010; end else if(opcode == ADD || opcode == ANDD || opcode == XORR || opcode == LDA) begin {inc_pc,load_acc,load_pc,rd} <= 4'b0001; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end state <= 3'b111; end 3'b111: begin if(opcode == SKZ && zero == 1) begin {inc_pc,load_acc,load_pc,rd} <= 4'b1000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end else begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; end state <= 3'b000; end default: begin {inc_pc,load_acc,load_pc,rd} <= 4'b0000; {wr,load_ir,datactl_ena,halt} <= 4'b0000; state <= 3'b000; end endcase end endtask endmodule 外围模块 为了对RISC-CPU进行测试,需要对ROM、RAM和地址译码器进行设计。 地址译码器 模块说明: 地址译码器用于产生选通信号,选通ROM或者RAM 1FFFH —— 1800H RAM(范围):1_1xxx_xxxx_xxxx 17FFH —— 0000H ROM(范围):0_xxxx_xxxx_xxxx+1_0xxx_xxxx_xxxx Verilog代码: // Description: RISC-CPU 地址译码器 // ----------------------------------------------------------------------------- module addr_decode ( input [12:0] addr , // Address output reg ram_sel , // Ram sel output reg rom_sel // Rom sel ); always@(addr)begin casex(addr) 13'b1_1xxx_xxxx_xxxx:{rom_sel,ram_sel} <= 2'b01; 13'b0_xxxx_xxxx_xxxx:{rom_sel,ram_sel} <= 2'b10; 13'b1_0xxx_xxxx_xxxx:{rom_sel,ram_sel} <= 2'b10; default: {rom_sel,ram_sel} <= 2'b00; endcase end endmodule RAM 模块说明: RAM用于存放临时数据,可读可写。 Verilog代码: // Description: RISC-CPU RAM模块 // ----------------------------------------------------------------------------- module ram ( input ena , // Enable input read , // read Enable input write , // write Enable inout wire [7:0] data , // data input [9:0] addr // address ); reg [7:0] ram [10'h3ff:0] ; assign data = (read && ena )? ram[addr]:8'h zz; always@(posedge write) begin ram[addr] <= data; end endmodule ROM 模块说明: RAM用于存放只读数据。 Verilog代码: // Description: RISC-CPU ROM模块 // ----------------------------------------------------------------------------- module rom ( input [12:0] addr , input read , input ena , output wire [7:0] data ); reg [7:0] memory [13'h1ff:0]; assign data = (read && ena)? memory[addr]:8'b zzzz_zzzz; endmodule 顶层模块 模块图: 图片 图片 Verilog代码: // Description: RISC-CPU 顶层模块 // ----------------------------------------------------------------------------- //`include "clk_gen.v" //`include "accum.v" //`include "adr.v" //`include "alu.v" //`include "machine.v" //`include "counter.v" //`include "machinectl.v" //`iclude "machine.v" //`include "register.v" //`include "datactl.v" module RISC_CPU ( input clk , input reset , output wire rd , output wire wr , output wire halt , output wire fetch , //addr output wire [12:0] addr , output wire [12:0] ir_addr , output wire [12:0] pc_addr , inout wire [7:0] data , //op output wire [2:0] opcode ); wire [7:0] alu_out ; wire [7:0] accum ; wire zero ; wire inc_pc ; wire load_acc ; wire load_pc ; wire load_ir ; wire data_ena ; wire contr_ena ; wire alu_ena ; //inst clk_gen mclk_gen( .clk (clk ), .reset (reset ), .fetch (fetch ), .alu_ena (alu_ena ) ); register m_register( .data (data ), .ena (load_ir ), .rst (reset ), .clk (clk ), .opc_iraddr ({opcode,ir_addr} ) ); accum m_accum( .data (alu_out ), .ena (load_acc ), .clk (clk ), .rst (reset ), .accum (accum ) ); alu m_alu( .data (data ), .accum (accum ), .clk (clk ), .alu_ena (alu_ena ), .opcode (opcode ), .alu_out (alu_out ), .zero (zero ) ); machinectl m_machinectl( .clk (clk ), .rst (reset ), .fetch (fetch ), .ena (contr_ena ) ); machine m_machine( .inc_pc (inc_pc ), .load_acc (load_acc ), .load_pc (load_pc ), .rd (rd ), .wr (wr ), .load_ir (load_ir ), .clk (clk ), .datactl_ena(data_ena ), .halt (halt ), .zero (zero ), .ena (contr_ena ), .opcode (opcode ) ); datactl m_datactl( .in (alu_out ), .data_ena (data_ena ), .data (data ) ); adr m_adr( .fetch (fetch ), .ir_addr (ir_addr ), .pc_addr (pc_addr ), .addr (addr ) ); counter m_counter( .clock (inc_pc ), .rst (reset ), .ir_addr (ir_addr ), .load (load_pc ), .pc_addr (pc_addr ) ); endmodule Testbench Testbench包含三个测试程序,这个部分不能综合。 Test1程序 TEST1程序用于验证RISC-CPU的逻辑功能,根据汇编语言由人工编译的。 若各条指令正确,应该在地址2E(hex)处,在执行HLT时刻停止。若程序在任何其他位置停止,则必有一条指令运行错误,可以按照注释找到错误的指令。 test1汇编程序:(.pro文件/存放于ROM) //机器码-地址-汇编助记符-注释 @00 //address statement 111_0000 //00 BEGIN: JMP TST_JMP 0011_1100 000_0000 //02 HLT //JMP did not work 0000_0000 000_00000 //04 HLT //JMP did not load PC skiped 0000_0000 101_1100 //06 JMP_OK: LDA DATA 0000_0000 001_00000 //08 SKZ 0000_0000 000_0000 //0a HLT 0000_0000 101_11000 //0C LDA DATA_2 0000_0001 001_00000 //0E SKZ 0000_0000 111_0000 //10 JMP SKZ_OK 001_0100 000_0000 //12 HLT 0000_0000 110_11000 //14 SKZ_OK: STO TEMP 0000_0010 101_11000 //16 LDA DATA_1 0000_0000 110_11000 //18 STO TEMP 0000_0010 101_11000 //1A LDA TEMP 0000_0010 001_00000 //1C SKZ 0000_0000 000_00000 //1E HLT 0000_0000 100_11000 //20 XOR DATA_2 0000_0001 001_00000 //22 SKZ 0000_0000 111_00000 //24 JMP XOR_OK 0010_1000 000_00000 //26 HLT 0000_0000 100_11000 //28 XOR_OK XOR DATA_2 0000_0001 001_00000 //2A SKZ 0000_0000 000_00000 //2C HLT 0000_0000 000_0000 //2E END 0000_0000 111_00000 //30 JMP BEGIN 0000_0000 @3c 111_00000 //3c TST_JMP IMR OK 0000_0110 000_00000 //3E HLT test1数据文件:(.dat/存放于RAM) /----------------------------------- @00 ///address statement at RAM 00000000 //1800 DATA_1 11111111 //1801 DATA_2 10101010 //1082 TEMPTest2程序 TEST1程序用于验证RISC-CPU的逻辑功能,根据汇编语言由人工编译的。 这个程序是用来测试RISC-CPU的高级指令集,若执行正确,应在地址20(hex)处在执行HLT时停止。 test2汇编程序: @00 101_11000 //00 BEGIN 0000_0001 011_11000 //02 AND DATA_3 0000_0010 100_11000 //04 XOR DATA_2 0000_0001 001_00000 //06 SKZ 0000_0000 000_00000 //08 HLT 0000_0000 010_11000 //0A ADD DATA_1 0000_0000 001_00000 //0C SKZ 0000_0000 111_00000 //0E JMP ADD_OK 0001_0010 111_00000 //10 HLT 0000_0000 100_11000 //12 ADD_OK XOR DATA_3 0000_0010 010_11000 //14 ADD DATA_1 0000_0000 110_11000 //16 STO TEMP 0000_0011 101_11000 //18 LDA DATA_1 0000_0000 010_11000 //1A ADD TEMP 0000_0001 001_00000 //1C SKZ 0000_0000 000_00000 //1E HLT 0000_0000 000_00000 //END HLT 0000_0000 111_00000 //JMP BEGIN 0000_0000test2数据文件: @00 00000001 //1800 DATA_1 10101010 //1801 DATA_2 11111111 //1802 DATA_3 00000000 //1803 TEMPTest3程序 TEST3程序是一个计算0~144的斐波那契数列的程序,用来验证CPU整体功能。 test3汇编程序: @00 101_11000 //00 LOOP:LDA FN2 0000_0001 110_11000 //02 STO TEMP 0000_0010 010_11000 //04 ADD FN1 0000_0000 110_11000 //06 STO FN2 0000_0001 101_11000 //08 VLDA TEMP 0000_0010 110_11000 //0A STO FN1 0000_0000 100_11000 //0C XOR LIMIT 0000_0011 001_00000 //0E SKZ 0000_0000 111_00000 //10 JMP LOOP 0000_0000 000_00000 //12 DONE HLT 0000_0000test3数据文件: @00 00000001 //1800 FN1 00000000 //1801 FN2 00000000 //1802 TEMP 10010000 //1803 LIMIT完整的testbench Verilog代码: // Description: RISC-CPU 测试程序 // ----------------------------------------------------------------------------- `include "RISC_CPU.v" `include "ram.v" `include "rom.v" `include "addr_decode.v" `timescale 1ns/1ns `define PERIOD 100 // matches clk_gen.v module cputop_tb; reg [( 3 * 8 ): 0 ] mnemonic; // array that holds 3 8 bits ASCII characters reg [ 12 : 0 ] PC_addr, IR_addr; reg reset_req, clock; wire [ 12 : 0 ] ir_addr, pc_addr; // for post simulation. wire [ 12 : 0 ] addr; wire [ 7 : 0 ] data; wire [ 2 : 0 ] opcode; // for post simulation. wire fetch; // for post simulation. wire rd, wr, halt, ram_sel, rom_sel; integer test; //-----------------DIGITAL LOGIC---------------------- RISC_CPU t_cpu (.clk( clock ),.reset( reset_req ),.halt( halt ),.rd( rd ),.wr( wr ),.addr( addr ),.data( data ),.opcode( opcode ),.fetch( fetch ),.ir_addr( ir_addr ),.pc_addr( pc_addr )); ram t_ram (.addr ( addr [ 9 : 0 ]),.read ( rd ),.write ( wr ),.ena ( ram_sel ),.data ( data )); rom t_rom (.addr ( addr ),.read ( rd ), .ena ( rom_sel ),.data ( data )); addr_decode t_addr_decoder (.addr( addr ),.ram_sel( ram_sel ),.rom_sel( rom_sel )); //-------------------SIMULATION------------------------- initial begin clock = 0; // display time in nanoseconds $timeformat ( -9, 1, "ns", 12 ); display_debug_message; sys_reset; test1; $stop; test2; $stop; test3; $finish; // simulation is finished here. end // initial task display_debug_message; begin $display ("\n************************************************" ); $display ( "* THE FOLLOWING DEBUG TASK ARE AVAILABLE: *" ); $display ( "* \"test1;\" to load the 1st diagnostic program. *"); $display ( "* \"test2;\" to load the 2nd diagnostic program. *"); $display ( "* \"test3;\" to load the Fibonacci program. *"); $display ( "************************************************\n"); end endtask // display_debug_message task test1; begin test = 0; disable MONITOR; $readmemb ("test1.pro", t_rom.memory ); $display ("rom loaded successfully!"); $readmemb ("test1.dat", t_ram.ram ); $display ("ram loaded successfully!"); #1 test = 1; #14800; sys_reset; end endtask // test1 task test2; begin test = 0; disable MONITOR; $readmemb ("test2.pro", t_rom.memory ); $display ("rom loaded successfully!"); $readmemb ("test2.dat", t_ram.ram ); $display ("ram loaded successfully!"); #1 test = 2; #11600; sys_reset; end endtask // test2 task test3; begin test = 0; disable MONITOR; $readmemb ("test3.pro", t_rom.memory ); $display ("rom loaded successfully!"); $readmemb ("test3.dat", t_ram.ram ); $display ("ram loaded successfully!"); #1 test = 3; #94000; sys_reset; end endtask // test1 task sys_reset; begin reset_req = 0; #( `PERIOD * 0.7 ) reset_req = 1; #( 1.5 * `PERIOD ) reset_req = 0; end endtask // sys_reset //--------------------------MONITOR-------------------------------- always@( test ) begin: MONITOR case( test ) 1: begin // display results when running test 1 $display("\n*** RUNNING CPU test 1 - The Basic CPU Diagnostic Program ***"); $display("\n TIME PC INSTR ADDR DATA "); $display(" ------ ---- ------- ------ ------ "); while( test == 1 )@( t_cpu.pc_addr ) begin // fixed if(( t_cpu.pc_addr % 2 == 1 )&&( t_cpu.fetch == 1 )) begin // fixed #60 PC_addr <= t_cpu.pc_addr - 1; IR_addr <= t_cpu.ir_addr; #340 $strobe("%t %h %s %h %h", $time, PC_addr, mnemonic, IR_addr, data ); // Here data has been changed t_cpu.m_register.data end // if t_cpu.pc_addr % 2 == 1 && t_cpu.fetch == 1 end // while test == 1 @ t_cpu.pc_addr end 2: begin // display results when running test 2 $display("\n*** RUNNING CPU test 2 - The Basic CPU Diagnostic Program ***"); $display("\n TIME PC INSTR ADDR DATA "); $display(" ------ ---- ------- ------ ------ "); while( test == 2 )@( t_cpu.pc_addr ) begin // fixed if(( t_cpu.pc_addr % 2 == 1 )&&( t_cpu.fetch == 1 )) begin // fixed #60 PC_addr <= t_cpu.pc_addr - 1; IR_addr <= t_cpu.ir_addr; #340 $strobe("%t %h %s %h %h", $time, PC_addr, mnemonic, IR_addr, data ); // Here data has been changed t_cpu.m_register.data end // if t_cpu.pc_addr % 2 == 1 && t_cpu.fetch == 1 end // while test == 2 @ t_cpu.pc_addr end 3: begin // display results when running test 3 $display("\n*** RUNNING CPU test 3 - An Executable Program **************"); $display("***** This program should calculate the fibonacci *************"); $display("\n TIME FIBONACCI NUMBER "); $display(" ------ -----------------_ "); while( test == 3 ) begin wait( t_cpu.opcode == 3'h 1 ) // display Fib. No. at end of program loop $strobe("%t %d", $time, t_ram.ram [ 10'h 2 ]); wait( t_cpu.opcode != 3'h 1 ); end // while test == 3 end endcase // test end // MONITOR: always@ test //-------------------------HALT------------------------------- always@( posedge halt ) begin // STOP when HALT intruction decoded #500 $display("\n******************************************"); $display( "** A HALT INSTRUCTION WAS PROCESSED !!! **"); $display( "******************************************"); end // always@ posedge halt //-----------------------CLOCK & MNEMONIC------------------------- always#(`PERIOD / 2 ) clock = ~ clock; always@( t_cpu.opcode ) begin // get an ASCII mnemonic for each opcode case( t_cpu.opcode ) 3'b 000 : mnemonic = "HLT"; 3'b 001 : mnemonic = "SKZ"; 3'b 010 : mnemonic = "ADD"; 3'b 011 : mnemonic = "AND"; 3'b 100 : mnemonic = "XOR"; 3'b 101 : mnemonic = "LDA"; 3'b 110 : mnemonic = "STO"; 3'b 111 : mnemonic = "JMP"; default : mnemonic = "???"; endcase end endmodule $ readmemb ( "test1. pro" ,t_ rom. . memory ); $ readmemb ( "testl. dat",t_ ram_ . ram); 即可把编译好的汇编机器码装人虚拟ROM,把需要参加运算的数据装人虚拟RAM就可以开始仿真。上面语句中的第一项为打开的文件名,后一项为系统层次管理下的ROM模块和RAM模块中的存储器memory和ram。源代码&脚本 见文章末尾 前仿真结果 test1 图片 test2 图片 test3 图片 图片 DC后仿真 采用SMIC180工艺在典型环境下进行测试 时序报告: 图片 面积报告: 图片 功耗报告: 图片 综合电路图: 图片 图片 图片 总结 该项目更加偏向于教学练习,CPU也是数字IC的重要研究方向,对此感兴趣的同学可以找点论文和开源资料进行学习。可以进一步优化如流水线、运算单元,扩展成SOC系统等。 源代码&脚本
FPGA&ASIC
IP&SOC设计
# ASIC/FPGA
# SOC设计
刘航宇
3年前
15
2,280
7
2023-04-06
【硬件算法】Verilog之FPGA实现信号移相法
摘要本文介绍了使用FPGA实现信号移相的方法,通过Verilog代码实现0-360度连续可调的相位移位。该算法基于边沿检测与分频,适用于数字中频信号处理。关键词:FPGA, 信号移相, Verilog, 数字中频信号, 边沿检测实现信号移相可以用FPGA控制信号0-360度连续可调,对于高频信号(1GHZ以上)超出了FPGA工作频率还有一种办法是FPGA-》DA-》射频前端-》移相器-》阻抗匹配-》天线。本案例直接采用FPGA对数字中频信号处理(kHZ、MHZ) 本质是边沿检测与分频 现象: 图片 代码: /* Function : Phase Shift Interface : clk_fre---unit(MHZ) din_fre---unit(KHz) phase_angle---unit(0-360 Angle) Date: 2023/04/05 Description: Phase shift is carried out on the input square wave. The phase Angle unit is Angle (0-360), or the input can be greater than 360. The system clock unit is MHz and the input signal clock is KHz. */ module PhaseShift( input clk, //clk input rst_n, //rest input [7:0] clk_fre, //system clock frequency,MHZ input [15:0] din_fre, //input signal clock frequency,KHZ input [8:0] phase_angle, //phase shift angle input din, //input signal output reg dout //output signal ); reg [31:0] posedge_counter; reg [31:0] negedge_counter; reg [31:0] delay_counter; reg in_posedge_flg; reg in_negedge_flg; reg out_posedge_flg; reg out_negedge_flg; reg old_din; reg init_data=1'b1; always @(posedge clk or negedge rst_n) begin if(!rst_n) begin posedge_counter <= 1'b0; negedge_counter <= 1'b0; in_posedge_flg <= 1'b0; in_negedge_flg <= 1'b0; out_posedge_flg <= 1'b0; out_negedge_flg <= 1'b0; end else begin if(~old_din & din) in_posedge_flg = 1'b1; if(old_din & ~din) in_negedge_flg = 1'b1; old_din <= din; if(init_data) begin delay_counter <= ((1000000000)/din_fre*clk_fre)/360*(phase_angle%360)/1000000; dout <= din ; init_data <= 1'b0; end if(in_posedge_flg && posedge_counter <= delay_counter) begin posedge_counter <= posedge_counter + 1'b1 ; out_posedge_flg <= 1'b0; end else begin posedge_counter <= 1'b0 ; in_posedge_flg <= 1'b0 ; if(~out_posedge_flg) begin dout <= 1'b1 ; out_posedge_flg <= 1'b1 ; end end if (in_negedge_flg && negedge_counter <= delay_counter) begin negedge_counter <= negedge_counter + 1'b1 ; out_negedge_flg <= 1'b0 ; end else begin negedge_counter <= 1'b0 ; in_negedge_flg <= 1'b0 ; if(~out_negedge_flg) begin dout <= 1'b0 ; out_negedge_flg <= 1'b1; end end end end endmodule测试代码: `timescale 100ps/10ps // module test_PhaseShift; reg clk; reg rst_n; reg [7:0] clk_fre; //system clock frequency,MHZ reg [15:0] din_fre ; //input signal clock frequency,KHZ reg [8:0] phase_angle; //phase shift angle reg din ; //input signal wire dout ; //output signal initial begin clk = 0; din = 0; din_fre = 4000; phase_angle = 90; clk_fre = 100; rst_n = 1; #12 rst_n = 0; #4 rst_n = 1; #10000 $stop; //end end always #5 clk = ~clk; always #125 din = ~din; PhaseShift u1( .clk(clk), .rst_n(rst_n), .clk_fre(clk_fre), .din_fre(din_fre), .phase_angle(phase_angle), .din(din), .dout(dout) ); endmodule
FPGA&ASIC
软硬件算法
# ASIC/FPGA
# 硬件算法
刘航宇
3年前
0
1,679
3
2023-03-18
【优惠活动】26考研西北大学电子信息类专业全程班
摘要西北大学电子信息类专业26考研全程班开启优惠活动,时间5.6日至5.20日,参与分享课程有机会获得不同等级的优惠,奖品包括150元至30元不等。课程包含数电、模电、电路等知识点讲解,并提供资料和模拟题。关键词:考研, 西北大学, 电子信息类专业, 全程班, 优惠活动pEVCsrd.png图片 26考研专业全程班优惠活动来啦! 所有课程https://edu.ee.ac.cn/ 奖品内容 活动内容 兑奖条件 声明&收奖方式 赠送资料 26考研西北大学843班(学习通上课):https://mooc1.chaoxing.com/course/249631535.html 课程二维码: m6eq51qr.png图片 目录 奖品内容 活动时间5.6日~5.20日 💻 特等奖奖优惠150元 📱 一等奖优惠100元 💿 二等奖优惠80元 📗 三等奖优惠50元 ✉ 四等奖优惠30元 只要参与98%概率中奖任何一个 兑奖成功后当日有效 活动内容 点开下面2个网页任何一个都可,然后点击分享到QQ空间或微信朋友圈,配上文案:西北大学843电子信息类考研全程班,有需要可以了解,QQ群:519462257。 任选一个 网页一 https://mooc1.chaoxing.com/course/249631535.html 网页二 https://edu.ee.ac.cn/ 兑奖条件 1、转发后需要获得至少5个人的点赞 2、转发后3天内不可删除转发消息,否则取消兑奖资格 3、完成后凭截图参与抽奖 声明&收奖方式 满足活动条件后请将截图发至以下任一核实地方 1、截图发至QQ:2091645818/微信:eecslab 2、截图上传至评论区 发送上面二个任意一个都可以,核实后奖品会立刻发放 每人仅能参与1次,中奖额度与赞数无关,达到最低要求即可 图片 西北大学26考研班:包含数电、模电、 电路 三科知识点讲解、划重点、送初复试资料、真题模拟题带刷带练、 复试指导等 拟定课时不低于90课时,课时更新中课程链接: 点击进入课程 赠送资料 西北大学843、849历年真题 下载地址:https://wwek.lanzoue.com/ip1gv2m1mg3c 提取码: 免费笔记入口 模拟电子技术 数字电子技术
我的随笔
刘航宇
3年前
18
2,016
7
使用Verilog实现与仿真AMBA--AHB总线协议(三)
摘要本文介绍了使用Verilog实现和仿真AMBA-AHB总线协议的AHB从机部分。文章详细阐述了AHB从机的应答机制、接口框图、程序代码以及测试用例,并通过VCS仿真验证了代码的正确性。关键词:Verilog, AHB-AHB总线协议, AMBA总线, 仿真, SRAM控制器1、AHB从机 AHB从机应答来自系统主主机发起的传输。从机使用从译码器输出的 HSELx 信号来决定它什么时候作应答。其它传输需要的信号,如地址与控制信息由主机产生。 下图为一个AHB从机的接口框图: 图片 下面是一个AHB接口的SRAM控制器的程序: //------------------------------------------------------------------------------ // File : ahb_sram.v // Editor : VSCode, Tab Size(4) // Description : Top Module of AHB SRAM Controller. // //------------------------------------------------------------------------------ `timescale 1ns / 1ps module ahb_sram #( parameter SYNC_RESET = 1, parameter AHB_DWIDTH = 32, parameter AHB_AWIDTH = 32, parameter SIZE_IN_BYTES = 2048, parameter ADD_WIDTH = $clog2(SIZE_IN_BYTES) ) ( //---------------------------------- // IO Declarations //---------------------------------- // Inputs input HCLK, input HRESETN, input HSEL, input HREADYIN, input [1:0] HTRANS, input [2:0] HBURST, input [2:0] HSIZE, input [AHB_DWIDTH-1:0] HWDATA, input [AHB_AWIDTH-1:0] HADDR, input HWRITE, // Outputs output [AHB_DWIDTH-1:0] HRDATA, output [1:0] HRESP, output HREADYOUT ); //---------------------------------- // Variable Declarations //---------------------------------- wire [ADD_WIDTH-1:0] HADDR_cal; wire [2:0] ahbsram_size; wire [ADD_WIDTH-1:0] ahbsram_addr; wire [31:0] ahbsram_wdata; wire ahbsram_write; wire [31:0] sramahb_rdata; wire sramahb_ack; //---------------------------------- // Start of Main Code //---------------------------------- assign HADDR_cal = HADDR[ADD_WIDTH-1:0]; // Instantiations ahb_sram_if #( .AHB_DWIDTH (AHB_DWIDTH), .AHB_AWIDTH (AHB_AWIDTH), .ADD_WIDTH (ADD_WIDTH), .SYNC_RESET (SYNC_RESET) ) u_ahb_sram_if ( .HCLK (HCLK), .HRESETN (HRESETN), .HSEL (HSEL), .HTRANS (HTRANS), .HBURST (HBURST), .HWRITE (HWRITE), .HWDATA (HWDATA), .HSIZE (HSIZE), .HADDR (HADDR_cal), .HREADYIN (HREADYIN), // From SRAM Control signals .sramahb_ack (sramahb_ack), .sramahb_rdata (sramahb_rdata), // Outputs .HREADYOUT (HREADYOUT), .HRESP (HRESP), // To SRAM Control signals .ahbsram_req (ahbsram_req), .ahbsram_write (ahbsram_write), .ahbsram_wdata (ahbsram_wdata), .ahbsram_size (ahbsram_size), .ahbsram_addr (ahbsram_addr), .HRDATA (HRDATA) ); sram_ctrl_if #( .ADD_WIDTH (ADD_WIDTH), .SYNC_RESET (SYNC_RESET) ) u_sram_ctrl_if ( .HCLK (HCLK), .HRESETN (HRESETN), // From AHB Interface signals .ahbsram_req (ahbsram_req), .ahbsram_write (ahbsram_write), .ahbsram_wdata (ahbsram_wdata), .ahbsram_size (ahbsram_size), .ahbsram_addr (ahbsram_addr), // Outputs // To AHB Interface signals .sramahb_ack (sramahb_ack), .sramahb_rdata (sramahb_rdata) ); endmodule //------------------------------------------------------------------------------ // File : ahb_sram_if.v // Editor : VSCode, Tab Size(4) // Description : // //------------------------------------------------------------------------------ `timescale 1ns / 1ps module ahb_sram_if #( parameter AHB_DWIDTH = 32, parameter AHB_AWIDTH = 32, parameter ADD_WIDTH = 11, parameter SYNC_RESET = 0 ) ( //---------------------------------- // IO Declarations //---------------------------------- // Inputs input HCLK, input HRESETN, input HSEL, input HREADYIN, input [1:0] HTRANS, input [2:0] HBURST, input [2:0] HSIZE, input [ADD_WIDTH-1:0] HADDR, input [AHB_DWIDTH-1:0] HWDATA, input HWRITE, input sramahb_ack, input [AHB_DWIDTH-1:0] sramahb_rdata, // Outputs output HREADYOUT, output [1:0] HRESP, output reg [AHB_DWIDTH-1:0] HRDATA, output ahbsram_req, output ahbsram_write, output [AHB_AWIDTH-1:0] ahbsram_wdata, output [2:0] ahbsram_size, output [ADD_WIDTH-1:0] ahbsram_addr ); //---------------------------------- // Local Parameter Declarations //---------------------------------- // State Machine parameters localparam IDLE = 2'b00; localparam AHB_WR = 2'b01; localparam AHB_RD = 2'b10; parameter RESP_OKAY = 2'b00; parameter RESP_ERROR = 2'b01; // AHB HTRANS definition parameter TRN_IDLE = 2'b00; parameter TRN_BUSY = 2'b01; parameter TRN_SEQ = 2'b11; parameter TRN_NONSEQ = 2'b10; parameter SINGLE = 3'b000; parameter INCR = 3'b001; parameter WRAP4 = 3'b010; parameter INCR4 = 3'b011; parameter WRAP8 = 3'b100; parameter INCR8 = 3'b101; parameter WRAP16 = 3'b110; parameter INCR16 = 3'b111; //---------------------------------- // Variable Declarations //---------------------------------- reg [1:0] HTRANS_d; reg [2:0] HBURST_d; reg [2:0] HSIZE_d; reg [ADD_WIDTH-1:0] HADDR_d; reg [AHB_DWIDTH-1:0] HWDATA_d; reg HWRITE_d; reg HSEL_d; reg HREADYIN_d; reg [1:0] ahbcurr_state; reg [1:0] ahbnext_state; reg latchahbcmd; reg ahbsram_req_int; reg ahbsram_req_d1; reg [AHB_DWIDTH-1:0] HWDATA_cal; reg [4:0] burst_count; reg [4:0] burst_count_reg; reg [4:0] count; wire aresetn; wire sresetn; //---------------------------------- // Start of Main Code //---------------------------------- assign aresetn = (SYNC_RESET==1) ? 1'b1 : HRESETN; assign sresetn = (SYNC_RESET==1) ? HRESETN : 1'b1; // Generation of valid AHB Command which triggers the AHB Slave State Machine assign validahbcmd = HREADYIN & HSEL & (HTRANS == TRN_NONSEQ); // Generation of HRESP assign HRESP = RESP_OKAY; always @(*) begin HWDATA_cal = HWDATA; end // Latch all the AHB signals always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin HADDR_d <= {20{1'b0}}; HWDATA_d <= {32{1'b0}}; HTRANS_d <= 2'b00; HSIZE_d <= 2'b00; HBURST_d <= 3'b000; HWRITE_d <= 1'b0; HSEL_d <= 1'b0; HREADYIN_d <= 1'b0; end else if (HREADYIN == 1'b1 & HSEL == 1'b1 & HREADYOUT == 1'b1) begin HADDR_d <= HADDR; HTRANS_d <= HTRANS; HSIZE_d <= HSIZE; HBURST_d <= HBURST; HWRITE_d <= HWRITE; HWDATA_d <= HWDATA_cal; HSEL_d <= HSEL; HREADYIN_d <= HREADYIN; end end // Current State generation always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin ahbcurr_state <= IDLE; end else begin ahbcurr_state <= ahbnext_state; end end // Next State and output decoder logic always @(*) begin latchahbcmd = 1'b0; ahbsram_req_int = 1'b0; ahbnext_state = ahbcurr_state; case (ahbcurr_state) IDLE : begin if (HREADYIN == 1'b1 && HSEL == 1'b1 && ((HTRANS == TRN_NONSEQ) || HTRANS == TRN_SEQ)) begin latchahbcmd = 1'b1; if (HWRITE == 1'b1) begin ahbnext_state = AHB_WR; end else begin ahbnext_state = AHB_RD; end end else begin ahbnext_state = IDLE; end end AHB_WR : begin latchahbcmd = 1'b0; ahbsram_req_int = 1'b1; if (sramahb_ack == 1'b1) begin if (count == burst_count_reg) begin ahbnext_state = IDLE; end else begin ahbsram_req_int = 1'b0; end end end AHB_RD : begin latchahbcmd = 1'b0; ahbsram_req_int = 1'b1; if (sramahb_ack == 1'b1) begin ahbnext_state = IDLE; end end default : begin ahbnext_state = IDLE; end endcase end // LOGIC FOR BURST COUNT always @(*) begin burst_count = burst_count_reg; if (HSEL == 1'b1 && HTRANS == TRN_NONSEQ && HREADYIN == 1'b1 && HREADYOUT == 1'b1) begin case (HBURST) SINGLE : burst_count = 5'b00001; WRAP4,INCR4 : burst_count = 5'b00100; WRAP8,INCR8 : burst_count = 5'b01000; WRAP16,INCR16 : burst_count = 5'b10000; default : burst_count = 4'b0001; endcase end end always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin burst_count_reg <= 'h0; end else begin burst_count_reg <= burst_count; end end always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin count <= 5'h0; end else begin if (count == burst_count_reg) begin count <= 5'h0; end else if (ahbsram_req == 1'b1) begin count <= count + 1'b1; end else begin count <= count; end end end assign HREADYOUT = !ahbsram_req_int; // Generation of signals required for SRAM assign ahbsram_write = ahbsram_req ? HWRITE_d : 1'b0; assign ahbsram_wdata = HWDATA; assign ahbsram_addr = ahbsram_req ? HADDR_d : HADDR_d; assign ahbsram_size = ahbsram_req ? HSIZE_d : HSIZE_d; always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin ahbsram_req_d1 <= 1'b0; end else begin ahbsram_req_d1 <= ahbsram_req_int; end end // Generate the request to the SRAM contol logic when there is AHB read or write request assign ahbsram_req = ahbsram_req_int & !ahbsram_req_d1; // HRDATA generation always @(*) begin if (HREADYOUT && HREADYIN) begin HRDATA = sramahb_rdata; end else begin HRDATA = sramahb_rdata; end end endmodule //------------------------------------------------------------------------------ // File : sram_ctrl_if.v // Editor : VSCode, Tab Size(4) // Description : // //------------------------------------------------------------------------------ `timescale 1ns / 1ps module sram_ctrl_if #( parameter AHB_DWIDTH = 32, parameter ADD_WIDTH = 11, parameter SYNC_RESET = 0 ) ( //---------------------------------- // IO Declarations //---------------------------------- // Inputs input HCLK, input HRESETN, input ahbsram_req, input ahbsram_write, input [2:0] ahbsram_size, input [ADD_WIDTH-1:0] ahbsram_addr, input [AHB_DWIDTH-1:0] ahbsram_wdata, // Outputs output sramahb_ack, output reg [AHB_DWIDTH-1: 0] sramahb_rdata ); //---------------------------------- // Local Parameter Declarations //---------------------------------- // State Machine parameters localparam S_IDLE = 2'b00; localparam S_WR = 2'b01; localparam S_RD = 2'b10; //---------------------------------- // Variable Declarations //---------------------------------- reg [3:0] sram_wen_mem; reg [1:0] sramcurr_state; reg [1:0] sramnext_state; reg sram_wen; reg sram_ren; reg sramahb_ack_int; reg sram_ren_d; reg sram_done; wire [AHB_DWIDTH-1:0] ram_rdata; wire aresetn; wire sresetn; //---------------------------------- // Start of Main Code //---------------------------------- assign aresetn = (SYNC_RESET == 1) ? 1'b1 : HRESETN; assign sresetn = (SYNC_RESET == 1) ? HRESETN : 1'b1; // Current State generation always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin sramcurr_state <= S_IDLE; end else begin sramcurr_state <= sramnext_state; end end // Next State and output decoder logic always @(*) begin sramahb_ack_int = 1'b0; sram_wen = 1'b0; sram_ren = 1'b0; sramnext_state = sramcurr_state; case (sramcurr_state) S_IDLE : begin if (ahbsram_req == 1'b1) begin if (ahbsram_write == 1'b1) begin sramnext_state = S_WR; sram_wen = 1'b1; end else begin sram_ren = 1'b1; sramnext_state = S_RD; end end end S_WR : begin if (sram_done == 1'b1) begin sramnext_state = S_IDLE; sramahb_ack_int = 1'b1; end end S_RD : begin if (sram_done == 1'b1) begin sramnext_state = S_IDLE; sramahb_ack_int = 1'b1; end end default : begin sramnext_state = S_IDLE; end endcase end always @(*) begin sram_wen_mem = 4'b0000; if (ahbsram_size == 3'b010) begin sram_wen_mem = {4{sram_wen}}; end else if (ahbsram_size == 3'b001) begin case (ahbsram_addr[1]) 1'b0 : begin sram_wen_mem[0] = sram_wen; sram_wen_mem[1] = sram_wen; sram_wen_mem[2] = 1'b0; sram_wen_mem[3] = 1'b0; end 1'b1 : begin sram_wen_mem[0] = 1'b0; sram_wen_mem[1] = 1'b0; sram_wen_mem[2] = sram_wen; sram_wen_mem[3] = sram_wen; end endcase end else if (ahbsram_size == 3'b000) begin case (ahbsram_addr[1:0]) 2'b00 : begin sram_wen_mem[0] = sram_wen; sram_wen_mem[1] = 1'b0; sram_wen_mem[2] = 1'b0; sram_wen_mem[3] = 1'b0; end 2'b01 : begin sram_wen_mem[0] = 1'b0; sram_wen_mem[1] = sram_wen; sram_wen_mem[2] = 1'b0; sram_wen_mem[3] = 1'b0; end 2'b10 : begin sram_wen_mem[0] = 1'b0; sram_wen_mem[1] = 1'b0; sram_wen_mem[2] = sram_wen; sram_wen_mem[3] = 1'b0; end 2'b11 : begin sram_wen_mem[0] = 1'b0; sram_wen_mem[1] = 1'b0; sram_wen_mem[2] = 1'b0; sram_wen_mem[3] = sram_wen; end endcase end else begin sram_wen_mem = {4{sram_wen}}; end end // SRAM Instantiations sram_model #( .SYNC_RESET (SYNC_RESET), .ADDR_WIDTH (ADD_WIDTH) ) u_sram_model ( .writedata (ahbsram_wdata), .readdata (ram_rdata[31:0]), .wren (sram_wen_mem), .rden (sram_ren), .writeaddr (ahbsram_addr[ADD_WIDTH-1:2]), .readaddr (ahbsram_addr[ADD_WIDTH-1:2]), .clk (HCLK), .resetn (HRESETN) ); always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin sramahb_rdata <= 32'h0; end else if (sram_ren_d == 1'b1) begin sramahb_rdata <= ram_rdata; end else begin sramahb_rdata <= sramahb_rdata; end end always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin sram_ren_d <= 32'h0; end else begin sram_ren_d <= sram_ren; end end // Generate the SRAM done when the SRAM wren/rden is done always @(posedge HCLK or negedge aresetn) begin if ((aresetn == 1'b0) || (sresetn == 1'b0)) begin sram_done <= 1'b0; end else if (sram_wen || sram_ren) begin sram_done <= 1'b1; end else begin sram_done <= 1'b0; end end // Generate the SRAM ack assign sramahb_ack = sramahb_ack_int; endmodule //------------------------------------------------------------------------------ // File : sram_model.v // Editor : GVIM, Tab Size(4) // Description : FPGA Block Ram/Onchip SRAM. // //------------------------------------------------------------------------------ `timescale 1ns / 1ps module sram_model #( parameter SYNC_RESET = 0, parameter ADDR_WIDTH = 16 ) ( //---------------------------------- // IO Declarations //---------------------------------- input [31:0] writedata, output [31:0] readdata, input [3:0] wren, input rden, input [ADDR_WIDTH-1:2] writeaddr, input [ADDR_WIDTH-1:2] readaddr, input clk, input resetn ); //---------------------------------- //--Local Parameter Declarations //---------------------------------- localparam AWT = ((1<<(ADDR_WIDTH-2))-1); //---------------------------------- // Variable Declarations //---------------------------------- reg [7:0] bram0[AWT:0]; reg [7:0] bram1[AWT:0]; reg [7:0] bram2[AWT:0]; reg [7:0] bram3[AWT:0]; reg [ADDR_WIDTH-3:0] addr_q1; reg rden_r = 1'b0; wire [31:0] readdata_i; wire aresetn; wire sresetn; //---------------------------------- // Start of Main Code //---------------------------------- assign aresetn = (SYNC_RESET == 1) ? 1'b1 : resetn; assign sresetn = (SYNC_RESET == 1) ? resetn : 1'b1; always @(posedge clk) begin rden_r <= rden; end // Infer Block RAM always @(posedge clk) begin if (wren[0]) bram0[writeaddr] <= writedata[7:0]; if (wren[1]) bram1[writeaddr] <= writedata[15:8]; if (wren[2]) bram2[writeaddr] <= writedata[23:16]; if (wren[3]) bram3[writeaddr] <= writedata[31:24]; end always @(posedge clk) begin addr_q1 <= readaddr[ADDR_WIDTH-1:2]; end assign readdata_i = {bram3[addr_q1],bram2[addr_q1],bram1[addr_q1],bram0[addr_q1]}; assign readdata = rden_r ? readdata_i : {32{1'b0}}; endmodule下面是测试用例代码: //------------------------------------------------------------------------------ // File : top_tb.v // Editor : VSCode, Tab Size(4) // Description : Testbench of AHB SRAM Controller. // //------------------------------------------------------------------------------ `timescale 1ns / 1ps module top_tb(); //---------------------------------- // Local Parameter Declarations //---------------------------------- localparam AHB_CLK_PERIOD = 5; // Assuming AHB CLK to be 100MHz localparam SIZE_IN_BYTES =2048; //---------------------------------- // Variable Declarations //---------------------------------- reg HCLK = 0; wire HWRITE; wire [1:0] HTRANS; wire [2:0] HSIZE; wire [2:0] HBURST; wire HREADYIN; wire [31:0] HADDR; wire [31:0] HWDATA; wire HREADYOUT; wire [1:0] HRESP; wire [31:0] HRDATA; reg HRESETn; //---------------------------------- // Start of Main Code //---------------------------------- //----------------------------------------------------------------------- // Generate HCLK //----------------------------------------------------------------------- always #AHB_CLK_PERIOD HCLK <= ~HCLK; //----------------------------------------------------------------------- // Generate HRESETn //----------------------------------------------------------------------- initial begin HRESETn = 1'b0; repeat(5) @(posedge HCLK); HRESETn = 1'b1; end ahb_master #( .START_ADDR (32'h0), .DEPTH_IN_BYTES (SIZE_IN_BYTES) ) u_ahb_master ( .HRESETn (HRESETn), .HCLK (HCLK), .HADDR (HADDR), .HTRANS (HTRANS), .HWRITE (HWRITE), .HSIZE (HSIZE), .HBURST (HBURST), .HWDATA (HWDATA), .HRDATA (HRDATA), .HRESP (HRESP), .HREADY (HREADYOUT) ); ahb_sram # ( .AHB_AWIDTH (32), .AHB_DWIDTH (32), .SIZE_IN_BYTES (SIZE_IN_BYTES), .SYNC_RESET (1) ) u_ahb_sram ( .HCLK (HCLK), .HRESETN (HRESETn), .HSEL (1'b1), .HWRITE (HWRITE), .HADDR (HADDR), .HWDATA (HWDATA), .HRDATA (HRDATA), .HSIZE (HSIZE), .HTRANS (HTRANS), .HBURST (HBURST), .HRESP (HRESP), .HREADYIN (1'b1), .HREADYOUT (HREADYOUT) ); `ifdef VCS initial begin $fsdbDumpfile("top_tb.fsdb"); $fsdbDumpvars; end initial begin `ifdef DUMP_VPD $vcdpluson(); `endif end `endif endmodule这个模块主要是产生了时钟和复位信号,例化了待测模块,以及一个AHB Master的功能模型。具体见下面的代码: //------------------------------------------------------------------------------ // File : ahb_master.v // Editor : VSCode, Tab Size(4) // Description : AHB Master Simulation Model. // //------------------------------------------------------------------------------ `timescale 1ns / 1ps `define SINGLE_TEST `define BURST_TEST module ahb_master #( //---------------------------------- // Paramter Declarations //---------------------------------- parameter START_ADDR = 0, parameter DEPTH_IN_BYTES = 32'h100, parameter END_ADDR = START_ADDR+DEPTH_IN_BYTES-1 ) ( //---------------------------------- // IO Declarations //---------------------------------- input wire HRESETn, input wire HCLK, output reg [31:0] HADDR, output reg [1:0] HTRANS, output reg HWRITE, output reg [2:0] HSIZE, output reg [2:0] HBURST, output reg [31:0] HWDATA, input wire [31:0] HRDATA, input wire [1:0] HRESP, input wire HREADY ); //---------------------------------- // Variable Declarations //---------------------------------- reg [31:0] data_burst[0:1023]; //---------------------------------- // Start of Main Code //---------------------------------- initial begin HADDR = 0; HTRANS = 0; HWRITE = 0; HSIZE = 0; HBURST = 0; HWDATA = 0; while(HRESETn === 1'bx) @(posedge HCLK); while(HRESETn === 1'b1) @(posedge HCLK); while(HRESETn === 1'b0) @(posedge HCLK); `ifdef SINGLE_TEST repeat(3) @(posedge HCLK); memory_test(START_ADDR, END_ADDR, 1); memory_test(START_ADDR, END_ADDR, 2); memory_test(START_ADDR, END_ADDR, 4); `endif `ifdef BURST_TEST repeat(5) @(posedge HCLK); memory_test_burst(START_ADDR, END_ADDR, 1); memory_test_burst(START_ADDR, END_ADDR, 2); memory_test_burst(START_ADDR, END_ADDR, 4); memory_test_burst(START_ADDR, END_ADDR, 6); memory_test_burst(START_ADDR, END_ADDR, 8); memory_test_burst(START_ADDR, END_ADDR, 10); memory_test_burst(START_ADDR, END_ADDR, 16); memory_test_burst(START_ADDR, END_ADDR, 32); memory_test_burst(START_ADDR, END_ADDR, 64); memory_test_burst(START_ADDR, END_ADDR, 128); memory_test_burst(START_ADDR, END_ADDR, 255); repeat(5) @(posedge HCLK); `endif $finish(2); end //----------------------------------------------------------------------- // Single transfer test //----------------------------------------------------------------------- task memory_test; input [31:0] start; // start address input [31:0] finish; // end address input [2:0] size; // data size: 1, 2, 4 integer i; integer error; reg [31:0] data; reg [31:0] gen; reg [31:0] got; reg [31:0] reposit[START_ADDR:END_ADDR]; begin $display("%m: read-after-write test with %d-byte access", size); error = 0; gen = $random(7); for (i = start; i < (finish-size+1); i = i + size) begin gen = $random & ~32'b0; data = align(i, gen, size); ahb_write(i, size, data); ahb_read(i, size, got); got = align(i, got, size); if (got !== data) begin $display("[%10d] %m A:%x D:%x, but %x expected", $time, i, got, data); error = error + 1; end end if (error == 0) $display("[%10d] %m OK: from %x to %x", $time, start, finish); $display("%m read-all-after-write-all with %d-byte access", size); error = 0; gen = $random(1); for (i = start; i < (finish-size+1); i = i + size) begin gen = {$random} & ~32'b0; data = align(i, gen, size); reposit[i] = data; ahb_write(i, size, data); end for (i = start; i < (finish-size+1); i = i + size) begin data = reposit[i]; ahb_read(i, size, got); got = align(i, got, size); if (got !== data) begin $display("[%10d] %m A:%x D:%x, but %x expected", $time, i, got, data); error = error + 1; end end if (error == 0) $display("[%10d] %m OK: from %x to %x", $time, start, finish); end endtask //----------------------------------------------------------------------- // Burst transfer test //----------------------------------------------------------------------- task memory_test_burst; input [31:0] start; // start address input [31:0] finish; // end address input [7:0] leng; // burst length integer i; integer j; integer k; integer r; integer error; reg [31:0] data; reg [31:0] gen; reg [31:0] got; reg [31:0] reposit[0:1023]; integer seed; begin $display("%m: read-all-after-write-all burst test with %d-beat access", leng); error = 0; seed = 111; gen = $random(seed); k = 0; if (finish > (start+leng*4)) begin for (i = start; i < (finish-(leng*4)+1); i = i + leng*4) begin for (j = 0; j < leng; j = j + 1) begin data_burst[j] = $random; reposit[j+k*leng] = data_burst[j]; end @(posedge HCLK); ahb_write_burst(i, leng); k = k + 1; end gen = $random(seed); k = 0; for (i = start; i < (finish-(leng*4)+1); i = i + leng*4) begin @(posedge HCLK); ahb_read_burst(i, leng); for (j = 0; j < leng; j = j + 1) begin if (data_burst[j] != reposit[j+k*leng]) begin error = error+1; $display("%m A=%hh D=%hh, but %hh expected",i+j*leng, data_burst[j], reposit[j+k*leng]); end end k = k + 1; r = $random & 8'h0F; repeat(r) @(posedge HCLK); end if (error == 0) $display("%m %d-length burst read-after-write OK: from %hh to %hh",leng, start, finish); end else begin $display("%m %d-length burst read-after-write from %hh to %hh ???",leng, start, finish); end end endtask //----------------------------------------------------------------------- // As AMBA AHB bus uses non-justified data bus scheme, data should be // aligned according to the address. //----------------------------------------------------------------------- function [31:0] align; input [ 1:0] addr; input [31:0] data; input [ 2:0] size; // num of bytes begin `ifdef BIG_ENDIAN case (size) 1 : case (addr[1:0]) 0 : align = data & 32'hFF00_0000; 1 : align = data & 32'h00FF_0000; 2 : align = data & 32'h0000_FF00; 3 : align = data & 32'h0000_00FF; endcase 2 : case (addr[1]) 0 : align = data & 32'hFFFF_0000; 1 : align = data & 32'h0000_FFFF; endcase 4 : align = data&32'hFFFF_FFFF; default : $display($time,,"%m ERROR %d-byte not supported for size", size); endcase `else case (size) 1 : case (addr[1:0]) 0 : align = data & 32'h0000_00FF; 1 : align = data & 32'h0000_FF00; 2 : align = data & 32'h00FF_0000; 3 : align = data & 32'hFF00_0000; endcase 2 : case (addr[1]) 0 : align = data & 32'h0000_FFFF; 1 : align = data & 32'hFFFF_0000; endcase 4 : align = data&32'hFFFF_FFFF; default : $display($time,,"%m ERROR %d-byte not supported for size", size); endcase `endif end endfunction `include "ahb_transaction_tasks.v" endmodule这个模块主要是实现了两个testcase,一个是测试single传输,另一个测试burst传输。AHB读写传输任务被封装在ahb_transaction_tasks.v文件中: //------------------------------------------------------------------------------ // File : ahb_transaction_tasks.v // Editor : VSCode, Tab Size(4) // Description : AHB Transaction Tasks. // //------------------------------------------------------------------------------ `ifndef __AHB_TRANSACTION_TASKS_V__ `define __AHB_TRANSACTION_TASKS_V__ //----------------------------------------------------------------------- // AHB Read Task //----------------------------------------------------------------------- task ahb_read; input [31:0] address; input [2:0] size; output [31:0] data; begin @(posedge HCLK); HADDR <= #1 address; HTRANS <= #1 2'b10; // NONSEQ; HBURST <= #1 3'b000; // SINGLE; HWRITE <= #1 1'b0; // READ; case (size) 1 : HSIZE <= #1 3'b000; // BYTE; 2 : HSIZE <= #1 3'b001; // HWORD; 4 : HSIZE <= #1 3'b010; // WORD; default : $display($time,, "ERROR: unsupported transfer size: %d-byte", size); endcase @(posedge HCLK); while (HREADY !== 1'b1) @(posedge HCLK); HTRANS <= #1 2'b0; // IDLE @(posedge HCLK); while (HREADY === 0) @(posedge HCLK); data = HRDATA; // must be blocking if (HRESP != 2'b00) $display($time,, "ERROR: non OK response for read"); @(posedge HCLK); end endtask //----------------------------------------------------------------------- // AHB Write Task //----------------------------------------------------------------------- task ahb_write; input [31:0] address; input [2:0] size; input [31:0] data; begin @(posedge HCLK); HADDR <= #1 address; HTRANS <= #1 2'b10; // NONSEQ HBURST <= #1 3'b000; // SINGLE HWRITE <= #1 1'b1; // WRITE case (size) 1 : HSIZE <= #1 3'b000; // BYTE 2 : HSIZE <= #1 3'b001; // HWORD 4 : HSIZE <= #1 3'b010; // WORD default : $display($time,, "ERROR: unsupported transfer size: %d-byte", size); endcase @(posedge HCLK); while (HREADY !== 1) @(posedge HCLK); HWDATA <= #1 data; HTRANS <= #1 2'b0; // IDLE @(posedge HCLK); while (HREADY === 0) @(posedge HCLK); if (HRESP != 2'b00) $display($time,, "ERROR: non OK response write"); @(posedge HCLK); end endtask //----------------------------------------------------------------------- // AHB Read Burst Task //----------------------------------------------------------------------- task ahb_read_burst; input [31:0] addr; input [31:0] leng; integer i; integer ln; integer k; begin k = 0; @(posedge HCLK); HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR ln = leng; end HWRITE <= #1 1'b0; // READ HSIZE <= #1 3'b010; // WORD @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); while (leng > 0) begin for (i = 0; i < ln-1; i = i + 1) begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b11; // SEQ; @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); data_burst[k%1024] <= HRDATA; k = k + 1; end leng = leng - ln; if (leng == 0) begin HADDR <= #1 0; HTRANS <= #1 0; HBURST <= #1 0; HWRITE <= #1 0; HSIZE <= #1 0; end else begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR1 ln = leng; end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); data_burst[k%1024] = HRDATA; // must be blocking k = k + 1; end end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); data_burst[k%1024] = HRDATA; // must be blocking end endtask //----------------------------------------------------------------------- // AHB Write Burst Task // It takes suitable burst first and then incremental. //----------------------------------------------------------------------- task ahb_write_burst; input [31:0] addr; input [31:0] leng; integer i; integer j; integer ln; begin j = 0; ln = 0; @(posedge HCLK); while (leng > 0) begin HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b10; // NONSEQ if (leng >= 16) begin HBURST <= #1 3'b111; // INCR16 ln = 16; end else if (leng >= 8) begin HBURST <= #1 3'b101; // INCR8 ln = 8; end else if (leng >= 4) begin HBURST <= #1 3'b011; // INCR4 ln = 4; end else begin HBURST <= #1 3'b001; // INCR ln = leng; end HWRITE <= #1 1'b1; // WRITE HSIZE <= #1 3'b010; // WORD for (i = 0; i < ln-1; i = i + 1) begin @(posedge HCLK); while (HREADY == 1'b0) @(posedge HCLK); HWDATA <= #1 data_burst[(j+i)%1024]; HADDR <= #1 addr; addr = addr + 4; HTRANS <= #1 2'b11; // SEQ; while (HREADY == 1'b0) @(posedge HCLK); end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); HWDATA <= #1 data_burst[(j+i)%1024]; if (ln == leng) begin HADDR <= #1 0; HTRANS <= #1 0; HBURST <= #1 0; HWRITE <= #1 0; HSIZE <= #1 0; end leng = leng - ln; j = j + ln; end @(posedge HCLK); while (HREADY == 0) @(posedge HCLK); if (HRESP != 2'b00) begin // OKAY $display($time,, "ERROR: non OK response write"); end `ifdef DEBUG $display($time,, "INFO: write(%x, %d, %x)", addr, size, data); `endif HWDATA <= #1 0; @(posedge HCLK); end endtask `endif使用VCS仿真,打印信息如下: 图片 图片 整体仿真波形如下: 图片 不喜欢用DVE的话,也可以选择用Verdi查看波形,这种比较简单的调试,DVE也足够用了。下面贴一张突发传输的细节图: 图片 图片
IP&SOC设计
# SOC设计
刘航宇
3年前
0
690
1
HFSS软件笔记
摘要本文介绍了HFSS软件在电磁场仿真中的应用,包括边界条件、激励方式、求解类型、数据后处理等功能,并详细阐述了HFSS在优化设计、参数扫描、灵敏度分析和统计分析等方面的应用。关键词:HFSS, 电磁场仿真, 麦克斯韦方程, 边界条件, 激励方式目录 一、HFSS中的边界条件(Boundaries) 二、HFSS中的激励方式(Excitation) 三、求解类型和求解设置 四、HFSS中的变量和Optimetrics模块的使用 五、HFSS的数据后处理 六、天线问题的数据后处理 # HFSS软件学习笔记 一、HFSS中的边界条件(Boundaries) 边界条件定义了求解区域的边界以及不同物体交界处的电磁场特性,是求解麦克斯韦方程的基础。 只有在假定场矢量是单值、有界、并且沿空间连续分布的前提下,微分形式的麦克斯韦方程组才是有效的;而在求解区域的边界、不同介质的交界处和场源处,场矢量是不连续的,那么场的导数也就失去了意义。边界条件就是定义跨越不连续边界处的电磁场的特性,因此,正确地理解、定义并设置边界条件,是正确使用HFSS仿真分析电磁场场特性的前提。 边界条件的类型: 理想导体边界(Perfect E) 电场矢量垂直于物体表面,有两种边界被自动设为理想导体边界条件: 1、任何与背景相关联的物体表面将被自动定义为理想导体边界,并命名为outer边界 2、材料设为PEC(理想电导体)的物体表面被自动定义为理想导体边界,并命名为smental 理想磁边界/自然边界(Perfect H) 电场矢量与物体表面相切,磁场矢量与物体表面垂直。 自然边界(Natural):当理想导体边界和理想磁边界出现交叠时,理想磁边界也称为自然边界 注意:在理想导体边界上叠加理想磁边界将去掉理想导体边界的特性,相当于在理想导体表面开个口,允许电场穿过。 有限导体边界(Finite Conductivity) 有耗导体/非理性导体边界条件,电场垂直于物体表面,在电磁波的传播方向上电场会愈来愈小 用户需要设置的参数:导电率和导磁率 注意:当物体的材料设置为非理想导体(如铜、铝等金属材料)时,其表面自动定义为有限导体边界条件。 辐射边界(Radiation) 用于模拟开放的自由空间,模拟波辐射到空间的无限远处的情况,常用于天线问题的分析。当结构中包含辐射边界条件时,HFSS会自动计算结构的远区场。(使用Perfect H边界条件模拟开放空间时,不会计算远区场) 辐射边界条件是自由空间的近似,这种近似的准确程度取决于波的传播方向与辐射边界之间的角度,以及辐射源与边界之间的距离。辐射边界在各个方向上距离辐射体一般不小于1/4个波长。 对称边界(Symmetry) 模拟理想电壁或理想磁壁对称面,应用对称边界可以构造结构时仅构造一部分,减小结构的尺寸和设计的复杂性,缩短计算时间。 定义对称平面时,需要遵循以下原则: 1、对称平面必须暴露在背景中 2、对称面必须定义在平面表面上,不能定义在曲面上 3、在一个问题上最多只能定义三个正交对称面 决定对称面的类型: 1、如果电场垂直于对称面且对称,使用理想电壁对称面 2、如果磁场垂直于对称面且对称,使用理想磁壁对称面 此外使用对称边界条件需要设置阻抗乘法器: 1、理想电壁对称面将结构分为两部分时,只有一半的电压值和一半的能量被计算,由Zpu=U*U/P计算出的阻抗也只有真实值的一半,所以需要定义2倍的阻抗乘法器。 2、理想磁壁对称面将结构分为两部分时,只有一半的能量被计算,而电压保持不变,由Zpu=U*U/P计算出的阻抗是真实值的2倍,所以需要定义0.5倍的阻抗乘法器。图片 图片 在这里插入图片描述 阻抗边界(Impedance) 用于模拟已知阻抗的边界表面,如薄膜电阻表面;表面的阻抗Zs=Rs+jXs。 阻抗的计算: number of "Square"=Length(in direction of current flow)/Width Impedance per Square=Desired Lumped Impedance/number of square 集总RLC边界(Lumped RLC) 类似于阻抗边界条件,利用用户提供的R、L、C值计算出对应的阻抗值 与阻抗边界不同的是,集总RLC边界不需要提供以Ohms/Square为单位的电阻和电抗,而是要给出R、L和C的真实值;之后HFSS就能确定任意频率下集总RLC边界以Ohms/Square为单位的阻抗。 分层阻抗边界条件(Layered Impedance) 分层阻抗边界条件是用多层结构将物体表面模拟为一个阻抗表面,其效果与阻抗边界条件相同; 与阻抗边界条件不同的是,对于分层阻抗边界条件,HFSS是根据输入的分层结构数据和表面粗糙度来计算表面电阻和表面电抗的。 分层边界条件不支持快速扫频。 无限地平面(Infinite Ground Plane) 在设置理想导体边界、有限导体边界或阻抗边界时有"Infinite Ground Plane"复选框。 将有限大的边界表面模拟成无限大地平面的作用,设置无限大平面边界后,在后处理中会影响近区、远区辐射场的计算。 定义无限大平面时,需要满足以下条件: 1、必须暴露在背景上 2、必须定义在平面上、 3、无限大平面和对称面的总数不超过3个 4、所有无限大地平面和对称面必须相互垂直 主从边界(Master and slave) 简称为关联边界条件LBC,主要用于模拟平面周期性结构表面,例如阵列天线。 包括主边界条件(Master)和从边界条件(Slave),总是成对出现,且主边界表面和从边界表面的形状、大小和方向完全相同,主边界表面和从边界表面上的电场存在一定的相位差,该相位差就是周期性结构相邻单元之间存在的相位差。 定义主从边界表面时,用户需要正确设置U、V坐标系,保证主从边界表面大小和方向完全一致。 理想匹配层(PML) 理想匹配层,是能够完全吸收入射电磁波的假想各项异性材料边界。理想匹配层有两种典型的应用:一是用于外场问题中的自由空间截断,二是用于导波问题中的吸收负载。 对于导波的吸收负载,理想匹配层模拟导波结构均匀地延申到无穷远处。 对于自由空间截断地情况,理想匹配层地作用类似于辐射边界条件,PML表面能够完全吸收入射过来地电磁波。和辐射边界条件相比,理想匹配层因为能够完全吸收入射的电磁波,零反射,因此计算结果更精确;同时理想匹配层表面可以距离辐射体更近(差不过十分之一个波长即可),不需要像辐射边界表面一般需要距离辐射体大约四分之一个波长。二、HFSS中的激励方式(Excitation) HFSS中,激励是一种定义在三维物体表面或者二维物体上的激励源,这种激励源可以是电磁波激励、电压源或者电流源,激励端口是一种允许能量进入或流出几何结构的特殊边界条件类型。 激励类型: 波端口(Wave Port) 默认情况下,所有三维物体和背景之间的接触面都是理想导体边界,没有能量可以进出;波端口设置在背景上,用作模型的激励源并提供一个能量进入/流出的窗口。波端口一般设置在背景平面上,不允许端口平面弯曲。 波端口模式(modes):对于给定横截面的波导或传输线,特定频率下有一系列的解满足相应的边界条件和麦克斯韦方程组,每个解都称之为一种模式,或者说一种波形。通常,模式是根据电场和磁场沿导波系统传输方向上有无分量这一情况来命名的,假设导波系统沿z轴放置,上述分量是指z向的电场分量Ez和磁场分量Hz。 对于Ez=0、Hz=0一类的模,称之为横电磁模,即TEM模; 对于Ez=0、Hz不为0一类模,称之为横电模,即TE模; 对于Ez不为0、Hz=0一类的模,称之为横磁模,即TM模。 端口校准:波端口必须被校准以确保一致的结果;校准的目的有两个,确定场的方向、设置电压的积分路径。 端口平移(Deembed):是指平移端口的位置,查看其对计算结果的影响;选中使用端口平移功能,只影响数据后处理,HFSS不会重新进行仿真计算。HFSS端口平移中正数表示参考平面向模型内部移动,负数则是向外延申。 终端线(Terminal):对于终端驱动的求解类型,终端的S参数反映的是波端口节点电压和电流的线性叠加,通过波端口处的节点电流和电压可以计算出端口的阻抗和S参数矩阵。 集总端口(Lumped Por) 集总端口激励和波端口激励是HFSS中最常用的两种激励方式。 集总端口激励类似于传统的波端口,与波端口不同的是集总端口可以设置在物体模型内部,且用户需要设定端口阻抗;集总端口直接在端口处计算S参数,设定的端口阻抗即为集总端口上S参数的参考阻抗;另外集总端口不计算端口处的传播常数,因此集总端口无法进行端口平移操作。 集总端口激励的尺寸大小要比波端口小 Floquet端口(Floquet Port) 与波端口的求解方式类似,Floquet端口求解的反射和传输系数能够以S参数的形式显示。使用Floquet端口激励并结合周期性边界,能够像传统波导端口激励一样轻松的分析周期型结构的电磁特性,从而避免了场求解器复杂的后处理过程。 入射波(Incident Wave) 是用户设置的朝某一特定方向传播的电磁波,其等相位面与传播方向垂直;入射波照射到器件表面和器件表面的夹角称为入射角。入射波激励常用于雷达反射截面(RCS)问题的计算。 需要设置的参数有:波的传播方向(Poynting Vector)、电场的强度和方向。 电压源激励(Voltage) 电压源激励定义在两层导体之间的平面上,用理想电压源来表示该平面上的电场激励。 电压源激励时需要设置的参数有:电压的幅度、相位和电场的方向。 注意:电压源激励所在的平面必须远小于工作波长,且平面上的电场是恒定电场;电压源激励是理想的源,没有内阻,因此后处理时不会输出S参数。 电流源激励(Current) 电流源激励定义于导体表面或者导体表面的缝隙上,用理想电流源来表示该平面上激励。 电流源激励需要设定的参数有:导体表面缝隙的电流幅度、相位和方向。 注意:电流源激励所在的平面/缝隙必须小于工作波长,且平面/缝隙上的电流是恒定的;电流源激励是理想的源,没有内阻,因此后处理时不会输出S参数。 磁偏置激励(Magnetic Bias) 创建一个铁氧体材料时,必须通过设置磁偏置激励来定义网格的内部偏置场;该偏置场使得铁氧体中的磁性偶极子规则排列,产生一个非零的磁矩。 如果应用的偏置场时均匀的,张量坐标系可以通过旋转全局坐标系来设置 如果应用的偏置场时非均匀的,不允许旋转全局坐标来设置张量坐标系三、求解类型和求解设置 1、HFSS中有三种求解类型:模式驱动求解(Driven Model)、终端驱动求解(Driven Terminal)和本征模求解(Eigenmode) 模式驱动求解类型:以模式为基础计算S参数,根据导波内各模式场的入射功率和反射功率来计算S参数矩阵的解。 终端驱动求解类型:以终端为基础计算导体传输线端口的S参数;此时,根据传输线终端的电压和电流来计算S参数矩阵的解。 本征模式求解类型:本征模式求解器主要用于谐振问题的设计与分析,可以用于计算谐振结构的谐振频率和谐振频率处对应的场,也可以用于计算谐振腔体的无载Q值。 应用本征模式求解时注意: 不需要设置激励方式 不能定义辐射边界条件 不能进行扫频分析 不能包含铁氧体材料 只有场解结果,没有S参数求解结果2、自适应网格剖分:在分析对象内部搜索误差最大的区域并进行网格的细化,每次网格细化过程中网格增加百分比由用户事先设置,完成一次细化过程后,重新计算并搜索误差最大的区域,然后判断误差是否满足设置的收敛条件。如果满足收敛条件,则完成网格剖分;如果不满足收敛条件,继续下一次网格细化过程,直到满足收敛条件或者达到设置的最大迭代次数为止。 3、求解频率(网格自适应剖分频率)的选择 HFSS计算时自适应网格剖分是在用户设定的单一频点上进行的,网格剖分完成后,同一个求解设置项下其他频点的求解都是基于前面设定频点上所完成的网格划分。自适应频率设置越高,网格剖分就越细,网格个数就越多,计算结果也相应地更加准确,但同时计算过程中所占用地计算机内存也就越高,计算所花费地时间也越长。 下面给出几个常用问题类别的自适应频率的选择: 点频或窄带问题:对于点频或者窄带问题,自适应网格剖分直接选择工作频率。 宽带问题:对于宽带问题,应该选择最高频率作为自适应网格剖分频率。 滤波器问题:对于滤波器问题,由于阻带内电场只存在于断口处,所以自适应频率选择在通带内的高频段。 快速扫频问题:对于快速扫频问题,典型的做法就是选择中心频率作为自适应频率。 高速数字信号:对于高速数字信号完整性分析问题,需要借助转折频率(Knee Frequency)来决定自适应网格剖分频率 4、扫频分析 离散扫频(Discrete):是在频带内的指定频点处计算S参数和场解。例如,指定频带范围为1~2GHz、步长为0.25GHz,则会计算在1GHz、1.25GHz、1.5GHz、1.75GHz、2GHz频点处的S参数和场解。默认情况下,使用离散扫频只保存最后计算频率点的场解。如果希望保存指定的所有频率点的场解,需要选中设置对话框中Save Fields复选框。 快速扫频(Fast):采用ALPS算法,在很宽的频带范围内搜寻处传输函数的全部零、极点。快速扫频适用于谐振问题和高Q值问题的分析,可以得到场在谐振点附近行为的精确描述。使用快速扫频,一般选择频带中心频率作为自适应网格剖分频率进行网格剖分,计算出该频点的S参数和场分布,然后使用基于ALPS算法的求解器从中心频率处的S参数解和场解来外推整个频带范围的S参数和场解。使用快速扫频,计算时只会求解中心频点处的场解,但在数据后处理时整个扫频范围内的任意频点的场都可以显示。 插值扫频(Interpolating):插值扫频使用二分法来计算整个频段内的S参数和场解。使用插值扫频,HFSS自适应选择场解的频率点,并计算相邻两个频点之间的解的误差,找出最大误差,当两点之间的最大误差达到指定的误差收敛标准或者达到了设定的最大频点数目后,扫描完成;其他频率点上的S参数和场解由内插给出。 四、HFSS中的变量和Optimetrics模块的使用 HFSS不仅能够提供常规的电磁分析,还能够提供优化分析、参数扫描分析、灵敏度分析和统计分析等功能。这些功能都集中在HFSS中的Optimetrics模块中。要使用Optimetrics模块的这些分析和设计功能。首先需要定义和添加相关变量。 1、HFSS中变量的定义和使用 (1)HFSS中有两种类型的变量:工程变量(Project Variables)和设计变量/本地变量(Local Variables) 工程变量和设计变量的区别: 工程变量前面有一个"$"前缀,以和本地变量区分 工程变量作用区间是整个Project,本地变量作用区间是所在的Design 物体模型尺寸、物体的材料属性(工程变量)等都可以使用变量来表示。 (2)变量的定义 变量名:可以由数字、字母或下划线组成。每个变量在定义时都必须赋一个初始值,变量值可以是数值、数学表达式或者数学函数,也可以是数组、矩阵或者行列式。 添加/删除变量:工程变量和设计变量操作不同 添加和删除工程变量:Project > Project Variables 或者 [Project Tree] Project > Project Variables 打开 Project Properties 对话框 添加和删除设计变量:HFSS > Design Properties 或者 [Project Tree] Design > Design Properties 打开 Design Properties 对话框 在设计过程中,也可以直接输入未定义的变量代替设计参数,输入未定义的变量后,HFSS会自动弹出添加变量的对话框 2、Optimetrics模块的功能介绍 Optimetrics是集成在HFSS中的优化设计模块,该模块通过自动分析设计参数的变化对求解结果的影响,HFSS中Optimetrics模块能够提供如下分析设计功能: 参数扫描分析(Parametric) 参数扫描分析功能可以用来分析物体的性能随着指定变量的变化而变化的关系,在优化设计之前一般使用参数扫描分析功能来确定被优化变量的合理变化区间 参数扫描分析步骤: 首先需要定义变量并添加求解设置项 HFSS > Optimetrices > Add Parametric...弹出 Setup Sweep Analysis 对话框,添加扫描变量 或选中Project Manager 中的 Optimetrics,单击右键 Add > Parametric,弹出 Setup Sweep Analysis 对话框,添加扫描变量 设置好扫面变量后,点击”Analyze“就可以进行参数扫描分析 查看分析结果 优化设计(Optimization) 优化设计是HFSS软件结合Optimetrics模块根据特定的优化算法在所有可能的设计变化中寻找出一个满足设计要求的值的过程 优化设计的过程: 首先需要明确设计要求或设计目标 然后用户根据设计要求创建初始结构模型(Nominal Design)、定义设计变量并构造目标函数 最后指定优化算法进行优化。 图片 图片 在这里插入图片描述 调谐分析(Tuning) 调谐分析功能是改变变量值的同时实时显示对求解结果的影响程度 HFSS中的调谐分析功能是用户在手动改变变量值得同时能实时显示求解结果 图片 图片 在这里插入图片描述 灵敏度分析(Sensitivity) 灵敏度定义为电磁特性/求解结果的变化与电路参数的变化的比值,使用HFSS进行电磁分析时S参数是很常用的一个分析结果。灵敏度分析功能是用来分析设计参数的微小变化对求解结果的影响程度 统计分析(Statistical) 统计分析功能是利用统计学的观点来研究设计参数容差对求解结果的影响,常用的方法是蒙特卡洛法 图片 图片 在这里插入图片描述 五、HFSS的数据后处理 使用HFSS进行电磁问题的求解分析过程中以及完成求解分析之后,利用数据后处理功能能够直观地给出问题地各种求解信息和求解结果。 1、求解信息数据(Solution Data) HFSS > Results > Solution Data 命令,或者右键单机工程树Results节点,从弹出菜单中选择Solution Data命令,可以打开求解信息对话框,显示各种求解信息。 2、Results数值结果 (1)显示方式 HFSS后处理模块能够以多种方式来显示分析数值结果,这些数值结果地显示方式包括:(右击Results > Create Model Solution Data Report) Rectangular Plot:直角坐标图形显示 Rectangular Stacked Plot Polar Plot:极坐标图像显示 Data Table:数据列表显示 Smith Chart: 史密斯圆图显示 3D Rectangular Plot:三维直角坐标 3D Polar Plot:三维球坐标图形显示 Radiation Pattern:辐射方向图 (2)参数类型 模式驱动求解: Output Variables:用户自定义的输出变量 S Parameter:散射参数 Y Parameter:导纳参数 Z Parameter:阻抗参数 VSWR:电压驻波比 Gamma:传播常数 Port Zo:端口特征阻抗 Active S Parameter Active Y Parameter Active Z Parameter Active VSWR 终端驱动求解: Output Variables:用户自定义的输出变量 S Parameter:散射参数 Y Parameter:导纳参数 Z Parameter:阻抗参数 VSWR:电压驻波比 Power:功率 Voltage Transform matrix:电压传输矩阵 Terminal Port Zo:端口特征阻抗 Active S Parameter Active Y Parameter Active Z Parameter Active VSWR (3)输出变量 右键单击工程树下的Result节点,从弹出菜单中选择Output Variables命令,便可打开输出变量的定义对话框 3、Field Overlays场分布图 在HFSS求解完成之后可以通过右击 Field Overlays 来查看电场、磁场、电流密度、坡印廷矢量等场分布图。 (1)电场E Mag_E:电场幅度瞬时值 ComplexMag_E:电场幅度有效值 Vector_E:电场矢量 (2)磁场H Mag_H:磁场幅度瞬时值 ComplexMag_H:磁场幅度有效值 Vector_H:磁场矢量 (3)电流密度J Mag_Jvol:体电流密度瞬时值 ComplexMag_Jvol:体电流密度有效值 Vector_Jvol:体电流密度矢量 Mag_Jsurf:面电流密度瞬时值 ComplexMag_Jsurf:面电流密度有效值 Vector_Jsurf:面电流密度矢量 (4)其他 Vector_RealPoynting:坡印廷矢量 Local\_SAR和Average\_SAR:局部SAR值和平均SAR值 六、天线问题的数据后处理 1、天线方向图 创建天线的方向图:Results > Create Model Solution Data Report > 3D Polar Plot 天线的辐射场在固定距离上随球坐标系的角坐标 θ 、φ 分布的图形被称为辐射方向图,简称方向图。方向图通常在远区场确定。用辐射场强表示的方向图称为场强方向图,用辐射功率密度表示的方向图称为功率方向图。 2、天线性能参数 右击Radiation,创建好查看天线性能参数:右击天线辐射方向图 > Compute Antenna Parameters Incident Power:输入功率 HFSS中输入功率是指定义的端口激励功率 Acceptable Power:净输入功率 净输入功率是指世纪流入天线端口的输入功率,如果分别使用 Pacc 和 Pinc 表示净输入功率和输入功率,对于只有一个传输模式的单端口天线,有: 图片 Radiated Power:辐射功率 辐射功率是指经由天线辐射到自由空间里的电磁能量,天线的辐射功率可以用坡印廷矢量的曲面积分来计算: 图片 Radiation Efficiency:辐射效率 辐射效率是辐射功率和净输入功率的比值 图片 Max U:最大辐射强度 辐射强度U是指每单位立体角内天线辐射出的功率,Max U是辐射强度的最大值 图片 η 自由空间中的波阻抗为 377Ω,r 为远区场点与天线之间的距离 Peak Directivity:方向性系数 天线的方向性系数是指在相同的辐射功率和相同的距离的情况下,天线在最大辐射方向上的辐射功率密度与无方向性天线在该方向上的辐射功率密度的比值图片 Peak Gain:天线增益 天线增益是指在相同的净输入功率和相同距离的情况下,天线在最大辐射方向上的辐射功率密度与无方向性天线在该方向上的辐射功率密度的比值图片 Peak Realized Gain:最大实际增益 天线的最大实际增益是指在相同的输入功率和相同距离的情况下,天线在最大辐射方向上的辐射功率密度与无方向性天线在该方向上的辐射功率密度的比值 Front to back Ration:前后向比 又称为轴比(Axis Ratio),指方向图中前后瓣的最大比值,代表天线的极化程度 3、天线阵的处理 由相同的天线单元构成的天线阵的方向图等于单个天线单元的方向图与阵因子的乘积。其中,阵因子取决于天线单元之间的振幅、相位差和相对位置,与天线的类型、尺寸无关。在HFSS中,可以定义天线阵元排列结构和激励方式,然后通过仿真分析分析单个天线单元的方向图等天线参数和阵因子来仿真分析整个天线阵列的方向图等天线参数。HFSS支持两种天线阵列类型:规则排列的均匀天线阵列(Regular Uniform Array)和用户自定义排列(Custom Array)。 其中用户自定义阵列:允许用户使用文本文件自定义阵因子信息,然后导入到HFSS软件中,HFSS计算得到阵因子。用户自定义阵列允许更大的灵活性,可以构造天线阵元在空间任意分布的天线阵列。
通信&信息处理
# 天线设计
刘航宇
3年前
0
5,669
2
上一页
1
2
3
4
...
9
下一页