🌍首页
📁归档
⏳时光机
🚩友链
📫留言
📧订阅
🌟推荐
📕考研课程
🏜️ 免费壁纸
❤ 捐助本站
💰资助名单
🎵音乐实验
Search
1
【NPN/PNP三极管】放大电路饱和失真和截止失真的区别
20,377 阅读
2
论文写作中如何把word/wps里面所有数字和字母替换为新罗马字体
10,873 阅读
3
【高数】形心计算公式讲解大全
9,201 阅读
4
Vivado-FPGA Verilog烧写固化教程
8,296 阅读
5
【概论】一阶矩、二阶矩原点矩,中心矩区别与概念
7,978 阅读
🪶微语&随笔
励志美文
我的随笔
工作办公
📡电子&通信
嵌入式&系统
通信&信息处理
编程&脚本笔记
⌨️IC&系统
FPGA&ASIC
VLSI&IC验证
EDA&虚拟机
💻电子&计算机
IP&SOC设计
机器学习
软硬件算法
登录
/
注册
Rs(共100篇)
找到
100
篇与
Rs
相关的结果
- 第 4 页
2023-03-04
AMBA--AHB总线协议介绍(二)
摘要本文介绍了AMBA-AHB总线协议的突发提前终止、控制信号、地址译码、从机传输响应、数据总线、总线仲裁机制和分段传输等内容。关键词:AMBA, AHB总线协议, 突发传输, 控制信号, 地址译码1、突发提前终止 在特定情况下,一个突发传输会被提前终止,此时,要求从机能根据突发信息采取正确的动作。从机能够通过监控HTRANS信号一个突发传输是否被提前终止。在突发传输开始后,从机每次传输都会监测HTRANS信号是否为SEQ或BUSY,当HTRANS信号上出现NONSEQ或者IDLE时,则表明前一次突发传输已经终止。 当一个主机因为仲裁失败导致突发传输未能完成,则在该主机下一次获得总线所有权时,必须能够保证重建该突发完成剩余传输。例如,当主机只完成一个4拍突发传输的一拍,那么它必须使用一个未定长度的突发来完成剩下的三拍传输。 下图表示了一个四拍的回环突发操作,从机在第一次传输插入了一个等待状态,该突发传输大小为4Byte,为4拍传输,所以地址将在16字节边界回环,因此传输到0x3C后,下一次的传输地址将返回到0x30: 图片 下图表示了一个4拍增量突发,在第一次传输时从机也插入了一个等待状态,地址是连续的,跨过了16字节地址地址边界: 图片 下图表示了一个8拍的回环突发传输,传输大小为4Byte,所以地址将在32字节边界回环,回环之后的地址为0x20: 图片 下图表示8拍增量突发,传输大小为2Byte,所以地址增量为2,同时传输会跨过16字节的地址边界: 图片 下图表示了未定义长度的突发传输,从图中可以看出,该图包含两个未定义长度的突发传输,第一个位起始地址为0x20,传输大小为2Byte;第二个突发起始地址为0x5C,传输大小为4Byte,地址增量为4: 图片 2、控制信号 和传输类型可突发类型信号一样,每次传输都会有一组控制信号来提供传输的附加信息。这些控制信号和地址总线具有相同的时序,和地址信号不同的是,这些控制信号在突发传输的过程中,必须保持不变。 2.1 传输方向 HWRITE为高时,表示写传输,并且主机需要数据广播到写数据总线(HWDATA)上;该信号为低时,表示读传输,从机必须产生数据到读数据总线(HRDATA)。 2.1 传输大小 HSIZE[2:0]表示传输大小,见下表: 图片 注:传输大小和传输类型一起被用于计算回环突发传输的地址边界。 2.3 保护控制 HPROT[3:0]为总线协议保护信号,用于定义存取的型态与特性,表示传输是否是: 一次预取址或者数据访问; 特权模式访问或者用户模式访问; 对于带有存储器管理单元的主机来说这些信号也表示当前访问是带高速缓存(cache)的或是带缓冲(buffer)的; HPROT[3]高速缓存HPROT[2]带缓冲的HPROT[1]特权模式HPROT[0]数据/预取指描述---0预取指---1数据访问--0-用户模式访问--1-特权模式访问-0--无缓冲-1--带缓冲0---无高速缓存1---带高速缓存注意:并非所有的主机都能产生正确的保护控制信号,因此建议从机没有严格必要的情况下,不要使用HPROT信号。 3、地址译码 AHB总线中,会使用一个中央译码器来产生HSELx信号,用于选择从机,选择信号由地址高位信号组合译码产生。建议使用简单的译码方案来保证高速操作。 从机只能在HREADY信号为高时,采样地址和控制信号以及HSELx,当HREADY信号为高时,表示传输完成。 AHB有几个特别的规定: (1)每个从机至少都有 1KB 的内存空间。 (2)每个主机每次存取的空间不可超过 1KB。 (3)如果在 NONSEQ 或 SEQ 型态下存取到不存在的地址时,会有一个预设的从机发出 ERROR 的响 应信号。 (4)如果在 IDLE 或 BUSY 型态下存取到不存在的地址时,会有 OKAY 的响应信号。 (5)预设的从机是中央译码器的一部分。 (6)根据系统设计,使用地址的高位来产生从机选择信号。 (7)地址的低位送给从机以寻址其的内部存储器或缓存器 图片 4、从机传输响应 主机发起传输后,由从机决定传输如何进行。一旦传输发起,协议不允许主机取消传输。 被访问的从机必须提供一个传输状态的响应。从机使用HREADY信号和HRESP[1:0]信号的组合,来提供传输状态。 从机可以提供多种方式来完成传输: (1)立刻完成传输; (2)插入一个或多个等待状态以获得充分时间来完成传输; (3)发出一个错误应答表示传输失败; (4)延时传输的完成,允许主机和从机放弃总线,让其他主机先完成传输,再完成剩下的传输。 4.1 传输完成 HREADY信号用于扩展AHB传输中的数据相位,HREADY为低表示传输被扩展,为高表示传输完成。 注意:每个从必须预先设定它放弃总线之前能插入的最大等待周期,用来计算访问总线的延时。推荐但不 必须的是, 等待状态最多只可使用 16 个周期,已防止任何访问长时间占用总线。 从机需要 HREADY 是双向信号(HREADY 做为总线上的信号,它是主机和从机的输入;同时每个从机自己的 HREADY 信号是输出。所以对于从机会有两个 HREADY 信号,一个来自总线的输入,一个自己给到多路器的输出。 4.2 传输响应 HRESP[1:0]的编码及传输响应信号如下表: HRESP[1:0]ReponseDescription00OKAY从机可以用HREADY (拉高)与OKAY 的信号响应,代表传送已成功完成。HREADY 被拉低,加上OKAY的信号可插入在任何的响应信号(ERROR、 RETRY 或SPLIT) 之间,也就是当从机在未能正确的选择ERROR、RETRY 或SPLIT时,可以插入HREADY (拉低)与OKAY信号,但是等待状态最多只可使用16个周期01ERROR此次数据传送发生错误,该信号必须维持两个时钟周期10RETRY传输未完成,主机应尝试再次发起传输,直到传输完毕,该信号必须维持两个时钟周期11SPLIT此信号必须维持两个周期,从机响应此信号表示此次的传送无法完成,要以分段传送方式来达成。等到从机可以完成时,会知会仲裁器,让重提数据传送要求的主机,完成传送4.3 双周期响应 仅有OKAY响应可以在单周期给出,ERROR、RETRY、SPLIT响应至少需要两个周期。为了完成这些响应,从机会在倒数第二个周期驱动HRESP为ERROR或RETRY或SPLIT,同时拉低HREADY以获得一个额外的扩展周期。在最后一个周期,HREADY拉高,表示传输完成,同时保持HRESP。 如果从机需要两个以上的周期来完成ERROR、RETRY、SPLIT响应,则从机可能在传输开始时,插入等待状态。在这段周期内,从机拉低HREADY,同时只能给出OKAY响应。 需要双周期响应是AHB流水线传输的本质决定的,当从机发起ERROR、RETRY、SPLIT响应时,下一次传输的地址已经被广播到地址总线上了,双周期响应允许主机有足够的时间来取消该地址,并在下一次传输开始之前驱动HTRANS为IDLE。 下图表示了一个RETRY应答,从图中可知,传输的起始地址为A,传输大小为4Byte,主机在获得响应之前,已经将地址设置为A+4,从机在地址A不能立即完成传输,因此给出RETRY响应,这个响应指示主机地址A的传输未完成,并且地址A+4的传输被IDLE传输类型取代。 图片 下图表示了传输中,从机需要一个周期(HRESP为OKAY)来决定给出何种响应的例子,之后从机给出双周期的ERROR响应结束了传输。 图片 4.4 错误响应 当主机收到一个 ERROR响应时,它可以选择结束当前的批量数据传送,也可以继续传送剩下的批量数据,但通常不这样做。在从机送出 ERROR的信号之前必须先送出OKEY + HREADY (LOW)的信号,而 ERROR 信号至少需要维持两个周期。如上图所示。 (1)在第二个周期 S 送出 OKAY+ low HREADY 信号,使从机有充分的时间决定是否需要发出 ERROR 的信号; (2)主机收到ERROR应答后,立刻结束当前的数据传送; 注意:从机必须维持ERROR至少两个周期 4.5 分块和重试 分块和重试响应给从机提供了在无法立刻给传输提供数据时释放总线的机制。这两种响应都允许在总线上结束传输,因此允许更高优先级的主机获得总线访问权。 SPLIT和RETRY的不同之处在于仲裁器在发生SPLIT和RETRY后分配总线的方式: (1)对RETRY而言,仲裁器将继续使用常规优先级方案,因此只有拥有更高优先级的主机能获得总线访问权; (2)对SPLIT而言,仲裁器将调整优先级方案,以便其他任何主机申请总线即能获取总线,即使这个主机拥有更低的优先级。为了完成SPLIT传输,从机必须通知仲裁器数据何时可用,以便相应主机完成传输。 SPLIT传输机制增加了仲裁器和从机的复杂度,却拥有完全释放总线给其他主机使用的有点;RETRY相应就只允许更高优先级的主机使用总线。 主机使用相同的方式处理SPLIT和RETRY相应。主机应继续请求总线,并尝试传输,知道传输完成或收到ERROR相应为止。 5、数据总线 为了避免使用三态数据总线,AHB协议将数据总线分开为读数据总线和写数据总线。最小的数据位宽为32位,且位宽可增加。 5.1 写数据总线HWDATA[31:0] 1、写出数据由主机发出; 2、主机必须将数据总线上的数据维持住,直到从机完成数据的接收 (HREADY HIGH); 3、所有传送所对应的地址都必须对齐,例如: 32 位的传送地址 Addr[1:0] = 00; 4、大端摆放法(big endian)或小端摆放法(little endian)都可使用 4.11小端摆放法(以 32 位为例) (1)低字节在 HWDATA.的低字节地址 (2)Byte 0 (address offset = 0) 在 HWDATA[7:0] (3)Byte 1 (address offset = 1) 在 HWDATA[15:8] (4)Byte 2 (address offset = 2) 在 HWDATA[23:16] (5)Byte 3 (address offset = 3) 在 HWDATA[31:24] 4.12大端摆放法 (1)低字节在 HWDATA.的高字节地址 (2)Byte 0 (address offset = 0) 在 HWDATA[31:24] (3)Byte 1 (address offset = 1) 在 HWDATA[23:16] (4)Byte 2 (address offset = 2) 在 HWDATA[15:8] (5)Byte 3 (address offset = 3) 在 HWDATA[7:0] 5.2 读数据总线HRDATA[31:0] 读数据总线在读数据期间,由被选中的从机驱动,如果从机通过拉低HREADY信号来扩展传输,则从机只需在最后一个周期提供有效数据,由HREADY信号为高表示。 端结构与写数据总线相同。 从机只需要在OKAY响应周期提供有效数据,SPLIT、RETRY以及ERROR响应不需要提供有效的读数据。 6、总线仲裁机制 仲裁机制确保了任何时刻只有一个主机可以访问总线。仲裁器的功能如下: (1)通过观察不同的总线请求信号,通过仲裁算法来决定哪个主机拥有最高优先级; (2)接收从机的完成分段传送的请求 仲裁信号描述如下表所示: NameWidthDescriptionHBUSREQx1bit由主机到仲裁器,主机通过此信号对仲裁器提出使用总线的要求。主机可在任何时间要求仲裁器对于固定长度的传送,只要发起一次请求即可, 仲裁器会依据HBURST[2:0]来判断传送的长度。对于未定的传送长度,主机必须持续提出请求,直到完成全部的传送为止。当所有主机都不需要使用总线时,必须在HTRANS.上送出IDLE信号,仲裁器就会将总线的使用权交给预设主机(default M)HLOCKx1bit此信号必须与HBUSREQx配合,表示一个不可分段的传送动作,HLOCKx必须再指定地址之前使能一个周期HGRANTx1bit由仲裁器输出到主机,仲裁器通知某个主机表示此主机得到总线的使用权.主机在HGRANT信号为高且HREADY信号也为高的那个HCLK上升沿处获得总线使用权 HMASTER4bit仲裁器以此信号表示当前是哪一个主机在使用总线,此信号也可用来控制地址多任务器HMASTERLOCK1bit仲裁器以此信号表示当前的总线是被锁住的,此信号与地址和控制信号具有相同的时序HSPLIT16bit一个可执行分段传送的从机以此信号让仲裁器知道要让哪一个主机完成其未完成的分段传送6.1 总线访问请求 主机可以在任何周期内使用HBUSREQx信号来请求总线。仲裁器会在时钟上升沿根据内部的优先级仲裁算法决定接下来哪一个主机将获得总线访问权。 通常仲裁器会在一个突发传输完成后才会授权另一个主机,但是如果需要的话,仲裁器也可以提前终止突发,将总线访问权授予更高优先级的主机。 如果一个主机需要锁定总线,那么它必须声明HLOCKx信号,告知仲裁器其他主机不应该被授予总线。 当主得到总线授权,并且正在执行一个定长的突发传输,它不需要继续总线请求即可完成这个 burst。仲裁器观察 突发的进程,并使用 HBURST[2:0]来决定主机有多少个传送。如果主机希望在当前正在进行的突发之后继续 1 次传输,它应在当前突发期间重新声明请求信号。 如果主机在突发传输过程中失去了总线访问权,那么它必须重新声明HBUSREQx信号以获得重新授权。 对于未定长度的突发,主机需持续声明HBUSREQx,知道最后一个传输已经开始。因为在未定长度的突发中,仲裁器不知道何时可以改变总线授权。 主机没有请求,也可能获得了总线控制权。这是因为当没有主机去请求总线时,总线会授权给一个默认的主机。 所以当某个主机不需要总线访问,它需要把传送类型 HTRANS 设置为 IDLE,这点很重要。 6.2 授予总线访问 仲裁器通过声明HGRANTx信号来表示当前拥有最高优先级的主机,HREADY信号为高时,主机将被授予总线,同时仲裁器改变HMASTER[3:0]来表示主机序号。 下图表示一个零等待的总线授予访问: 图片 下图表示了有等待状态总线授予访问: 图片 数据总线的拥有权必须比地址总线的拥有权晚释放出去, 这是因为数据周期发生在地址周期之后。 (1)在 T5 正沿,从机送出 HREADY 信号,表示 M1成功传送最后一次传输的地址及控制信号 (2)地址总线在 T5 正沿开始交换使用者,当 HGRANT_M2 AND HREADY = HIGH,表示地址总线交换成功 (3)仲裁器必须知道 M1还有多少笔数据要传送,才可正确的发出 HGRANT_M2 信号 (4)当仲裁器收到最后一个传输地址后,仲裁器就会改变 HGRANTx 信号 (5)T5 刚开始时, M2 送出地址与控制信号 (6)数据总线的交换只有在上一笔数据传送结束后才会开始 (7)在 T7 正沿,开始数据总线的交换 图片 下图表示了仲裁器在一次突发结束后移交总线的例子: (1)仲裁器在倒数第二个地址被采样时(T5),改变HGRANTx信号; (2)新的HGRANTx信息将在最后一个地址被采样时(T7)同时被采样。 图片 下图表示了HGRANTx和HMASTER信号在系统中是如何被使用的: !注意:由于使用了中央地址译码器,每个主机可以立刻输出它想被执行的地址,而不用等到被授予总线。HGRANTx信号仅被主机用来决定它何时拥有总线,并考虑何时地址被选中的从机采样。HMASTER的延迟信号被用来控制写数据总线数据选择器。 6.3 锁定传输 仲裁必须从观察每一个主机的 HLOCKx 信号, 来决定什么时候主机希望执行一个锁定顺序传输。之后仲裁器负责确保没有其他主机被授权,直到这个锁定传输完成。 在一个连续锁定传输之后,仲裁将总是还会保持当前的主机的授权来传一个附加的传送来保证锁定传输的序列的最后一个传送已经成功完成,并且没有收到 SPLIT or RETRY 的应答之一。 所以推荐但并不是强制要求的做法是,主机在任何锁定传输后插入一个 IDLE 传输,在开始其它突传输之前,来提供一个仲裁切换的机会。 仲裁器也负责声明HMASTERLOCK信号,该信号与地址和控制信号具有相同的时序。该信号指示从机当前传输时锁定的,因此必须在其他主机被授予总线之前处理完成。 6.4 默认总线主机 每个系统都必须包含一个默认总线主机,当其他主机都不能使用总线时,该主机被授予总线。默认主机在获得授予总线时,只能执行IDLE传输。 如果所有主机都还在等待 SPLIT传输的完成,也会将总线使用权交给默认主机。 7、分段传输 从机可以用 SPLIT 来解决延迟太长的传输。 仲裁器必须观察响应信号并且遮掉(mask)已被分段传送的主机,使其等候 HSPLIT 信号的通知后才授予其总线使用权。 仲裁器必须在 HMASTER[3:0] 上产生一个标签表示哪一个主机正在执行数据传送。 当从机要执行分段传输的动作时,这个从机必须存下主机序号。 当从机可以完成被分段的传输时会在 HSPLITx[15:0]信号上,送出要完成传送的主机序号。 仲裁器以 HSPLITx[15:0] 来决定哪一个主机 可以重新获得 bus 的使用权。 仲裁器会在每个周期去观察 HSPLITx 信号。 当有多个 HSPLITx 信号时,会被逻辑或在一起传送给仲裁器。 7.1 分段传输顺序 1、主机送出地址与控制信号,开始传送。 2、被寻址到的从机立即提供数据,或者送出SPLIT应答信号(如果需要等些周期来获得数据)。在每次的传输,仲裁器会广播出当前是哪一个主机在使用总线。 从机需要记录主机序列号,以便后面重传使用。 3、有 SPLIT 信号响应时,仲裁器会将总线使用权交给别的主机使用,如果所有其它主机都收到SPLIT 信号,则移交给默认主机。 4、当从机要完成分段传送时, 从机会在 HSPLITx 上设定对应的主机 ID,来指示哪个主机可以被允许再次访问总线。 5、仲裁器会在每个周期观察 HSPLITx 信号,如果有变化,就更改正确的主机的优先权。 6、仲裁器将会允许重新要求使用权的主机,但如果有更高优先级的主机在用总线,可能会延迟。 7、从机会响应 OKAY 信号表示传送完成。 7.2 多重分段传输 只要一个主机有额外的 HBUSREQ 与 HGRANT 线, 即可发出超过一个以上的传送要求。 仲裁器将一组信号 (REQ and GNT) 视为一个主机。 可分段传输的从机可被设计去处理额外的传送要求而不需纪录额外的地址与控制信号,但要记录主机序号。 从机可利用 HSPLITx 来表示当前正在处理的是哪一个主机要完成分段传输。 仲裁器可重新仲裁这些主机的请求,高优先权的主机可被重新给予使用权。 7.3 预防死锁 Deadlock可能发生在很多不同的主机对同一个发出 SPLIT 和 RETRY 的从机身上, 而该从机又无法处理那么多 SPLIT and RETRY 时,便会发生 deadlock。 Deadlock 可以透过限制分段传送的数目(最多 16 个)来避免。 从机并不会记录下每个要求的地址与控制讯息,如果要作 SPLIT 的话,只会记录下当前传送对象的 ID 讯息。当 S 可完成分段传送时,才会锁定要求的地址与控制讯息。 从机会依序地让仲裁器知道从机要服务哪些要求。 从机可以任何顺序处理要求的服务。 重传: 当从机无法在很短的时间内完成传送的动作时, 它可以要求主机重传。 从机一次只可对一个主机发出 RETRY 信号,确定所服务的主机是同一个时, RETRY 的动作才能完成。如果 RETRY 是不同主机时可以采取下列措 施: (1)给一个 error 回应 (2)通知仲裁器 (3)产生中断 (4)重置系统 7.4 分块传输的总线移交 当主机收到 SPLIT 或 RETRY 响应信号时,必须先进入 IDLE 状态并且重新请求总线使用权,一个新的主机会在 IDLE 周期结束前由仲裁器决定出来。主机在收到 SPLIT 或 RETRY 信号后须立刻进入 IDLE 状态。 (1)在 T2 与 T3, 从机会传两个周期的 SPILT 信号。 (2)该主机在 T3 正沿时发现有 SPLIT 响应信号,于是进入 IDLE 状态。 (3)仲裁器在 T3 正沿时,决定下一个总线的使用者。 (4)在 T4,新的主机送出地址与控制信号 图片
IP&SOC设计
# SOC设计
刘航宇
3年前
0
829
1
AMBA--AHB总线协议介绍(一)
摘要本文介绍了AMBA AHB总线协议,包括其概述、总线互联、信号定义、操作概述、基本传输、传输类型和突发操作。AHB总线是SOC芯片中应用广泛的片上总线,具有高效的数据传输能力。关键词:AMBA, AHB总线, 高级高性能总线, 总线协议, 微控制器1、AHB总线概述 AHB:Advanced High-performance Bus,即高级高性能总线。AHB总线是SOC芯片中应用最为广泛的片上总线。下图是一个典型的基于AMBA AHB总线的微控制器系统: 图片 SOC架构 图片 基于AMBA AHB的设计中可以包含一个或多个总线主机,通常一个系统里至少包含一个处理器和一个测试接口;DMA和DSP作为总线主机同样是比较常见的。 典型的AHB总线设计包括一下几个部分: (1)AHB主机:主机可以通过提供地址和控制信息发起读写操作;同一时刻总线上只允许一个主机占用总线。 (2)AHB从机:从机需在给定的地址空间范围内响应总线上的读或写操作;从机通过信号将成功、失败、等待数据传输等信息返回至有效的主机。 (3)AHB仲裁器:总线仲裁器确保同一时刻只有一个主机被允许发起传输。所有的AHB总线都必须包含一个仲裁器,即使是在单主机总线系统中。 (4)AHB译码器:译码器的作用是对传输中的地址信号进行译码,并提供给从机一个选择信号。所有的AHB总线中都必须包含一个中央译码器。 2、总线互联 AMBA AHB总线协议被设计为一个使用中央多路选择器的互联方案,如下表: 图片 基于这种方案,所有的主机在需要发起传输时,都可以驱动地址和控制信号,由仲裁器决定哪一个主机的地址和控制信号(写传输时包含写数据信号)连通到总线上的所有从机。同时总线需要一个中央译码器,用于控制读数据和应答信号的多路数据选择器,该多路数据选择器用于选择传输中涉及的从机的相关信号。 3、AHB信号 AHB信号以字母H作为前缀,如下表所示 NameWidthSourceDescriptionHCLK1bit时钟源总线所有传输都基于此时钟,所有信号的时序都与时钟上升沿有关HRESETn1bit复位控制器总线复位信号,总线上唯一低电平有效的信号HADDR32bit主机32位地址总线HTRANS2bit主机表明当前传输的类型HSIZE2bit主机表明传输的大小,典型的是字节(8-bit)、 半字(16-bit)、字(32-bit), 协议允许最大传输大小是1024 bitHWRITE1bit主机传输写信号,高电平表示写传输,低电平表示读传输HBURST3bit主机有自己的HBURST信号有自己的HBURST信号HPROT4bit主机保护控制信号。主要应用于期望实现某些程度的保护级别的模块中HWDATA32bit主机写传输数据。要求最低位宽位32位HSELx1bit译码器从机选择信号,每个AHB从机都有自己的HSEL信号,该信号有效时,表明选中相应从机HRDATA32bit从机读数据总线,用于读操作期间从机向主机传输数据HREADY1bit从机该信号为高时,表明总线传输完成。也可以拉低该信号用以扩展传输HRESP2bit从机传输响应信号。提供四种响应OKAY、ERROR、RETRY、SPLITAMBA AHB也需要一些信号用于支持多主机总线操作,其中一些仲裁信号需要点对点连接: NameWidthSourceDescriptionHBUSREQx1bit主机主机x发送至仲裁器的总线请求信号,总线系统中最多有16个主机,每个主机都有一个HBUSREQ信号HLOCKx1bit主机该信号为高时,表示主机x发起锁定传输HGRANTx1bit仲裁器表明主机x在当前总线上拥有最高的优先级,当HREADY信号为高时,地址/控制信号的所有权将发生变化,故主机x需在HREADY与HGRANTx信号同时为高时,获得总线控制权HMASTER4bit仲裁器表明哪一个主机当前拥有地址/控制信号的所有权HMASTLOCK1bit仲裁器表明当前传输为锁定顺序传输,此信号与HMASTER具有相同时序HSPLITx16bit从机用于指示仲裁器,哪一个主机可以继续完成分块传输4、AMBA AHB操作概述 在一次AHB传输开始之前,主机必须被授予总线访问权。这个过程起始于主机向仲裁器发出一个总线请求,由仲裁器决定该主机何时被授予总线使用权。被授权的主机通过驱动地址和控制信号来发起一次AHB传输,这些信号提供了地址、传输方向、传输宽度等信息,以及会表明当前传输是否为突发传输的一部分。AHB支持两种形式的突发传输: (1)增量突发,在地址边界不进行回环; (2)回环突发,在特定地址边界回环 写数据总线用于将数据从主机发送到从机,读数据总线用于将数据从从机传输到主机。 每次数据传输包含: (1)一个地址和控制周期; (2)一个或多个数据周期 由于地址不支持扩展,所以所有的从机必须在地址周期内采样地址,而数据可以通过HREADY信号进行扩展延长,当HREADY信号为低,总线将插入等待状态,以此提供从机额外的采样数据或者提供数据的时间。 在传输中,从机使用应答信号HRESP[1:0]来表示传输状态: (1)OKAY:OKAY响应表示传输正常,且当HREADY信号为高时,表示传输成功; (2)ERROR:ERROR响应表示发生了传输错误,并且传输失败; (3)RETRY and SPLIT:RETRY和SPLIT都表示当前传输未能即刻完成,但是主机应继续尝试传输 一般而言,仲裁器授权另一个主机前,允许当前被授权主机完成突发传输。然而,为了避免过多的仲裁延迟(当前主机占用过多总线周期),总线可以打断一个突发传输,在这种情况下,主机必须重新申请总线,以完成后续的突发传输。 5、基本传输 一个AHB传输包含两个部分: (1)地址相位,仅包含一个时钟周期; (2)数据相位,可以使用HREADY信号,维持多个时钟周期 下图表示了一个无等待状态的简单传输: 图片 在无等待的简单传输中,主机在HCLK的上升沿驱动地址和控制信号到总线上,在下一个时钟上升沿时,从机对地址和控制信号进行采样,从机采样得到地址和控制信息后,可以驱动应答信号给与主机适当的响应,主机在第三个时钟的上升沿对应答信号进行采样。 这个简单的例子演示了在不同的时钟周期地址和数据相位是怎样产生的。实际上,当前传输的地址相位都对应于前一次传输的数据相位,这种地址和数据交叠现象,是总线能够进行流水线传输的基础,这样不仅能够获得更高的传输性能,也能为从机进行响应提供充足的时间。 从机可以在数据相位中,插入等待状态,以此获得更多得时间来完成传输: 图片 注意: (1)在写传输中,主机需要在整个扩展周期内保持写数据信号稳定 (2)在读传输中,从机没必要提供有效数据,知道传输结束时 当传输以这种方式做扩展时,将对下一个传输的地址相位产生一个扩展的副作用,如下图所示: 图片 该图表示了三个不相关的地址A、B、C上的传输,图中地址A和C的传输都没有等待状态,地址B的传输通过HREADY信号的拉低插入了一个等待的数据相位,这样导致了地址C传输的地址相位进行了扩展。 6、传输类型 AHB传输类型可以分为四种,通过HTRANS[1:0]的取值来划分: HTRANSTypeDescription00IDLE表明没有数据传输的要求。IDLE 用于主机被授予总线,但不希望进行数据传输的情况。对于IDLE传输,从机必须提供一个零等待的OKAY应答,并且忽略该传输01BUSYBUSY传输类型允许主机在突发传输中插入空闲周期。表明主机正在进行突发传输,但下次传输不能立即有效。当主机使用BUSY传输类型时,地址和控制信号必须对应突发中的下一次传输。从机必须提供一个零等待的OKAY应答,并且忽略该传输。10NONSEQ表示突发传输中的第一次传输或者非突发的单次传输,地址和控制信号与前次传输无关.11SEQ突发传输中剩余的传输时连续的,地址和前一次传输是相关的,当前地址值等于前一次传输的地址值加上传输大小(字节), 控制信息和前一次传输相同。在回环的突发传输中,传输的地址在地址边界处回环,回环值的大小等于传输大小(字节) 乘以传输次数(4、8或16) )下图是一个不同传输类型的例子: 图片 从图中可以看出: 第一个传输为以此突发传输的开始(T1),所以其传输类型为NONSEQ; 主机不能立刻执行突发传输中的第二次传输,所以使用了BUSY的传输类型(T2)来延迟下一次传输的开始,注意此时地址已经时下次传输的地址,控制信号和下次传输保持一致,主机只插入了一个BUSY,所以T3执行第二次传输; 主机执行第三次传输(T4),由于从机将HREADY信号拉低,插入了一个等待周期,引起地址相位的扩展; T6周期完成第三次传输,T7周期完成第四次传输(图中T8边沿)。 7、突发操作 AMBA AHB协议定义了4、8和16拍的突发,未定义长度的突发传输以及单次传输;协议支持增量和回环的突发方式。 增量突发方式访问连续地址空间,每次传输的地址是前一次传输地址增加一个增量偏移; 回环突发中,如果传输的其实地址并未和突发中的字节总数对齐,则突发传输地址将在达到边界处回环。例如:一个4拍回环突发的字(4字节)访问将在16字节的边界处回环,如果传输的起始地址为0x34,那么突发中将包含4个地址:0x34,0x38,0x3C,0x30。 AMBA AHB 有8种突发操作,使用信号HBRUST[2:0]表示: HTRANSTypeDescription000SINGLE单一传输001INCR未指定长度的增量突发010WRAP44拍回环突发011INCR44拍增量突发100WRAP88拍回环突发101INCR88拍增量突发110WRAP1616拍回环突发111INCR1616拍增量突发突发不能超过1K的地址边界,所以主机尽量不要发起将要跨过地址边界的定长的增量突发。 一次突发传输的数据总量,等于节拍数乘以每拍包含的字节数。所以突发传输必须将地址边界和数据大小对齐,例如,字传输必须对齐到字地址边界,即A[1:0]=00;半字传输必须对齐到半字地址边界,即A[0]=0。
IP&SOC设计
# SOC设计
刘航宇
3年前
0
1,938
2
2023-03-03
天线设计1-基本参数
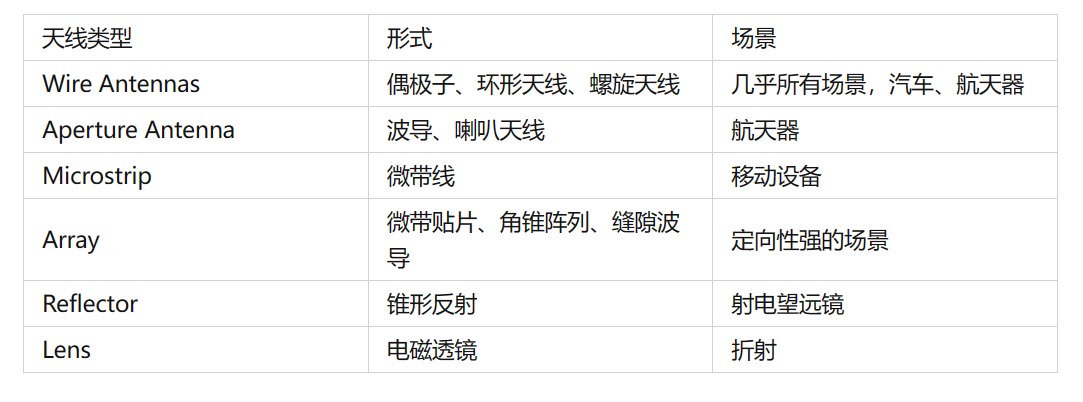
摘要本文介绍了天线设计的基本参数和辐射机理,包括单根导线、传输线和偶极子的辐射原理,以及天线分析方法。同时,讨论了天线的基本参数,如辐射图、主平面、场区、波束宽度、方向性、波束立体角、极化和输入阻抗等。关键词:天线设计, 辐射机理, 电磁波传播, 天线参数, 传输线第一章 导言 天线类型 图片 辐射机理 电磁波是如何产生,并最终与天线“分离”而在自由空间中传播的呢? 我们讨论以下几种辐射源的辐射原理。 单根导线 图片 图片 这一方程表示了电流和电荷之间的关系,也是电磁辐射的基本条件:要产生电磁辐射,需要有电流或电荷的加速(或减速)。 要产生电荷的加速或减速,需要导线弯曲、不连续、或者端接。就如同水流一样,当管道宽度变化,流速发生变化,在管道宽度变化的区域,就有水流的加速/减速。 为了定性的的了解辐射机理。考虑一个脉冲源连接到一个导线,导线与GND存在RC寄生参数,到导线通电时,导体中的电子被加速;在终端的电子被减速,即反射;从而在导线的两端和导线上产生辐射场。在这个过程中,电荷加速是外部源造成的,电场使电荷运动;电荷减速,则于是由于感应场有关的力造成的,例如导线两端的电荷积累。因此激励电场引起电荷加速,而导线阻抗不连续导致辐射的产生。 传输线 图片 考虑一个电压源连接到图1.11(a)所示的两根导线上。导线间的交变电压使得电荷加速或减速,交变电场感应出交变的磁场,反之亦然,因此,从天线端产生了电磁波,并传播到自由空间中。 结论:激发电场需要电荷,单维持电场不需要。(这就类似水波的产生) 偶极子 首先我们要接受电磁场传播的速度是有限的。两个偶极子在每T/2的时间内交换位置,每个T/2时间内,电场只能传播的距离。每次偶极子交换位置时,电场的极性发生了变化,因此传播的电场变成交变电场,产生交变磁场,从而形成了脱离源的电磁波。 图片 电流在细导线上的分布 讨论天线的辐射场时,需要知道电流的分布。 图片 图片 图片 图片 分析方法 在过去,分析复杂天线问题通常用积分方程方法、几何衍射理论来求解。此类方法用于线型天线较为方便。然而当辐射系统为多个波长时,低频的方法计算效率不高,最近广为关注和应用的GTD/UTD方法,它是几何光学的拓展,通过引入衍射机制,克服了几何光学的局限性。有限差分时域是另一种在散射方面受到广泛关注的方法,现已应用到天线辐射问题。有限元是一种在解决天线问题中获得巨大成功的方法。 遇到的挑战 目前仍有许多挑战和需要解决的问题,例如单片集成MIC技术和相控阵架构依然是最具挑战的问题。复杂问题的计算电磁学。创新的天线设计。多功能、多频带、超宽带、可重构天线等。 第二章 天线的基本参数和FOM 在描述天线性能前,需要定义一些参数,一些参数可能是相互关联的。书中的许多带引号的定义来源于 IEEE Standard Definitions of Terms for Antennas [IEEE Std 145-1993.Reaffirmed 2004(R2004)] Radiation Pattern 辐射图 在天线研究中,通常用球面坐标来表示电磁场会较为方便,因此首先介绍球面坐标系 图片 图片 图片 辐射波瓣(radiation lobe):以辐射强度较弱的区域为边界,将辐射图分割成几个区域。 最大的辐射波瓣称为主瓣(major lobe),其他则为次瓣(minor lobe)。副瓣(side lobe)通常表示功率水平最高的次瓣。后瓣(back lobe)方向与主瓣方向相反的次瓣。 图片 图片 图片 各向同性、定向、全向天线 图片 其中全向天线是定向天线的特殊类型。 主平面 对于线性极化的天线,通常用其主要平面图来描述其性能,包括: 电场平面(E-plane):包含最大电场矢量与最大辐射方向的平面。 磁场平面(H-plane):包含最大磁场矢量与最大辐射方向的平面。 大多数天线的通常的做法是让至少一个电磁平面与几何平面重合。例如图2.5中,可以定义XOZ平面为电场的主平面,而XOY为磁场的主平面。 图片 图片 Field Regions 场区 天线周围空间可分成三个区域: 图片 图2.8显示了,从近场到远场时,场的形状随距离的典型变化趋势。在近场中,场更加分散,几乎均匀,只有很小的变化,随着距离到辐射近场区,图案变得圆滑,逐渐形成波瓣。在远场区,形成了类似花瓣的图案。 图片 弧度和球面度 图片 图片 波束宽度 HPBW Half power beam width 半波束宽度 FNBW First Null Beam width 第一组零点之间的宽度 方向性 定义:在给定方向上的辐射强度与各项同性源的辐射强度之比。 图片 波束立体角 波束立体角定义:假如辐射强度是恒定的,且等于最大值,流过某一个立体角的功率等于天线辐射功率,那么该立体角称为波束立体角。 图片 图片 图片 传导效率和介电效率通常很难计算,可以通过实验测量,但也很难区分出二者,因此把两项合并成传导-介电效率 极化 辐射波的极化定义为:沿着传播方向观察电场的矢量箭头,随时间变化,绘制的轨迹图。 极化可以分成线性、圆形和椭圆。如果电场的矢量始终沿着一条直线变化,则该电场称为线性极化;但一般而言,电场矢量箭头的路径通常是椭圆形,这称为椭圆极化。圆形和线性实际上是椭圆的特赦情况。 假如有一个沿着负z轴方向传播的平面波。其电场可以写成: 图片 图片 输入阻抗 图片 重要公式 图片
通信&信息处理
# 天线设计
刘航宇
3年前
0
1,756
1
AMBA--APB总线协议及Verilog实现与仿真
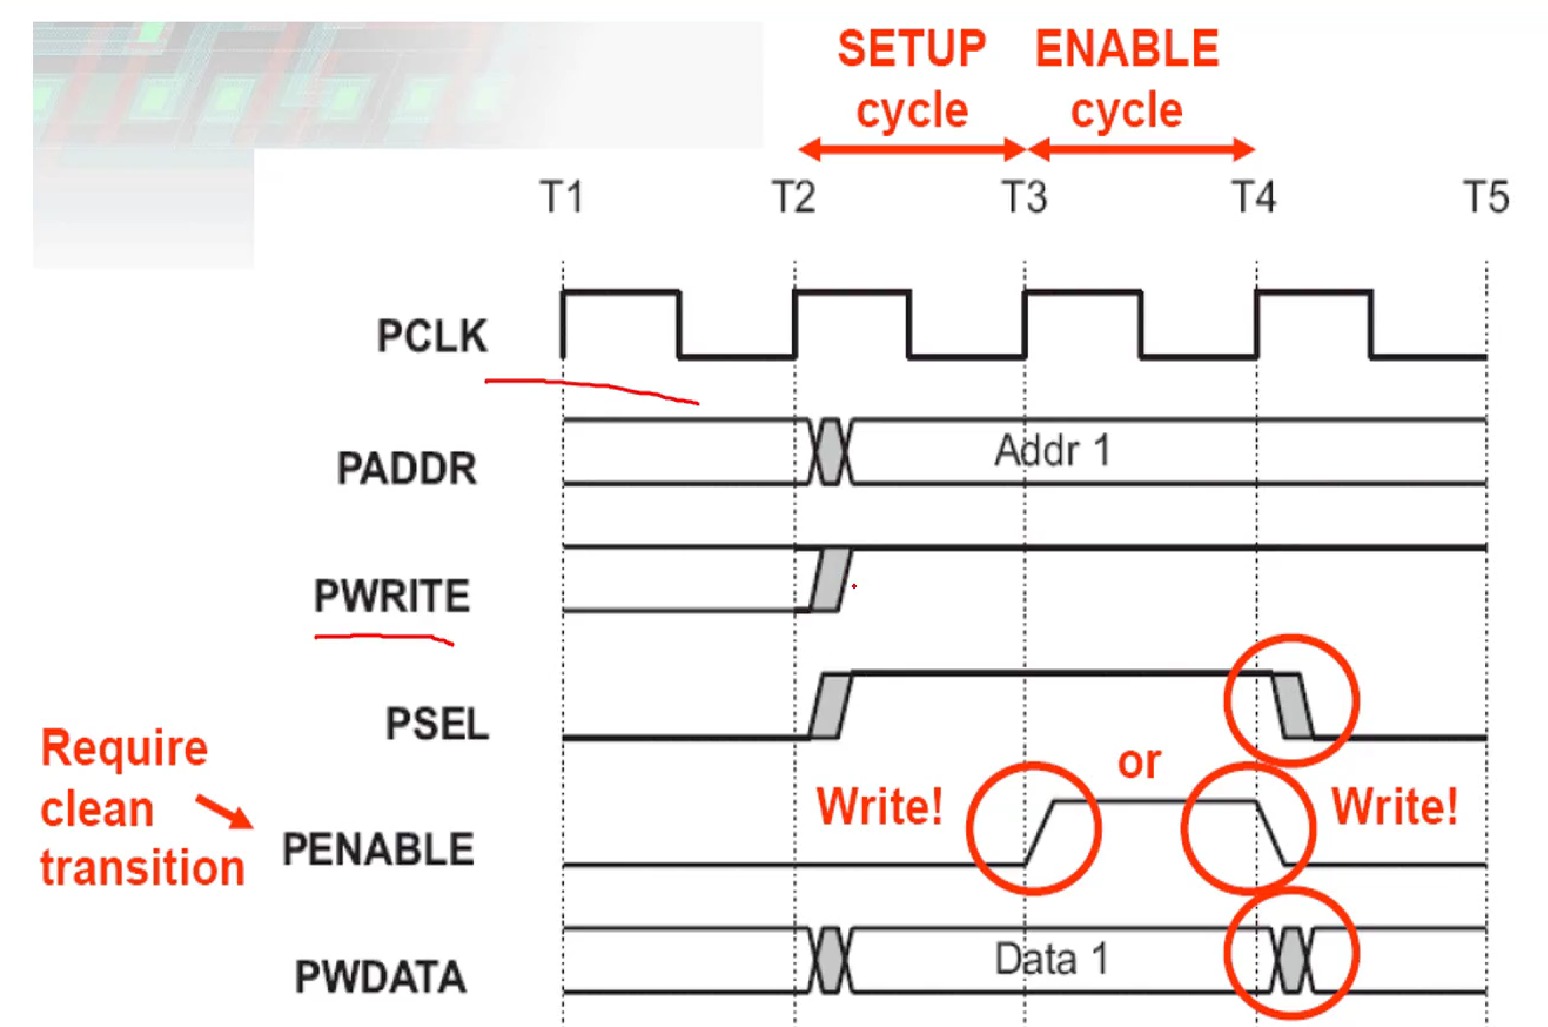
摘要本文介绍了APB总线协议及其Verilog实现与仿真。APB总线具有低功耗、接口协议简单等特性,支持多种外设。文章详细描述了APB信号列表、时序以及Verilog实现,并通过仿真验证了读写时序的正确性。关键词:APB总线, Verilog实现, 仿真波形, APB读时序, APB写时序1、APB总线简介 APB:Advanced Peripheral Bus,高级外设总线,具备以下特性: (1)低功耗; (2)接口协议简单; (3)总线传输使用时钟上升沿进行,便于时序分析; (4)应用广泛,支持多种外设。 所有的APB模块均是APB从机。 2、APB信号列表 所有的APB总线信号都以字母P作为前缀,下表列出了APB信号的名称以及对信号的描述: NameWidthI/ODescriptionPCLK1bitInAPB总线时钟,所有传输只能发生在PCLK的上升沿PRESETn1bitInAPB总线复位信号,低电平有效PADDR32bitInAPB地址总线PSEL1bitInAPB从机片选信号PENABLE1bitInAPB选通信号,高电平表示APB传输的第二个周期PWRITE1bitInAPB读写控制信号,高表示写,低表示读PRDATA32bitOutAPB读数据信号,最高为32位PWDATA32bitInAPB写数据信号,最高为32位3、APB总线时序 (1)写时序 图片 写传输开始于T2时刻,在改时钟上升沿时刻,地址、写信号、PSEL、写数据信号同时发生变化,T2时钟,即传输的第一个时钟被称为SETUP周期。在下个时钟上升沿T3,PENABLE信号拉高,表示ENABLE周期,在该周期内,数据、地址以及控制信号都必须保持有效。整个写传输在这个周期结束时完成。 (2)读时序 图片 读传输开始于T2时刻,在改时钟上升沿时刻,地址、写信号、PSEL信号同时发生变化,在下个时钟上升沿T3,PENABLE信号拉高,从机必须在ENABLE周期内提供读数据,读数据信号将在T4上升沿时刻被采样。 经历2个cycle就读数据,不需要握手 4、Verilog实现 下面编写一个简单的基于APB接口的memory读写控制程序供读数据,读数据信号将在T4上升沿时刻被采样。 `timescale 1ns / 1ps module apb_sram #( parameter SIZE_IN_BYTES = 1024 ) ( //---------------------------------- // IO Declarations //---------------------------------- input PRESETn, input PCLK, input PSEL, input [31:0] PADDR, input PENABLE, input PWRITE, input [31:0] PWDATA, output reg [31:0] PRDATA ); //---------------------------------- // Local Parameter Declarations //---------------------------------- localparam A_WIDTH = clogb2(SIZE_IN_BYTES); //---------------------------------- // Variable Declarations //---------------------------------- reg [31:0] mem[0:SIZE_IN_BYTES/4-1]; wire wren; wire rden; wire [A_WIDTH-1:2] addr; //---------------------------------- // Function Declarations //---------------------------------- function integer clogb2; input [31:0] value; reg [31:0] tmp; reg [31:0] rt; begin tmp = value - 1; for (rt = 0; tmp > 0; rt = rt + 1) tmp = tmp >> 1; clogb2 = rt; end endfunction //---------------------------------- // Start of Main Code //---------------------------------- // Create read and write enable signals using APB control signals assign wren = PWRITE && PENABLE && PSEL; // Enable Period assign rden = ~PWRITE && ~PENABLE && PSEL; // Setup Period assign addr = PADDR[A_WIDTH-1:2]; // Write mem always @(posedge PCLK) begin if (wren) mem[addr] <= PWDATA; end // Read mem always @(posedge PCLK) begin if (rden) PRDATA <= mem[addr]; else PRDATA <= 'h0; end endmodule测试代码: `timescale 1ns / 1ps `ifndef CLK_FREQ `define CLK_FREQ 50000000 `endif module top_tb(); //---------------------------------- // Local Parameter Declarations //---------------------------------- parameter SIZE_IN_BYTES = 1024; localparam CLK_FREQ = `CLK_FREQ; localparam CLK_PERIOD_HALF = 1000000000/(CLK_FREQ*2); //---------------------------------- // Variable Declarations //---------------------------------- reg PRESETn = 1'b0; reg PCLK = 1'b0; reg PSEL; reg [31:0] PADDR; reg PENABLE; reg PWRITE; reg [31:0] PWDATA; wire [31:0] PRDATA; reg [31:0] reposit[0:1023]; //---------------------------------- // Start of Main Code //---------------------------------- apb_sram #( .SIZE_IN_BYTES (SIZE_IN_BYTES) ) u_apb_sram ( .PRESETn (PRESETn), .PCLK (PCLK), .PSEL (PSEL), .PADDR (PADDR), .PENABLE (PENABLE), .PWRITE (PWRITE), .PWDATA (PWDATA), .PRDATA (PRDATA) ); // generate PCLK always #CLK_PERIOD_HALF begin PCLK <= ~PCLK; end // generate PRESETn initial begin PRESETn <= 1'b0; repeat(5) @(posedge PCLK); PRESETn <= 1'b1; end // test memory initial begin PSEL = 1'b0; PADDR = ~32'h0; PENABLE = 1'b0; PWRITE = 1'b0; PWDATA = 32'hffff_ffff; wait(PRESETn == 1'b0); wait(PRESETn == 1'b1); repeat(3) @(posedge PCLK); memory_test(0, SIZE_IN_BYTES/4-1); repeat(5) @(posedge PCLK); $finish(2); end // memory test task task memory_test; // starting address input [31:0] start; // ending address, inclusive input [31:0] finish; reg [31:0] dataW; reg [31:0] dataR; integer a; integer b; integer err; begin err = 0; // read-after-write test for (a = start; a <= finish; a = a + 1) begin dataW = $random; apb_write(4*a, dataW); apb_read (4*a, dataR); if (dataR !== dataW) begin err = err + 1; $display($time,,"%m Read after Write error at A:0x%08x D:0x%x, but 0x%x expected", a, dataR, dataW); end end if (err == 0) $display($time,,"%m Read after Write 0x%x-%x test OK", start, finish); err = 0; // read_all-after-write_all test for (a = start; a <= finish; a = a + 1) begin b = a - start; reposit[b] = $random; apb_write(4*a, reposit[b]); end for (a = start; a <= finish; a = a + 1) begin b = a - start; apb_read(4*a, dataR); if (dataR !== reposit[b]) begin err = err + 1; $display($time,,"%m Read all after Write all error at A:0x%08x D:0x%x, but 0x%x expected", a, dataR, reposit[b]); end end if (err == 0) $display($time,,"%m Read all after Write all 0x%x-%x test OK", start, finish); end endtask // APB write task task apb_write; input [31:0] addr; input [31:0] data; begin @(posedge PCLK); PADDR <= #1 addr; PWRITE <= #1 1'b1; PSEL <= #1 1'b1; PWDATA <= #1 data; @(posedge PCLK); PENABLE <= #1 1'b1; @(posedge PCLK); PSEL <= #1 1'b0; PENABLE <= #1 1'b0; end endtask // APB read task task apb_read; input [31:0] addr; output [31:0] data; begin @(posedge PCLK); PADDR <= #1 addr; PWRITE <= #1 1'b0; PSEL <= #1 1'b1; @(posedge PCLK); PENABLE <= #1 1'b1; @(posedge PCLK); PSEL <= #1 1'b0; PENABLE <= #1 1'b0; data = PRDATA; // it should be blocking end endtask `ifdef VCS initial begin $fsdbDumpfile("top_tb.fsdb"); $fsdbDumpvars; end initial begin `ifdef DUMP_VPD $vcdpluson(); `endif end `endif endmodule该测试用例,主要实现了APB读和写的task,用于产生APB读写时序,对memory的测试分成连个部分,一个是每进行一次写传输后,紧接着进行同地址的读传输,让后对比读写结果一致性;另一个测试是在连续写一段地址后,再全部读出改地址段的数据,完成读操作后进行数据比对。 下面是仿真打印信息 图片 APB写传输时序的仿真波形如下: 图片 APB写传输时序的仿真波形如下: 图片
IP&SOC设计
# SOC设计
刘航宇
3年前
0
2,956
2
2023-02-24
VLSI设计基础9-时序逻辑电路设计(一)
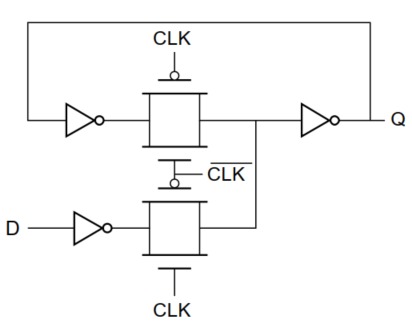
摘要本文介绍了时序逻辑电路设计的基础知识,包括时序电路概念、静态/动态存储器、时序参数和约束条件,以及锁存器和寄存器的类型和工作原理,最后讨论了流水线和多周期路径的设计要点。关键词:VLSI设计, 时序逻辑电路, 静态存储器, 动态存储器, 时序参数参考书:数字集成电路-电路、系统与设计,本文栏目对其重点进行精简化 目录 1. 时序电路的相关概念1. 时序电路 2. 静态/动态存储器 3. 时序参数(重点) 4. 时序约束条件(重点) 5. 锁存器和寄存器 静态锁存器/寄存器1. 静态锁存器1. 电路图与分析 2. 时序参数分析 2. 静态寄存器——边沿触发寄存器 3. 动态锁存器/寄存器 4. 流水线和多周期路径(重点) 1. 时序电路的相关概念 1. 时序电路 框架: 时序电路=组合电路+存储电路 结果:取决于当前的输入和过去的状态。 2. 静态/动态存储器 静态存储器: 上电就保持存储状态 通过正反馈,有意将输入和输出连接 如果长时间不用可以用门控时钟关闭(起到降低功耗的作用) 图片 动态存储器: 简单而言,即传输门+反相器,如下图。 利用寄生电容存储高低电平 只能存储较短的时间(ms级别)(电容小等原因使得存储时间短) 需要周期性刷新来补偿泄露电荷(参见(9)动态门) 结构简单,有较高性能(管子少,RC小)和较低功耗(不存在静态功耗) 图片 3. 时序参数(重点) 图片 为何这么说? 因为只有当满足了建立时间,此时时钟CLK才可以翻转,即此时的数据才是输入端输入的数据 所以输入端数据的50%即为时钟的50% 图片 图片 小贴士: 建立时间tsu和保持时间thold都是针对时钟的有效沿而言的。 即,输入数据50%的时间对时钟有效沿50%的时间;对于传播延时 ,输入信号50%(即时钟信号)时间对输出信号50%时间 4. 时序约束条件(重点) 图片 1.时钟周期T 图片 2.保持时间thold 图片 5. 锁存器和寄存器 图片 静态锁存器/寄存器 1. 静态锁存器 1. 电路图与分析 以正锁存器为例,电路图如下, 图片 电路结构:以传输门为主体的二选一选择器;CLK=1,Q=D;而CLK=0,通过正反馈,输出端和输入端连接。 2. 时序参数分析 1.5中提到,分析正锁存器时,需要注意的时钟边沿是时钟的下降沿。 这是因为,在CLK=1时,Q=D,属于透明传输,即输出随输入随时变化。其信号传播路径:D-①-②-③-Q 当CLK=1->0时,锁存器将要对输入数据进行所存。因此需要考虑建立时间tsu。 如果要让数据可以正确锁存下来,需要④⑤之间的节点的电平等于③⑤之间节点的电平,即 $$ D_{(4)(5)}=D_{(3)(5)} $$2. 静态寄存器——边沿触发寄存器 边沿触发寄存器,又称主-从寄存器,由主、从两个锁存器组成 电路图与分析 图片 图片 图片 主-从寄存器,由主锁存器——负锁存器、从锁存器——正锁存器组成。 图片 时序参数分析 图片 图片 图片 寄存器复位——同步/异步 同步复位(RST=0时复位) 图片 异步复位(clr=0时复位) 图片 3. 动态锁存器/寄存器 动态锁存器 电路图: 图片 使用电容电荷表示一个逻辑信号。 但是值的保存时间有限(ms)(漏电时间),需要周期性进行刷新。 动态寄存器 电路图 图片 工作原理: 图片 时间参数分析: 图片 存在的问题 图片 图片 优化——提高噪声容限 图片 3.C2MOS寄存器 图片 图片 4. 流水线和多周期路径(重点) 流水线 电路的工作速度取决于时序电路间的组合逻辑 可以通过将复杂、延迟大的组合逻辑(如计算lg(AB))通过寄存器进行分割,提高做工效率。 需要注意时序设计。每增加一个寄存器,结果就落后一拍! 图片 多周期路径 主要是写RTL代码时需要注意。 如果一个组合逻辑计算需要多个时间周期完成,可以通过一个cnt进行移位(移位运算量小)。当满足某个条件时,寄存器en=1,输出结果。 如:某运算需要经过四个周期完成,可以声明cnt=4'b0001,每个时钟进行左移,当cnt[3]==1'b1时,en=1,输出结果。
VLSI&IC验证
# VLSI
刘航宇
3年前
0
991
2
2023-02-10
FPGA与数字IC设计中接口命名规范
摘要本文介绍了FPGA与数字IC设计中接口命名规范,重点区分了EN与vld信号的区别,并详细列举了常用信号及其说明。关键词:FPGA, 数字IC设计, 接口命名规范, 端口信号规范, 门控时钟在硬件编程中,接口命名规范也是一个良好的习惯。接口在确定模块划分后需要明确模块的端口以及模块间的数据交互。完成项目模块划分后,可以在确定端口及数据流向时参考使用。本节重点是EN与vld的区别! ` 端口信号规范 ` 信号说明clk模块工作时钟rst_n系统复位信号,低电平有效en门控时钟,请搜索本站关于门控时钟讲解,这是低功耗的设计,EN=0睡眠状态、阻断时钟输入vld数据有效标志指示信号,表示当前的 data 数据有效。注意,vld 不仅表示了数据有效,而且还表示了其有效次数。时钟收到多少个 vld=1,就表示有多少个数据有data数据总线。输入一般名称为 din,输出一般名称为 dout。类似的信号还有 addr,len 等err整个报文错误指示,在 eop=1 且 vld=1 有效时才有效sop报文起始指示信号,用于表示有效报文数据的第一个数据,当 vld=1 时此信号有效eop报文结束指示信号,用于表示有效报文数据的最后一个数据,当 vld=1 时此信号有效rdy模块准备好信号,用于模块之间控制数据发送速度。例如模块 A 发数据给模块 B,则rdy 信号由模块 B 产生,连到模块 A(该信号对于 B 是输出信号,对于 A 是输入信号);B 要确保 rdy 产生正确,当此信号为 1 时,B 一定能接收数据;A 要确保仅在 rdy=1 时才发送图片
FPGA&ASIC
# ASIC/FPGA
刘航宇
3年前
0
559
2
2023-02-09
VCS、Verdi与Makefile使用简介
摘要本文介绍了VCS、Verdi与Makefile的使用方法。首先,通过在测试文件中加入特定代码生成.fsdb文件,然后创建filelist.f文件存放所有仿真文件。接着,通过Makefile实现一键编译、仿真和波形观察等功能,提高了开发效率。最后,还介绍了不使用Makefile直接执行的方法。关键词:VCS, Verdi, Makefile, 仿真, 编译前期工作 1、.fsdb文件 在使用Makefile文件前,先在测试文件中加入这样一句。 initial begin $fsdbDumpfile("tb.fsdb");//这个是产生名为tb.fsdb的文件 $fsdbDumpvars; end需要注意:对于用于仿真的testbench,需要额外建立一个 initial 块,调用产生有关 fsdb 格式的波形文件: 首先调用 fsdbDumpfile 函数,产生一个叫 .fsdb 的波形文件 然后调用 fsdbDumpvars 函数,声明需要保存那些信号的波形,括号内不加任何参数,则默认全部保存。 2、 filelist.f文件 filelist.f里存放所有需要仿真的.v文件。 创建filelist.f的方法: find -name "*.v" >filelist.f 1. Makefile作用? 编写makefile文件本质上是帮组make如何一键编译,进行批处理,makefile文件包含的规则命令使我们不需要繁琐的操作,提高了开发效率。 Makefile可以根据指定的依赖规则和文件是否有修改来执行命令。常用来编译软件源代码,只需要重新编译修改过的文件,使得编译速度大大加快。 2. Makefile应用 利用Makefile 实现简单的前端设计流程,包括VCS编译,Verdi仿真,DC综合,后续流程待补充。 目录结构 图片 #use "make" for help help: @echo "make help" @echo "make com to compile" @echo "make sim to run simulation" @echo "make clean to delete temporary files" #need to midify design name design_name = div_top fsdb_name = $(design_name).fsdb # use command "make com" to run vsc and product fsdb file com: cd RTL && vcs \ -full64 \ -f flist.f \ -debug_all \ -l com.log \ +v2k \ -P ${Verdi_HOME}/share/PLI/VCS/LINUXAMD64/novas.tab ${Verdi_HOME}/share/PLI/VCS/LINUXAMD64/pli.a # cd RTL && ./simv -l sim.log +fsdbfile+$(fsdb_name) #simulation:product fsdb file and sim log sim: ./RTL/simv cd RTL && ./simv -l sim.log +fsdbfile+$(fsdb_name) # use verdi to observe the waveform verdi: cd RTL && verdi \ +v2k \ -f flist.f \ -ssf $(fsdb_name) & #use fsdb file # run dc for synthesize syn: cd dc_script && dc_shell -64bit -topographical -f top_syn.tcl | tee -i syn.log #delete all files except .v and makefile clean: #rm -rf `ls | grep -v "Makefile"|grep -v "flist.f" | grep -v "\.v" | grep -v "dc_script"` make -C RTL clean make -C dc_script clean/RTL目录下MakeFile #delete temporary files clean: rm -rf `ls | grep -v "Makefile"|grep -v "flist.f" | grep -v "\.v"` dc_script目录下Makefile #delete temporary files clean: rm -rf `ls | grep -v "Makefile"|grep -v "script" | grep -v ".*.tcl"` make com :调用vcs编译 make sim:调用vcs仿真 make verdi 波形,shifrt+l可刷新重新编译结果 make clean 删除所有子目录下的临时生成文件 详细命令 执行“make vcs” 编译仿真 执行“make verdi” 打开波形 verdi常用快捷键 ctrl+w: 添加信号到波形图 h: 在波形窗口显示详细的信号名(路径) File>save signal,命名*.rc,下次直接打开rc文件就行 c/t: 修改信号的颜色(t可以直接切换颜色) 在波形窗口显示状态机的名字: 在rtl窗口,tools>Extract internative FSM ,可选first stage(仅展开目前所指定的FSM state),all stage (展开所有的FSM state) 改变颜色填充波形: Tools>waveform>view options>waveformpane> paint waveform with specified color/pattern 在rtl窗口按x: 标注出信号的值 z: 缩小波形窗口 Z: 放大波形窗口 f: 全屏 l: 上一个视图 L: 重新加载设计波形或文件 n: 向前查找 N: 向后查找 ctrl+→: 向右移动半屏 ctrl+←: 向左移动半屏 双击信号波形: 跳转到rtl中信号位置,并高亮新号 b: 跳到波形图开头 e: 跳到波形图尾部 2.不使用Makefile直接执行 vcs -R -f flist.f -full64 -fsdb -l name.log verdi -f flist.f -ssf name.fsdb 图片
编程&脚本笔记
EDA&虚拟机
# EDA&虚拟机
# Makefile
刘航宇
3年前
0
1,776
2
TCL脚本语言用法简介
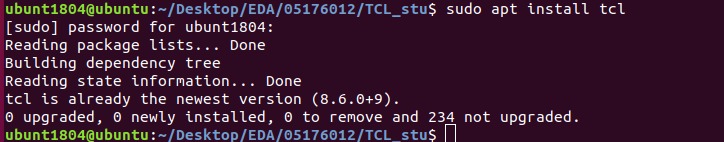
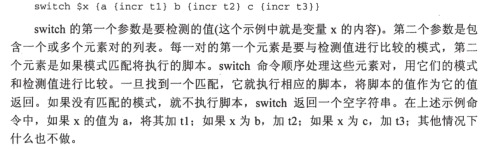
摘要TCL是一种解释执行的脚本语言,具有强大的可扩展性,支持变量、过程和控制结构。它易于嵌入C/C++应用程序,并可通过扩展命令集适应特定应用领域。TCL在自动测试领域广泛应用,因其高抽象层次和快速开发测试脚本的能力。关键词:TCL, 脚本语言, 解释执行, 编程能力, 可扩展性前言(TCL综述) TCL(Tool Command Language)是一种解释执行的脚本语言(Scripting Language)。 它提供了 通用的编程能力:支持变量、过程和控制结构;同时 TCL还拥有一个功能强大的固有的核心命令集。 由于TCL的解释器是用一个C\C++语言的过程库实现的,因此在某种意义上我们又可以把TCL看作一个C库,这个库中有丰富的用于扩展TCL命令的C\C++过程和函数,可以很容易就在C\C++应用程序中嵌入TCL,而且每个应用程序都可以根据自己的需要对TCL语言进行扩展。我们可以针对某一特定应用领域对TCL语言的核心命令集进行扩展,加入适合于自己的应用领域的扩展命令,如果需要,甚至可以加入新的控制结构,TCL解释器将把扩展命令和扩展控制结构与固有命令和固有控制结构同等看待。扩展后的TCL语言将可以继承TCL 核心部分的所有功能,包括核心命令、控制结构、数据类型、对过程的支持等。根据需要,我们甚至可以屏蔽掉TCL的某些固有命令和固有控制结构。通过对TCL的扩展、继承或屏蔽,用户用不着象平时定义一种计算机语言那样对词法、语法、语义、语用等各方面加以定义,就可以方便的为自己的应用领域提供一种功能完备的脚本语言。 TCL良好的可扩展性使得它能很好地适应产品测试的需要,测试任务常常会由于设计和需求的改变而迅速改变,往往让测试人员疲于应付。利用TCL的可扩展性,测试人员就可以迅速继承多种新技术,并针对产品新特点迅速推出扩展TCL命令集,以用于产品的测试中,可以较容易跟上设计需求的变化。 另外,因为TCL是一种比C\C++ 语言有着更高抽象层次的语言,使用TCL可以在一种更高的层次上编写程序,它屏蔽掉了编写C\C++程序时必须涉及到的一些较为烦琐的细节,可以大大地提高开发测试例的速度。而且, 使用TCL语言写的测试例脚本,即使作了修改,也用不着重新编译就可以调用TCL解释器直接执行。可以省却不少时间。TCL 目前已成为自动测试中事实上的标准。 目录 前言(TCL综述) 语法脚本,命令和单词符号 置换(substitution) 变量置换variable subtitution 命令置换command substitution反斜杠置换backslash substitution 双引号和花括号 变量简单变量 数组 append和incr expr List concat lindex llength linsert lreplace lrange lappend lsearch 控制流 if 循环命令:while 、for 、 foreach while for break和continue命令 switch source 过程(procedure) 附录(Tcl的安装) 直接打开终端(terminal),输入 sudo apt install tcl即可进行安装,这里的截图是笔者安装成功后的实例。 图片 之后输入tclsh即可 语法 脚本,命令和单词符号 一个TCL脚本可以包含一个或多个命令。命令之间必须用换行符或分号隔开,下面的两个脚本都是合法的: set a 1 set b 2 或使用分号隔开 set a 1;set b 2TCL解释器对一个命令的求值过程分为两部分:分析和执行。在分析阶段,TCL 解释器运用规则把命令分成一个个独立的单词,同时进行必要的置换(substitution); 在执行阶段,TCL 解释器会把第一个单词当作命令名,并查看这个命令是否有定义,如果有定义就激活这个命令对应的C/C++过程,并把所有的单词作为参数传递给该命令过程,让命令过程进行处理。 置换(substitution) TCL解释器在分析命令时,把所有的命令参数都当作字符串看待,例如: %set x 10 //定义变量x,并把x的值赋为10 10 %set y x+100 //y的值是x+100,而不是我们期望的110 x+100上例的第二个命令中,x被看作字符串x+100的一部分,如果我们想使用x的值’10’ ,就必须告诉 TCL解释器:我们在这里期望的是变量x的值,而非字符’x’。怎么告诉TCL解释器呢,这就要用到TCL语言中提供的置换功能。置换功能分为三种.TCL提供三种形式的置换:变量置换、命令置换和反斜杠置换。每种置换都会导致一个或多个单词本身被其他的值所代替。置换可以发生在包括命令名在内的每一个单词中,而且置换可以嵌套。 变量置换variable subtitution 变量置换由一个$符号标记,变量置换会导致变量的值插入一个单词中。例如之前的一个例子 %set x 10 //定义变量x,并把x的值赋为10 10 %set y x+100 //y的值是x+100,而不是我们期望的110 x+100 %set y $x+100 //y的值是我们期望的110 110命令置换command substitution 命令置换是由[]括起来的TCL命令及其参数,命令置换会导致某一个命令的所有或部分单词被另一个命令的结果所代替。例如: %set y [expr $x+100] 110这里当TCL解释器遇到字符’[‘时,它就会把随后的expr作为一个命令名,从而激活与expr对应的C/C++过程,并把expr和变量置换后得到的10+100传递给该命令过程进行处理。 反斜杠置换backslash substitution TCL语言中的反斜杠置换类似于C语言中反斜杠的用法,主要用于在单词符号中插入诸如换行符、空格、[、$等被TCL解释器当作特殊符号对待的字符。 %set msg money\ \$3333\ \nArray\ a\[2] //这个命令的执行结果为: money $3333 Array a[2]双引号和花括号 除了使用反斜杠外,TCL提供另外两种方法来使得解释器把分隔符和置换符等特殊字符当作普通字符,而不作特殊处理,这就要使用双引号和花括号({})。 TCL解释器对双引号中的各种分隔符将不作处理,但是对换行符 及$和[]两种置换符会照常处理。而在花括号中,所有特殊字符都将成为普通字符,失去其特殊意义,TCL解释器不会对其作特殊处理。 %set y "$x ddd" 100 ddd %set y {/n$x [expr 10+100]} /n$x [expr 10+100]注释 TCL中的注释符是#,#和直到所在行结尾的所有字符都被TCL看作注释,TCL解释器对注释将不作任何处理。不过,要注意的是,#必须出现在TCL解释器期望命令的第一个字符出现的地方,才被当作注释。 %set a 100 # Not a comment wrong # args: should be "set varName ?newValue?" %set b 101 ; # this is a comment 101变量 变量分为简单变量和数组 简单变量 一个 TCL 的简单变量包含两个部分:名字和值。名字和值都可以是任意字符串。 % set a 2 2 set a.1 4 4 % set b $a.1 2.1在最后一个命令行,我们希望把变量a.1的值付给b,但是TCL解释器在分析时只把$符号之后直到第一个不是字母、数字或下划线的字符(这里是’.’)之间的单词符号(这里是’a’)当作要被置换的变量的名字,所以TCL解释器把a置换成2,然后把字符串“2.1”付给变量b。这显然与我们的初衷不同。 当然,如果变量名中有不是字母、数字或下划线的字符,又要用置换,可以用花括号把变量名括起来。例如: %set b ${a.1} 4数组 数组是一些元素的集合。TCL的数组和普通计算机语言中的数组有很大的区别。在TCL中,不能单独声明一个数组,数组只能和数组元素一起声明。数组中,数组元素的名字包含两部分:数组名和数组中元素的名字,TCL中数组元素的名字(下标〕可以为任何字符串。 例如: set day(monday) 1 set day(tuesday) 2 set a monday set day(monday) 1 set b $day(monday) //b 的值为 1 ,即 day(monday) 的值。 set c $day($a) //c 的值为 1 ,即 day(monday) 的值。其他命令 unset % unset a b day(monday)上面的语句中删除了变量a、b和数组元素day(monday),但是数组day并没有删除,其他元素还存在,要删除整个数组,只需给出数组的名字。 append和incr 这两个命令提供了改变变量的值的简单手段。 append命令把文本加到一个变量的后面,例如: % set txt hello hello % append txt "! How are you" hello! How are youincr命令把一个变量值加上一个整数。incr要求变量原来的值和新加的值都必须是整数。 expr 可以进行基本的数学函数计算 %expr 1 + 2*3 7List list这个概念在TCL中是用来表示集合的。TCL中list是由一堆元素组成的有序集合,list可以嵌套定 义,list每个元素可以是任意字符串,也可以是list。下面都是TCL中的合法的list: {} //空list {a b c d} {a {b c} d} //list可以嵌套list是TCL中比较重要的一种数据结构,对于编写复杂的脚本有很大的帮助 list 语法: list ? value value…? 这个命令生成一个list,list的元素就是所有的value。例: % list 1 2 {3 4} 1 2 {3 4}使用置换将其相结合 % set a {1 2 3 4 {1 2}} 1 2 3 4 {1 2} % puts $a 1 2 3 4 {1 2}concat 语法:concat list ?list…? 这个命令把多个list合成一个list,每个list变成新list的一个元素。 % set a {1 2 3} 1 2 3 % set b {4 5 6} 4 5 6 % concat $a $b 1 2 3 4 5 6lindex 语法:lindex list index 返回list的第index个(0-based)元素。例: % lindex {1 2 {3 4}} 2 3 4llength 语法:llength list 返回list的元素个数。例 % llength {1 2 {3 4}} 3 % set a {1 2 3} 1 2 3 % llength $a 3linsert 语法:linsert list index value ?value…? 返回一个新串,新串是把所有的value参数值插入list的第index个(0-based)元素之前得到。例: % linsert {1 2 {3 4}} 1 7 8 {9 10} 1 7 8 {9 10} 2 {3 4} % linsert {1 2 {3 4}} 1 {1 2 3 {4 5}} 1 {1 2 3 {4 5}} 2 {3 4} % set a {1 2 3} 1 2 3 % linsert $a 1 {2 3 4} 1 {2 3 4} 2 3lreplace 语法:lreplace list first last ?value value …? 返回一个新串,新串是把list的第firs (0-based)t到第last 个(0-based)元素用所有的value参数替换得到的。如果没有value参数,就表示删除第first到第last个元素。例: % lreplace {1 7 8 {9 10} 2 {3 4}} 3 3 1 7 8 2 {3 4} % lreplace {1 7 8 2 {3 4}} 4 4 4 5 6 1 7 8 2 4 5 6 % set a {1 2 3} 1 2 3 % lreplace $a 1 2 4 5 6 7 1 4 5 6 7 % lreplace $a 1 end 1lrange 语法:lrange list first last 返回list的第first (0-based)到第last (0-based)元素组成的串,如果last的值是end。就是从第first个直到串的最后。 例: % lrange {1 7 8 2 4 5 6} 3 end 2 4 5 6 % set a {1 2 3} 1 2 3 % lrange $a 0 end 1 2 3lappend 语法:lappend varname value ?value…? 把每个value的值作为一个元素附加到变量varname后面,并返回变量的新值,如果varname不存在,就生成这个变量。例: % set a {1 2 3} 1 2 3 % lappend a 4 5 6 1 2 3 4 5 6lsearch 语法:lsearch ?-exact? ?-glob? ?-regexp? list pattern 返回list中第一个匹配模式pattern的元素的索引,如果找不到匹配就返回-1。-exact、-glob、 -regexp是三种模式匹配的技术。-exact表示精确匹配;-glob的匹配方式和string match命令的匹配方式相同;-regexp表示正规表达式匹配。缺省时使用-glob匹配。例: % set a { how are you } how are you % lsearch $a y* 2 % lsearch $a y? -1-all 返回一个列表,返回的列表中的数值就是字符在列表中的位置 默认全局匹配,返回第一个字符在列表中的位置,其位缺省状态 % lsearch {a b c d e} c 2 % lsearch -all {a b c a b c} c 2 5 % lsearch {a b c d c} c 2匹配不到返回-1 % lsearch {a b c d e} g -1控制流 主要是对于所有的控制流,包括 if、while、for、foreach、switch、break、continue 等以及过程, if 语法: if test1 body1 ?elseif test2 body2 elseif…. ? ?else bodyn? TCL先把test1当作一个表达式求值,如果值非0,则把body1当作一个脚本执行并返回所得值,否则把test2当作一个表达式求值,如果值非0,则把body2当作一个脚本执行并返回所得值……。例如: if { $x>0 } { ..... }elseif{ $x==1 } { ..... }elseif { $x==2 } { .... }else{ ..... }if { $x<0 } { puts "x is smaller than zero" } elseif {$x==1} { puts "x is equal 1" } elseif {$x==2} { puts "x is equal 2" } else { puts "x is other" } 这里需要注意的是, if 和{之间应该有一个空格,否则TCL解释器会把’if{‘作为一个整体当作一个命令名,从而导致错误。 ‘{‘一定要写在上一行,因为如果不这样,TCL 解释器会认为if命令在换行符处已结 束,下一行会被当成新的命令,从而导致错误的结果需要将}{ 分开写, 否则会报错extra characters after close-brace 循环命令:while 、for 、 foreach while 语法为: while test body 参数test是一个表达式,body是一个脚本,如果表达式的值非0,就运行脚本,直到表达式为0才停止循环,此时while命令中断并返回一个空字符串。 例如:假设变量 a 是一个链表,下面的脚本把a 的值复制到b: % #首先生成一个集合 % set a {1 2 3 4} 1 2 3 4 % set b " " % #计算生成集合的长度(从0开始这里需要减去1例如:0-3一共有四个数) % set i [expr [llength $a] -1] 3 #接下来进行判断,将集合a中的元素全部按顺序写入b中 % while {$i>=0} { #思考执行该行代码替换会有怎样的结果打印出来 #lappend b [lindex $a $i] lappend b [lindex $a [expr [llength $a] - 1 - $i]] incr i -1 } #打印观察结果 % puts $b 1 2 3 4对代码进行分析 set 变量a为一个list,b为一个空list 然后计算列表里有几个元素,将其减一后的值赋值给i,这里减一的目的是从零开始计数会多一个 开始进行循环,首先i的值是4大于0,表达式为真,开始执行脚本。 脚本为将数组a的第i个位置的元素添加到b list 里,然后给i减一同时进行下一次判断即可。 最后输出b的值 for 语法为: for init test reinit body 参数init是一个初始化脚本,第二个参数test是一个表达式,用来决定循环什么时候中断,第三个参数reinit是一个重新初始化的脚本,第四个参数body也是脚本,代表循环体。下例与上例作用相同:(注意这里复制打印顺序的不同) % set a {1 2 3 4} 1 2 3 4 % set b " " % for {set i [expr [llength $a] -1]} {$i>=0} {incr i -1} { lappend b [lindex $a $i] } % puts $b 4 3 2 1例 % for {set i 0} {$i<4} {incr i} { puts "I is: $i " } I is: 0 I is: 1 I is: 2 I is: 3 foreach 这个命令有两种语法形式 1, foreach varName list body 第一个参数varName是一个变量,第二个参数list 是一个表(有序集合),第三个参数body是循环体。每次取得链表的一个元素,都会执行循环体一次。 下例与上例作用相同: % set a {1 2 3 4} 1 2 3 4 % set b " " % foreach i $a { set b [linsert $b 0 $i] } % puts $b 4 3 2 1% foreach var {a b c d e f} { puts $var } a b c d e f2, foreach varlist1 list1 ?varlist2 list2 ...? Body 这种形式包含了第一种形式。第一个参数varlist1是一个循环变量列表,第二个参数是一个列表list1,varlist1中的变量会分别取list1中的值。body参数是循环体。 ?varlist2 list2 …?表示可以有多个变量列表和列表对出现。例如: set x {} foreach {i j} {a b c d e f} { lappend x $j $i }这时总共有三次循环,x的值为”b a d c f e”。 % foreach i {a b c} j {d e f g} { puts $i puts $j } a d b e c f gset x {} foreach i {a b c} j {d e f g} { lappend x $i $j }这时总共有四次循环, x的值为”a d b e c f {} g set x {} foreach i {a b c} {j k} {d e f g} { lappend x $i $j $k }这时总共有三次循环,x的值为”a d e b f g c {} {}”。 例子: 图片 break和continue命令 在循环体中,可以用break和continue命令中断循环。其中break命令结束整个循环过程,并从循环中跳出,continue只是结束本次循环 这里有一个特别好的例子 说明:这里首先进行给一个list,然后使用foreach循环进行写入数据当遇见break时候直接退出了循环,而continue仅仅只是跳出此次循环继续向b里写入数 % set b {} % set a {1 2 3 4 5} 1 2 3 4 5 % foreach i $a { if {$i == 4} break set b [linsert $b 0 $i] } % puts $b 3 2 1% set b {} % set a {1 2 3 4 5} 1 2 3 4 5 % foreach i $a { if {$i == 4} continue set b [linsert $b 0 $i] } % puts $b 5 3 2 1switch 和 C 语言中 switch 语句一样,TCL 中的 switch 命令也可以由 if 命令实现。只是书写起来较为烦琐。 switch 命令的语法为: switch ? options? string { pattern body ? pattern body …?} 注意这里进行的是字符匹配 图片 set x a; set t1 0;set t2 0;set t3 0; switch $x { a - b {incr t1} c {incr t2} default {incr t3} } puts "t1=$t1,t2=$t2,t3=$t3"x=a时执行的是t1加2 其中 a 的后面跟一个’-’表示使用和下一个模式相同的脚本。default 表示匹配任意值。一旦switch 命令 找到一个模式匹配,就执行相应的脚本,并返回脚本的值,作为 switch 命令的返回值。 source source 命令读一个文件并把这个文件的内容作为一个脚本进行求值 以上边的switch第一段代码为例 使用VIM新建一个文件,写入文件后保存退出 vim switch1.tcl键入wish然后输入source switch1.tcl 图片 过程(procedure) TCL 支持过程的定义和调用,在 TCL 中,过程可以看作是用 TCL 脚本实现的命令,效果与 TCL的固有命令相似。我们可以在任何时候使用 proc 命令定义自己的过程,TCL 中的过程类似于 C中的函数。 TCL 中过程是由 proc 命令产生的: 例如: % proc add {x y } {expr $x+$y} roc 命令的第一个参数是你要定义的过程的名字,第二个参数是过程的参数列表,参数之间用空格隔开,第三个参数是一个 TCL 脚本,代表过程体。 proc 生成一个新的命令,可以象固有命令一样调用: % add 1 2 3
编程&脚本笔记
# TCL脚本
刘航宇
3年前
0
1,838
0
2023-01-25
Synopsys ICC简单教程
摘要本文介绍了Synopsys ICC(IC Compiler)的基本概念、输入输出文件、综合流程和注释详解。ICC将门级网表转换为版图信息,包括数据准备、布局、时钟树综合和布线等步骤。关键词:Synopsys ICC, IC Compiler, 门级网表, 布局布线, 时钟树综合目录 一、ICC综合概述ICC输入文件 ICC输出文件 二、ICC综合流程1、逻辑库、技术库、版图库等基本参数设定 2、创建自己的Milkyway文件夹 3、布局规划floorplan 4、布局placement 5、时钟树综合CTS 6、布线routing 三、ICC注释详解 一、ICC综合概述 ICC(IC Compiler)是把门级网表转换成foundry厂可用于掩膜的版图信息的过程,它包括数据准备、布局、时钟树综合、布线等步骤。 图片 ICC输入文件 ICC输入需要两部分信息:综合数据+物理数据。 综合数据: 门级网表文件,如orca.v 约束文件,如orca.sdc 逻辑库文件,包含时序信息,如标准单元sc.db,宏单元macros.db,输入输出单元io.db等 物理数据: 技术文件,包含金属层等信息,如abc_6m.tf 线负载模型,TLU+ 物理库文件,包含版图信息,如标准单元sc.mw,宏单元macros.mw,输入输出单元io.mw等 ICC输出文件 ICC输出的是GDSII格式的版图,用于流片。 二、ICC综合流程 参考Synopsys ICC lab1的RISC_CHIP的例子,展示各个流程发生的变化。 1、逻辑库、技术库、版图库等基本参数设定 这是前期的准备工作,设定搜索路径、逻辑时序库.db、负载模型库.tluplus等。 2、创建自己的Milkyway文件夹 Milkyway是Synopsys用于保存版图所有信息的格式,创建自己的Milkyway文件夹用来保存ICC过程中的文件。 读入门级网表,所有的模块都集中在角落,需要加入后续的布局布线信息。 图片 3、布局规划floorplan 布局主要包含芯片大小的规划、IO单元的规划、宏单元的规划、电源网络的设计等。 读入.def文件,包含了整体的布局信息,这个文件需要另外经过许多操作产生: 图片 floorplan一旦确定,整个芯片的面积就定下来了,并且和整个设计的timing、布通率密切相关。 4、布局placement placement是将一个个标准单元模块放入中间区域,通过place_opt自动排布 图片 5、时钟树综合CTS 时钟树综合的主要目的是减小内部各个时钟的偏斜。时钟源必须通过一级一级的buffer才能驱动众多内部时钟,buffer采用上下延时对称的反相器。 下图是时钟树综合后的布局,内部的标准单元会重新排布: 图片 下图高亮了时钟树的内部走线 图片 6、布线routing 布线会经过全局布线(Global routing 和详细布线 (Detail Routing)两个步骤,通过route_opt完成: 图片 三、ICC注释详解 ############################################################ # 1、逻辑库、技术库等基本参数设定 ############################################################ lappend search_path ../ref/db ../ref/tlup set_app_var target_library "sc_max.db" set_app_var link_library "* sc_max.db io_max.db ram16x128_max.db" set_min_library sc_max.db -min_version sc_min.db set_min_library io_max.db -min_version io_min.db set_min_library ram16x128_max.db -min_version ram16x128_min.db # - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - # RISC_CHIP setup variables # - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - set my_mw_lib risc_chip.mw set mw_path "../ref/mw_lib" set tech_file " ../ref/tech/cb13_6m.tf" set tlup_map "../ref/tlup/cb13_6m.map" set tlup_max "../ref/tlup/cb13_6m_max.tluplus" set tlup_min "../ref/tlup/cb13_6m_min.tluplus" set top_design "RISC_CHIP" set verilog_file "./design_data/RISC_CHIP.v" set sdc_file "./design_data/RISC_CHIP.sdc" set def_file "./design_data/RISC_CHIP.def" set ctrl_file "./scripts/opt_ctrl.tcl" set derive_pg_file "./scripts/derive_pg.tcl" set MODULE_NAME RISC_CHIP ############################################################ # 2、创建自己的Milkyway文件夹 ############################################################ file delete -force $my_mw_lib create_mw_lib $my_mw_lib -open -technology $tech_file \ -mw_reference_library "$mw_path/sc $mw_path/io $mw_path/ram16x128" #加载门级网表文件 import_designs $verilog_file \ -format verilog \ -top $top_design #加载线负载模型 set_tlu_plus_files \ -max_tluplus $tlup_max \ -min_tluplus $tlup_min \ -tech2itf_map $tlup_map #加载VDD、VSS信息 source $derive_pg_file #加载约束文件 read_sdc $sdc_file source $ctrl_file source scripts/zic_timing.tcl exec cat zic.timing remove_ideal_network [get_ports scan_en] save_mw_cel -as RISC_CHIP_data_setup ############################################################ # 3、布局规划floorplan ############################################################ # 读入布局信息并布局 read_def $def_file set_pnet_options -complete {METAL3 METAL4} save_mw_cel -as RISC_CHIP_floorplanned ############################################################ # 4、布局placement,放置基本单元 ############################################################ place_opt redirect -tee place_opt.timing {report_timing} report_congestion -grc_based -by_layer -routing_stage global save_mw_cel -as RISC_CHIP_placed ############################################################ # 5、时钟树综合clock tree synthesis ############################################################ remove_clock_uncertainty [all_clocks] set_fix_hold [all_clocks] #时钟树综合 clock_opt redirect -tee clock_opt.timing {report_timing} # 保存文件 save_mw_cel -as RISC_CHIP_cts ############################################################ # 6、布线routing ############################################################ route_opt #报告物理信息 report_design -physical save_mw_cel -as RISC_CHIP_routed ############################################################ # 7、输出文件 ############################################################ file mkdir icc_files write -format ddc -hierarchy -output icc_files/$MODULE_NAME.apr.ddc write_verilog -no_tap_cells icc_files/$MODULE_NAME.lvs.v -pg -no_core_filler_cells write_verilog -no_tap_cells icc_files/$MODULE_NAME.sim.v -no_core_filler_cellssynopsys的实验礼包 synopsys实验 下载地址:https://pan.baidu.com/s/1OQHs8jfcFEs5bSs2fm6o8A?pwd=udwm 提取码:udwm
EDA&虚拟机
# EDA&虚拟机
刘航宇
3年前
0
2,170
0
2023-01-14
Design Compile(DC)使用简版
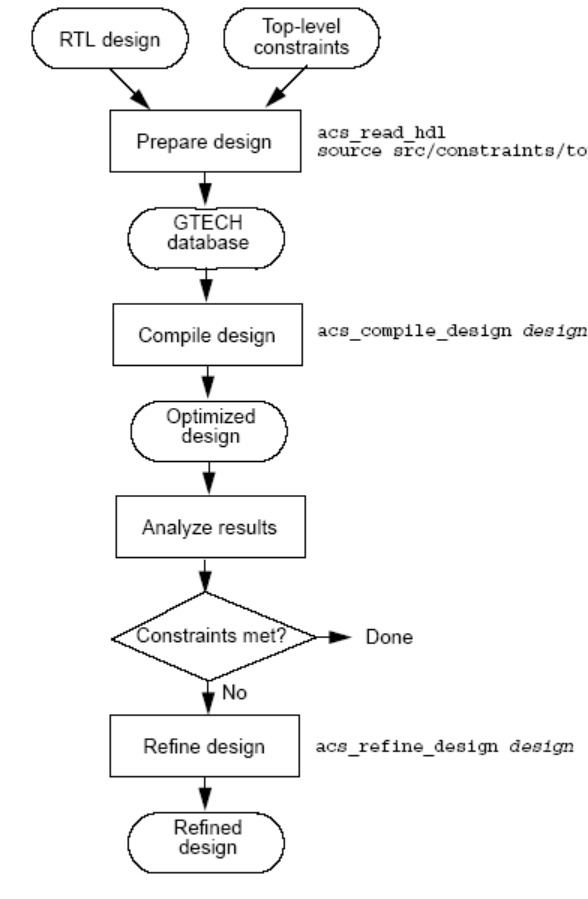
摘要Design Compile(DC)是Synopsys的综合软件,将RTL代码转化为门级网表,包括转译、优化和映射三个过程。DC流程包括创建文件夹、复制文件、编写脚本、运行脚本等步骤,并生成相关报告和网表。关键词:Design Compile, Synopsys, RTL代码, 门级网表, 综合软件Design Compile是synopsys的综合软件,它的功能是把RTL级的代码转化为门级网表。综合包括转译(Translation),优化(Opitimization),映射(Mapping)三个过程。在转译的过程中,软件自动将源代码翻译成每条语句所对应的功能模块以及模块之间的拓扑结构,这一过程是在综合器内部生成电路的布尔函数的表达,不做任何的逻辑重组和优化。优化:基于所施加的一定时序和面积的约束条件,综合器按照一定的算法对转译结果作逻辑优化和重组。在映射过程中,根据所施加的一定的时序和面积的约束条件,综合器从目标工艺库中搜索符合条件的单元来构成实际电路。 图片 DC 又称为设计综合 将设计的RTL代码综合成门级网表的过程。 在 DC 流程中 一般要经过以下几个步骤,以项目A为例 做如下分析: 1】 在项目子目录下创建DC文件夹,在DC文件夹下分别创建db in lib_syn log netlist rpt和 script 文件夹 以及一个makefile 文件用来运行DC 脚本 。 2】 第二步就是复制相应工艺技术库文件到lib_syn ,一般有2种文件各3个分别包括了typical worst 和 best情况,一类是db,文件一类是lib 文件 也可以在lc_shell 下读取lib 得到相应的db文件。 3】 第三步将需要综合的设计RTL代码(Verilog 文件)复制到in 文件夹 4】 第四步在script 创建综合脚本,脚本创建过程将在后面介绍 5】 第五步编写运行脚本的makefile 文件 6】 第六步运行脚本而后查看综合报告,是否有违例现象出现,如果有修改脚本加以修复直到最终通过设计。 注意 另外的几个文件夹作用 db文件夹存放DC综合生成的项目db文件,综合网表输出到netlist 文件夹,综合程序运行报告存放在log文件夹中,而综合结果的数据报告则存放在rpt 文件夹中。 DC脚本的编写(A.scr) DC综合脚本基本上有几大部分组成 1】定义综合环境中命名规则(分别对net cell port 命名) define_name_rules verilog –casesensitive define_name_rules verilog –type net –allowed “a-z A-Z 0-9 _ ” \ -first_restricted “ _ 0-9 N ” \ -replacement_char “_ ” \ -prefix “n” define_name_rules verilog –type cell –allowed “a-z A-Z 0-9 _ ” \ -first_restricted “ _ 0-9 ” \ -replacement_char “_” \ -prefix “u” define_name_rules verilog –type port –allowed “a-z A-Z 0-9 _ ” \ -first_restricted “ _ 0-9 ” \ -replacement_char “_” \ -prefix “p”2】综合环境的建立 指明库所在的位置 Search_path = { lib_syn/db } 指定综合所需目标库一般选用最恶劣情况worst 库作目标库 target_library = { slow.db} 创建链接库,链接库中包括了一些已经做好的设计和子模块,又包括了当前设计的目标库是设计实例化时所用的库文件 link_library = { “ * ” , slow.db } + synthetic_library 在上述的环境建立所需的各类库中,一般有生产商提供目标库,库中的各类cell用于逻辑映射,链接库则包括了目标库,还包括其他一些以前设计实例基本单元,我们门级网表实例化元件和单元都来自于它。 3】RTL 代码的读入 read –format verilog ./in/ Encoder_32k.v read –format verilog ./in/ Encoder_DBLOCK.v read –format verilog ./in/ Encoder.v read –format verilog ./in/ Step_rom.v指明设计顶层 current_design = Encoder 展开设计分解原设计组 ungroup -all –flatten 设计唯一实例化 uniquify 4】综合环境约束 用户往往需要设置worst case 和 best case 的库来验证setup timing 修复 hold timing 不清楚命令使用和属性 可使用 man set_min_library 查看 set_min_library lib_syn/db/slow.db -min_version lib_syn/db/fast.db 编译操作条件的表述 set_operating_conditions -min slow –min_library slow \ -max fast –max_library fast 设置wire_load_model wire_load_model 负载模型的每一种模型定义,它定义相关的net_length 和 net fanout 属性 而wire_load_mode 则不同指的是不同logic margin 连线net的处理方式 一般我们只设置前者 set_wire_load_model -name “ Silterra18_w110 ” –min set_wire_load_model -name “ Silterra18_w110 ” –max设置模块输入驱动强度信息 man set_driving_cell 查看帮助 set_driving_cell -lib_cell BUFX1 –pin Y –library slow –dont_scale –no_design_rule all_input ( )5】设计时钟相关约束 create_clock clk -period 40 set_clock_latency 0.3 –rise { clk } set_clock_latency 0.3 –fall { clk } set_clock_uncertainty –setup 0.3 { clk } set_clock_uncertainty –hold 0.3 { clk }6】禁止改变门电路控制结构 芯片中的时钟和复位电路一般由门电路控制的,我们不希望DC在综合时候改变它的结构以保证时钟信号和复位信号的稳定性和可靠性需要设置,禁止对某些单元进行优化 set_dont_touch_network { clk, rstn } set_dont_touch { rstn }7】异步电路处理 任何跨越异步边界的路径我们都对其禁止时序分析 set_false_path -from { rstn } –to { clk } 8】设置其他可选约束和禁用单元 可选约束一般包括 set_max_fanout set_max_capacitance set_max_transition set_load 等 这些属性一般在技术库中已经设置了,只有技术库不能满足设计要求时才使用脚本增加约束选项 本脚本中只增加了 set_load 0.02 all_output ( ) Set_max_transition 2.5 current_design 输入输出直通buffer 插入,多重端口的连接插入buffer (选用) set_fix_multiple_port_nets –feedthrough 输出端口插入buffer , 隔离端口 (必须) set_isolate_ports –type buffer all_output ( ) 9】检查设计层次关系进行单元映射 check_design –one_level compile –map_effort medium10】修复hold时序 重新编译 set_fix_hold {clk } compile –only_hold_time 11】导出编译综合相关报告 核对网表命名规则修改相关信息 change_names –rules verilog –hierarchy –verbose 检查整体设计导出报告 check_design > ./rpt/adpcm.rpt 移除未连接的相关端口 remove_unconnected_ports find ( hierarchy cell , “ * ”) 导出设计面积报告 report_area > ./rpt/adpcm_area.txt 导出设计违例报告 report_constraint –all_violators > ./rpt/adpcm_cons.txt 导出setup时序违例的详细报告 report_timing –nworst 50 > ./rpt/adpcm_max_time.txt 导出hold 时序违例的详细报告 report_timing -delay min –nworst 20 > ./rpt/adpcm_min_time.txt 导出综合的设计中cell和reg_cel的报告 report_cell > ./rpt/adpcm_cell.txt report_cell {find (cell, “* _reg *”)} > ./rpt/adpcm_reg_cell.txt12】生成综合网表和pnr 所需的时序约束文件 write -hierarchy -output ./db/adpcm.db write -format verilog –hierarchy -output ./netlist/adpcm.sv write_sdf ./netlist/adpcm.sdf write_sdc ./netlist/adpcm.sdc exit13】compile-ultra 图片
EDA&虚拟机
# EDA&虚拟机
刘航宇
3年前
0
1,714
0
I2C协议及verilog实现-串口读写 EEPROM
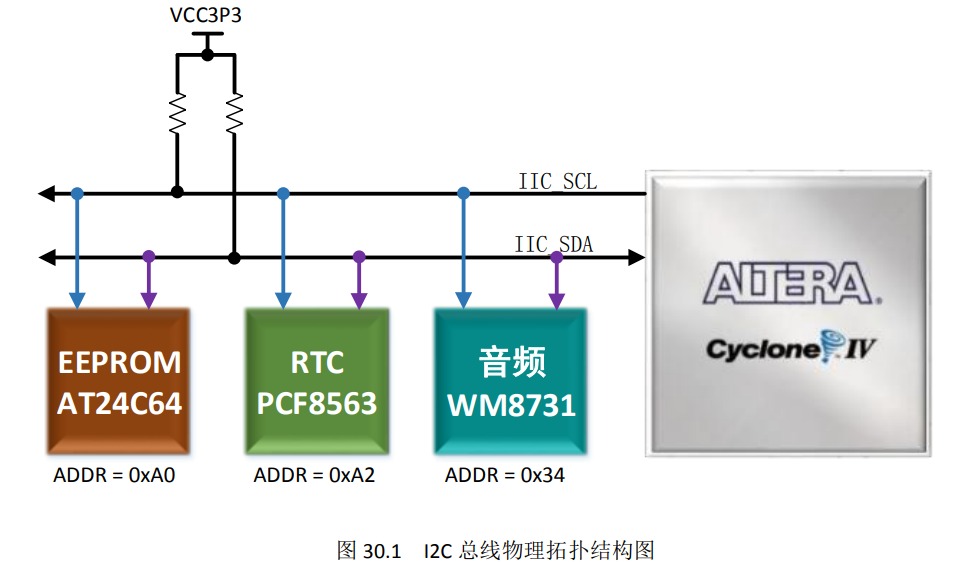
摘要本文介绍了I2C协议的基本概念、时序、器件地址和存储器地址,并详细阐述了I2C读写操作的时序和Verilog实现,最后通过仿真和板级验证验证了设计的正确性。关键词:I2C协议, Verilog实现, 串口读写, EEPROM, FPGAI2C 基本概念 I2C 总线(I2C bus,Inter-IC bus)是一个双向的两线连续总线,提供集成电路(ICs)之间的通信线路。I2C 总线是一种串行扩展技术,最早由 Philips 公司推出,广泛应用于电视,录像机和音频设备。I2C 总线的意思是“完成集成电路或功能单元之间信息交换的规范或协议”。Philips 公司推出的 I2C 总线采用一条数据线(SDA),加一条时钟线(SCL)来完成数据的传输及外围器件的扩展。I2C 总线物理拓扑结构如图 30.1 所示。 图片 I2C 总线在物理连接上比较简单,分别由 SDA(串行数据线)和 SCL(串行时钟线)两条总线及上拉电阻组成。通信的原理是通过控制 SCL 和 SDA 的时序,使其满足 I2C 的总线协议从而进行数据的传输。 I2C 总线上的每一个设备都可以作为主设备或者从设备,而且每一个设备都会对应一个唯一的地址(可以从 I2C 器件数据手册得知),主从设备之间就是通过这个地址来确定与哪个器件进行通信。本次实验我们把 FPGA 作为主设备,把挂载在总线上的其他设备(如 EEPROM、PFC8563 等 I2C 器件)作为从设备。 I2C 总线数据传输速率在标准模式下可达 100kbit/s,快速模式下可达 400kbit/s,高速模式下可达 3.4Mbit/s。I2C 总线上的主设备与从设备之间以字节(8 位)为单位进行双向的数据传输。 目录 I2C 基本概念 I2C 协议时序介绍 inout信号原理 I2C 器件地址 I2C 存储器地址 I2C 单字节写时序 I2C 连续写时序(页写时序) I2C 单字节读时序 I2C 连续读时序(页读取) I2C 读写器件控制程序 本节小结 I2C 协议时序介绍 I2C 协议整体时序图如图 30.2 所示 图片 I2C 协议整体时序说明如下: (1) 总线空闲状态:SDA 为高电平,SCL 为高电平; (2) I2C 协议起始位:SCL 为高电平时,SDA 出现下降沿,产生一个起始位; (3) I2C 协议结束位:SCL 为高电平时,SDA 出现上升沿,产生一个结束位; (4) I2C 读写数据状态:主要包括数据的串行输出输入和数据接收方对数据发送方的响应信号。具体时序如图 30.3 所示。 图片 当 I2C 主机(后面简称主机)向 I2C 从机(后面简称从机)写入数据时,SDA 上的每一位数据在 SCL 的高电平期间被写入从机中。从主机角度来看,需要在 SCL 低电平期间改变要写入的数据。而当主机读取从机中数据时,从机在 SCL 低电平期间将数据输出到 SDA 总线上,在 SCL 的高电平期间保持数据稳定,从主机角度来看,需要在 SCL 的高电平期间将 SDA 线上的数据读取并存储。 每当一个字节的数据或命令传输完成时,数据接收方都会向发送方响应一位应答位。在响应应答位时,数据发出方将 SDA 总线设置为三态输入,由于 I2C 总线上都有上拉电阻,因此此时总线默认为高电平,若数据接收方正确接收到数据,则数据接收方将 SDA 总线拉低,以示正确应答。例如当主机向从机写入数据或命令时,每个字节都需要从机产生应答信号以告诉主机此次的数据或命令是否成功被写入。所以,当主机将一字节的数据或命令传出后,会将 SDA 信号设置为三态输入,等待从机应答(等待 SDA 被从机拉低为低电平),若从机正确应答,表明当前数据或命令传输成功,可以结束或开始下一个数据或命令的传输,否则表明数据或命令写入失败,主机就可以决定是否放弃写入或者重新发起写入。 inout信号原理 图片 图片 I2C 器件地址 每个 I2C 器件都有一个器件地址,有的器件地址在出厂时地址就设置好了,用户不可以更改(例如 OV7670 器件地址为固定的 0x42),有的确定了几位,剩下几位由硬件确定(比如常见的 I2C 接口的 EEPROM 存储器,留有 3 个控制地址的引脚,由用户自己在硬件设计时确定)。严格讲,主机不是直接向从机发送地址,而是主机往总线上发送地址,所有的从机都能接收到主机发出的地址,然后每个从机都将主机发出的地址与自己的地址比较,如 果匹配上了,这个从机就会向主机发出一个响应信号。主机收到响应信号后,开始向总线上发送数据,与这个从机的通讯就建立起来了。如果主机没有收到响应信号,则表示寻址失败。 通常情况下,主从器件的角色是确定的,也就是说从机一直工作在从机模式。不同器件定义地址的方式是不同的,有的是软件定义,有的是硬件定义。例如某些单片机的I2C 接口作为从机时,其器件地址是可以通过软件修改从机地址寄存器确定的。而对于一些其他器件,如 CMOS 图像传感器、EEPROM 存储器,其器件地址在出厂时就已经设定好了,具体值可以在对应的数据手册中查到。 对于 AT24C64 这样一颗 EEPROM 器件,其器件地址为 1010 加 3 位的片选信号。3位片选信号由硬件连接决定。例如 SOIC 封装的该芯片 PIN1、PIN2、PIN3 为片选地址。当硬件电路上分别将这三个 pin 连接到 GND 或 VCC 时,就可以设置不同的片选地址。I2C 协议在进行数据传输时,主机需要首先向总线上发出控制命令,其中,控制命令就包含了从机地址/片选信号+读写控制。然后等待从机响应。如图 30.4 所示为 I2C 控制命令传输的数据格式。 图片 I2C 传输时,按照从高到低的位序进行传输。控制字节的最低位为读写控制位,当该位为 0 时表示主机对从机进行写操作,当该位为 1 时表示主机对从机进行读操作。例如,当需要对片选地址为 100 的 AT24LC64 发起写操作,则控制字节应该为 1010_100_0。若进行读操作,则控制字节应该为 1010_100_1。 I2C 存储器地址 每个支持 I2C 协议的器件,内部总会有一些可供读写的寄存器或存储器,例如,对于我们用到的 EEPROM 存储器,内部就是顺序编址的一系列存储单元。对于我们常接触的 CMOS 摄像头如 OV7670(OV7670 的该接口叫 SCCB 接口,其实质也是一种特殊的 I2C协议,可以直接兼容 I2C 协议),其内部就是一系列编址的可供读写的寄存器。因此,我们要对一个器件中的存储单元(寄存器和存储器以下简称存储单元)进行读写,就必须要能够指定存储单元的地址。I2C 协议设计了有从机存储单元寻址地址段,该地址段为一个字或两个字节长度,在主机确认收到从机返回的控制字节响应后由主机发出。地址段长度视不同的器件类型,长度不同,例如同是 EEPROM 存储器,AT24C04 的址段长度为一个字节,而 AT24C64 的地址段长度为两个字节。具体是一个字节还是两个字节,与器件的存储单元数量有关。如图 30.5 和图 30.6 分别为 1 字节地址和 2 字节地址器件的地址分布图,其中 1 字节地址的器件是以内存为 1kbit 的 EEPROM 存储器 AT24C01 举例,2 字节地址的器件是以内存为 64kbit 的 EEPROM 存储器 AT24C64 举例的。 图片 I2C 单字节写时序 根据前面讲的,不同器件,I2C 器件地址字节不同,这样对于 I2C 单字节写时序就会有所差别,图 30.7 和图 30.8 分别为 1 字节地址段器件和 2 字节地址段器件单字节写时序图。 图片 图片 根据时序图,从主机角度来描述一次写入单字节数据过程如下: a. 主机设置 SDA 为输出; b. 主机发起起始信号; c. 主机传输器件地址字节,其中最低位为 0,表明为写操作; d. 主机设置 SDA 为三态门输入,读取从机应答信号; e. 读取应答信号成功,主机设置 SDA 为输出,传输 1 字节地址数据; f. 主机设置 SDA 为三态门输入,读取从机应答信号; g. 读取应答信号成功,对于两字节地址段器件,传输地址数据低字节,对于 1 字节地址段器件,主机设置 SDA 为输出,传输待写入的数据; h. 设置 SDA 为三态门输入,读取从机应答信号,对于两字节地址段器件,接着步骤 i;对于 1 字节地址段器件,直接跳转到步骤 k; i. 读取应答信号成功,主机设置 SDA 为输出,传输待写入的数据(对于两字节地址段器件); j. 设置 SDA 为三态门输入,读取从机应答信号(两字节地址段器件); k. 读取应答信号成功,主机产生 STOP 位,终止传输。 I2C 连续写时序(页写时序) 注:I2C 连续写时序仅部分器件支持。 连续写是主机连续写多个字节数据到从机,这个和单字节写操作类似,连续多字节写操作也是分为 1 字节地址段器件和 2 字节地址段器件的写操作,图 30.9 和图 30.10 分别为 1 字节地址段器件和 2 字节地址段器件连续多字节写时序图。 图片 根据时序图,从主机角度来描述一次写入多字节数据过程如下: a. 主机设置 SDA 为输出; b. 主机发起起始信号; c. 主机传输器件地址字节,其中最低位为 0,表明为写操作; d. 主机设置 SDA 为三态门输入,读取从机应答信号; e. 读取应答信号成功,主机设置 SDA 为输出,传输 1 字节地址数据; f. 主机设置 SDA 为三态门输入,读取从机应答信号; g. 读取应答信号成功后,主机设置 SDA 为输出,对于两字节地址段器件,传输低字节地址数据,对于 1 字节地址段器件,传输待写入的第 1 个数据 h. 设置 SDA 为三态门输入,读取从机应答信号,对于两字节地址段器件,接着步骤 i;对于 1 字节地址段器件,直接跳转到步骤 k; i. 读取应答信号成功后,主机设置 SDA 为输出,传输待写入的第 1 个数据(两字节地址段器件); j. 设置 SDA 为三态门输入,读取从机应答信号(两字节地址段器件); k. 读取应答信号成功后,主机设置 SDA 为输出,传输待写入的下一个数据; l. 设置 SDA 为三态门输入,读取从机应答信号;n 个数据被写完,转到步骤 m,若数据未被写完,转到步骤 k; m. 读取应答信号成功后,主机产生 STOP 位,终止传输。 注:对于 AT24Cxx 系列的 EEPROM 存储器,一次可写入的最大长度为 32 字节。 I2C 单字节读时序 同样的,I2C 读操作时序根据不同 I2C 器件具有不同的器件地址字节数,单字节读操作分为 1 字节地址段器件单节数据读操作和 2 字节地址段器件单节数据读操作。图30.11 和图 30.12 分别为 不同情况的时序图。 图片 根据时序图,从主机角度描述一次读数据过程,如下: a. 主机设置 SDA 为输出; b. 主机发起起始信号; c. 主机传输器件地址字节,其中最低位为 0,表明为写操作; d. 主机设置 SDA 为三态门输入,读取从机应答信号; e. 读取应答信号成功,主机设置 SDA 输出,传输 1 字节地址数据; f. 主机设置 SDA 为三态门输入,读取从机应答信号; g. 读取应答信号成功,主机设置 SDA 输出,对于两字节地址段器件,传输低字节地址数据;对于 1 字节地址段器件,无此步骤,直接跳转到步骤 h; h. 主机发起起始信号; i. 主机传输器件地址字节,其中最低位为 1,表明为读操作; j. 设置 SDA 为三态门输入,读取从机应答信号; k. 读取应答信号成功,主机设置 SDA 为三态门输入,读取 SDA 总线上的一个字节的数据; l. 产生无应答信号(高电平)(无需设置为输出高电平,因为总线会被自动拉高);m. 主机产生 STOP 位,终止传输。 I2C 连续读时序(页读取) 连续读是主机连续从从机读取多个字节数据,这个和单字节读操作类似,连续多字节读操作也是分为 1 字节地址段器件和 2 字节地址段器件的读操作,图 30.13 和图 30.14 分别为 1 字节地址段器件和 2 字节地址段器件连续多字节读时序图。 图片 根据时序图,从主机角度描述多字节数据读取过程如下: a. 主机设置 SDA 为输出 b. 主机发起起始信号 c. 主机传输器件地址字节,其中最低位为 0,表明为写操作。 d. 主机设置 SDA 为三态门输入,读取从机应答信号。 e. 读取应答信号成功,主机设置 SDA 输出,传输 1 字节地址数据 f. 主机设置 SDA 为三态门输入,读取从机应答信号。 g. 读取应答信号成功,主机设置 SDA 输出,对于两字节地址段器件,传输低字节地址数据;对于 1 字节地址段器件,无此步骤;直接跳转到步骤h; h. 主机发起起始信号; i. 主机传输器件地址字节,其中最低位为 1,表明为读操作; j. 设置 SDA 为三态门输入,读取从机应答信号; k. 设置 SDA 为三态门输入,读取 SDA 总线上的第 1 个字节的数据; l. 主机设置 SDA 输出,发送一位应答信号; m. 设置 SDA 为三态门输入,读取 SDA 总线上的下一个字节的数据;若 n 个字节数据读完成,跳转到步骤 n,若数据未读完,跳转到步骤 l;(对于 AT24Cxx,一次读取长度最大为 32 字节,即 n 不大于 32) n. 主机设置 SDA 输出,产生无应答信号(高电平)(无需设置为输出高电平,因为总线会被自动拉高); o. 主机产生 STOP 位,终止传输。 I2C 读写器件控制程序 通过上述的讲述,对 I2C 读写器件数据时序有了一定的了解,下面将开始进行控制程序的设计。根据上面 I2C 的基本概念中有关读写时 SDA 与 SCL 时序,不管对于从机还是主机,SDA 上的每一位数据在 SCL 的高电平期间保持不变,而数据的改变总是在 SCL的低电平期间发生。因此,我们可以选用 2 个标志位对时钟 SCL 的高电平和低电平进行标记,如下图所示:scl_high 对 SCL 高电平期间进行标志,scl_low 对 SCL 低电平期间进行标志。这样就可以在 scl_high 有效时读 SDA 数据,在 scl_low 有效时改变数据。scl_high和 scl_low 产生的时序图如图 30.15 所示。 图片 在本实验中,时钟信号 SCL 采用计数器方法产生,计数器最大计数值为系统时钟频率除以 SCL 时钟频率,即:SCL_CNT_M = SYS_CLOCK/SCL_CLOCK。对于 scl_high 和 scl_low则只需要分别在计数到四分之一的最大值和四分之三的最大值时产生标志位即可,具体的时钟信号 SCL 和标志信号 scl_high、scl_low 产生实现代码如下: //系统时钟采用 50MHz parameter SYS_CLOCK = 50_000_000; //SCL 总线时钟采用 400kHz parameter SCL_CLOCK = 400_000; //产生时钟 SCL 计数器最大值 localparam SCL_CNT_M = SYS_CLOCK/SCL_CLOCK; reg [15:0]scl_cnt; //SCL 时钟计数器 reg scl_vaild; //I2C 非空闲时期 reg scl_high; //SCL 时钟高电平中部标志位 reg scl_low; //SCL 时钟低电平中部标志位 //I2C 非空闲时期 scl_vaild 的产生 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_vaild <= 1'b0; else if(Wr | Rd) scl_vaild <= 1'b1; else if(Done) scl_vaild <= 1'b0; else scl_vaild <= scl_vaild; end //scl 时钟计数器 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_cnt <= 16'd0; else if(scl_vaild)begin if(scl_cnt == SCL_CNT_M - 1) scl_cnt <= 16'd0; else scl_cnt <= scl_cnt + 16'd1; end else scl_cnt <= 16'd0; end //scl 时钟,在计数器值到达最大值一半和 0 时翻转 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Scl <= 1'b1; else if(scl_cnt == SCL_CNT_M >>1) Scl <= 1'b0; else if(scl_cnt == 16'd0) Scl <= 1'b1; else Scl <= Scl; end //scl 时钟高低电平中部标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_high <= 1'b0; else if(scl_cnt == (SCL_CNT_M>>2)) scl_high <= 1'b1; else scl_high <= 1'b0; end //scl 时钟低电平中部标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) scl_low <= 1'b0; else if(scl_cnt == (SCL_CNT_M>>1)+(SCL_CNT_M>>2)) scl_low <= 1'b1; else scl_low <= 1'b0; end上述代码中 Wr 和 Rd 信号为 I2C 进行一次写和读操作的门控使能信号,Done 信号为一次I2C写和读操作完成标志位。(SCL_CNT_M>>2)和(SCL_CNT_M>>1)+(SCL_CNT_M>>2)分别为 1/2 的 SCL_CNT_M 和 3/4 的 SCL_CNT_M 的计数值。 在 SCL 时钟总线以及其高低电平标志位产生完成后,接下来的事情就是 SDA 数据线的产生,这个需要根据具体的读写操作时序完成。本实验主要采用状态机实现,根据上面讲述的读写数据的时序关系,设计了如图 30.16 所示的状态转移图,其状态机状态编码采用独热编码,若需要改变状态编码形式,只需改变程序中的 parameter 定义即可。 图片 根据上面 I2C 基本概念可知,不同的器件其寄存器地址字节数分为 1 字节或和 2 字节地址段,并且有些 I2C 器件是支持多字节的数据读写,所以在设计时考虑到该 I2C 控制器的通用性,我们将设计寄存器地址字节和读取数据个数均可自行设置的 I2C 控制器,用户可根据自己的实际应用情况设置选择与器件对应的寄存器地址字节数或是读写数据的字节数。寄存器地址字节数的可变主要是通过一个计数器对字节数进行计数,当计数值达到指定值后跳转到下一状态,具体的可参见代码。 在状态机中,从主机角度来看,SDA 数据线上在写控制、写数据、读控制状态过程是需要串行输出数据,而在读数据状态过程是需要串行输入数据。根据数据在时钟高电平期间保持不变,改变数据在低电平时期的规则,本设计对时钟信号的高低电平进行计数,从而在指定的计数值进行输出或读取数据实现数据的串行输出和串行输入。串行输出和串行输入数据采用任务的形式进行表示,便于在主状态机中多次的调用。图 30.17为计数的过程以及特定状态变化的时序图,这里的特定状态主要是指读/写控制、读/写地址和读/写数据状态。 图片 图 30.17 中计数器 halfbit_cnt 和数据接收方对发送的响应检测标志位 ack 以及串行输出、输入数据任务的具体代码如下: //sda 串行接收与发送时 scl 高低电平计数器 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) halfbit_cnt <= 8'd0; else if((main_state == WR_CTRL)|| (main_state == WR_WADDR)|| (main_state == WR_DATA)|| (main_state == RD_CTRL)|| (main_state == RD_DATA))begin if(scl_low | scl_high)begin if(halfbit_cnt == 8'd17) halfbit_cnt <= 8'd0; else halfbit_cnt <= halfbit_cnt + 8'd1; end else halfbit_cnt <= halfbit_cnt; end else halfbit_cnt <= 8'd0; end //数据接收方对发送的响应检测标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) ack <= 1'b0; else if((halfbit_cnt == 8'd16)&&scl_high&&(Sda==1'b0)) ack <= 1'b1; else if((halfbit_cnt == 8'd17)&&scl_low) ack <= 1'b0; else ack <= ack; end //输出串行数据任务 task send_8bit_data; if(scl_high && (halfbit_cnt == 8'd16)) FF <= 1; else if(halfbit_cnt < 8'd17)begin sda_reg <= sda_data_out[7]; if(scl_low) sda_data_out <= {sda_data_out[6:0],1'b0}; else sda_data_out <= sda_data_out; end else ; endtask //串行数据输入任务 task receive_8bit_data; if(scl_low && (halfbit_cnt == 8'd15)) FF <= 1; else if((halfbit_cnt < 8'd15))begin if(scl_high) sda_data_in <= {sda_data_in[6:0],Sda}; else begin sda_data_in <= sda_data_in; end end else ; endtask对于计数器 halfbit_cnt 只在写控制、写数据、读控制、读数据状态下才进行计数,其他状态为零。代码中 FF 是进行串行输出或输入任务的标志位,当 FF 为 1 时表示退出任务,FF 为 0 时表示进入任务。这样便于在状态机中对任务的调用,以及在指定的时间退出任务。 接下来就是主状态机的设计,主状态机的状态转移图上面已经给出,具体转移过程是依据 I2C 读写时序进行的,代码如下: //主状态机 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n)begin main_state <= IDLE; sda_reg <= 1'b1; W_flag <= 1'b0; R_flag <= 1'b0; Done <= 1'b0; waddr_cnt <= 2'd1; wdata_cnt <= 8'd1; rdata_cnt <= 8'd1; end else begin case(main_state) IDLE:begin sda_reg <= 1'b1; W_flag <= 1'b0; R_flag <= 1'b0; Done <= 1'b0; waddr_cnt <= 2'd1; wdata_cnt <= 8'd1; rdata_cnt <= 8'd1; if(Wr)begin main_state <= WR_START; W_flag <= 1'b1; end else if(Rd)begin main_state <= WR_START; R_flag <= 1'b1; end else main_state <= IDLE; end WR_START:begin if(scl_low)begin main_state <= WR_CTRL; sda_data_out <= wr_ctrl_word; FF <= 1'b0; end else if(scl_high)begin sda_reg <= 1'b0; main_state <= WR_START; end else main_state <= WR_START; end WR_CTRL:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(scl_low)begin main_state <= WR_WADDR; FF <= 1'b0; if(Wdaddr_num == 2'b1) sda_data_out <= Word_addr[7:0]; else sda_data_out <= Word_addr[15:8]; end else main_state <= WR_CTRL; end else//未收到响应 main_state <= IDLE; end end WR_WADDR:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(waddr_cnt == Wdaddr_num)begin if(W_flag && scl_low)begin main_state <= WR_DATA; sda_data_out <= Wr_data; waddr_cnt <= 2'd1; FF <= 1'b0; end else if(R_flag && scl_low)begin main_state <= RD_START; sda_reg <= 1'b1; end else main_state <= WR_WADDR; end else begin if(scl_low)begin waddr_cnt <= waddr_cnt + 2'd1; main_state <= WR_WADDR; sda_data_out <= Word_addr[7:0]; FF <= 1'b0; end else main_state <= WR_WADDR; end end else//未收到响应 main_state <= IDLE; end end WR_DATA:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(wdata_cnt == Wrdata_num)begin if(scl_low)begin main_state <= STOP; sda_reg <= 1'b0; wdata_cnt <= 8'd1; end else main_state <= WR_DATA; end else begin if(scl_low)begin wdata_cnt <= wdata_cnt + 8'd1; main_state <= WR_DATA; sda_data_out <= Wr_data; FF <= 1'b0; end else main_state <= WR_DATA; end end else//未收到响应 main_state <= IDLE; end end RD_START:begin if(scl_low)begin main_state <= RD_CTRL; sda_data_out <= rd_ctrl_word; FF <= 1'b0; end else if(scl_high)begin main_state <= RD_START; sda_reg <= 1'b0; end else main_state <= RD_START; end RD_CTRL:begin if(FF == 1'b0) send_8bit_data; else begin if(ack == 1'b1) begin//收到响应 if(scl_low)begin main_state <= RD_DATA; FF <= 1'b0; end else main_state <= RD_CTRL; end else//未收到响应 main_state <= IDLE; end end RD_DATA:begin if(FF == 1'b0) receive_8bit_data; else begin if(rdata_cnt == Rddata_num)begin sda_reg <= 1'b1; if(scl_low)begin main_state <= STOP; sda_reg <= 1'b0; end else main_state <= RD_DATA; end else begin sda_reg <= 1'b0; if(scl_low)begin rdata_cnt <= rdata_cnt + 8'd1; main_state <= RD_DATA; FF <= 1'b0; end else main_state <= RD_DATA; end end end STOP:begin//结束操作 if(scl_high)begin sda_reg <= 1'b1; main_state <= IDLE; Done <= 1'b1; end else main_state <= STOP; end default: main_state <= IDLE; endcase end end主状态机完成后,I2C 控制器设计的大块就解决了,剩下的就是 SDA 数据线的输出了,该数据线采用三态使能输出,具体代码如下: assign Sda = sda_en ? sda_reg : 1'bz;对于使能信号 sda_en 按照上面的时序关系图可知,该信号在不同的状态,其高低电平变化的时刻是有差别的,比如在开始和结束状态,它是一直为高电平的,在写控制、写数据、读控制状态,它是在串行输出一字节数据期间(即 halfbit_cnt < 16 时)为高电平,之外的一个数据为位低电平,而在读数据状态时串行输入一字节数据期间(即halfbit_cnt < 16 时)为低电平电平,之外的一个数据位为高电平。具体代码如下: //SDA 三态使能信号 sda_en always@(*) begin case(main_state) IDLE: sda_en = 1'b0; WR_START,RD_START,STOP: sda_en = 1'b1; WR_CTRL,WR_WADDR,WR_DATA,RD_CTRL: if(halfbit_cnt < 16) sda_en = 1'b1; else sda_en = 1'b0; RD_DATA: if(halfbit_cnt < 16) sda_en = 1'b0; else sda_en = 1'b1; default: sda_en = 1'b0; endcase end本实验设计考虑到了多字节数据的读取情况,所以增加了数据读取和数据写入时的 有效标志位信号。主要是标志读取数据时数据有效时刻和写数据时提供待写入数据时刻。 具体代码如下: //写数据有效标志位 assign Wr_data_vaild = ((main_state==WR_WADDR)&& (waddr_cnt==Wdaddr_num)&& (W_flag && scl_low)&& (ack == 1'b1))|| ((main_state == WR_DATA)&& (ack == 1'b1)&&(scl_low)&& (wdata_cnt != Wrdata_num)); //读数据有效标志位前寄存器 assign rdata_vaild_r = (main_state == RD_DATA) &&(halfbit_cnt == 8'd15)&&scl_low; //读出数据有效标志位 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Rd_data_vaild <= 1'b0; else if(rdata_vaild_r) Rd_data_vaild <= 1'b1; else Rd_data_vaild <= 1'b0; end //读出的有效数据 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Rd_data <= 8'd0; else if(rdata_vaild_r) Rd_data <= sda_data_in; else Rd_data <= Rd_data; end到目前为止,整个 I2C 控制器的设计就完成了,接下来就进入仿真环节,我们需要EEPROM 的仿真模型进行仿真,这样能更好的检验 I2C 控制器设计的是否存在问题,以便后面进行优化改进。本实验采用的是镁光官网提供的 EEPROM 仿真模型,具体下载网 址 为 http://www.microchip.com/zh/design-centers/memory/serial-eeprom/verilog-ibis-models,我们选择两个具有代表性的模型进行仿真,分别为 1 字节寄存器地址段的 24LC04B 和 2 字节寄存器地址段的 24LC64 仿真模型,利用这两个模型对我们设计的 I2C 控制器进行仿真。如图 30.18 为仿真验证的结构框图。 图片 这里我们对 1 字节寄存器地址段的 24LC04B 和 2 字节寄存器地址段的 24LC64 仿真模型的器件地址{A3,A2,A1}分别设置为 3’b001 和 3’b000,仿真时为了能分别对不同型号的模型进行仿真,在编写的 testbench 文件中采用了申明方法去选择当前使用哪个模型进行仿真,具体代码如下: `timescale 1ns/1ns `define CLK_PERIOD 20 //仿真模型选择 //`define TEST_M24LC64 //24LC64 `define TEST_M24LC04 //24LC04 module I2C_tb; reg Clk; //系统时钟 reg Rst_n; //系统复位信号 reg [15:0] Word_addr; //I2C 器件寄存器地址 reg Wr; //I2C 器件写使能 reg [7:0] Wr_data; //I2C 器件写数据 wire Wr_data_vaild;//I2C 器件写数据有效标志位 reg Rd; //I2C 器件读使能 wire[7:0] Rd_data; //I2C 器件读数据 wire Rd_data_vaild;//I2C 器件读数据有效标志位 wire Scl; //I2C 时钟线 wire Sda; //I2C 数据线 wire Done; //对 I2C 器件读写完成标识位 localparam NUM = 6'd4; //单次读写数据字节数 `ifdef TEST_M24LC64 localparam DevAddr = 3'b000; //I2C 器件的器件地址 localparam WdAr_NUM= 2; //I2C 器件的存储器地址字节数 `elsif TEST_M24LC04 localparam DevAddr = 3'b001; //I2C 器件的器件地址 localparam WdAr_NUM= 1; //I2C 器件的存储器地址字节数 `endif I2C I2C( .Clk(Clk), .Rst_n(Rst_n), .Rddata_num(NUM), .Wrdata_num(NUM), .Wdaddr_num(WdAr_NUM), .Device_addr(DevAddr), .Word_addr(Word_addr), .Wr(Wr), .Wr_data(Wr_data), .Wr_data_vaild(Wr_data_vaild), .Rd(Rd), .Rd_data(Rd_data), .Rd_data_vaild(Rd_data_vaild), .Scl(Scl), .Sda(Sda), .Done(Done) ); `ifdef TEST_M24LC64 M24LC64 M24LC64( .A0(1'b0), .A1(1'b0), .A2(1'b0), .WP(1'b0), .SDA(Sda), .SCL(Scl), .RESET(!Rst_n) ); `elsif TEST_M24LC04 M24LC04B M24LC04( .A0(1'b1), .A1(1'b0), .A2(1'b0), .WP(1'b0), .SDA(Sda), .SCL(Scl), .RESET(!Rst_n) ); `endif //系统时钟产生 initial Clk = 1'b1; always #(`CLK_PERIOD/2)Clk = ~Clk; initial begin Rst_n = 0; Word_addr = 0; Wr = 0; Wr_data = 0; Rd = 0; #(`CLK_PERIOD*200 + 1) Rst_n = 1; #200; `ifdef TEST_M24LC64 //仿真验证 24LC64 模型 //写入 20 组数据 Word_addr = 0; Wr_data = 0; repeat(20)begin Wr = 1'b1; #(`CLK_PERIOD); Wr = 1'b0; repeat(NUM)begin //在写数据有效前给待写入数据 @(posedge Wr_data_vaild) Wr_data = Wr_data + 1; end @(posedge Done); #2000; Word_addr = Word_addr + NUM; end #2000; //读出刚写入的 20 组数据 Word_addr = 0; repeat(20)begin Rd = 1'b1; #(`CLK_PERIOD); Rd = 1'b0; @(posedge Done); #2000; Word_addr = Word_addr + NUM; end `elsif TEST_M24LC04 //仿真验证 24LC04 模型 //写入 20 组数据 Word_addr = 100; Wr_data = 100; repeat(20)begin Wr = 1'b1; #(`CLK_PERIOD); Wr = 1'b0; repeat(NUM)begin //在写数据有效前给待写入数据 @(posedge Wr_data_vaild) Wr_data = Wr_data + 1; end @(posedge Done); #2000; Word_addr = Word_addr + NUM; end #2000; //读出刚写入的 20 组数据 Word_addr = 100; repeat(20)begin Rd = 1'b1; #(`CLK_PERIOD); Rd = 1'b0; @(posedge Done); #2000; Word_addr = Word_addr + NUM; end `endif #5000; $stop; end endmodule在 testbench 文件中,通过对 EEPROM 模型进行 20 写操作,每次写字节数为NUM,然后对 EEPROM 模型在刚写入数据的地址段进行读操作,通过比较读出和写入的数据验证 I2C 控制器设计是否正确。这里分别通过申明选择 TEST_M24LC64 或TEST_M24LC04 来作为当前的仿真模型。如图 30.19 所示为 2 字节地址的 EEPROM模型 24LC64 仿真结果。图 30.20 和图 30.21 分别为型号 24LC64 仿真模型写操作时序和读操作时序放大后的波形图。 图片 图片 同样的方式选择 24LC04 型号 EEPROM 模型进行仿真,如图 30.22 所示为 1 字节地址的 EEPROM 模型 24LC604 仿真结果。图 30.23 和图 30.24 分别为型号24LC604 仿真模型写操作时序和读操作时序放大后的波形图。 图片 通过观察图 30.21 和图 30.24 的时序波形发现,在读操作时序结果中,读出的数据中某些位是高阻态,仔细观察波形可知,高阻态的位置正好是需要输出高电平的位置,这个的原因是 EEPROM 的仿真模型是完全与实际的器件是一样的,对于器件来说,只在输出 0 时将数据线拉低,而在高阻态或本应该为高电平的时刻都是设置为高阻态的,这个在仿真模型的代码中也有体现,具体体现这一点的代码如下: bufif1 (SDA, 1'b0, SDA_DriveEnableDlyd);图片 其中,器件地址包括器件的地址字节数和 3 位的器件地址,具体分配如下: 图片 功能码主要是区分是写数据操作还是读数据操作,为了方便,我们直接规定,功能码为 0xf1 表示写数据操作,0xf2 表示读数据操作;起始地址是我们要读写数据的第一个地址;数据字节数表示要写入或读取的数据的字节个数,后面的数据 1 到数据n 表示要写入的 n 个数据,对于读操作没有这部分。如图 30.25 为该实验整体的设计框图。 图片 有关串口发送和接收以及 fifo 模块在前面章节都已经进行了讲解,这里就不重复讲解了,这里重点讲解命令解析模块的设计,命令解析模块的主要作用是对串口接收的数据进行解析,通过对接收的数据进行解析分析判断出是进行何种操作。根据我们自己规定的数据协议,进行如下的设计,首先我们将串口发送的数据的前 4 个数据存入一个缓冲区数据内,通过对功能码识别判断是写操作还是读操作,如果是写操作,就将后面待写入的数据存入 fifo 中;同时将器件地址、地址字节数、起始地址、数据字节数赋值给 I2C 对应的信号线;如果是读操作,就在前 4 个字节接收完成后将器件地址、地址字节数、起始 地址、数据字节数赋值给 I2C 对应的信号线,同时给 I2C 控制器模块的读使能给一个时钟周期的门控信号,使能 I2C 的读操作。读出的数据同样也是先存放在另外一个 fifo 中,然后送给串口发送模块发出。具体实现代码如下: module cmd_analysis( Clk, Rst_n, Rx_done, Rx_data, Wfifo_req, Wfifo_data, Rddata_num, Wrdata_num, Wdaddr_num, Device_addr, Word_addr, Rd ); input Clk; //系统时钟 input Rst_n; //系统复位 input Rx_done; //串口接收一字节数据完成 input[7:0] Rx_data; //串口接收一字节数据 output reg Wfifo_req; //写 fifo 请求信号 output reg[7:0] Wfifo_data; //写 fifo 数据 output reg[5:0] Rddata_num; //I2C 总线连续读取数据字节数 output reg[5:0] Wrdata_num; //I2C 总线连续读取数据字节数 output reg[1:0] Wdaddr_num; //I2C 器件数据地址字节数 output reg[2:0] Device_addr; //EEPROM 器件地址 output reg[15:0] Word_addr; //EEPROM 寄存器地址 output reg Rd; //EEPROM 读请求信号 reg [7:0] buff_data[4:0];//串口接收数据缓存器 //串口接收数据计数器 reg [7:0]byte_cnt; always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) byte_cnt <= 8'd0; else if(Rx_done && byte_cnt==8'd4)begin if(buff_data[1]==8'hf2) //读数据指令 byte_cnt <= 8'd0; else if(buff_data[1]==8'hf1) //写数据指令 byte_cnt <= byte_cnt + 8'd1; else byte_cnt <= 8'd0; //错误指令 end else if(Rx_done)begin if(byte_cnt == 8'd4 + buff_data[4]) byte_cnt <= 8'd0; else byte_cnt <= byte_cnt + 8'd1; end else byte_cnt <= byte_cnt; end //串口接收数据缓存器 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n)begin buff_data[0] <= 8'h00; buff_data[1] <= 8'h00; buff_data[2] <= 8'h00; buff_data[3] <= 8'h00; buff_data[4] <= 8'h00; end else if(Rx_done && byte_cnt<5) buff_data[byte_cnt] <= Rx_data; else ; end //写 fifo 请求信号 Wfifo_req always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Wfifo_req <= 1'b0; else if(byte_cnt >8'd4 && Rx_done) Wfifo_req <= 1'b1; else Wfifo_req <= 1'b0; end //写 fifo 数据 Wfifo_data always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Wfifo_data <= 8'd0; else if(byte_cnt > 8'd4 && Rx_done) Wfifo_data <= Rx_data; else Wfifo_data <= Wfifo_data; end //EEPROM 读请求信号 Rd always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) Rd <= 1'b0; else if(byte_cnt == 8'd4 && Rx_done && buff_data[1]==8'hf2) Rd <= 1'b1; else Rd <= 1'b0; end //指令完成标志位 reg cmd_flag; always@(posedge Clk or negedge Rst_n) begin if(!Rst_n) cmd_flag <= 1'b0; else if((byte_cnt == 8'd4)&& Rx_done) cmd_flag <= 1'b1; else cmd_flag <= 1'b0; end //EEPROM 读写数据、寄存器地址字节数,器件地址,寄存器地址 always@(posedge Clk or negedge Rst_n) begin if(!Rst_n)begin Rddata_num <= 6'd0; Wrdata_num <= 6'd0; Wdaddr_num <= 2'd0; Device_addr <= 3'd0; Word_addr <= 16'd0; end else if(cmd_flag == 1'b1)begin Rddata_num <= buff_data[4][5:0]; Wrdata_num <= buff_data[4][5:0]; Wdaddr_num <= buff_data[0][5:4]; Device_addr <= buff_data[0][2:0]; Word_addr <= {buff_data[2],buff_data[3]}; end else ; end endmodule下面编写 testbench 测试文件对设计的命令解析模块进行仿真验证,该仿真主要是分别模拟发送写数据操作和读数据操作指令,来观察相应的输出时序波形结果。通过仿真时序结果可以对该模块进行优化改进,具体的 testbench 文件如下: `timescale 1ns/1ns `define CLK_PERIOD 20 module cmd_analysis_tb; reg Clk; reg Rst_n; reg Rx_done; reg [7:0] Rx_data; wire Wfifo_req; wire[7:0] Wfifo_data; wire[5:0] Rddata_num; wire[5:0] Wrdata_num; wire[1:0] Wdaddr_num; wire[2:0] Device_addr; wire[15:0] Word_addr; wire Rd; reg [15:0] addr; reg [7:0] data_num; reg [7:0] wr_data; reg [39:0] wdata_cmd; reg [39:0] rdata_cmd; cmd_analysis cmd_analysis( .Clk(Clk), .Rst_n(Rst_n), .Rx_done(Rx_done), .Rx_data(Rx_data), .Wfifo_req(Wfifo_req), .Wfifo_data(Wfifo_data), .Rddata_num(Rddata_num), .Wrdata_num(Wrdata_num), .Wdaddr_num(Wdaddr_num), .Device_addr(Device_addr), .Word_addr(Word_addr), .Rd(Rd) ); //写 FIFO 模块例化 fifo_wr wr( .clock(Clk), .data(Wfifo_data), .rdreq(), .wrreq(Wfifo_req), .empty(), .full(), .q(), .usedw() ); //系统时钟产生 initial Clk = 1'b1; always #(`CLK_PERIOD/2)Clk = ~Clk; initial begin Rst_n = 0; Rx_done = 0; Rx_data = 0; addr = 0; data_num = 0; wr_data = 0; wdata_cmd = 0; rdata_cmd = 0; #(`CLK_PERIOD*200 + 1) Rst_n = 1; #200; addr = 0; data_num = 4; wr_data = 0; send_uart_data_wr; //写数据 #500; send_uart_data_rd; //读数据 #500; addr = 4; data_num = 8; wr_data = 20; send_uart_data_wr; //写数据 #500; send_uart_data_rd; //读数据 #500; $stop; end //串口发送写数据命令和待写入数据任务 task send_uart_data_wr; begin //写数据指令 wdata_cmd = {8'h21,8'hf1,addr[15:8],addr[7:0],data_num}; //发送写数据指令 repeat(5)begin Rx_done = 1; Rx_data = wdata_cmd[39:32]; #(`CLK_PERIOD) Rx_done = 0; #500; wdata_cmd = {wdata_cmd[31:0],8'h00}; end //待写入数据 Rx_data = wr_data; repeat(data_num)begin Rx_done = 1; Rx_data = Rx_data + 1; #(`CLK_PERIOD) Rx_done = 0; #500; end end endtask //串口发送读数据命令任务 task send_uart_data_rd; begin //读数据指令 rdata_cmd = {8'h21,8'hf2,addr[15:8],addr[7:0],data_num}; //发送读数据指令 repeat(5)begin Rx_done = 1; Rx_data = rdata_cmd[39:32]; #(`CLK_PERIOD) Rx_done = 0; #500; rdata_cmd = {rdata_cmd[31:0],8'h00}; end end endtask endmodule仿真过程主要是模拟命令解析模块接收到写或读 EEPROM 操作指令后的操作是否和我们设计想要达到的目标是否一致。这里的写或读数据指令均采用任务的形式,写数据指令下待写入的数据是采用给定一个值的基础上递增进行赋值的。命令解析模块仿真的结果如图 30.26 所示。 图片 根据波形时序图,在模拟发送写操作命令 0x21,0xf1,0x00,0x00,0x04,0x06,0x07,0x08,0x09 时,在接收完数据字节数这个数据后,后面收到的数据就存入到 fifo 中去了,与我们设计的是一致的,同理可以分析读数据操作命令,也是没有问题的,这样命令解析模块就设计完成了。 下面就是整个系统的设计,如图 30.25 整体设计框图中,在 I2C 写数据操作之前和读数据后分别加入了 fifo 模块,因为串口读写速度和 I2C 读写速度不一样,在这之间加入的 fifo 模块具有读写时钟不一致的特点,可以对数据进行一个缓存,这样就能解决前后速度不一样的问题,这里的两个 fifo 均设置的是读取数据在读请求前有效,这样设计的目的是为了与其他模块待输入数据与使能信号相匹配,里面的 fifo模块都是通过 QuartusII 软件生成的 IP 核,fifo 输入输出数据位宽均设置为 8位,深度设置为 64(多字节读取最多支持 32 字节,稍大于这个数就可以了)。在各模块均设计完成后,整个系统的顶层电路设计就显得比较简单了,根据设计的系统框图进行整合就可以了。整个系统设计的代码如下: module uart_eeprom( Clk, Rst_n, Uart_rx, Uart_tx, Sda, Scl ); parameter Baud_set = 3'd4;//波特率设置,这里设置为 115200 input Clk; //系统时钟 input Rst_n; //系统复位 input Uart_rx; //串口接收 output Uart_tx; //串口发送 inout Sda; //I2C 时钟线 output Scl; //I2C 数据线 wire [7:0] Rx_data; //串口接收一字节数据 wire Rx_done; //串口接收一字节数据完成 wire wfifo_req; //写 FIFO 模块写请求 wire [7:0] wfifo_data; //写 FIFO 模块写数据 wire [5:0] wfifo_usedw; //写 FIFO 模块已写数据量 wire [5:0] rfifo_usedw; //读 FIFO 模块可读数据量 wire rfifo_rdreq; //读 FIFO 模块读请求 wire [5:0] Rddata_num; //I2C 总线连续读取数据字节数 wire [5:0] Wrdata_num; //I2C 总线连续写取数据字节数 wire [1:0] Wdaddr_num; //EEPROM 数据地址字节数 wire [2:0] Device_addr; //EEPROM 地址 wire [15:0] Word_addr; //EEPROM 寄存器地址 wire Wr; //EEPROM 写使能 wire [7:0] Wr_data; //EEPROM 写数据 wire Wr_data_vaild;//EEPROM 写数据有效标志位 wire Rd; //EEPROM 读使能 wire [7:0] Rd_data; //EEPROM 读数据 wire Rd_data_vaild;//EEPROM 读数据有效标志位 wire Done; //EEPRO 读写完成标识位 wire tx_en; //串口发送使能 wire [7:0] tx_data; //串口待发送数据 wire tx_done ; //一次串口发送完成标志位 //串口接收模块例化 uart_byte_rx uart_rx( .Clk(Clk), .Rst_n(Rst_n), .Rs232_rx(Uart_rx), .baud_set(Baud_set), .Data_Byte(Rx_data), .Rx_Done(Rx_done) ); //指令解析模块例化 cmd_analysis cmd_analysis( .Clk(Clk), .Rst_n(Rst_n), .Rx_done(Rx_done), .Rx_data(Rx_data), .Wfifo_req(wfifo_req), .Wfifo_data(wfifo_data), .Rddata_num(Rddata_num), .Wrdata_num(Wrdata_num), .Wdaddr_num(Wdaddr_num), .Device_addr(Device_addr), .Word_addr(Word_addr), .Rd(Rd) ); //写缓存 fifo 模块例化 fifo_wr fifo_wr( .clock(Clk), .data(wfifo_data), .rdreq(Wr_data_vaild), .wrreq(wfifo_req), .empty(), .full(), .q(Wr_data), .usedw(wfifo_usedw) ); //EEPROM 写使能 assign Wr = (wfifo_usedw == Wrdata_num)&& (wfifo_usedw != 6'd0); //I2C 控制模块例化 I2C I2C( .Clk(Clk), .Rst_n(Rst_n), .Rddata_num(Rddata_num), .Wrdata_num(Wrdata_num), .Wdaddr_num(Wdaddr_num), .Device_addr(Device_addr), .Word_addr(Word_addr), .Wr(Wr), .Wr_data(Wr_data), .Wr_data_vaild(Wr_data_vaild), .Rd(Rd), .Rd_data(Rd_data), .Rd_data_vaild(Rd_data_vaild), .Scl(Scl), .Sda(Sda), .Done(Done) ); //读缓存 fifo 模块例化 fifo_rd fifo_rd( .clock(Clk), .data(Rd_data), .rdreq(rfifo_rdreq), .wrreq(Rd_data_vaild), .empty(), .full(), .q(tx_data), .usedw(rfifo_usedw) ); //串口发送使能 assign tx_en = ((rfifo_usedw == Rddata_num)&&Done)|| ((rfifo_usedw < Rddata_num)&& (rfifo_usedw >0)&&tx_done); //读 FIFO 模块读请求 assign rfifo_rdreq = tx_en; //串口发送模块例化 uart_byte_tx uart_tx( .Clk(Clk), .Rst_n(Rst_n), .send_en(tx_en), .baud_set(Baud_set), .Data_Byte(tx_data), .Rs232_Tx(Uart_tx), .Tx_Done(tx_done), .uart_state() ); endmodule下面对设计的整个系统进行编写 testbench 文件来仿真验证,整个仿真主要是通过串口发送模块模拟对该系统发送指令进行仿真验证,这里就只选用 M24LC64 这个仿真模型进行仿真,M24LC04 的仿真模型类似(读者可尝试对该模型进行仿真),编写的 testbench 文件具体代码如下: `timescale 1ns/1ns `define CLK_PERIOD 20 module uart_eeprom_tb; reg Clk; reg Rst_n; reg tx_en; reg [7:0] tx_data; wire tx_done; wire Uart_rx; wire Uart_tx; wire Sda; wire Scl; reg [15:0] addr; reg [7:0] data_num; reg [7:0] wr_data; reg [39:0] wdata_cmd; reg [39:0] rdata_cmd; localparam Baud_set = 3'd4; //波特率设置,这里设置为 115200 localparam DevAddr = 3'b000;//I2C 器件的器件地址 localparam WdAr_NUM = 2'd2; //I2C 器件的存储器地址字节数 //串口发送模块例化 uart_byte_tx uart_tx( .Clk(Clk), .Rst_n(Rst_n), .send_en(tx_en), .baud_set(Baud_set), .Data_Byte(tx_data), .Rs232_Tx(Uart_rx), .Tx_Done(tx_done), .uart_state() ); //串口读写 EEPROM 模块例化 uart_eeprom #(.Baud_set(Baud_set)) uart_eeprom( .Clk(Clk), .Rst_n(Rst_n), .Uart_rx(Uart_rx), .Uart_tx(Uart_tx), .Sda(Sda), .Scl(Scl) ); //EEPROM 模型例化 M24LC64 M24LC64( .A0(1'b0), .A1(1'b0), .A2(1'b0), .WP(1'b0), .SDA(Sda), .SCL(Scl), .RESET(!Rst_n) ); //系统时钟产生 initial Clk = 1'b1; always #(`CLK_PERIOD/2)Clk = ~Clk; initial begin Rst_n = 0; tx_data = 0; tx_en = 0; addr = 0; data_num = 0; wr_data = 0; wdata_cmd = 0; rdata_cmd = 0; #(`CLK_PERIOD*200 + 1) Rst_n = 1; #200; addr = 0; data_num = 4; wr_data = 0; send_uart_data_wr;//写数据 @(posedge uart_eeprom.I2C.Done); #500; send_uart_data_rd;//读数据 @(posedge uart_eeprom.I2C.Done); #500; addr = 4; data_num = 8; wr_data = 20; send_uart_data_wr;//写数据 @(posedge uart_eeprom.I2C.Done); #500; send_uart_data_rd;//读数据 @(posedge uart_eeprom.I2C.Done); //从 EEPROM 读出的数据串口发送出去,等待发送完成 repeat(data_num)begin @(posedge uart_eeprom.tx_done); end #5000; $stop; end //串口发送写数据命令和待写入数据任务 task send_uart_data_wr; begin //写数据指令 wdata_cmd = {{2'b00,WdAr_NUM,1'b0,DevAddr},8'hf1, addr[15:8],addr[7:0],data_num}; //发送写数据指令 repeat(5)begin tx_en = 1; tx_data = wdata_cmd[39:32]; #(`CLK_PERIOD) tx_en = 0; @(posedge tx_done) #100; wdata_cmd = {wdata_cmd[31:0],8'h00}; end //待写入数据 tx_data = wr_data; repeat(data_num)begin tx_en = 1; tx_data = tx_data + 1; #(`CLK_PERIOD) tx_en = 0; @(posedge tx_done) #100; end end endtask //串口发送读数据命令任务 task send_uart_data_rd; begin //读数据指令 rdata_cmd = {{2'b00,WdAr_NUM,1'b0,DevAddr},8'hf2, addr[15:8],addr[7:0],data_num}; //发送读数据指令 repeat(5)begin tx_en = 1; tx_data = rdata_cmd[39:32]; #(`CLK_PERIOD) tx_en = 0; @(posedge tx_done) #100; rdata_cmd = {rdata_cmd[31:0],8'h00}; end end endtask endmodule仿真过程主要是通过串口发送模块模拟对该系统发送读写指令进行仿真验证,分别进行了 2 次写和读指令的发送,读指令主要是对刚写入地址的数据进行读出,我们可以通过观察时序波形图,比较写入数据与读出数据是否一致来验证系统设计的正确性。如图 30.27 为系统仿真波形时序图。 图片 分别对一次写数据指令和一次读数据指令的波形进行放大后观察分析,如图 30.28 和图30.29 分别为一次对 EEPROM 写数据过程和读数据过程的波形时序图。 图片 这次写数据过程的仿真是通过串口发送模块模拟发送指令数据 0x21,0xf1,0x00,0x00,0x04,0x05,0x06,0x07,0x08,向 EEPROM 中起始地址为 0 开始写入 0x05,0x06,0x07,0x08 四个数据,可以通过观察图 30.28 的中 SDA 和 SCL 波形图分析得知,写入的数据确实是这四个数据,说明系统中串口写 EEPROM 部分是没有问题的。 读数据过程的仿真是通过串口发送模块模拟发送指令数据 0x21,0xf2,0x00,0x00,0x04,向 EEPROM 中起始地址为 0 开始读出四个数据,通过观察图 30.29 的中 SDA和 SCL 波形图分析得知,读出的四个数据为 0x05,0x06,0x07,0x08,与之前在这些地址写入的数据是一致的,说明这次的读数据时没有问题的,同样的方式经过多次的验证,串口读写 EEPROM 系统是可以正常工作的。仿真验证进行完成后,接下来就是进行板级验证,先是引脚的分配,本实验板级验证平台是 AC620 开发板,根据开发板的引脚分配表对本实验所用引脚进行分配。如图 30.30 是 AC620 开发板上 EEPROM 部分的硬件原理图,在引脚分配之前,是需要对这一块硬件电路有所了解的。 图片 细心的读者会发现,I2C 时钟线 SCL 和 I2C 数据线没有进行硬件上拉处理,与前面讲解的需要上拉处理不一样,可能会猜想是硬件设计的问题。这里我说明一下,硬件设计是没有问题的,因为对于 FPGA 是可以通过软件对引脚进行上拉处理的,这个也是本实验包含的一个知识点。通过 Quartus II 软件将管脚设置为上拉电阻(弱上拉)的方法,具体的步骤如下: 1.在菜单 Assignments 中选择 Pin Planner,也可以直接点击面板上引脚分配的图标 图片 2.这样进入引脚分配的界面,在弹出的 Pin Planner 界面的 All Pins 区域里点击鼠标右键,找到 Customize Columns。 图片 在弹出的 Customize Columns 对 话 框的 左 列表 框 选 择 Weak Pull-Up Resistor,再点击,把 Weak Pull-Up Resistor 添加到右列表框,这样在 Pin Planner 的 All Pins 区域里就有一列 Weak Pull-Up Resistor 的设置项。 图片 再把需要上拉的 SDA 和 SCL 在其对应的 Weak Pull-Up Resistor 列的位置双极鼠标左键,就会弹出一个 Off/On 的选项,选上 On 就可以了。最后完成后的设置如下: 图片 引脚分配和上拉设置完成后,对我们设计的系统顶层文件进行综合布局布线生成 sof 下载文件,然后下载到 AC620 实验平台进行板级验证。板级验证需要用到串口软件工具, 这里使用的是名叫格西烽火的串口工具,选择对应的开发板的串口号和波特率,系统设计的波特率在顶层文件 uart_eeprom 中可进行设置,这里我们设置的波特率为115200bps。 板级验证时,我们先往 EEPROM 里写入一些数据,也就是在串口发送 6 组数据,每组数据写入四个数据;写完后发送读数据命令,读出写入的数据,分两次读,一次读 20个数据,一次读 4 个数据,具体的发送读写指令操作和串口接收的数据如下图: 图片 从串口发送和接受的数据分析可得,从 EEPROM 读出的 20 个数据和写入的 20 个数据是一样的,这就说明,设计的整个系统是工作正常的,读者可以多次进行多组测试来验证设计的完整性,整个的测试还可以利用 Quartus II 软件中的 SignalTap II Logic Analyzer 工具对 SDA 和 SCL 的波形进行抓取分析系统设计的正确性,这里就不详细的说明了,读者可以自己进行尝试。整个串口读写 EEPROM 的系统设计就算完成了,里面还有很多需要完善的地方,读者可以在学习完成后,对本实验进行改进和拓展。 本节小结 本节主要从二线制 I2C 协议的基本知识和概念、 I2C 器件之间数据通信过程,比较全面的了解了 I2C 协议,并以此设计一个可进行读写操作的 I2C 控制器,结合前面设计的串口收发模块和 FIFO 模块设计了一个简易应用,实现了串口对 EEPROM 存储器的读写功能,并进行相应的板级验证。读者可以在此基础上进行一定的优化和拓展,AC620实验开发板上还有音频模块和时钟模块挂在在 I2C 总线上,读者可以利用这些模块实现更丰富的应用
FPGA&ASIC
# ASIC/FPGA
# 小实验
刘航宇
3年前
0
2,022
6
2022-12-31
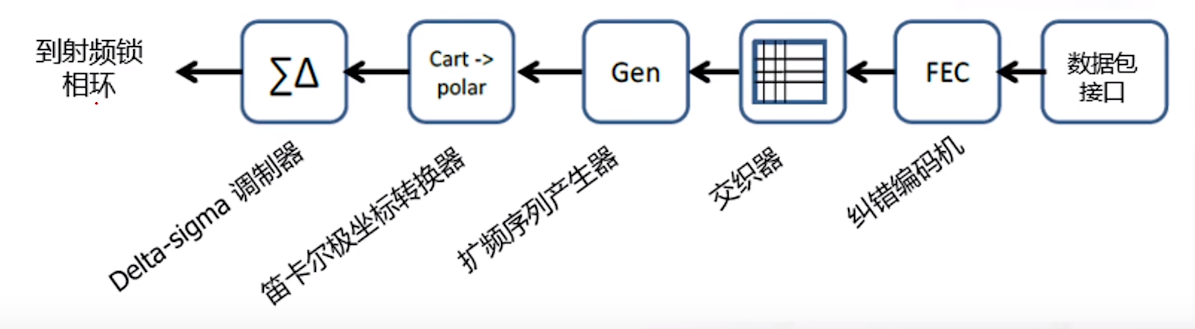
LoRa码元调制、编码与解调
摘要本文介绍了LoRa调制链路,包括纠错编码、交织、扩频、调制和解调过程,并解释了不同扩频因子(SF)和带宽(BW)对LoRa调制方式的影响。关键词:LoRa调制, 纠错编码, 交织器, 扩频序列, Delta-sigma调制LoRa调制链路 ●LoRa调制链路由五部分组成,分别是纠错编码机、交织器、扩频序列产生器、笛卡 尔极坐标转换器、Delta-sigma调制器。 image.png图片 纠错编码器 ●当一组数据(用户的有效载荷(Payload) )被推入数据包接口( Packet Interface)时,调制过程开始。调制器通过纠错编码机将前向纠错编码(ForwardErrorCorrection,FEC)添加到这些字节中。 ●这些有效载荷数据每个字节首先分成半字节(4比特一组)。然后,根据编码速率配置, 在1到4冗余纠错位之间选择并追加到每个半字节。调制器编码速率通过CR寄存器进行设置,表3-1为前向纠错编码配置表。 image.png图片 交织器 ●纠错编码后,产生的(4+CR)位比特段,随后被存储到交织器的存储阵列中。交织器(Interleaver) 有(4+CR)列和SF行。一旦交织器满了,它的内容将编码到码元上。每个码元都带有SF位。因此,交织器内有(4+CR) *SF 比特,独立于扩频因子SF被编码到4+CR码元上。 ●这里举一一个例子让读者理解交织器。假设此时CR=1,,, SF=7, 其交织器为7行、5列。需要传输的数据流为:00000001001000110100010101100111。先将这些比特流分为4b一组(b1,b2,b3,b4) : 0000; 0001; 0010; 0011; 0100;0101; 0110; 0111; 对上述数据增加1比特校验位(b1,b2,b3,b4,C) 后为: 00000; 00011; 00101; 00110; 01001;01010; 01100; 01111; 再将,上述数字填入交织器的存储列阵中,当35b数据进入交织器的存储列阵后,交织器存储满了,下一组数据(b1,b2,b3,b3,C) 需要填入下一个交织器中。 image.png图片 扩频序列产生器 image.png图片 门坐标转换、Delta-sigma调制输出 image.png图片 解调 image.png图片 编码 下是一个SF=7的LoRa调制编码图, 从图中可以看出码元、码片、比特速率、载荷数据之间的关系。 图中SF=7, 所以发送信号带宽切分为128(27-128)个频率段的码片。假设该系统工作频率为470MHz,BW=250kHz,相邻码片间隔为250kHz/128=1 .95kHz,此时f0=470MHz,f1=470.00195MHz,f2=470.0039MHz,.. .f127=470.24805MHz. 图3-9中有三个时间长度分别是码片率(Chip rate),比特速率(Data rate),码元率(Symbol rate),可以清楚地看出它们的对应关系. 图片 解释一下:如果要发送f64,就在f64频率出加到f127,然后再从f0加到f64 不同的SF对应带宽BW除以时间的斜率,SF越大倾斜角度越小。SF和BW对应一种LoRa调制方式,只有接收机也采用对应的SF和BW才能正常解调,否则信号在相干解 调中会淹没在噪声中。在实际的相干解调中,LoRa调制在不同的SF信号或不同的BW下都是正交的,频带可以充分利用。比如在BW=125kHz的同频段内,一个SF=7信号 Psez和一个SF=8信号Psps都在发射,频段内的噪声为N,,当两个信号都满足解调信噪比要求时(SNRsf7 >=-7.5dB; SNRsf8>=-10dB) ,两个信号都可以正常解调。这里需要注意,当计算SNRsf7时,SF=8的信号表现为此系统噪声,SNRsF7= Psp/(N0+Psf8) ; 同理当计算SNRsf8时,SF=7的信号表现为此系统噪声,SNRsf8=Psf8/(N0+Psf7). 图片
通信&信息处理
# 信号处理
刘航宇
4年前
0
1,295
1
上一页
1
...
3
4
5
...
9
下一页